COCO128-Segデータセット#
はじめに#
UltralyticsのCOCO128-Segは、小規模ながら汎用性の高いインスタンスセグメンテーションデータセットです。COCO train2017セットの最初の128枚の画像で構成されています。このデータセットは、セグメンテーションモデルのテストやデバッグ、新しいセグメンテーション手法の実験に最適です。128枚と小規模なため簡単に扱える一方、多様性も備えており、学習パイプラインのエラー検出や、より大規模なデータセットで学習を始める前の健全性チェックに適しています。
データセットの構成#
- 画像: 合計128枚。trainとvalで同じ画像に分割されています(下記の注記を参照)。
- クラス: COCOと同じ80種類のオブジェクトカテゴリ。
- ラベル: trainとvalで共有する画像ディレクトリ内の
labels/train2017に、YOLO形式のポリゴンが保存されています。 - ダウンロードサイズ: ~7 MB。
デフォルトのYAMLでは、trainとvalの両方に同じ128枚の画像が指定されています。そのため、検証指標は保留データへの汎化性能ではなく、学習セットへの適合度を測定します。真の保留データセットが必要な場合は、分割を複製またはカスタマイズしてください。
このデータセットは、Ultralytics PlatformおよびYOLO26での使用を目的としています。
データセットYAML#
データセット設定の定義にはYAMLファイルを使用します。このファイルには、データセットのパス、クラス、その他の関連情報が含まれます。COCO128-Segデータセットの場合、coco128-seg.yamlファイルはhttps://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yamlで管理されています。
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128-seg dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/coco128-seg
# Example usage: yolo train data=coco128-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128-seg ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128-seg # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128-seg.zip使用方法#
COCO128-SegデータセットでYOLO26n-segモデルを画像サイズ640、100エポックで学習するには、次のコードスニペットを使用できます。利用可能な引数の一覧については、モデルの学習ページをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-seg.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)サンプル画像とアノテーション#
以下に、COCO128-Segデータセットの画像と、それぞれに対応するアノテーションの例を示します。
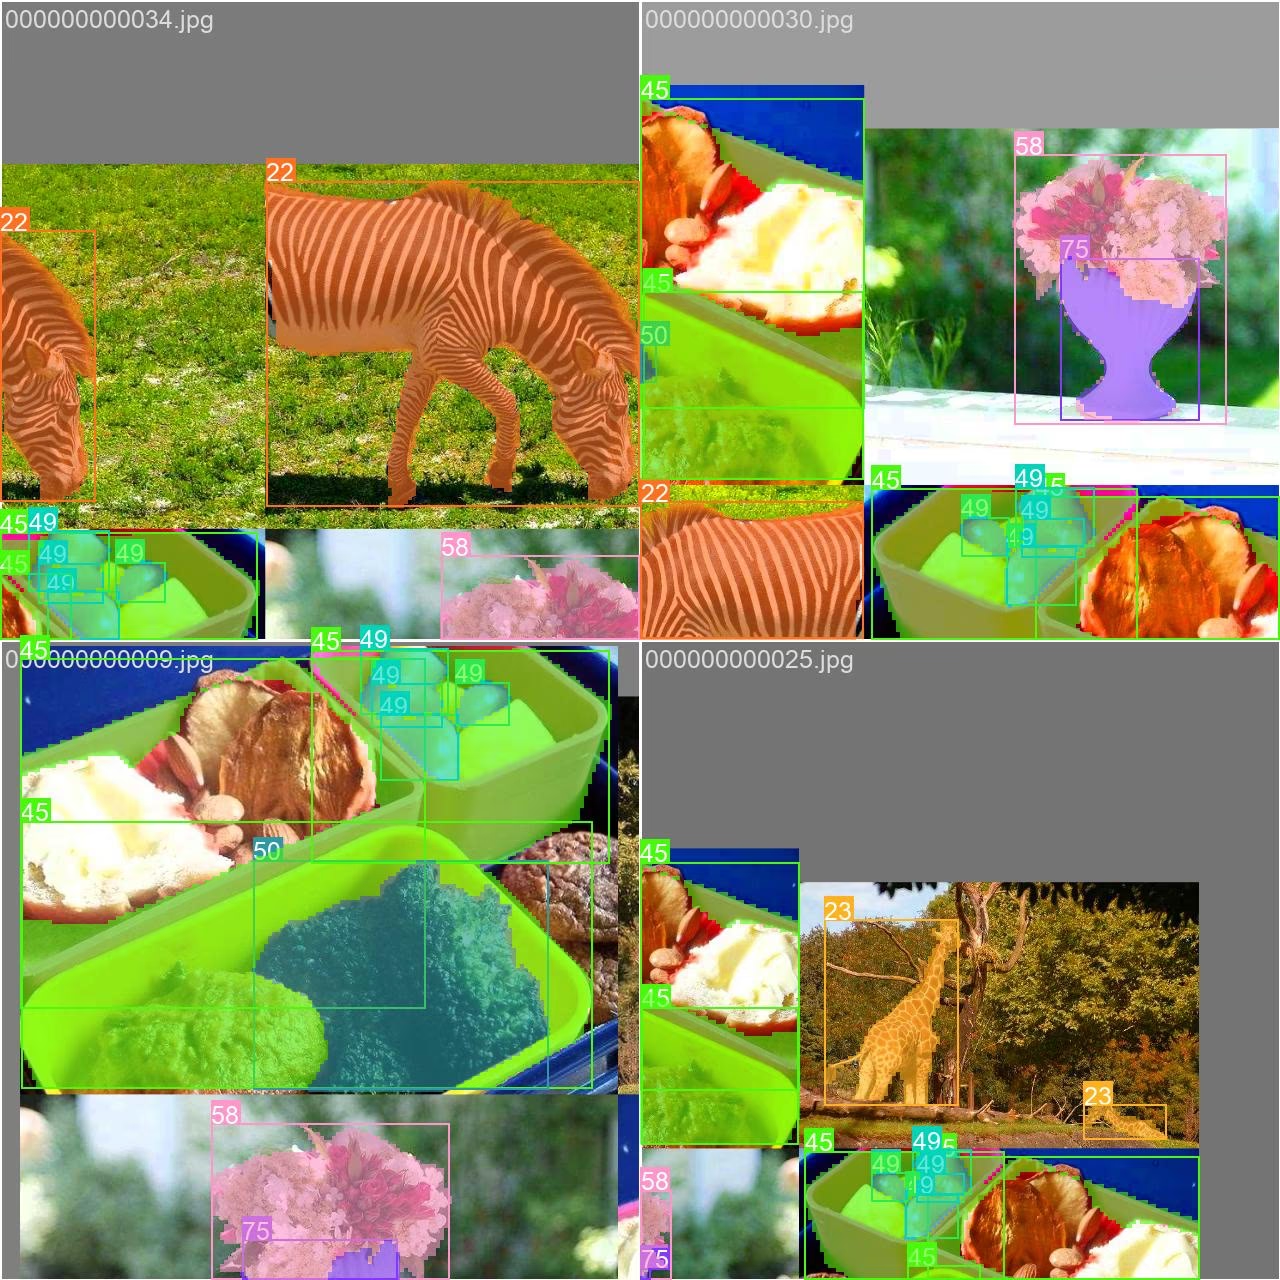
- モザイク画像: モザイク化したデータセット画像で構成されるトレーニングバッチを示しています。モザイク化はトレーニング中に使用される手法で、複数の画像を1枚にまとめ、各トレーニングバッチ内のオブジェクトやシーンの多様性を高めます。これにより、さまざまなオブジェクトサイズ、アスペクト比、コンテキストに対するモデルの汎化性能が向上します。
引用と謝辞#
研究または開発でCOCOデータセットを使用する場合は、以下の論文を引用してください。
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}この貴重なリソースを作成・維持しているCOCOコンソーシアムに、コンピュータビジョンコミュニティを代表して感謝します。COCOデータセットとその作成者について詳しくは、COCOデータセットのウェブサイトをご覧ください。
よくある質問#
COCO128-SegデータセットでYOLO26n-segモデルを画像サイズ640、100エポックで学習するには、PythonまたはCLIコマンドを使用できます。簡単な例を示します。
トレーニング例from ultralytics import YOLO # モデルを読み込む model = YOLO("yolo26n-seg.pt") # 事前トレーニング済みモデルを読み込みます(トレーニングに推奨) # モデルをトレーニングする results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)利用可能な引数と設定オプションの詳しい説明については、学習のドキュメントをご覧ください。
COCO128-Segは、フルサイズのCOCOよりダウンロードとtrain/valループが大幅に小さいため、フルサイズのCOCO-Segデータセットに拡張する前に、新しいパイプラインで1エポックの健全性チェックを実行できます。これにより、モデルが正しく学習・検証され、チェックポイントが保存されることを確認できます。対応するデータセット形式の詳細については、Ultralyticsのセグメンテーションデータセットガイドをご覧ください。
COCO128-SegデータセットのYAML設定ファイルは、Ultralyticsリポジトリから入手できます。ファイルにはhttps://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yamlから直接アクセスできます。YAMLファイルには、モデルの学習と検証に必要なデータセットのパス、クラス、設定などの重要な情報が含まれています。
サイズで比較すると、COCO128-Seg(128枚)はCOCO8-Seg(8枚)より大きく、フルサイズのCOCO-Segデータセット(学習画像118,287枚)より小規模です。
- COCO8-Seg: 8枚(train 4枚、val 4枚)—簡単な健全性チェックやデバッグに最適です。
- COCO128-Seg: 128枚—サイズと多様性のバランスが取れており、trainとvalで同じディレクトリを共有します。
- フルサイズのCOCO-Seg: 学習画像118,287枚—包括的ですが、リソースを多く必要とし、初回のダウンロードには~20 GBが必要です。
COCO128-SegはCOCO8-Segより多様性に富み、実験や初期のモデル開発において、フルサイズのCOCO-Segデータセットよりはるかに扱いやすい規模です。