YOLOモデルの推論
Ultralytics Platformでは、トレーニング済みYOLOモデルをPredictタブから独自の画像でテストし、共有エンドポイントまたは専用エンドポイントを介してRESTで呼び出せます。
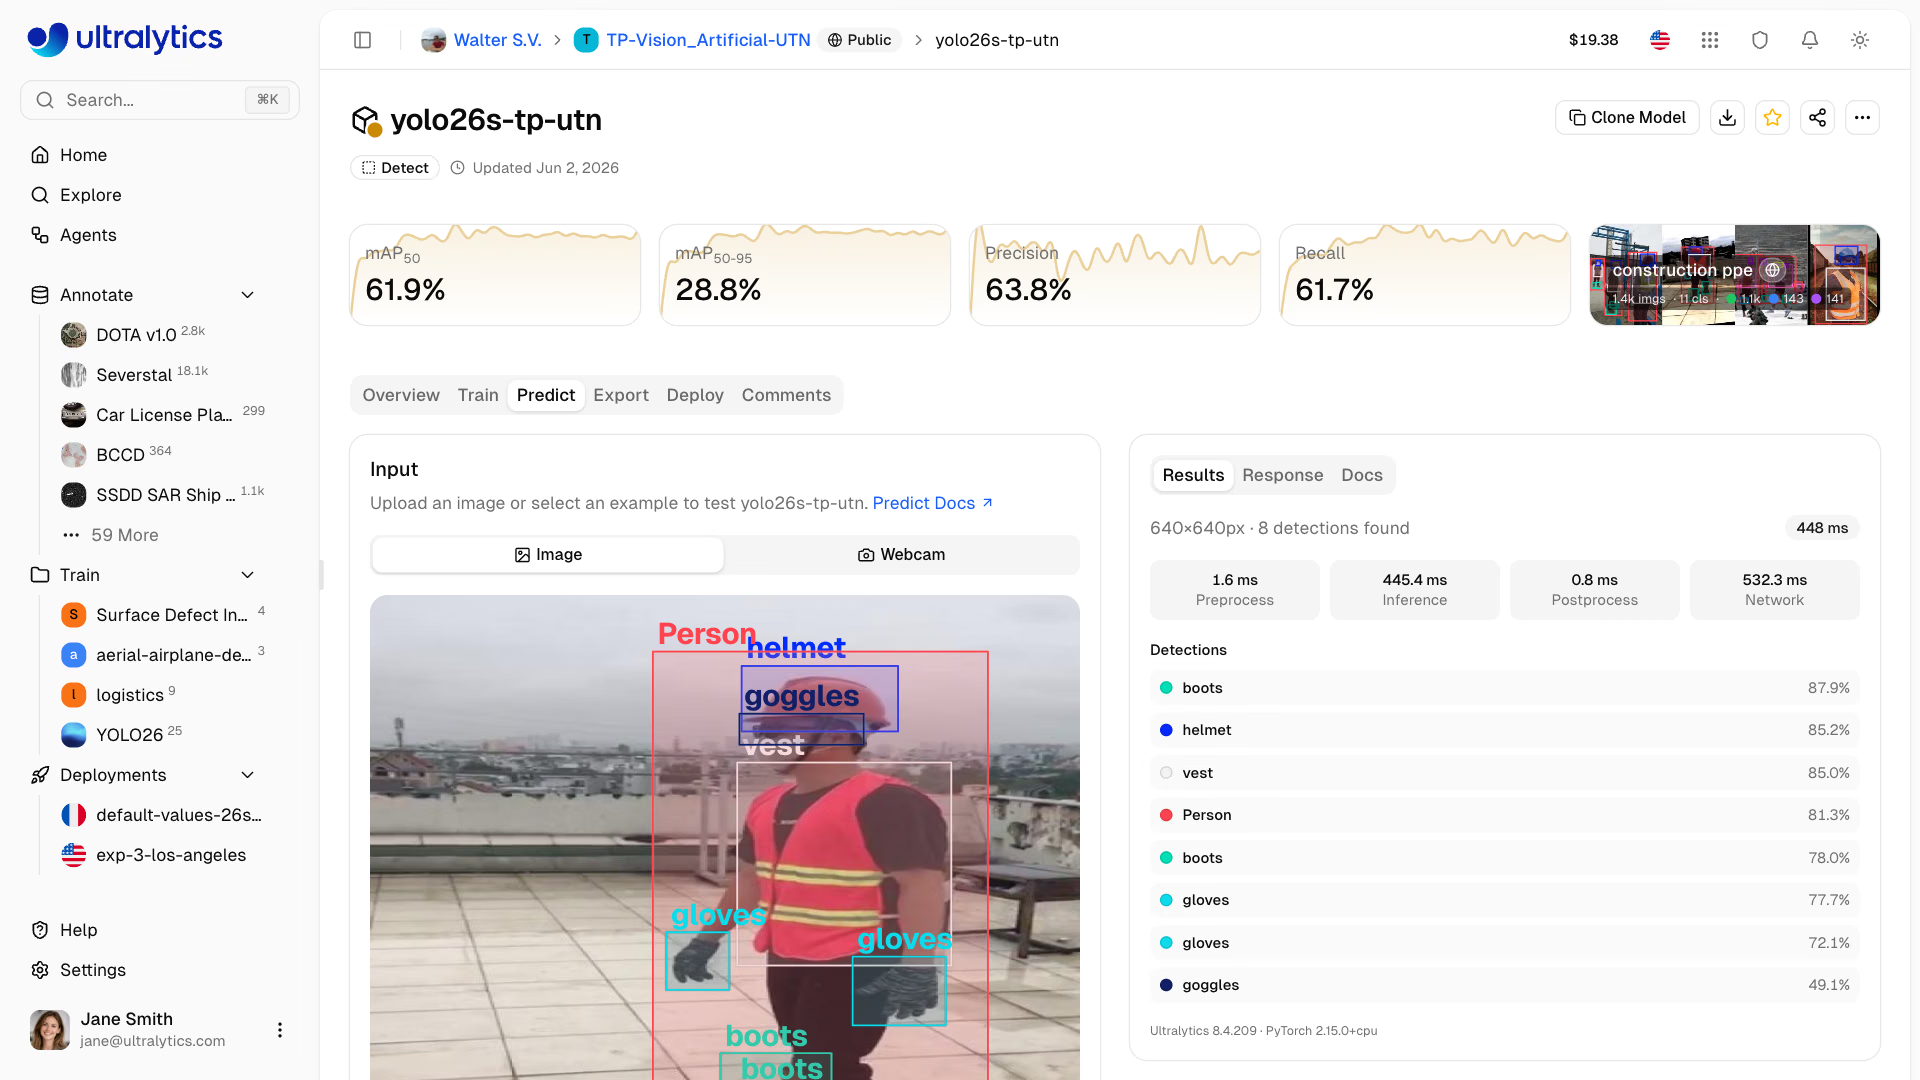
Predictタブ#
重みを含むすべてのモデルには、ブラウザーベースの推論用のPredictタブがあります。
- モデルに移動します
- Predictタブをクリックします
- 画像をアップロードするか、サンプルを使用するか、ウェブカメラを開きます
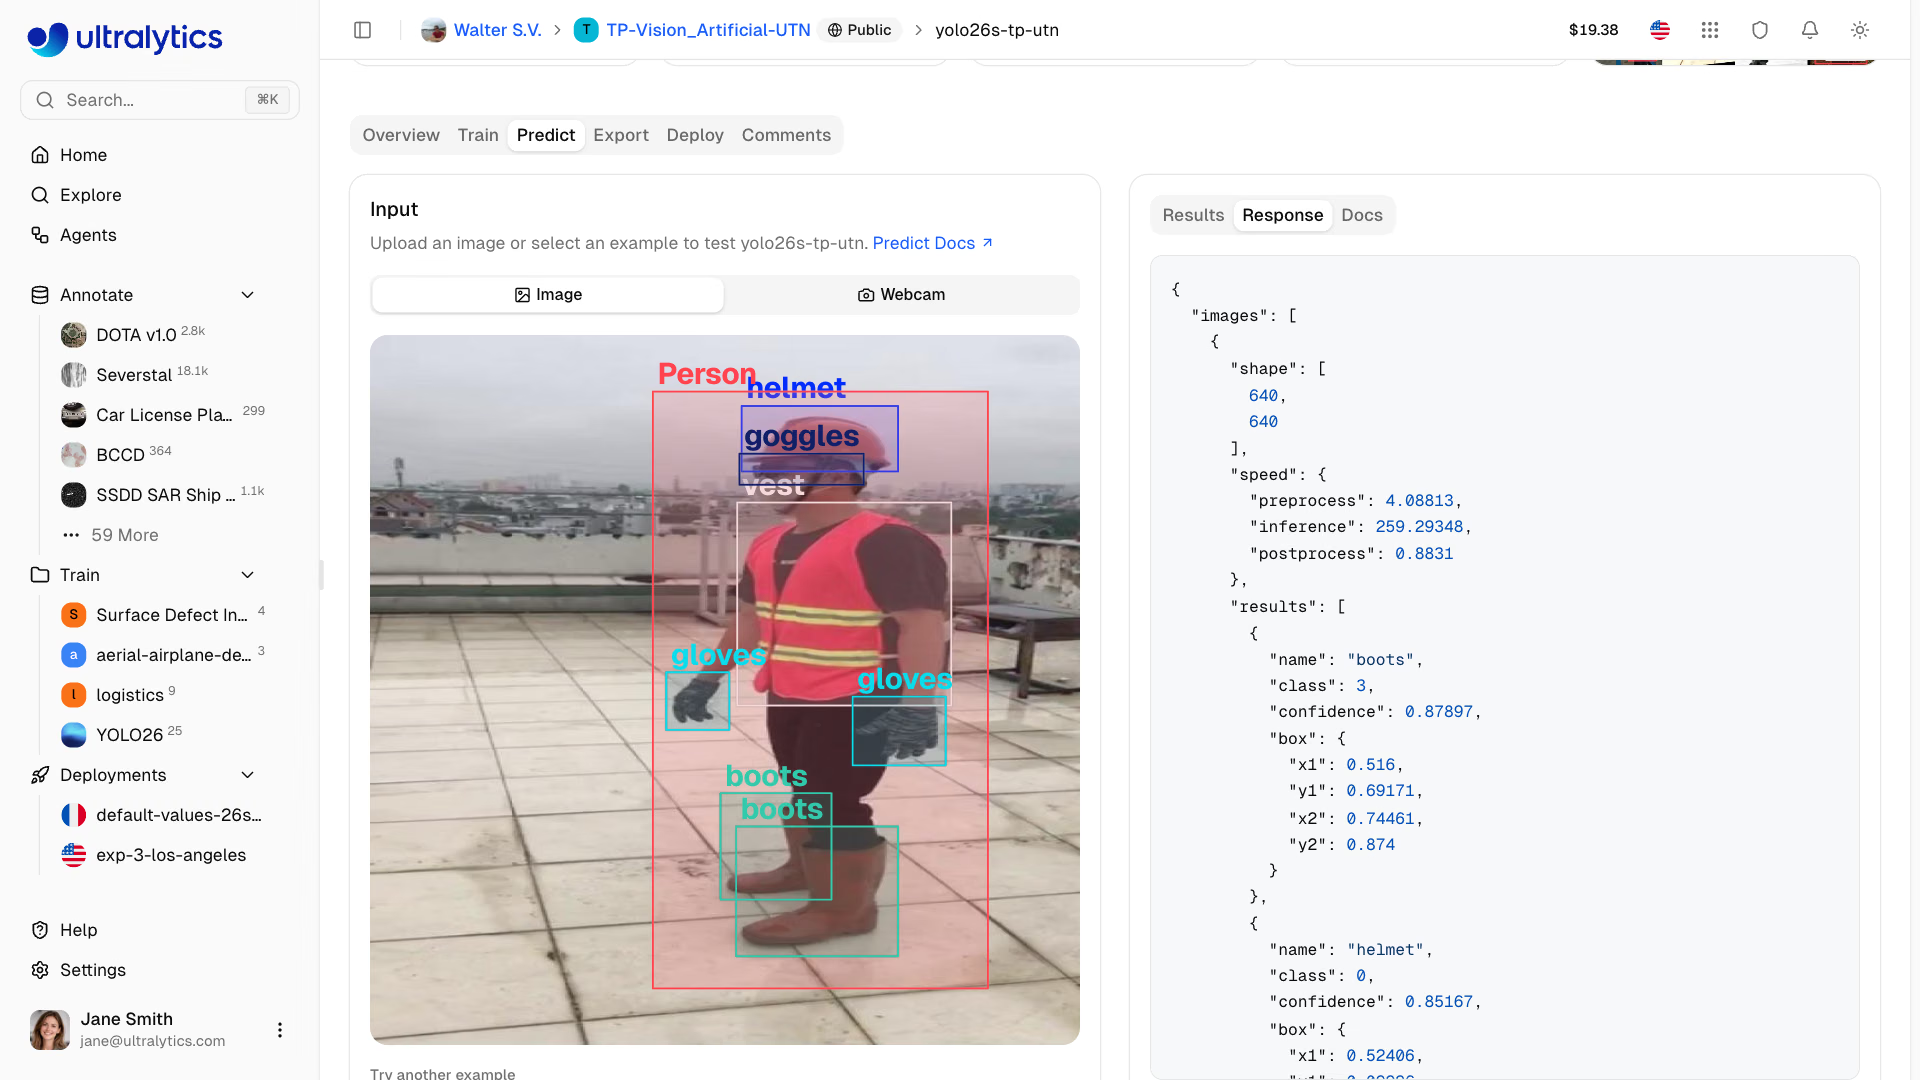
- タスクに応じたオーバーレイ、予測の概要、処理時間、生のレスポンスを確認します
重みのないモデルでは、代わりに空の状態が表示されます。まずモデルをトレーニングするか、重みをアップロードしてください。
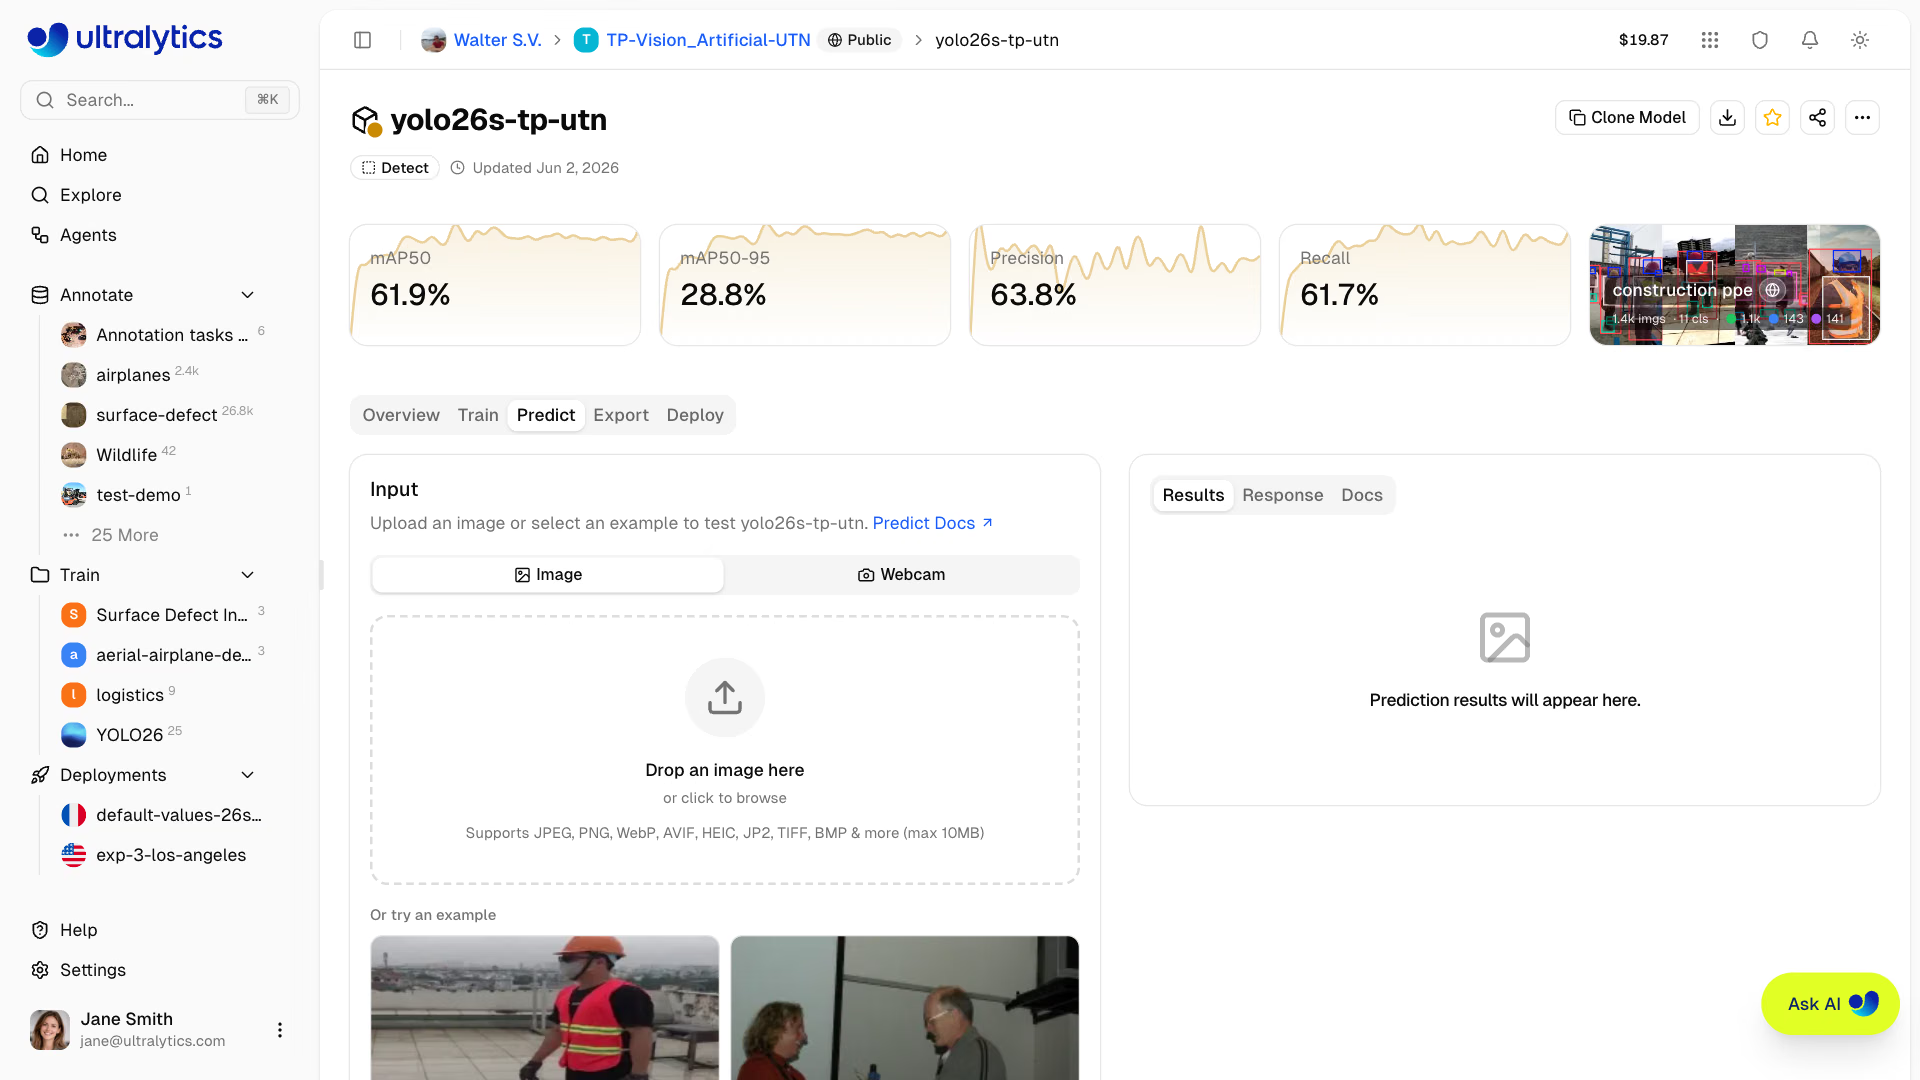
入力方法#
予測パネルでは、複数の入力方法を利用できます。
| メソッド | 説明 |
|---|---|
| 画像のアップロード | ドラッグ&ドロップするかクリックして、画像またはPDFをアップロードします |
| サンプル画像 | 組み込みのサンプル(データセット画像またはデフォルト画像)をクリックします |
| ウェブカメラ撮影 | 1フレームを撮影できるライブカメラ映像 |
| IPカメラ | 独自のデプロイメント上のRTSPまたはRTSPSストリーム |
画像をアップロード#
ドラッグ&ドロップするか、クリックしてアップロードします:
- 対応フォーマット: JPEG、PNG、WebP、AVIF、HEIC、JP2、TIFF、BMP、PDF(最初のページを画像としてレンダリングし、画像と同様に予測します)
- 最大サイズ:10 MB
- 自動推論:アップロード後、結果が自動的に表示されます
画像のアップロード、サンプルの選択、またはウェブカメラのフレーム撮影を行うと、予測パネルが自動的に推論を実行します。ボタンをクリックする必要はありません。
アップロード前に、パネルは最長辺が選択した Image Size を超える画像をそのサイズに縮小し、元の画像より小さくなる場合(たとえばPNGのスクリーンショット)は元の画像の代わりにJPEGを送信し、正規化された座標を要求します。これによりブラウザーでのテストが高速になります。自分で送信するリクエストではサイズは変更されません。iPhoneのHEIC写真やChromeでのTIFFなど、ブラウザーで直接表示できない形式はブラウザー内で変換されるため、ほかの画像と同じようにプレビューでき、同じ方法でサイズが変更されます。HEIC、HEIF、BMPは常にJPEGとして送信されます。
サンプル画像#
予測パネルには、モデルにリンクされたデータセットから最大4枚のサンプル画像が表示されます。val分割が優先され、次にtest、続いてtrainが使用されます。データセットがリンクされていない場合は、デフォルトのサンプルが使用されます。
| 画像 | 内容 |
|---|---|
bus.jpg | 車両が写った街路の風景 |
zidane.jpg | 人物が写ったスポーツの風景 |
OBBモデルでは、代わりにボートや空港の航空画像が表示されます。
ページの読み込み時にサンプル画像がプリロードされるため、サンプルをクリックすると、ダウンロードを待たずにほぼ即座に推論が実行されます。
ウェブカメラ#
画像領域の上にあるWebカメラを選択すると、ライブカメラ映像が始まります:
- プロンプトが表示されたら、カメラへのアクセスを許可します
- ビデオプレビューをクリックしてフレームを撮影します
- 撮影したフレームに対して推論が自動的に実行されます
- ライブ映像に戻るには、Webカメラに戻るをクリックします
独自のデプロイメントのPredictタブでは、代わりにWebカメラで継続的に推論が実行されます。ライブカメラ推論をご覧ください。
結果の表示#
推論結果には、モデルのタスクに応じて、ボックス、マスク、キーポイント、方向付きボックス、分類スコア、セマンティック領域、または深度マップが表示されます。利用可能な場合、物体の結果にはデータセットのクラスカラーが使用されます。パネルには、前処理、推論、後処理、ネットワークの処理時間も表示されます。
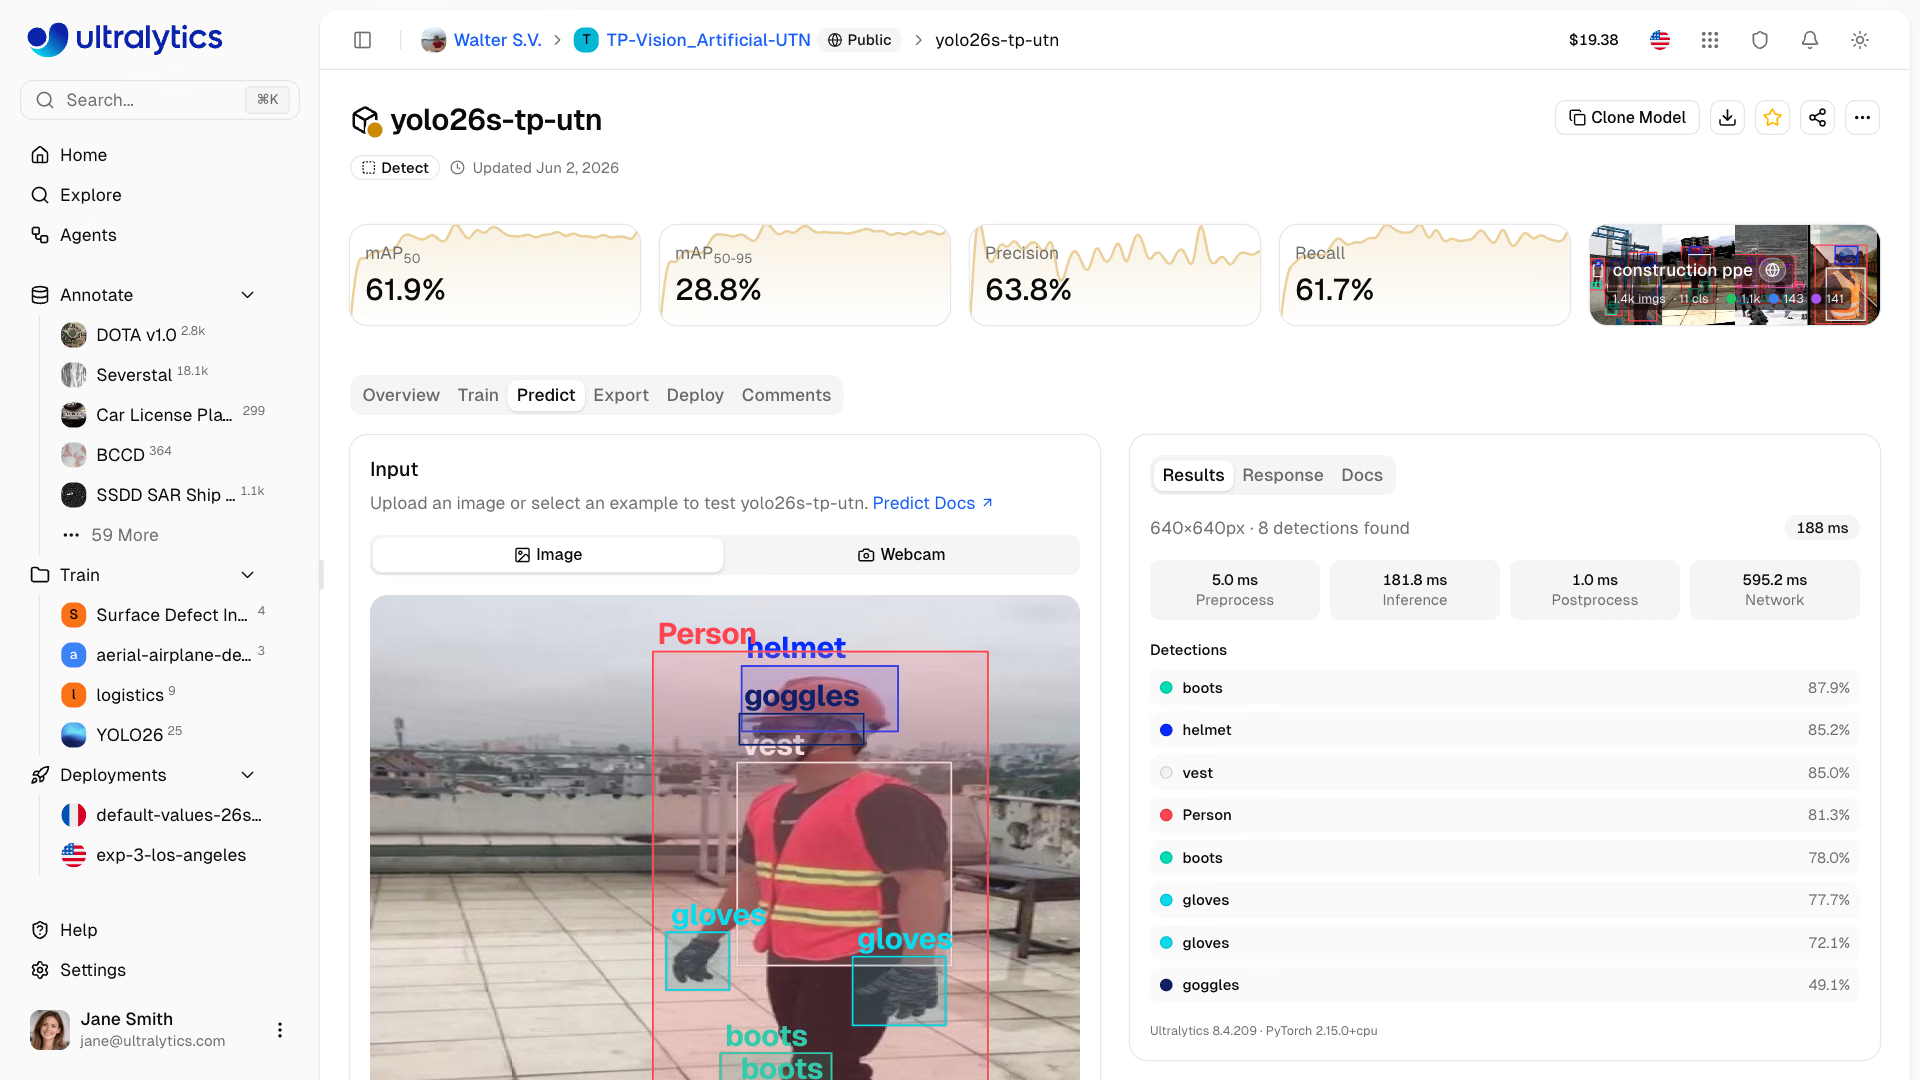
結果パネルには次の項目が表示されます。
| 項目 | 説明 |
|---|---|
| 結果の概要 | 検出ごとの一覧、または分類モデルとセマンティックモデルの上位5クラス |
| 速度統計 | 前処理、推論、後処理、ネットワーク(ms) |
| バージョン | UltralyticsとPyTorchのバージョン、および該当する場合は深度の範囲またはマスクのサイズ |
| JSONレスポンス | base64形式のマップデータを省略した、生のAPIレスポンスをコードブロックで表示します |
結果が表示されると、プレビュー上に2つのコントロールが表示されます。画像をクリックするとオーバーレイを保持したまま拡大表示でき、ダウンロードボタンを使用すると現在の結果を注釈付きJPEGとして保存できます。
検出結果の行にカーソルを合わせるとバウンディングボックスが強調表示され、画像上のボックスにカーソルを合わせると該当する行が強調表示されて、リスト内に表示されるようスクロールします。結果が10件を超える場合、ラベルが対象物に重ならないよう、画像にはラベルなしのボックスが表示されます。リストには各結果の名前が表示され、拡大画像にはラベルが表示されます。画面が広い場合、結果カードは入力カードの高さまで拡張できるため、商品が密集した小売店の棚などの長いリストも読みやすく表示されます。
モデルのPredictタブでは、画像ごとに最大1,000件の結果が返されます。RT-DETRモデルでは最大300件が返されます。これはデコーダー内のクエリ数です。
推論パラメーター#
画像の下にある3つのスライダーで推論の動作を調整します(深度モデルでは 画像サイズ のみ表示されます)。
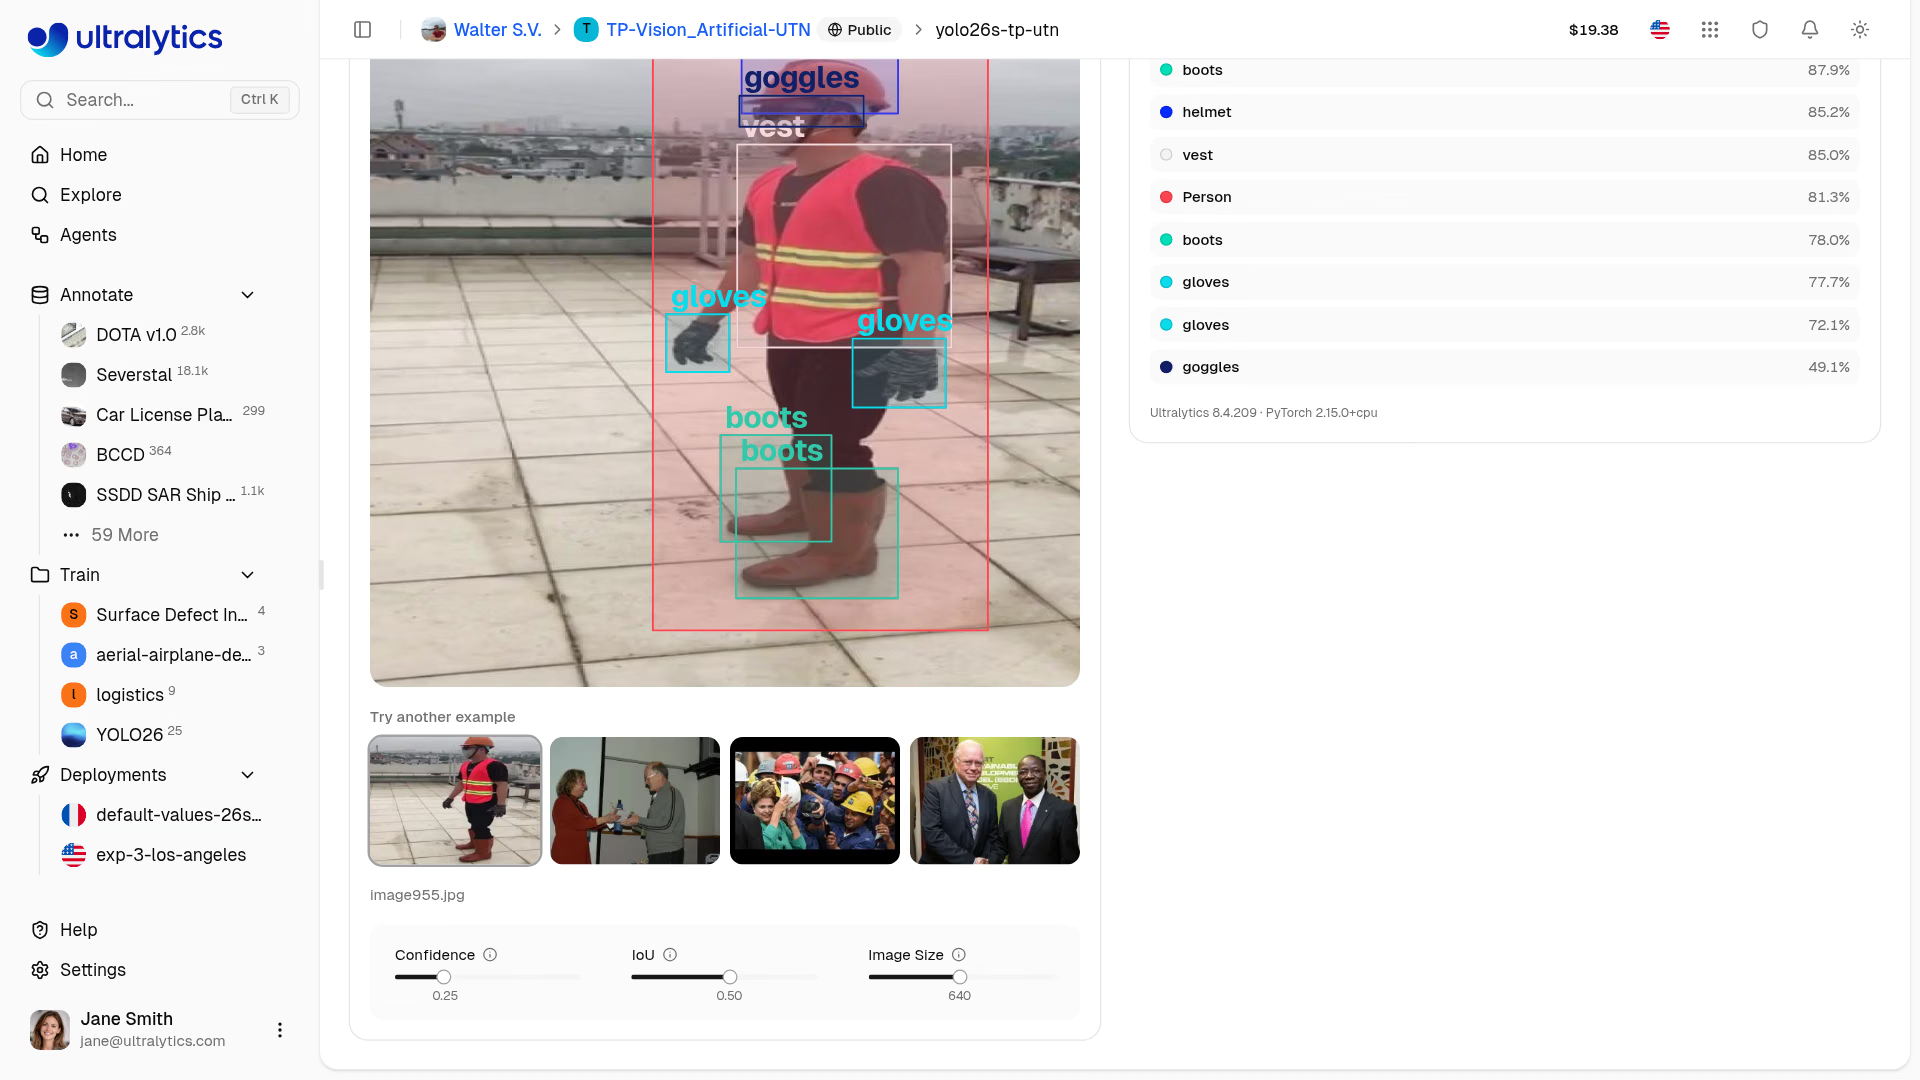
| パラメーター | 範囲 | デフォルト | 説明 |
|---|---|---|---|
| 信頼度 | 0.01~1.0、刻み幅0.01 | 0.25 | 最小信頼度しきい値 |
| IoU | 0.0~0.95、刻み幅0.01 | 0.5 | NMSのIoUしきい値 |
| 画像サイズ | 32~1280、刻み幅32 | 640 | 入力画像のリサイズ寸法 |
パラメーターを変更すると、500ミリ秒のデバウンス後に現在の画像で推論が自動的に再実行されます。再アップロードは不要です。
信頼度しきい値#
信頼度スコアで予測をフィルタリングします:
- 高め(0.5以上):予測数は少なくなりますが、確度が高くなります
- 低め(0.1~0.25):予測数は増えますが、ノイズが含まれる場合があります
- デフォルト(0.25):ほとんどのユースケースでバランスの取れた設定です
IoUしきい値#
このしきい値を超えるIntersection over Union (IoU)で、高信頼度のボックスと重なるボックスを除去するNon-Maximum Suppression (NMS)を制御します:
- 高め(0.6以上): ボックスの重なりをより多く許容します
- 低め(0.3~0.4): 重なり合う検出をより積極的に抑制します
- デフォルト(0.5): ほとんどのユースケースに適したバランスの取れたNMS動作です
デプロイ済みモデルの推論#
実行中の各専用エンドポイントには、デプロイページにPredictタブがあります。このタブでは共有のPredictサービスではなく、デプロイメント専用の推論サービスを使用するため、ブラウザーからデプロイ済みエンドポイントをテストできます。
準備完了状態のエンドポイントで処理された画像は、Monitoringタブにも反映されます。サンプルや集計グラフは、メモリー上に保持される軽量な一時データです。停止、再起動、再デプロイ、サイズ変更、モデルの置き換えを行うと、データが消去される場合があります。サンプルを保持するには、データセットに保存してください。
ライブカメラ推論#
所有するデプロイメントのPredictタブで、WebカメラまたはIPカメラを選択すると、ライブ映像でエンドポイントを実行できます:
| ソース | 仕組み |
|---|---|
| Webカメラ | ブラウザーはフレームを1つずつエンドポイントに送信し、各結果をライブ映像に重ねて表示します |
| IPカメラ | 認証情報を含むrtsp://またはrtsps://のURLを入力し、接続をクリックします。エンドポイントがカメラ映像を読み取り、各結果をストリーミングで返します |
ライブ推論では、エンドポイントにバインドされたAPIキーを使用します。このキーを読み込めるのはワークスペースの所有者のみです。他のチームメンバーの場合、Webカメラは単一フレームをキャプチャし、モデルのPredictタブと同様にIPカメラは利用できません。IPカメラはインターネットからアクセス可能である必要があります。エンドポイントは192.168.x.xのようなローカルネットワークアドレスを拒否します。各結果は最新のフレームに対するものであり、推論が遅れるとフレームはスキップされます。スライダーの変更は次のWebカメラフレームに適用され、IPカメラのストリームは再起動します。ブラウザーのタブが非表示になるとライブ推論は一時停止します。プレビューをクリックしてフレームをキャプチャするか、切断をクリックしてIPカメラの表示を停止します。
バックグラウンドカメラ#
カスタムCPU・メモリサイズのエンドポイントでは、切断後やページを閉じた後も、IPカメラ1台の監視を継続できます。接続したカメラに結果が表示されたら、バックグラウンドで実行を継続をオンにします。デプロイメントのヘッダーにはカメラ稼働中と表示され、結果は一時的なサンプルと予測統計としてモニタリングタブに送られます。
- 設定: バックグラウンドカメラでは、常にデフォルトの信頼度(0.25)、IoU(0.5)、およびモデルのトレーニング画像サイズが使用されます。スライダーは適用されません。
- 料金: 追加料金なしでエンドポイントの起動中インスタンス上で実行されます。カメラのオン・オフにかかわらず、時間単位の稼働料金が適用されます。
- 変更: カメラをオン・オフにしたり、別のカメラに切り替えたりすると、エンドポイントのインスタンスが再起動します。これによりエンドポイントは使用可能な状態に保たれますが、一時的なモニタリングデータは消去されます。
- 停止: スイッチをオフにします。切断したりページを閉じたりしても停止しません。また、エンドポイントをデフォルトサイズに変更すると、バックグラウンドカメラは削除されます。カメラがオフラインになった場合、エンドポイントは再接続を続けます。
- エンドポイントのライフサイクル: エンドポイントを停止するとカメラと課金が停止します。再び起動すると、保存済みのカメラが再開します。
デフォルトサイズのエンドポイントでは、バックグラウンドオプションを使用せずに、WebカメラとIPカメラのライブ推論を利用できます。APIからバックグラウンドカメラを保存するには、デプロイメントのcameraアクションを使用します。
APIからのストリーム結果#
専用エンドポイントのURLに、sourceとしてRTSPまたはRTSPSのURLを指定し、Accept: text/event-streamヘッダーを付けて送信すると、サーバー送信イベントとして結果を受け取れます:
curl -N -X POST \
  "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Accept: text/event-stream" \
  -F "source=rtsp://user:password@camera.example.com:554/stream" \
-F "conf=0.25"各フレームイベントには、正規化(0~1)座標を含むレスポンス形式のimages、フレームのpreview JPEGデータURL、およびタスク名とクラス名を含むmetadataが含まれます。適用されるのはconf、iou、imgszのみです。エンドポイントのバックグラウンドカメラURLをストリーミングする場合は、デフォルト設定が使用されます。statusのみを含むイベントにはフレームが含まれません。また、errorメッセージを含むイベント(カメラを読み取れない場合、またはエンドポイントでモデルを実行できない場合)が発生すると、ストリームは終了します。エンドポイントの再起動時、またはリクエストが制限時間に達した場合もストリームは閉じます。エラーなしで終了した場合は、バックオフを設けて再接続してください。Platform APIのデプロイメント予測ルートとSDKではストリーミングはできません。バインドされたAPIキーを使用し、カメラリクエストをエンドポイントURLに送信してください。ヘッダーなしのカメラsourceは400を返します。
専用エンドポイントAPI#
モデルのPredictタブにあるAPI Docsカードには、スライダーで現在設定されている信頼度、IoU、画像サイズが入力済みのPython、JavaScript、cURLのリクエスト例が含まれています。モデルをデプロイするまでは、URLとキーはプレースホルダーです。コードタブの横にあるDeployボタンをクリックすると、モデルのDeployタブに移動します。デプロイ後、デプロイページのPredictタブにあるDocs結果タブに、そのエンドポイントのURLと、ワークスペースの所有者には紐付けられたAPIキーが表示され、コピーして実行できる状態になります。
認証#
リクエストにAPIキーを含めてください。
Authorization: Bearer YOUR_API_KEY独自のスクリプト、ノートブック、アプリから推論を実行するには、APIキーを含めてください。Settings > API KeysでAPIキーを生成できます。専用エンドポイントが受け付けるのは、そのエンドポイントの作成時に使用した単一のキーのみです。共有モデルAPIはワークスペース内の有効なキーをすべて受け付け、公開モデルは匿名リクエストも受け付けます。
エンドポイント#
専用エンドポイントには、それぞれ固有のURLでリクエストを送信します。
POST https://YOUR_DEPLOYMENT_URL.run.app/predict共有推論では、モデルのフルパスを指定してPlatform APIを使用します。
POST https://platform.ultralytics.com/api/models/{owner}/{project}/{model}/predictどちらも同じmultipart/form-dataボディを受け付け、同じ形式のレスポンスを返します。Python SDKでは、共有推論にclient.models.predict(owner, project, model, body=...)を、専用デプロイメントにclient.deployments.predict(owner, deployment, body=...)を使用します。どちらのSDKメソッドもPlatform APIを呼び出すため、Platform APIのレート制限とリクエストサイズ制限が適用されます。これらの制限を回避するには、Requestに示すように、専用エンドポイントのURLに直接POSTしてください。共有推論の例:
from ultralytics_platform import Platform

client = Platform()  # reads ULTRALYTICS_API_KEY
with open("image.jpg", "rb") as f:
results = client.models.predict("acme-vision", "inspection", "v3", body={"file": f, "conf": 0.25})リクエスト#
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as image_file:
    response = requests.post(url, headers=headers, files={"file": image_file}, data=data)
print(response.json())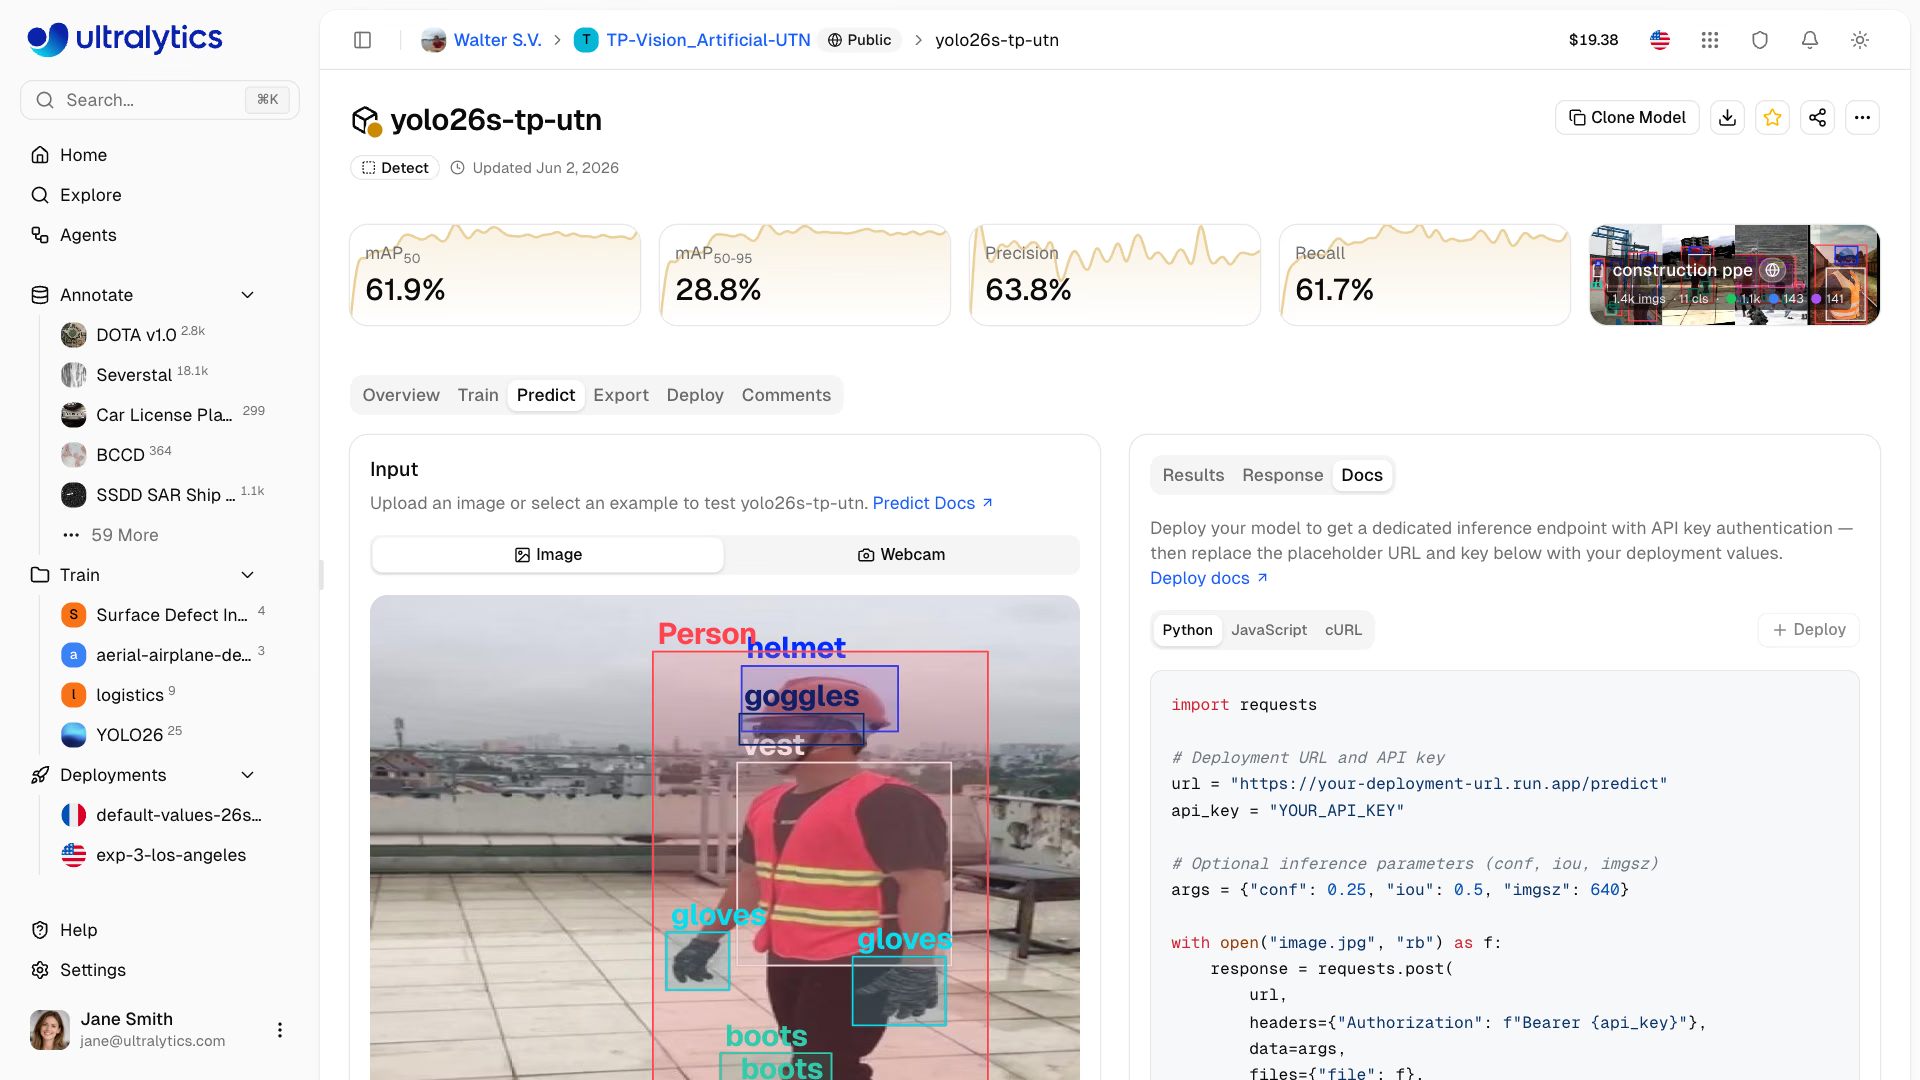
リクエストパラメーター#
| パラメーター | 種類 | デフォルト | 範囲 | 説明 |
|---|---|---|---|---|
file | file | - | - | 画像または動画ファイル(sourceが設定されていない場合は必須) |
conf | 浮動小数点数 | 0.25 | 0.01 – 1.0 | 最小信頼度しきい値 |
iou | 浮動小数点数 | 0.5 | 0.0 – 0.95 | NMSのIoUしきい値 |
imgsz | 整数 | - | 32 – 1280 | 入力画像サイズ(ピクセル単位)。デフォルトはモデルの学習時のサイズです(取得できない場合は640)。 |
normalize | ブール値 | false | - | バウンディングボックスの座標を0~1の範囲で返します |
decimals | 整数 | 5 | 0 – 10 | 座標値の小数点以下の桁数 |
vid_stride | 整数 | 1 | ≥ 1 | 動画のNフレームごとに予測します。画像には適用されません |
bits | 整数 | 8 | 8, 12, 16 | 深度マップの量子化。深度モデルのみ |
source | 文字列 | - | - | 画像URLまたはbase64文字列(fileの代替)。Platform API経由では最大4,096文字 |
レスポンス#
{
    "images": [
        {
            "shape": [1080, 1920],
            "results": [
                {
                    "class": 0,
                    "name": "person",
                    "confidence": 0.92,
                    "box": { "x1": 100, "y1": 50, "x2": 300, "y2": 400 }
                },
                {
                    "class": 2,
                    "name": "car",
                    "confidence": 0.87,
                    "box": { "x1": 400, "y1": 200, "x2": 600, "y2": 350 }
                }
            ],
            "speed": {
                "preprocess": 1.2,
                "inference": 12.5,
                "postprocess": 2.3
            }
        }
    ],
    "metadata": {
        "imageCount": 1,
        "functionTimeAlive": 1284.51,
        "functionTimeCall": 0.018,
        "task": "detect",
        "version": {
            "ultralytics": "8.x.x",
            "torch": "2.6.0",
            "torchvision": "0.21.0",
            "python": "3.13.0"
        }
    }
}
レスポンスフィールド#
| 項目 | 種類 | 説明 |
|---|---|---|
images | 配列 | 処理済み画像のリスト。処理済み動画フレームごとに1つの項目が含まれます |
images[].shape | 配列 | 画像の寸法 [height, width] |
images[].results | 配列 | 検出結果のリスト |
images[].results[].class | 整数 | クラスインデックス(整数ID) |
images[].results[].name | 文字列 | クラス名 |
images[].results[].confidence | 浮動小数点数 | 検出信頼度(0~1) |
images[].results[].box | オブジェクト | バウンディングボックスの座標 |
images[].semantic_mask | オブジェクト | ピクセルごとのクラスマップ(セマンティックモデルのみ) |
images[].depth | オブジェクト | ピクセルごとの深度マップ(深度モデルのみ) |
images[].speed | オブジェクト | 処理時間(ミリ秒) |
metadata | オブジェクト | 画像数、サービスの処理時間、タスク、バージョン |
タスク別のレスポンス#
レスポンス形式はタスクによって異なります。
{
  "class": 0,
  "name": "person",
  "confidence": 0.92,
  "box": {"x1": 100, "y1": 50, "x2": 300, "y2": 400}
}レート制限#
共有モデルAPIは、APIキー、サインイン済みの呼び出し元、または匿名IPアドレスごとに毎分20リクエストに制限されています。Platformのデプロイメント用Predictルート(POST /api/deployments/{owner}/{deployment}/predict)にも同じ制限が適用されます。スロットリングが発生すると、APIは429とRetry-Afterヘッダーを返します。すべてのエンドポイントカテゴリーについては、レート制限のリファレンスを参照してください。
専用エンドポイントに直接送信されたリクエストは、Platform APIのレートリミッターを経由しません。ただし、エンドポイントが一時的に処理能力の上限に達すると、429とRetry-Afterヘッダーを返して負荷を制限します。大量のローカル推論については、Predictモードガイドを参照してください。
エラー処理#
一般的なエラーレスポンス:
| コード | メッセージ | ソリューション |
|---|---|---|
| 400 | 無効な画像 | ファイル形式を確認するか、モデルに学習済み重みがあることを確認してください |
| 401 | 認証エラー | APIキーを確認してください |
| 404 | モデルが見つかりません | 所有者、プロジェクト、モデル名を確認してください |
| 413 | 入力サイズが大きすぎます | ファイルサイズをエンドポイントの上限未満にしてください |
| 429 | レート制限に達しました | しばらく待ってから再試行するか、専用エンドポイントに直接リクエストを送信してください |
| 500 | サーバーエラー | リクエストを再試行してください |
| 503 | サービスを利用できません | Predictサービスが起動中か、到達できません。少し待ってから再試行してください |
よくある質問#
どちらの推論方法も動画ファイルを受け付けます。
- 専用エンドポイントは動画ファイルを直接受け付けます。対応形式(1リクエストあたり最大32 MB):ASF、AVI、GIF、M4V、MKV、MOV、MP4、MPEG、MPG、TS、WEBM、WMV。結果は処理済みフレームごとに返され、リクエストは最大1時間実行できます。詳しくは専用エンドポイントを参照してください。
- 共有推論(
POST /api/models/{owner}/{project}/{model}/predict)は同じ予測サービスを使用し、同じ動画形式を受け付けますが、リクエストサイズは約4.5 MBに制限され、約30秒でタイムアウトします。そのため、短いクリップにのみ適しています。ブラウザーの予測タブでは画像のみをアップロードできます。動画ファイルには専用エンドポイントを、WebカメラまたはIPカメラにはライブカメラ推論を使用してください。
深度モデルは動画ファイルを受け付けません。
Predictタブでは、プレビュー上部のダウンロードボタンをクリックすると、現在の結果がアノテーション済みJPEGとして保存されます。API自体は予測結果をJSONで返します。予測結果を可視化するには、次のようにします。
- 予測結果を使ってローカルでボックスを描画します
- Ultralyticsを使ってモデルをローカルで実行し、注釈付きの結果を
save()で保存します(またはplot()で配列を取得します)。
from ultralytics import YOLO model = YOLO("yolo26n.pt") results = model("image.jpg") results[0].save("annotated.jpg")完全な結果APIと可視化オプションについては、Predictモードのドキュメントをご覧ください。
- Predictタブの上限: 10 MB
- 共有推論APIの上限: Python SDK経由を含め、リクエストあたり約4.5 MB
- 専用エンドポイントの上限: エンドポイントURLに直接送信するリクエストあたり32 MB
長辺が選択した
Image Sizeを超える画像は、ブラウザーがデコードできない場合を除き、アスペクト比を維持したままブラウザー内で縮小されます(画像をアップロード)。ご自身で送信するリクエストはリサイズされないため、上限を超えるリクエストは413で拒否されます。現在のAPIは1リクエストにつき1枚の画像を処理します。バッチ処理を行うには、次の方法があります。
- 画像ごとに個別のリクエストを送信します
- 適切な場合は、リクエストを複数の専用エンドポイントに分散します
- 大規模バッチにはローカル推論を使用します
Pythonでのバッチ推論import concurrent.futures import requests url = "https://YOUR_DEPLOYMENT_URL.run.app/predict" headers = {"Authorization": "Bearer YOUR_API_KEY"} images = ["img1.jpg", "img2.jpg", "img3.jpg"] def predict(image_path): with open(image_path, "rb") as f: return requests.post(url, headers=headers, files={"file": f}).json() with concurrent.futures.ThreadPoolExecutor(max_workers=4) as executor: results = list(executor.map(predict, images))


コメント2
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
 Bob Ass
مدلی که عکس از کالاهای مغازه خوراکی میگیرد عکس بعدی را میگیرد و کم یا زیاد شدن کالاها و تعداد و نامشان را میگوید
 Paula DerrengerUltralytics
بله، میتوانید چنین سامانهای را با YOLO بسازید: مدل را با تصاویر برچسبخوردهٔ کالاهای فروشگاه آموزش دهید تا هر نوع کالا را تشخیص دهد؛ سپس هر عکس را جداگانه پردازش کنید و تعداد هر کالا را با عکس قبلی مقایسه کنید تا نام کالا و میزان افزایش یا کاهش آن گزارش شود. بخش مقایسه و گزارش تغییرات باید در کد برنامهٔ شما پیادهسازی شود؛ خروجی تشخیص بهتنهایی این کار را انجام نمیدهد. فقط کالاهای قابلمشاهده قابلشمارشاند، نه اقلام پنهان پشت آنها. برای شروع، راهنمای مدیریت موجودی با YOLO را ببینید. منظورتان تشخیص دستههایی مثل نوشابه و بیسکویت است یا نام دقیق برند و نوع هر محصول؟