ExecuTorch로 모바일 및 엣지에 YOLO26 배포하기
스마트폰, 태블릿, 임베디드 시스템과 같은 엣지 기기에 컴퓨터 비전 모델을 배포하려면 성능과 리소스 제약의 균형을 맞춘 최적화 런타임이 필요합니다. 엣지 컴퓨팅을 위한 PyTorch 솔루션인 ExecuTorch는 Ultralytics YOLO 모델의 효율적인 온디바이스 추론을 지원합니다.
이 가이드에서는 Ultralytics YOLO 모델을 ExecuTorch 형식으로 내보내 최적화된 성능으로 모바일 및 엣지 디바이스에 배포하는 방법을 설명합니다.
ExecuTorch로 내보내는 이유는 무엇인가요?#
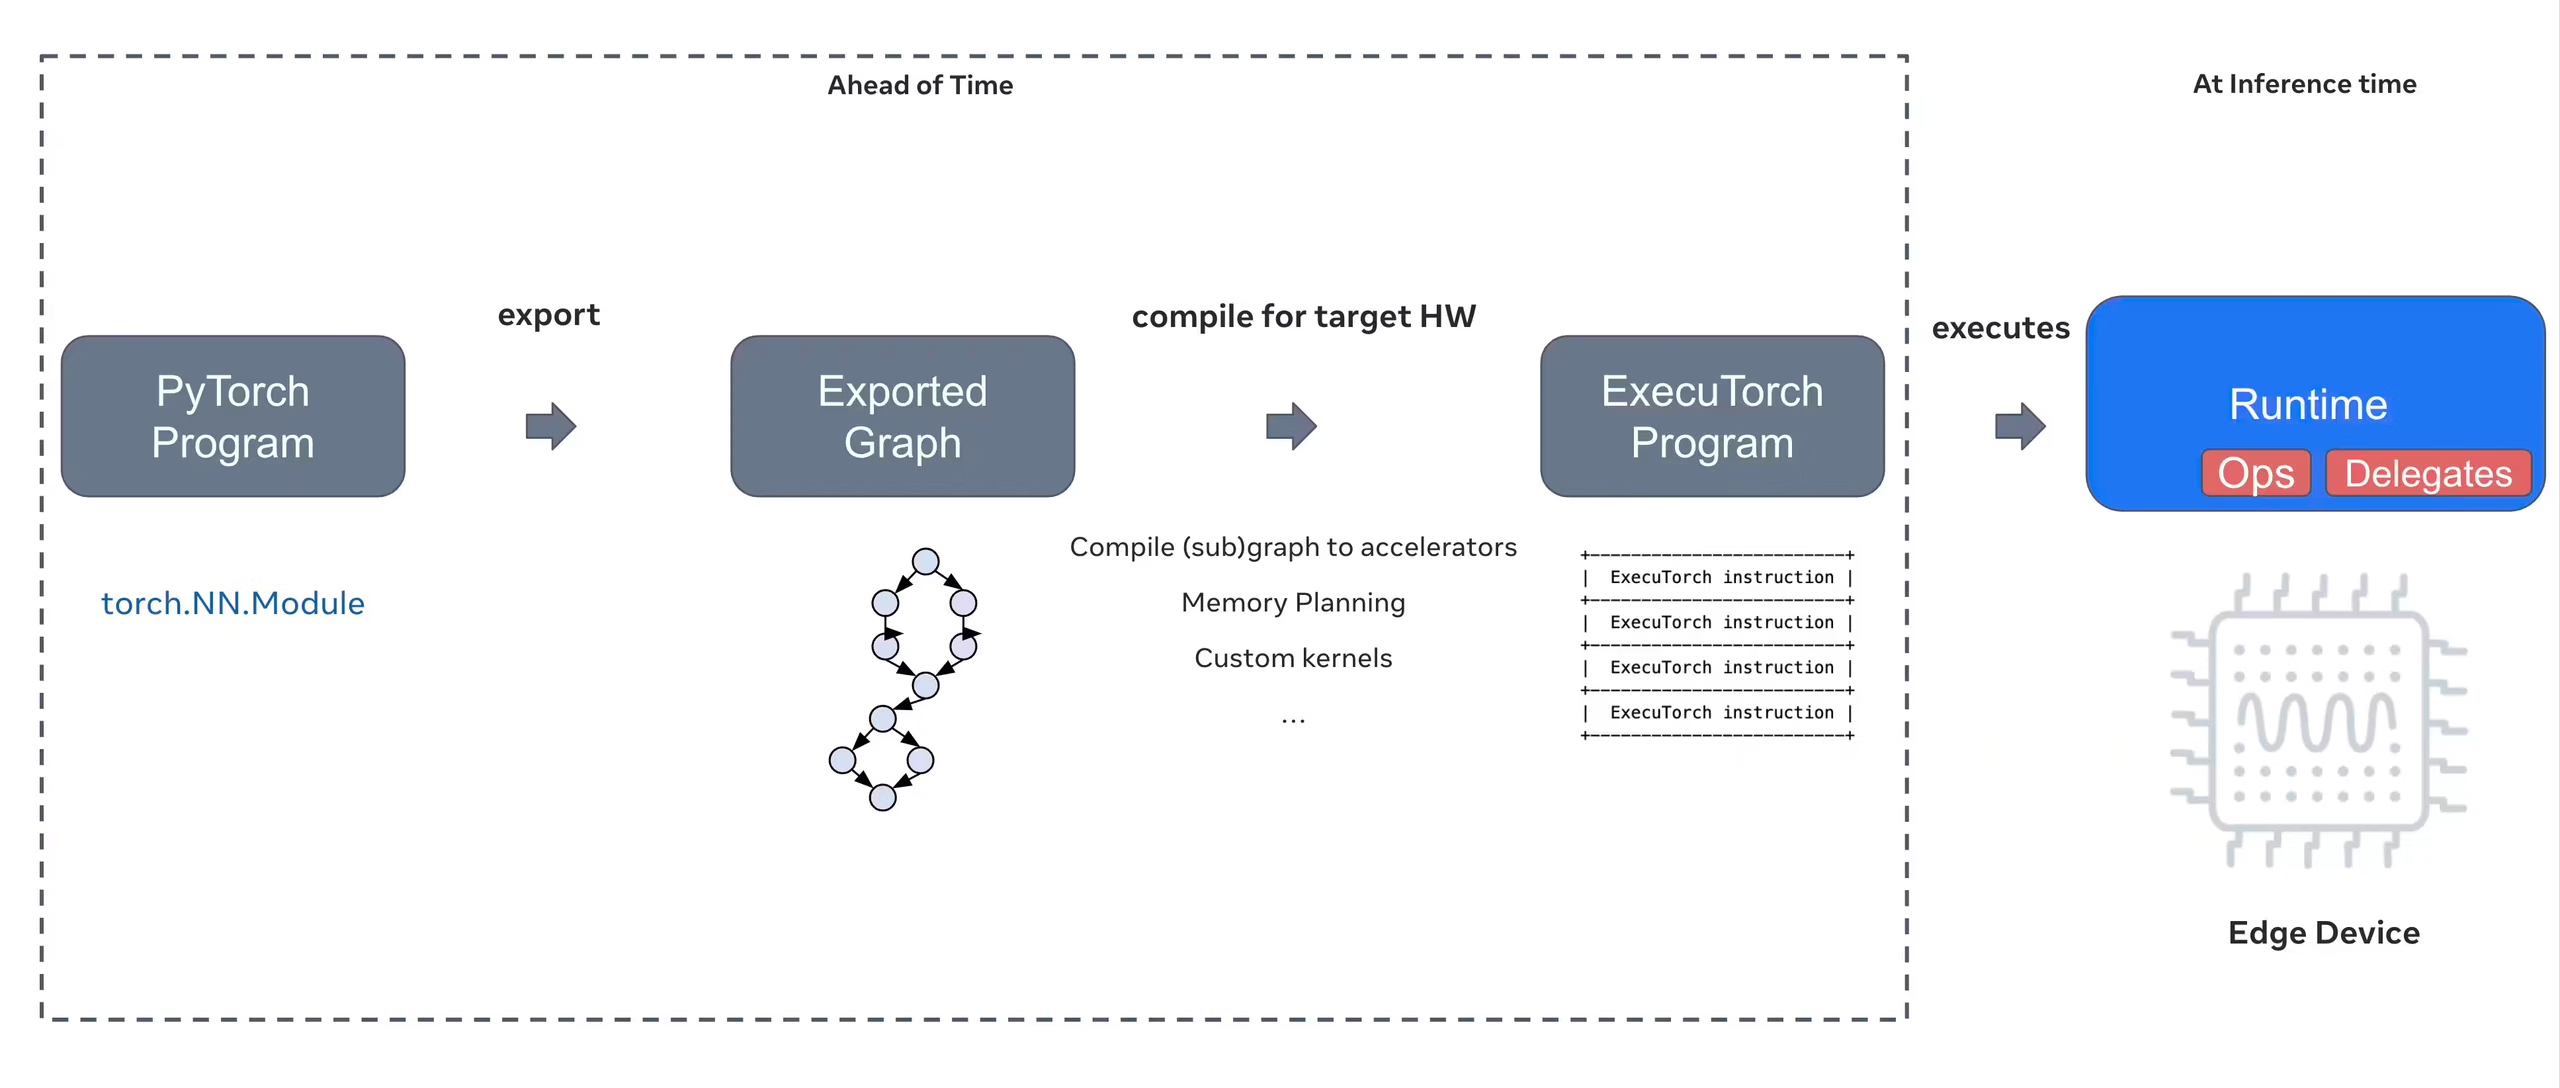
ExecuTorch는 모바일 및 엣지 디바이스 전반에서 온디바이스 추론 기능을 제공하는 PyTorch의 엔드 투 엔드 솔루션입니다. 이식성과 효율성을 목표로 설계된 ExecuTorch를 사용하면 다양한 컴퓨팅 플랫폼에서 PyTorch 프로그램을 실행할 수 있습니다.
ExecuTorch의 주요 기능#
ExecuTorch는 엣지 기기에 Ultralytics YOLO 모델을 배포하기 위한 여러 기능을 제공합니다:
-
이식 가능한 모델 형식: ExecuTorch는 리소스가 제한된 디바이스에서 크기와 로딩 속도를 최적화한
.pte(PyTorch ExecuTorch) 형식을 사용합니다. -
XNNPACK 백엔드: XNNPACK과의 기본 통합은 모바일 CPU에서 고도로 최적화된 추론을 제공하여 특수 하드웨어 없이도 우수한 성능을 구현합니다.
-
양자화 지원: ExecuTorch 생태계는 모델 크기를 줄이고 추론 속도를 높이는 양자화 기법을 지원합니다. Ultralytics는 기본적으로 FP32를 내보내며, XNNPACK 백엔드용으로
quantize=8을 사용해 정적 INT8을 내보냅니다. -
메모리 효율성: 최적화된 메모리 관리를 통해 런타임 메모리 사용량을 줄여 RAM이 제한된 디바이스에 적합합니다.
-
모델 메타데이터: 내보낸 모델에는 손쉬운 통합을 위해 이미지 크기, 클래스 이름 등의 메타데이터가 별도의 YAML 파일에 포함됩니다.
ExecuTorch를 사용한 배포 옵션#
ExecuTorch 모델은 다양한 엣지 및 모바일 플랫폼에 배포할 수 있습니다.
-
모바일 애플리케이션: iOS 및 Android 애플리케이션에 네이티브 성능으로 배포하여 모바일 앱에서 실시간 객체 탐지를 구현합니다.
-
임베디드 시스템: Raspberry Pi, NVIDIA Jetson 및 기타 ARM 기반 시스템과 같은 임베디드 Linux 디바이스에서 최적화된 성능으로 실행합니다.
-
엣지 AI 디바이스: 가속 추론을 위한 사용자 지정 delegate를 사용해 특수 엣지 AI 하드웨어에 배포합니다.
-
IoT 디바이스: 클라우드 연결 없이 온디바이스 추론을 수행하도록 IoT 디바이스에 통합합니다.
지원 작업#
ExecuTorch 내보내기는 Ultralytics의 7가지 작업을 모두 지원합니다. 시맨틱 세그멘테이션과 깊이 추정은 해당 헤드를 제공하는 유일한 제품군인 YOLO26에서만 사용할 수 있습니다.
Ultralytics YOLO26 모델을 ExecuTorch로 내보내기#
Ultralytics YOLO26 모델을 ExecuTorch 형식으로 변환하면 모바일 및 엣지 디바이스에 효율적으로 배포할 수 있습니다.
설치#
ExecuTorch 내보내기에는 Python 3.10-3.14 및 PyTorch >= 2.9.0이 필요합니다. ExecuTorch 모델을 내보내거나 로드하면 Ultralytics가 호환되는 executorch 패키지를 설치합니다. PyTorch 2.13 미만에서는 해당 패키지가 executorch<1.5로 고정되므로 직접 업그레이드하지 마세요.
# Install Ultralytics package
pip install ultralytics
설치 과정에 관한 자세한 지침과 모범 사례는 YOLO26 설치 가이드를 확인하세요. YOLO26에 필요한 패키지를 설치하는 중 문제가 발생하면 해결 방법과 팁이 담긴 일반적인 문제 가이드를 참조하세요.
사용법#
YOLO26 모델을 ExecuTorch로 내보내는 작업은 명령 하나로 수행할 수 있습니다.
ExecuTorch 형식은 내보내기, 예측, 검증 모드를 지원합니다. 모델을 내보낸 다음 내보낸 모델을 불러와 추론을 실행하거나 정확도를 검증하세요.
from ultralytics import YOLO

# YOLO26 모델 로드
model = YOLO("yolo26n.pt")

# 모델을 ExecuTorch 형식으로 내보냅니다
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# 내보낸 ExecuTorch 모델을 불러옵니다
model = YOLO("yolo26n_executorch_model")
# 추론 실행
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# 내보낸 ExecuTorch 모델을 불러옵니다
model = YOLO("yolo26n_executorch_model")
# COCO8 데이터셋에서 정확도 검증
metrics = model.val(data="coco8.yaml")ExecuTorch로 내보내면 .pte 파일과 메타데이터가 포함된 디렉터리가 생성됩니다. 모바일 또는 임베디드 애플리케이션에서 ExecuTorch 런타임을 사용해 .pte 모델을 불러오고 추론을 수행하세요.
내보내기 인수#
ExecuTorch 형식으로 내보낼 때는 다음 인수를 지정할 수 있습니다.
| 인수 | 유형 | 기본값 | 설명 |
|---|---|---|---|
format | str | 'executorch' | 내보낸 모델의 대상 형식으로, 다양한 배포 환경과의 호환성을 정의합니다. |
imgsz | int 또는 tuple | 640 | 모델 입력에 사용할 이미지 크기입니다. 정사각형 이미지에는 정수를 사용하고, 특정 크기에는 튜플 (height, width)을 사용할 수 있습니다. |
quantize | int 또는 str | None | 양자화 정밀도: 8(정적 INT8, int8 가중치 + int8 활성화, detect, segment, pose 및 OBB 헤드는 FP32로 유지; 보정 data/fraction 및 executorch>=1.6.0 필요) 또는 32/미설정(FP32)입니다. FP16 및 W8A16은 지원되지 않습니다. |
batch | int | 1 | 내보내기 모델의 배치 추론 크기 또는 predict 모드에서 내보낸 모델이 동시에 처리할 최대 이미지 수를 지정합니다. |
data | str | None | INT8 캘리브레이션에 사용하는 데이터셋 YAML입니다. 분류 작업에서는 데이터셋 디렉터리나 내장 데이터셋 이름을 대신 사용합니다. quantize=8을 함께 지정하지 않으면 Ultralytics가 모델 작업에 맞는 기본 캘리브레이션 데이터셋을 선택합니다. |
fraction | float, int 또는 list | 1.0 | 비율, 이미지 수 또는 [train, val, test] 비율/개수로 지정하는 보정 하위 집합입니다. 항목이 두 개인 목록에서는 test이 전체로 설정되고, 0는 건너뜁니다. |
device | str | None | 내보내기에 사용할 장치를 지정합니다. GPU(device=0), CPU(device=cpu), Apple 실리콘용 MPS(device=mps)를 사용할 수 있습니다. |
출력 구조#
ExecuTorch로 내보내면 모델과 메타데이터가 포함된 디렉터리가 생성됩니다.
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
내보낸 ExecuTorch 모델 사용하기#
모델을 내보낸 후 ExecuTorch 런타임을 사용해 대상 애플리케이션에 통합해야 합니다.
모바일 통합#
모바일 애플리케이션(iOS/Android)의 경우 다음 단계를 수행해야 합니다.
- ExecuTorch 런타임 추가: 모바일 프로젝트에 ExecuTorch 런타임 라이브러리를 포함합니다.
- 모델 불러오기: 애플리케이션에서
.pte파일을 불러옵니다. - 추론 실행: 이미지를 처리하고 예측 결과를 가져옵니다.
iOS#
iOS 통합 예시 (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://docs.pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Maven Central에서 ExecuTorch Android AAR을 추가합니다:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Android 통합 예시 (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val predictions = outputs[0].toTensor().dataAsFloatArray
임베디드 Linux#
임베디드 Linux 시스템에서는 ExecuTorch C++ API를 사용합니다:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
애플리케이션에 ExecuTorch를 통합하는 방법에 관한 자세한 내용은 ExecuTorch 문서를 참조하세요.
성능 최적화#
모델 크기 최적화#
배포용 모델 크기를 줄이려면 다음을 수행합니다:
- 더 작은 모델 사용: 가장 작은 공간을 차지하는 YOLO26n(nano) 모델부터 시작합니다.
- 입력 해상도 낮추기: 더 작은 이미지 크기를 사용합니다 (예:
imgsz=320또는imgsz=416). - 양자화:
quantize=8과 보정 데이터셋(data)을 사용해 FP32보다 약 3배 작은 정적 INT8 모델을 YOLO26n용으로 내보냅니다.
추론 속도 최적화#
더 빠른 추론을 위해 다음을 수행합니다:
- XNNPACK 백엔드: 기본 XNNPACK 백엔드는 최적화된 CPU 추론을 제공합니다
- 하드웨어 가속: 플랫폼별 delegate를 사용합니다 (예: iOS용 CoreML).
- 배치 처리: 가능한 경우 여러 이미지를 처리합니다
벤치마크#
Ultralytics 팀은 YOLO26 모델을 벤치마크하여 PyTorch와 ExecuTorch의 속도와 정확도를 비교했습니다.
| 모델 | 형식 | 상태 | 크기(MB) | metrics/mAP50-95(B) | 추론 시간(ms/이미지) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
추론 시간에는 전처리 및 후처리가 포함되지 않습니다.
문제 해결#
일반적인 문제#
문제: Python version error
해결 방법: ExecuTorch에는 Python 3.10~3.14가 필요합니다. 지원되는 버전으로 환경을 만듭니다.
# Using conda
conda create -n executorch python=3.14
conda activate executorch
문제 해결에 관한 자세한 도움말은 Ultralytics GitHub Issues 또는 ExecuTorch 문서를 참조하세요.
요약#
YOLO26 모델을 ExecuTorch 형식으로 내보내면 효율적인 모바일 및 엣지 기기 배포가 가능합니다. PyTorch 네이티브 통합, 크로스 플랫폼 지원, 최적화된 성능을 갖춘 ExecuTorch는 엣지 AI 애플리케이션에 적합한 선택입니다.
핵심 요점:
- ExecuTorch는 우수한 성능을 갖춘 PyTorch 네이티브 엣지 배포를 제공합니다.
format='executorch'인수를 사용해 내보냅니다.- XNNPACK 백엔드를 통해 모바일 CPU에 맞게 모델을 최적화합니다
- iOS, Android 및 임베디드 Linux 플랫폼을 지원합니다
- Python 3.10-3.14 및 PyTorch >= 2.9.0 필요
자주 묻는 질문#
Python 또는 CLI를 사용하여 YOLO26 모델을 ExecuTorch로 내보냅니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
또는
yolo export model=yolo26n.pt format=executorchExecuTorch 내보내기에는 다음이 필요합니다:
- Python 3.10~3.14
- 자동으로 설치되는
executorch패키지 (PyTorch 2.13 미만에서는executorch<1.5이 설치되며, 최신 ExecuTorch 런타임은 이를 지원하지 않습니다.) - PyTorch (ultralytics와 함께 자동으로 설치됨)
참고:
executorch패키지에는 사전 빌드된 wheel (XNNPACK 백엔드 포함)이 제공되므로 내보내는 동안 추가 컴파일 단계가 필요하지 않습니다.ExecuTorch 모델은 Python에서 추론 및 검증을 위해
YOLO()으로 직접 로드할 수 있으며 (위의 Predict/Validate 예시 참조), ExecuTorch 런타임 라이브러리를 사용하여 모바일 및 엣지 디바이스에 배포할 수도 있습니다.ExecuTorch는 다음을 지원합니다:
- 모바일: iOS 및 Android
- 임베디드 Linux: Raspberry Pi, NVIDIA Jetson 및 기타 ARM 디바이스
- 데스크톱: Linux, macOS 및 Windows (개발용)
ExecuTorch와 LiteRT는 모두 모바일 배포에 적합합니다:
- ExecuTorch: PyTorch 통합이 더 뛰어나고, PyTorch 네이티브 워크플로를 지원하며, 생태계가 성장하고 있습니다
- LiteRT: 더 성숙하고, 하드웨어 지원 범위가 넓으며, 배포 예시가 더 많고, Android, iOS 및 브라우저에서 동일한 모델을 실행합니다
이미 PyTorch를 사용하고 있고 네이티브 배포 경로를 원한다면 ExecuTorch를 선택하세요. 호환성과 성숙한 도구를 최우선으로 고려한다면 LiteRT를 선택하세요.
예. ExecuTorch는 다양한 백엔드를 통해 하드웨어 가속을 지원합니다:
- 모바일 GPU: Vulkan, Metal 또는 OpenCL delegate를 통해 지원합니다
- NPU/DSP: 플랫폼별 delegate를 통해 지원합니다
- 기본값: 최적화된 CPU 추론을 위한 XNNPACK
백엔드별 설정은 ExecuTorch 문서를 참조하세요.


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.