IBM Watsonx로 YOLO26 모델을 학습하는 단계별 가이드
확장 가능한 컴퓨터 비전 솔루션에는 데이터, 학습, 배포를 위한 인프라가 필요합니다. IBM Watsonx는 AI 모델의 개발, 배포, 관리를 지원하는 AI 및 데이터 플랫폼입니다. AI 라이프사이클 전체를 다루며 IBM Cloud 서비스와 통합됩니다.
Ultralytics YOLO26 모델은 IBM Watsonx를 사용해 학습할 수 있습니다. 효율적인 모델 학습, 특정 작업에 맞춘 미세 조정, 강력한 도구와 사용자 친화적인 설정을 통한 모델 성능 개선에 관심 있는 기업에 적합한 선택입니다. 이 가이드에서는 환경 설정부터 학습된 모델 평가까지 IBM Watsonx로 YOLO26을 학습하는 과정을 안내합니다.
IBM Watsonx란 무엇인가요?#
Watsonx는 상업용 생성형 AI와 과학 데이터를 위해 설계된 IBM의 클라우드 기반 플랫폼입니다. IBM Watsonx의 세 가지 구성 요소인 watsonx.ai, watsonx.data, watsonx.governance가 함께 작동하여 비즈니스 문제 해결을 목표로 하는 AI 프로젝트를 가속화할 수 있는 엔드투엔드 신뢰형 AI 플랫폼을 구축합니다. 이 플랫폼은 도구 구축, 학습, 머신러닝 모델 배포를 위한 도구를 제공하고 다양한 데이터 소스에 쉽게 연결할 수 있도록 합니다.
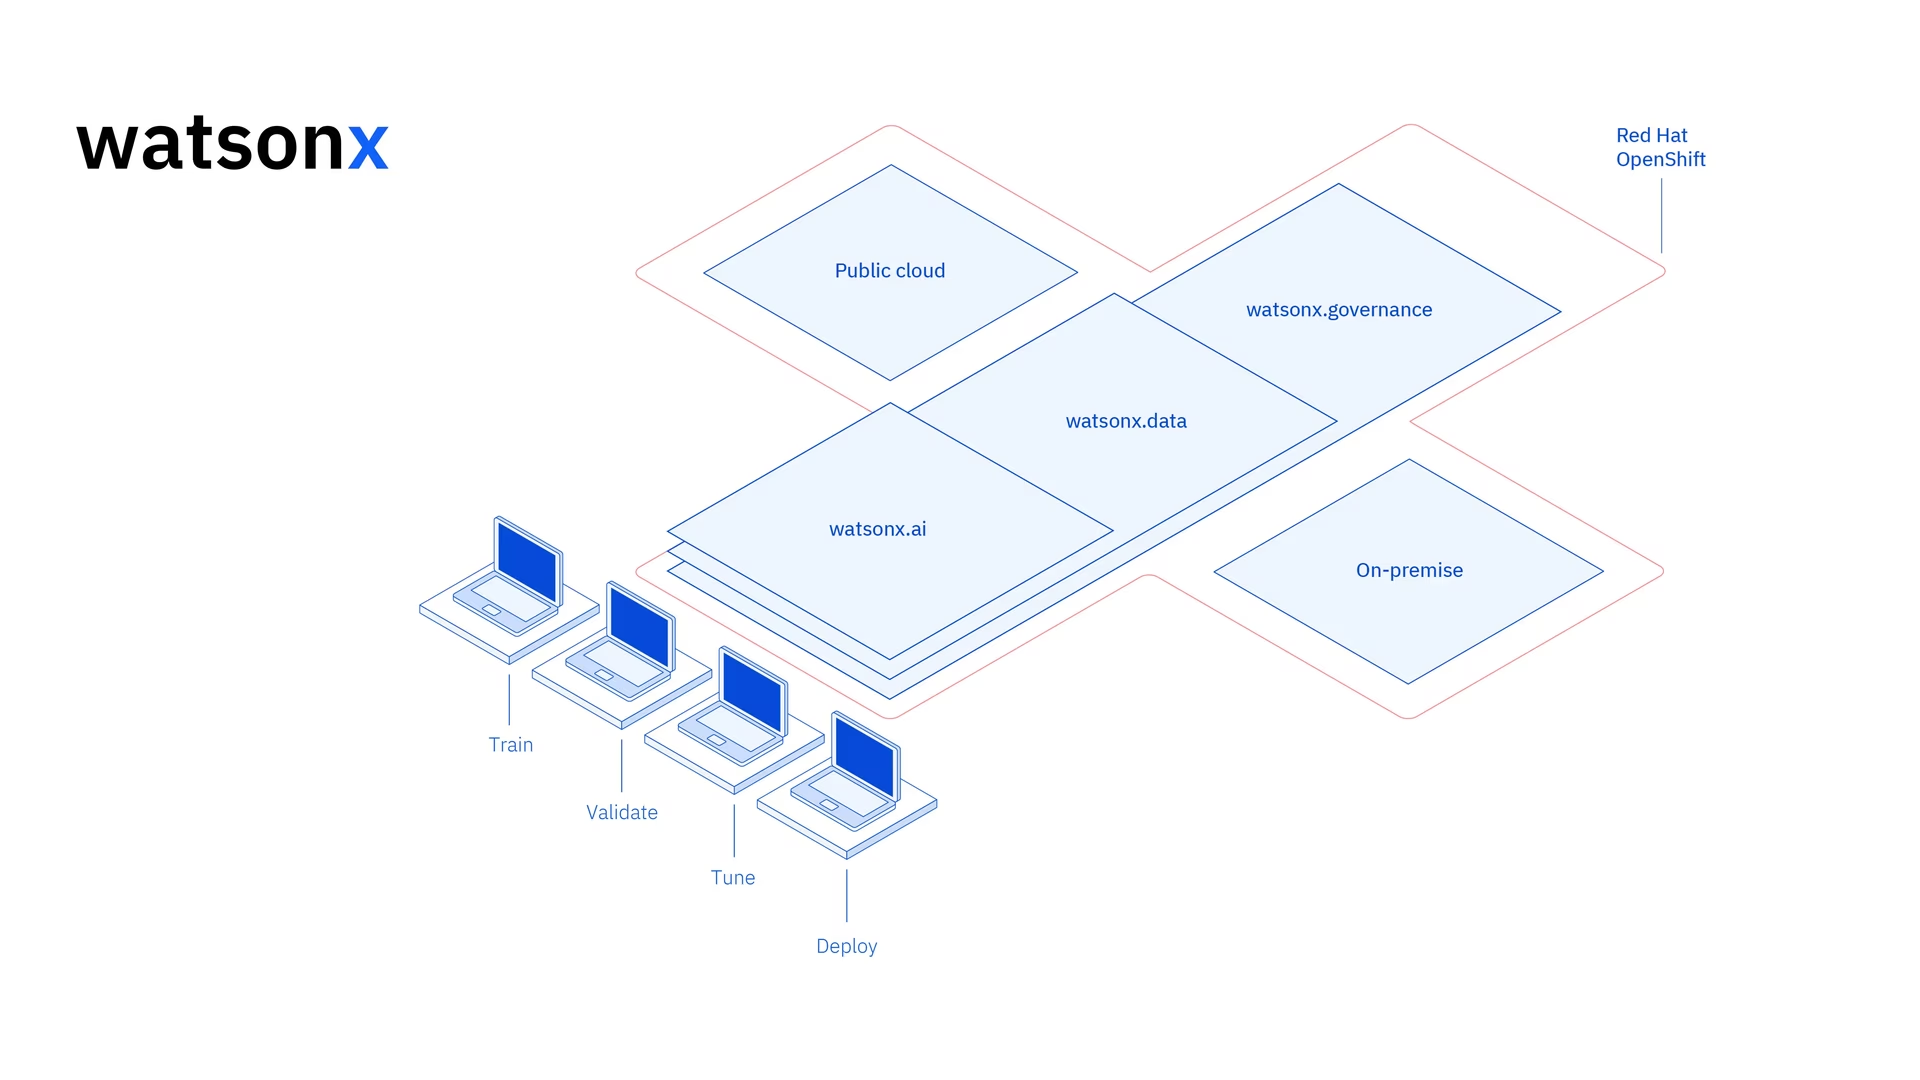
IBM Watsonx의 인터페이스와 협업 기능은 모델 개발, 관리, 배포를 지원합니다. IBM Watsonx는 컴퓨터 비전, 예측 분석, 자연어 처리 및 기타 AI 애플리케이션을 지원합니다.
IBM Watsonx의 주요 기능#
IBM Watsonx는 세 가지 주요 구성 요소인 watsonx.ai, watsonx.data, watsonx.governance로 구성됩니다. 각 구성 요소는 AI 및 데이터 관리의 서로 다른 측면을 담당합니다.
Watsonx.ai#
Watsonx.ai는 AI 개발 도구를 제공하며 IBM 지원 맞춤 모델, Llama 3와 같은 타사 모델, IBM 자체 Granite 모델을 이용할 수 있게 합니다. AI 프롬프트 실험을 위한 Prompt Lab과 레이블이 지정된 데이터로 모델 성능을 개선하는 Tuning Studio가 포함되어 있습니다. 또한 AI 모델 수명 주기를 자동화하고 다양한 API 및 라이브러리에 연결하는 종합 도구를 제공합니다.
Watsonx.data#
Watsonx.data는 클라우드 및 온프레미스 배포를 모두 지원합니다. 사용하기 쉬운 콘솔에서 여러 환경의 데이터에 중앙 집중식으로 액세스할 수 있으며, 일반 SQL을 사용해 데이터를 손쉽게 탐색할 수 있습니다. Presto 및 Spark와 같은 효율적인 쿼리 엔진으로 워크로드를 최적화하고, AI 기반 시맨틱 계층으로 데이터 인사이트 도출을 가속화합니다. AI 관련성을 위한 벡터 데이터베이스를 포함하며, 분석 및 AI 데이터를 쉽게 공유할 수 있도록 개방형 데이터 형식을 지원합니다.
Watsonx.governance#
Watsonx.governance는 규제 변경 사항을 자동으로 식별하고 정책을 시행하여 규정 준수를 간소화합니다. 요구 사항을 내부 위험 데이터와 연결하고 최신 AI 팩트시트를 제공합니다. 이 플랫폼은 알림과 편향 및 드리프트와 같은 문제를 탐지하는 도구로 위험 관리를 지원합니다. 또한 AI 수명 주기의 모니터링 및 문서화를 자동화하고, 모델 인벤토리로 AI 개발을 체계화하며, 사용자 친화적인 대시보드와 보고 도구로 협업을 강화합니다.
IBM Watsonx를 사용하여 YOLO26을 학습하는 방법#
IBM Watsonx를 사용하여 YOLO26 모델 학습 워크플로를 가속화할 수 있습니다.
사전 요구 사항#
watsonx.ai 프로젝트를 만들려면 IBM Cloud 계정이 필요하며, 데이터 세트를 불러오려면 Kaggle 계정도 필요합니다.
1단계: 환경 설정#
먼저 Jupyter Notebook을 사용하기 위한 IBM 계정을 설정해야 합니다. IBM Cloud 계정으로 watsonx.ai에 로그인합니다.
그런 다음 watsonx.ai 프로젝트와 Jupyter Notebook을 만듭니다.
이 작업을 완료하면 데이터 세트를 불러올 수 있는 노트북 환경이 열립니다. 이 튜토리얼의 코드를 사용해 간단한 객체 탐지 모델을 학습할 수 있습니다.
2단계: 관련 라이브러리 설치 및 가져오기#
그다음 필요한 Python 라이브러리를 설치하고 가져옵니다.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
설치 절차에 대한 자세한 지침과 모범 사례는 Ultralytics 설치 가이드를 참조하세요. YOLO26에 필요한 패키지를 설치하는 중 문제가 발생하면 해결 방법과 팁을 확인할 수 있는 일반적인 문제 가이드를 참조하세요.
그런 다음 필요한 패키지를 가져옵니다.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
3단계: 데이터 로드#
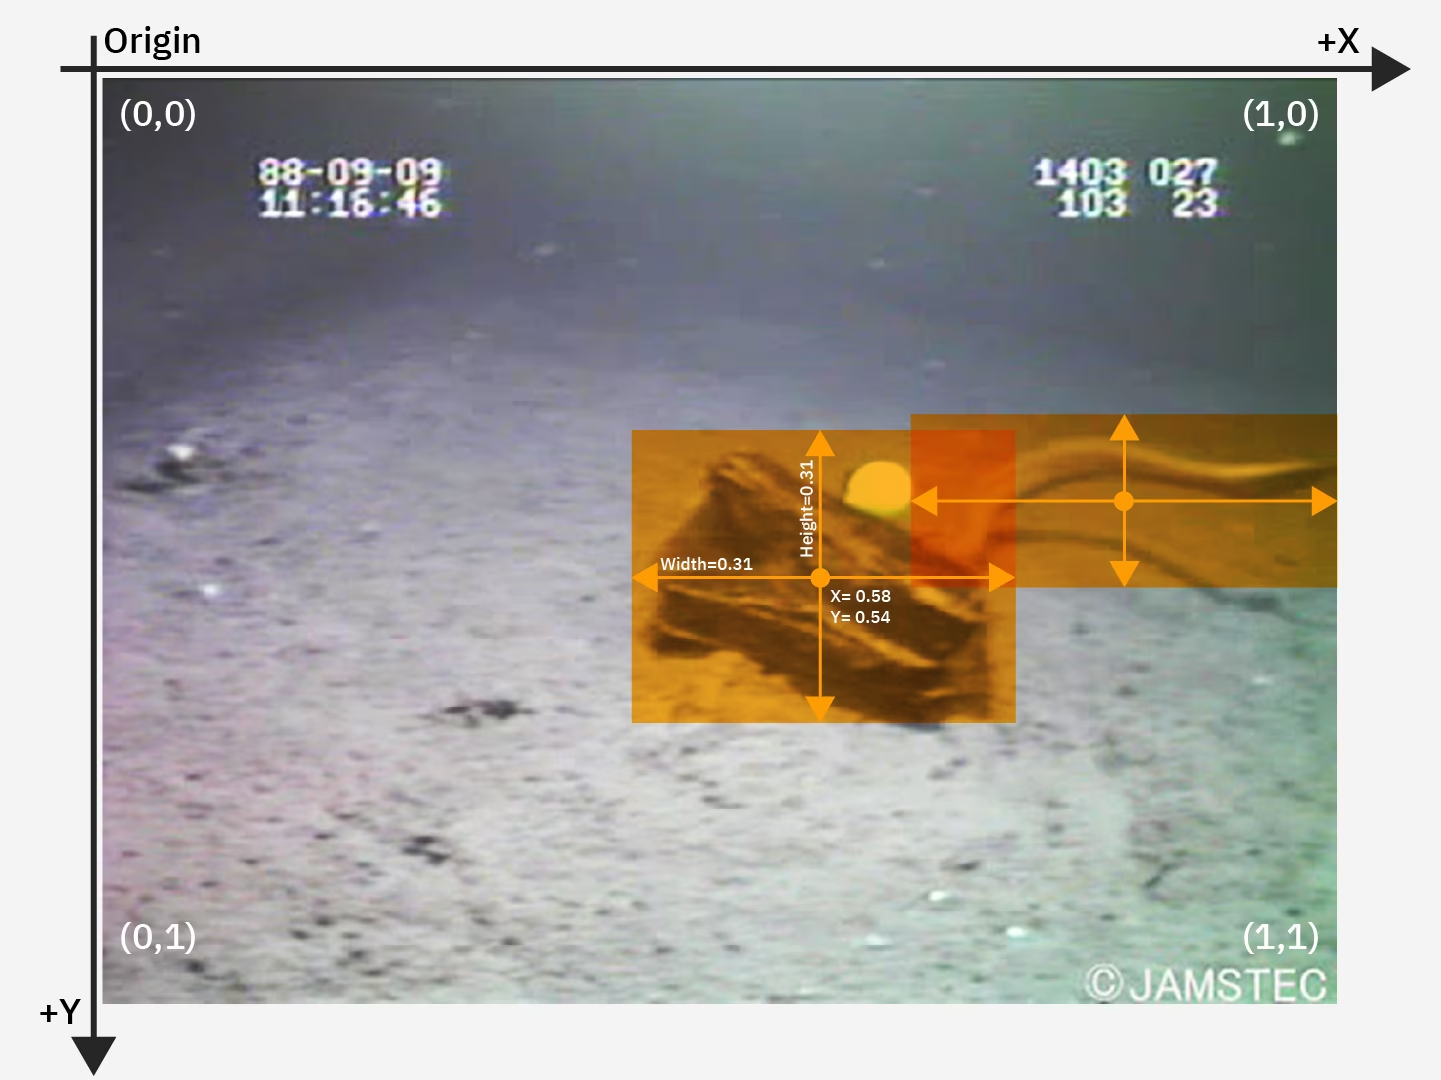
이 튜토리얼에서는 Kaggle에서 제공하는 해양 쓰레기 데이터 세트를 사용합니다(Ultralytics Platform의 Trash-ICRA19로도 제공됩니다). 이 데이터 세트로 YOLO26 모델을 커스텀 학습하여 수중 이미지에서 쓰레기와 생물학적 객체를 탐지하고 분류합니다.
Kaggle API를 사용하여 데이터 세트를 노트북에 직접 로드할 수 있습니다. 먼저 무료 Kaggle 계정을 만듭니다. 계정을 만든 다음 API 키를 생성해야 합니다. 키 생성 방법은 Kaggle API 문서의 "API credentials" 섹션에서 확인할 수 있습니다.
다음 코드에 Kaggle 사용자 이름과 API 키를 복사하여 붙여넣습니다. 그런 다음 코드를 실행하여 API를 설치하고 데이터 세트를 Watsonx에 로드합니다.
# Install kaggle
pip install kaggle
Kaggle을 설치한 후 데이터 세트를 Watsonx에 로드할 수 있습니다.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
데이터 세트를 불러온 후 작업 디렉터리를 출력하고 저장했습니다. 또한 "trash_ICRA19" 데이터 세트가 제대로 불러와졌는지 확인하기 위해 작업 디렉터리의 내용을 출력했습니다.
디렉터리 내용에 "trash_ICRA19"가 표시되면 데이터 세트가 성공적으로 로드된 것입니다. 파일 또는 디렉터리 세 개, 즉 config.yaml 파일, videos_for_testing 디렉터리, dataset 디렉터리가 표시되어야 합니다. videos_for_testing 디렉터리는 사용하지 않으므로 삭제해도 됩니다.
객체 탐지 모델을 학습하는 데 config.yaml 파일과 데이터 세트 디렉터리의 내용을 사용합니다. 다음은 해양 쓰레기 데이터 세트의 샘플 이미지입니다.
4단계: 데이터 전처리#
해양 쓰레기 데이터 세트의 모든 레이블은 이미 YOLO .txt 파일 형식으로 지정되어 있습니다. 하지만 모델이 이미지를 찾을 수 있도록 이미지 및 레이블 디렉터리를 재구성해야 합니다. 현재 불러온 데이터 세트 디렉터리의 구조는 다음과 같습니다.
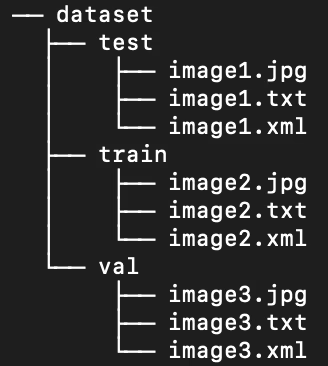
기본적으로 YOLO 모델은 각 train/val/test 분할 내에 별도의 images 및 labels 하위 디렉터리가 있어야 합니다. 디렉터리를 다음 구조로 재구성해야 합니다.
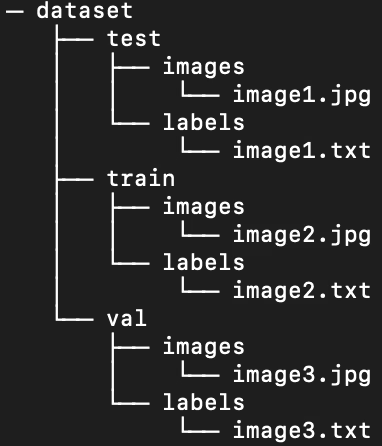
데이터 세트 디렉터리를 재구성하려면 다음 스크립트를 실행하면 됩니다.
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
다음으로 데이터 세트 YAML 파일을 수정해야 합니다. 다음은 .yaml 파일에 사용할 설정입니다. 클래스 ID 번호는 0부터 시작합니다.
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
현재 config.yaml의 내용을 삭제하고 새 데이터 세트 디렉터리 구조를 반영하는 설정으로 바꾸려면 다음 스크립트를 실행하세요. 스크립트는 앞서 정의한 work_dir 변수를 자동으로 사용하므로 실행하기 전에 해당 변수가 데이터 세트를 가리키는지 확인하고, train, val, test 하위 디렉터리 정의는 변경하지 마세요.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
5단계: YOLO26 모델 학습#
다음 명령을 실행하여 사전 학습된 YOLO26n 모델을 파인튜닝하세요.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=True모델 학습 명령의 매개변수를 자세히 살펴보겠습니다.
- detect: 지정된 YOLO 모델 및 데이터 세트에 사용할 컴퓨터 비전 작업입니다.
- train: 지정된 모델과 데이터를 로드하는 목적을 나타내는 모드입니다. 나중에 모델 성능을 테스트할 때는
predict을 사용합니다. - epochs: YOLO26이 전체 데이터 세트를 통과하는 횟수입니다.
- batch: 모델이 파라미터를 업데이트하기 전에 처리하는 이미지 수인 학습 배치 크기입니다.
- plots: YOLO가 모델의 학습 및 평가 지표 그래프를 생성하고 저장하도록 합니다.
모델 학습 과정과 모범 사례를 자세히 이해하려면 YOLO26 모델 학습 가이드를 참조하세요. 이 가이드는 실험을 최대한 활용하고 YOLO26을 효과적으로 사용하는 데 도움이 됩니다.
6단계: 모델 테스트#
이제 파인튜닝된 모델의 성능을 테스트하기 위해 추론을 실행할 수 있습니다:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=True이 명령은 테스트 세트의 각 이미지에 대한 예측 레이블과 원본 이미지 위에 예측된 바운딩 박스를 오버레이한 새 출력 이미지 파일을 생성합니다.
각 이미지의 예측된 .txt 레이블은 save_txt=True 인수를 통해 저장되며, 바운딩 박스가 오버레이된 출력 이미지는 save=True 인수를 통해 생성됩니다. conf=0.5 매개변수는 신뢰도 수준이 50% 미만인 예측을 모두 무시하도록 모델에 지시합니다.
마지막으로 iou=.5은 비최대 억제(NMS) 임계값을 설정합니다. 같은 클래스의 박스가 더 높은 점수의 박스와 50% 넘게 겹치면 제거됩니다. 이를 통해 동일한 객체에 대해 생성되는 중복 박스를 줄입니다. 예측 바운딩 박스가 오버레이된 이미지를 불러와 몇 개 이미지에서 모델의 성능을 확인할 수 있습니다.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
위 코드는 테스트 세트에서 이미지 10개를 표시하고, 각 이미지에 예측된 경계 상자, 클래스 이름 레이블 및 신뢰도 수준을 함께 보여 줍니다.
7단계: 모델 평가#
각 클래스의 모델 정밀도와 재현율을 시각화할 수 있습니다. 이러한 시각화는 학습 실행 디렉터리({work_dir}/runs/detect/train/)에 저장됩니다. 정밀도 점수는 BoxP_curve.png에 표시됩니다.
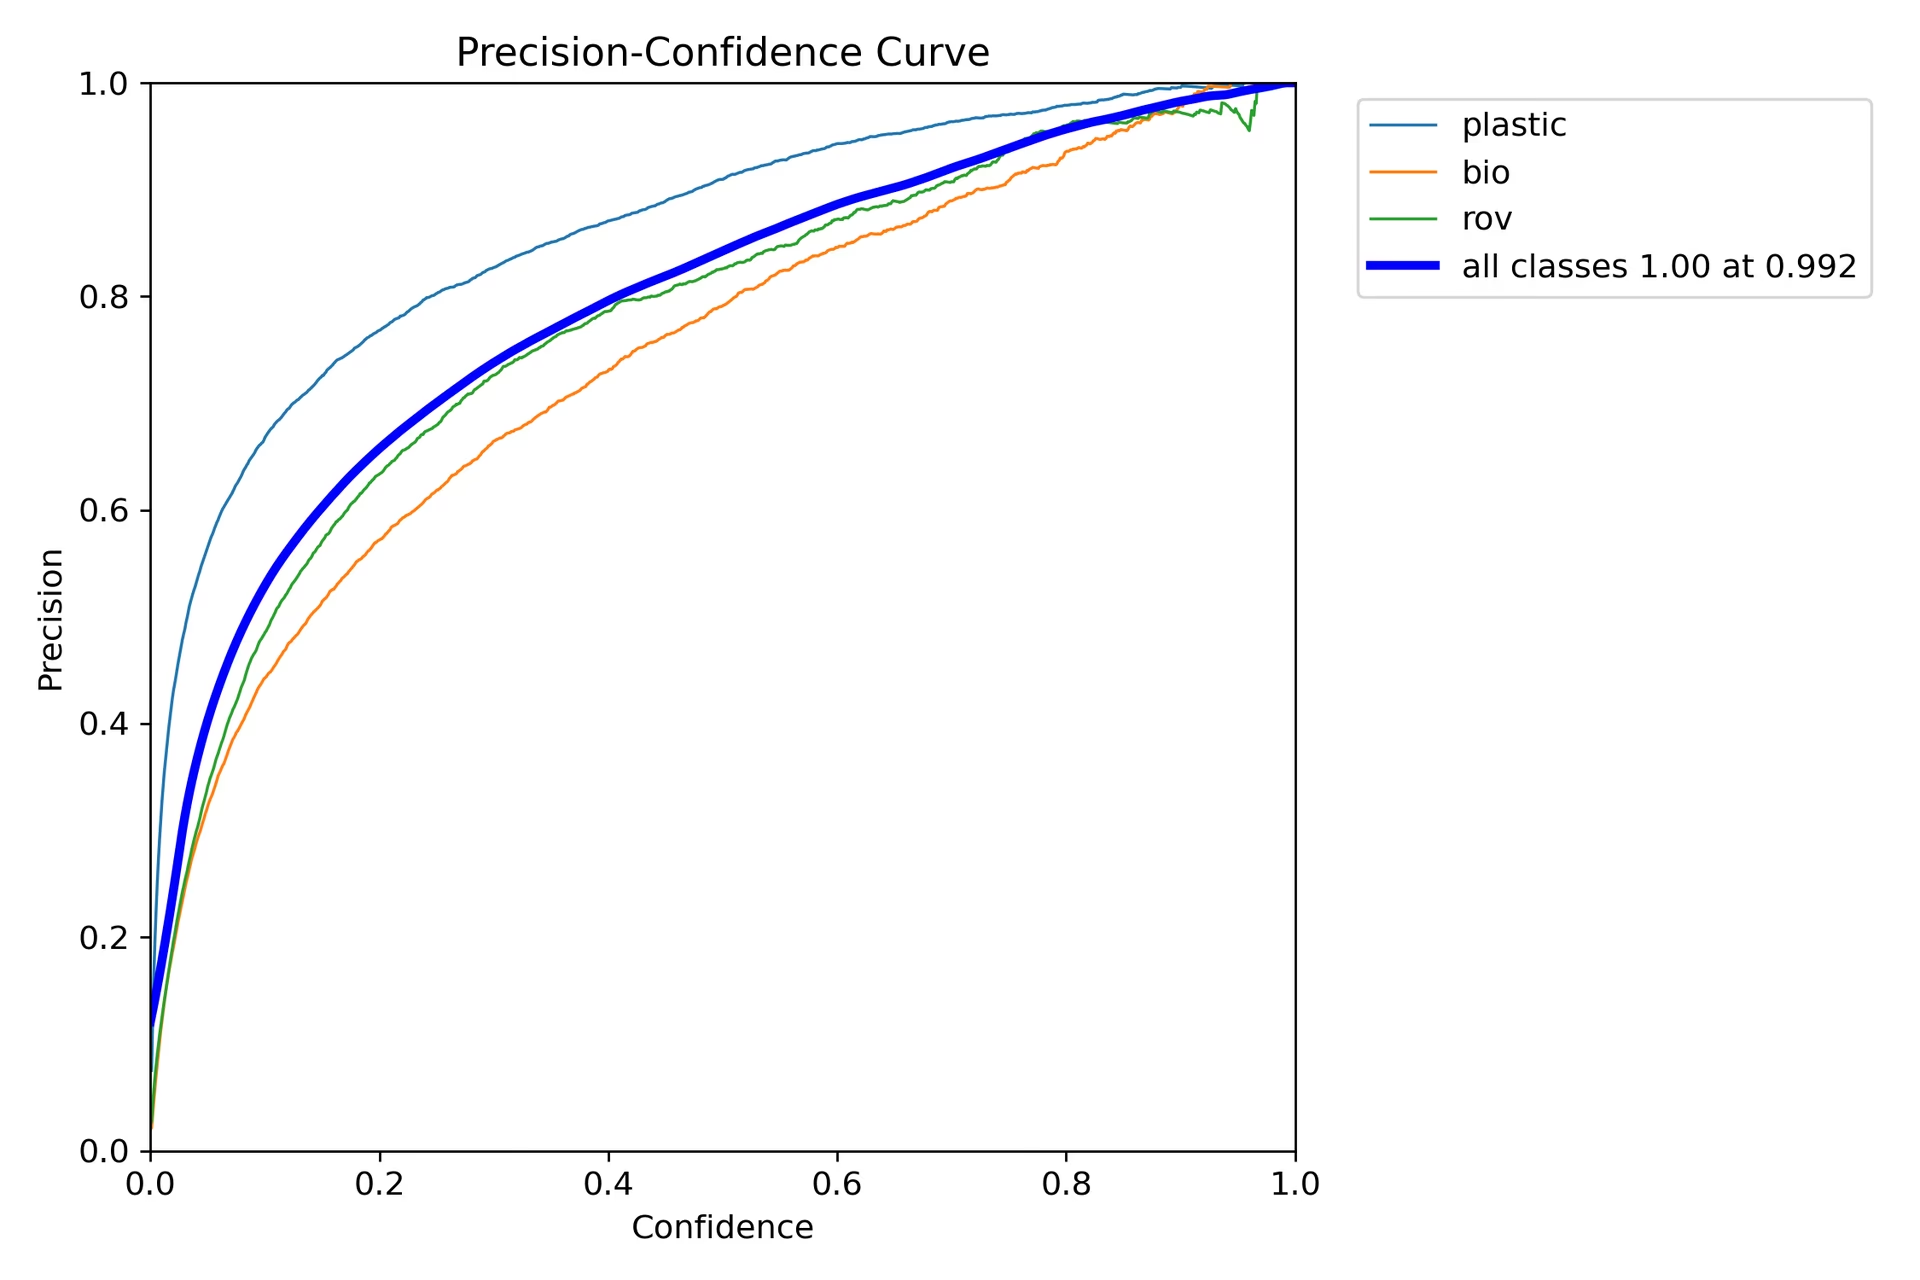
그래프는 예측 신뢰도 임계값이 높아질수록 정밀도가 상승하는 것을 보여줍니다. 하지만 두 번의 에포크가 지난 후에도 모델의 정밀도는 특정 신뢰도 수준에서 아직 안정화되지 않았습니다.
재현율 그래프(BoxR_curve.png)는 반대 추세를 보여줍니다.
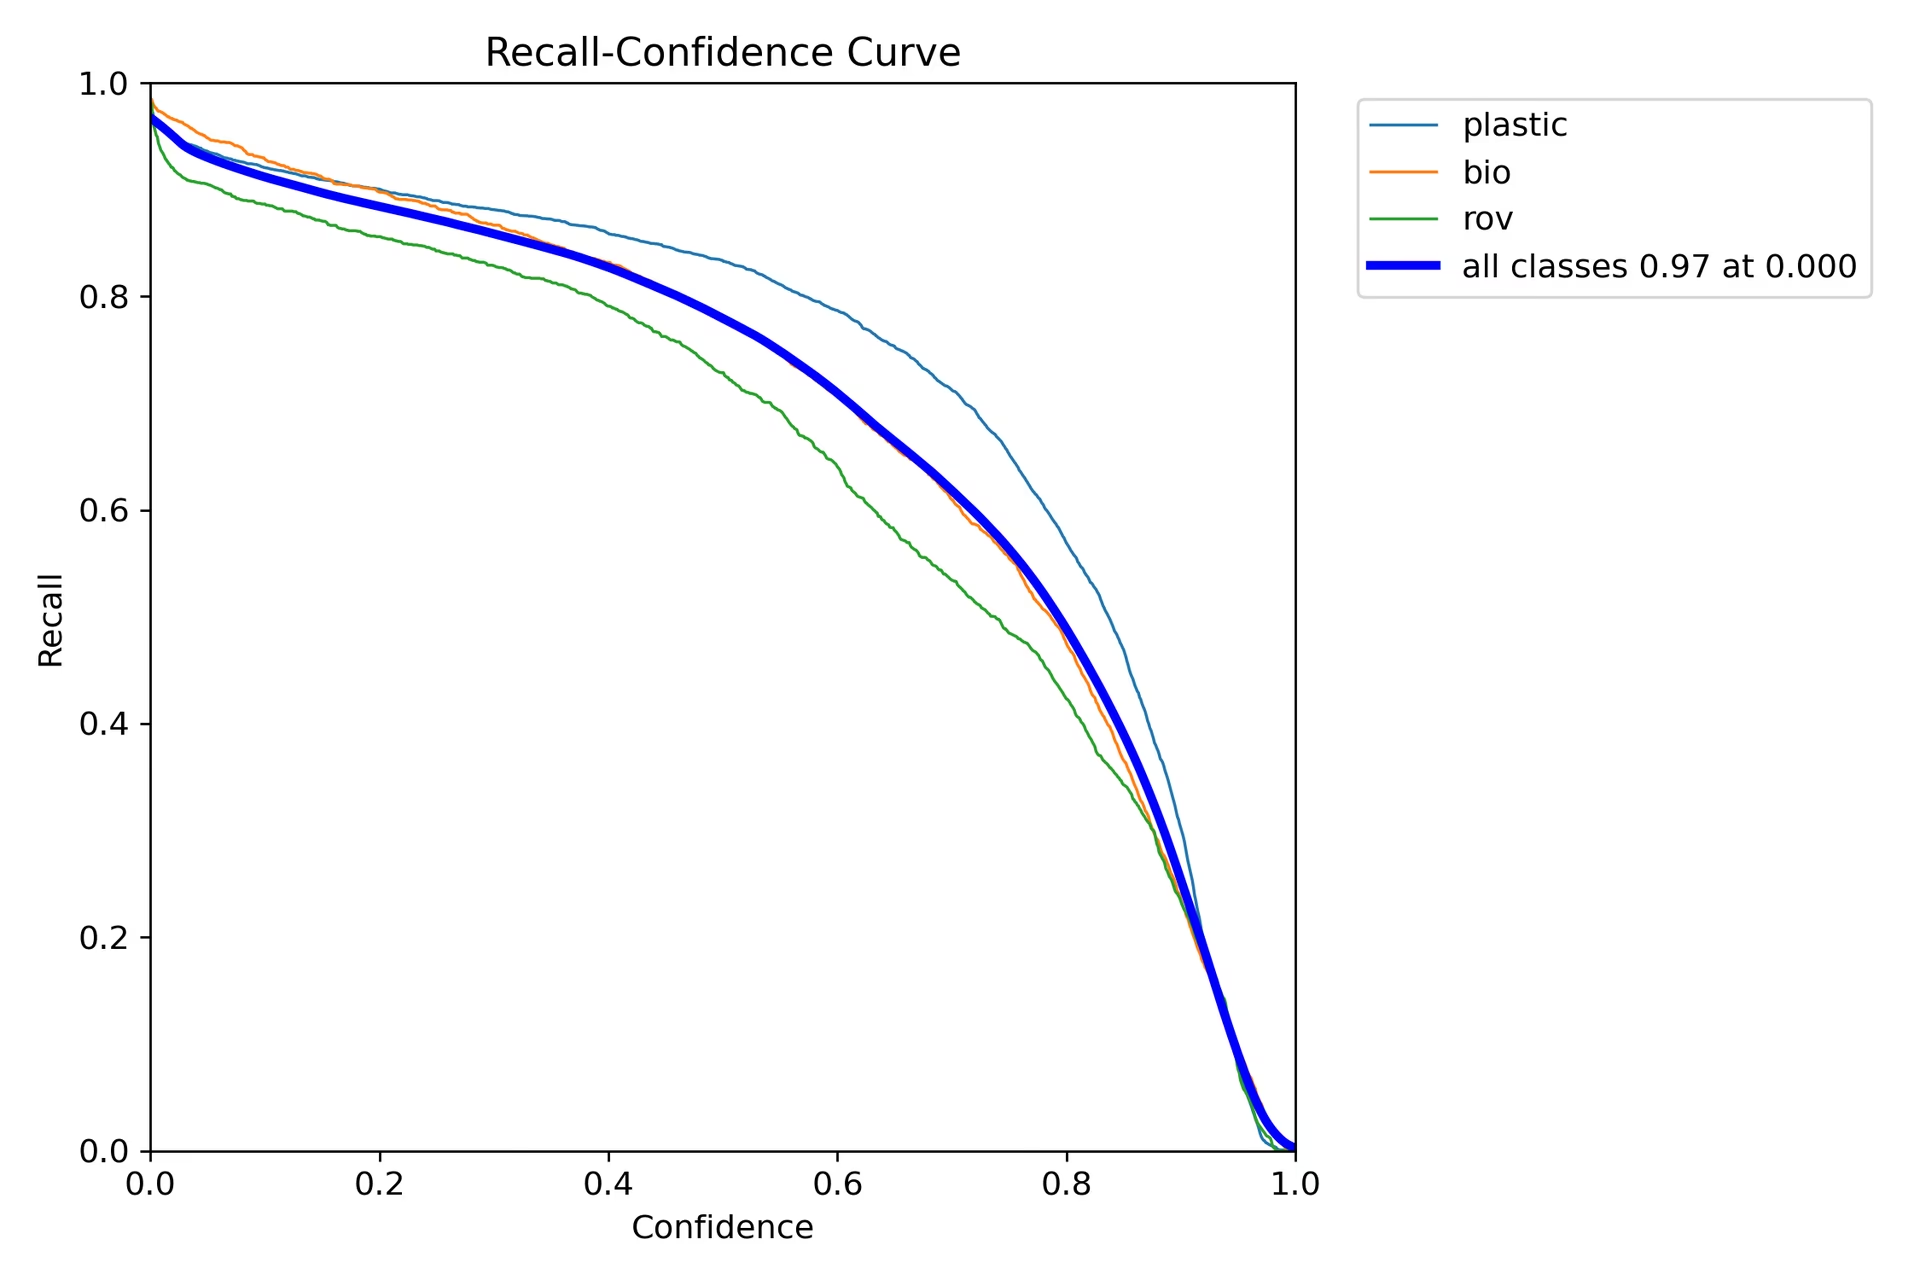
정밀도와 달리 재현율은 신뢰도 임계값이 낮을 때 가장 높으며 임계값이 높아질수록 낮아집니다. 이는 정밀도와 재현율 간의 상충 관계를 보여줍니다.
8단계: 교집합 대비 합집합 계산#
동일 객체에 대해 예측된 바운딩 박스와 실제 바운딩 박스 간의 교집합 대비 합집합(IoU)을 계산하여 위치 정확도를 측정할 수 있습니다.
요약#
IBM Watsonx의 주요 기능과 IBM Watsonx를 사용해 YOLO26 모델을 학습시키는 방법을 살펴보았습니다. IBM Watsonx는 모델 구축, 데이터 관리 및 규정 준수를 위한 도구도 제공합니다.
사용 방법에 대한 자세한 내용은 IBM Watsonx 공식 문서를 참조하세요.
자주 묻는 질문#
IBM Watsonx를 사용해 YOLO26 모델을 학습하려면 다음 단계를 따르세요:
- 환경 설정: IBM Cloud 계정을 만들고 Watsonx.ai 프로젝트를 설정합니다. 코딩 환경으로 Jupyter Notebook을 사용합니다.
- 라이브러리 설치:
torch,opencv,ultralytics와 같은 필수 라이브러리를 설치합니다. - 데이터 불러오기: Kaggle API를 사용해 데이터셋을 Watsonx에 불러옵니다.
- 데이터 전처리: 데이터셋을 필요한 디렉터리 구조로 구성하고
.yaml구성 파일을 업데이트합니다. - 모델 학습: YOLO 명령줄 인터페이스를 사용하여
epochs및batch과 같은 매개변수로 모델을 학습합니다. - 테스트 및 평가: 추론을 실행해 모델을 테스트하고 정밀도 및 재현율과 같은 지표를 사용해 성능을 평가합니다.
자세한 지침은 YOLO26 모델 학습 가이드를 참조하세요.
IBM Watsonx는 AI 모델 학습을 위한 다음과 같은 주요 기능을 제공합니다:
- Watsonx.ai: IBM 지원 맞춤 모델 및 Llama 3와 같은 타사 모델에 대한 액세스를 포함해 AI 개발 도구를 제공합니다. 포괄적인 AI 수명 주기 관리를 위한 Prompt Lab과 Tuning Studio가 포함되어 있습니다.
- Watsonx.data: 클라우드 및 온프레미스 배포를 지원하며, 중앙 집중식 데이터 액세스, Presto 및 Spark와 같은 효율적인 쿼리 엔진, AI 기반 시맨틱 계층을 제공합니다.
- Watsonx.governance: 규정 준수를 자동화하고 알림을 통해 위험을 관리하며, 편향 및 드리프트와 같은 문제를 감지하는 도구를 제공합니다. 협업을 위한 대시보드와 보고 도구도 포함되어 있습니다.
자세한 내용은 IBM Watsonx 공식 문서를 참조하세요.
IBM Watsonx는 AI 수명 주기 전반을 아우르는 도구를 제공하므로 Ultralytics YOLO26 학습에 적합합니다. 주요 이점은 다음과 같습니다.
- 확장성: IBM Cloud 서비스를 사용해 모델 학습 규모를 쉽게 확장할 수 있습니다.
- 통합: 다양한 데이터 소스 및 API에 연결합니다.
- 사용하기 쉬운 인터페이스: 협업에 적합하고 직관적인 인터페이스로 개발 프로세스를 간소화합니다.
- 고급 도구: 모델 성능을 향상하는 Prompt Lab 및 Tuning Studio와 같은 도구를 사용할 수 있습니다.
IBM Watsonx에서 YOLO26을 학습하기 위해 데이터셋을 전처리하려면 다음을 수행하세요:
- 디렉터리 구성: 학습/검증/테스트 분할 내에서 이미지와 레이블을 별도의 하위 디렉터리에 저장하는 YOLO 디렉터리 구조를 데이터셋이 따르는지 확인합니다.
- .yaml 파일 업데이트: 새 디렉터리 구조와 클래스 이름을 반영하도록
.yaml구성 파일을 수정합니다. - 전처리 스크립트 실행: Python 스크립트를 사용해 데이터셋을 재구성하고 이에 맞게
.yaml파일을 업데이트합니다.
다음은 데이터셋을 구성하는 샘플 스크립트입니다:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
자세한 내용은 데이터 전처리 가이드를 참조하세요.
IBM Watsonx에서 YOLO26 모델 학습을 시작하기 전에 다음 사전 요구 사항을 충족하는지 확인하세요:
- IBM Cloud 계정: Watsonx.ai에 액세스할 수 있도록 IBM Cloud 계정을 만듭니다.
- Kaggle 계정: 데이터셋을 불러오려면 Kaggle 계정과 API 키가 필요합니다.
- Jupyter Notebook: 코딩 및 모델 학습을 위해 Watsonx.ai에서 Jupyter Notebook 환경을 설정합니다.
환경 설정에 대한 자세한 내용은 Ultralytics 설치 가이드를 참조하세요.


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.