배포를 위한 TFLite 모델 내보내기(지원 중단됨)#
Ultralytics 8.4.83부터 독립 실행형 tflite 내보내기 형식이 제거되고 통합 Google LiteRT 형식으로 대체되었습니다. LiteRT(Lite Runtime)는 TensorFlow Lite의 차세대 버전이자 새로운 이름이며, 동일한 .tflite 모델을 내보냅니다. 이제 하나의 형식으로 모바일, 임베디드, 엣지 및 브라우저 배포를 모두 지원합니다.
format="tflite"은 계속 작동하지만 지원 중단 경고를 표시하고 대신 LiteRT 모델을 내보냅니다. 앞으로는 **format="litert"**를 사용하시기 바랍니다. 최신 내보내기 지침과 옵션은 **LiteRT 내보내기 가이드**를 참조하십시오.
컴퓨터 비전 모델을 엣지 디바이스 또는 임베디드 디바이스에 배포하려면 원활한 성능을 보장할 수 있는 형식이 필요합니다.
기존 TensorFlow Lite 또는 TFLite 내보내기 형식은 엣지 애플리케이션에서 객체 감지 및 이미지 분류와 같은 작업을 수행하도록 Ultralytics YOLO26 모델을 최적화했습니다. 이 가이드는 기존 TFLite 배포 컨텍스트를 유지하며, 새로 내보낼 때는 LiteRT를 사용하십시오.
내보내기에 TFLite를 사용한 이유#
2017년 5월 Google이 TensorFlow 프레임워크의 일부로 공개한 TensorFlow Lite, 즉 TFLite는 디바이스 내 추론을 위해 설계된 오픈 소스 딥러닝 프레임워크이며 엣지 컴퓨팅이라고도 합니다. 개발자는 이 도구를 사용하여 모바일, 임베디드 및 IoT 디바이스뿐 아니라 기존 컴퓨터에서도 학습된 모델을 실행할 수 있었습니다.
TensorFlow Lite는 임베디드 Linux, Android, iOS 및 마이크로컨트롤러(MCU)를 비롯한 다양한 플랫폼을 지원했습니다. TFLite 내보내기를 사용하면 애플리케이션이 모델을 로컬 및 오프라인으로 실행할 수 있습니다.
TFLite 모델의 주요 기능#
TFLite 모델은 개발자가 모바일, 임베디드 및 엣지 디바이스에서 모델을 실행할 수 있도록 지원하여 디바이스 내 머신 러닝을 구현하는 다양한 주요 기능을 제공합니다.
-
디바이스 내 최적화: TFLite는 디바이스 내 ML에 맞게 최적화되어 데이터를 로컬에서 처리함으로써 지연 시간을 줄이고, 개인 데이터를 전송하지 않아 개인정보 보호를 강화하며, 모델 크기를 최소화하여 저장 공간을 절약합니다.
-
다중 플랫폼 지원: TFLite는 Android, iOS, 임베디드 Linux 및 마이크로컨트롤러를 지원하는 폭넓은 플랫폼 호환성을 제공합니다.
-
다양한 언어 지원: TFLite는 Java, Swift, Objective-C, C++ 및 Python을 비롯한 다양한 프로그래밍 언어와 호환됩니다.
-
높은 성능: 하드웨어 가속과 모델 최적화를 통해 뛰어난 성능을 달성합니다.
측정된 성능(과거 기록)#
이 결과는 Android 16/API 36에서 Ultralytics Flutter 플러그인 0.6.8과 LiteRT 2.1.5을 사용하여 12GB LPDDR5X 메모리가 탑재된 Xiaomi 17에서 기록되었습니다. 3nm Snapdragon 8 Elite Gen 5(SM8850)는 8코어 Qualcomm Oryon CPU(최대 4.6GHz의 Prime 코어 2개와 최대 3.62GHz의 Performance 코어 6개), Adreno GPU 및 Hexagon NPU를 탑재합니다. 이 표는 마이그레이션 중 평가한 기존 onnx2tf INT8 TFLite 에셋과 후보 litert-torch 내보내기를 비교합니다. 이후 릴리스 에셋은 표준화된 내보내기로 덮어써졌으므로 이 수치는 현재 v0.6.6 에셋 바이트를 설명하지 않습니다. 현재 측정값은 LiteRT 성능 표를 참조하십시오.
두 형식 모두 표시된 입력 크기에서 동일한 연속 GPU 테스트를 실행했습니다. 각 셀은 전체 시간(전처리 + 추론 + 후처리)이며, 아래에 단계별 시간이 나뉘어 표시됩니다. 네이티브 로그를 통해 두 형식 모두 Adreno GPU에서 전체 그래프를 LiteRT OpenCL(LITERT_CL)로 위임했음이 확인되었습니다.
| 모델 | 태스크 | 크기 (픽셀) | 기존 형식 onnx2tf INT8 TFLite (ms) | 후보 형식 w8a32 LiteRT (ms) |
|---|---|---|---|---|
| YOLO26n | Detect | 640 | 14.0 1.8 / 8.1 / 4.2 | 13.5 1.9 / 8.1 / 3.5 |
| YOLO26n-seg | Segment | 640 | 30.1 1.9 / 20.3 / 8.0 | 28.6 1.8 / 20.1 / 6.7 |
| YOLO26n-sem | 시맨틱 | 640 | 26.4 1.9 / 16.4 / 8.1 | 32.9 1.8 / 23.0 / 8.2 |
| YOLO26n-cls | 분류 | 224 | 3.5 0.9 / 2.2 / 0.4 | 3.2 1.0 / 2.2 / 0.1 |
| YOLO26n-pose | 포즈 | 640 | 17.4 2.4 / 9.9 / 5.1 | 14.0 1.9 / 9.3 / 2.8 |
| YOLO26n-obb | OBB | 640 | 13.9 3.0 / 8.3 / 2.7 | 13.0 2.9 / 7.9 / 2.3 |
동일한 마이그레이션 실행에서 YOLO26n detect 양자화 형식도 비교했습니다. 추론은 형식에 따라 달라지는 비교 가능한 지표입니다.
| Android 형식 | GPU 추론(ms) | GPU 컴파일 |
|---|---|---|
| onnx2tf INT8(기존 TFLite) | 8.6 | 예 |
| LiteRT w8a32(후보 형식) | 8.4 | 예 |
LiteRT INT8(quantize=8) | 11.0 | 예 |
| LiteRT FP32 | 8.8 | 예 |
LiteRT w8a16(quantize="w8a16") | CPU 폴백 | 아니요 |
이 실행에서 w8a16은 총 약 660ms로 CPU로 폴백되었으며, GPU 형식은 약 17ms가 소요되었습니다. 이러한 결과를 바탕으로 w8a32을 출시했지만, delegate 호환성과 성능은 디바이스 및 런타임 버전에 따라 달라집니다. 대상 디바이스를 벤치마크하고 런타임 로그에서 가속기 배치를 확인하십시오.
TFLite의 배포 옵션#
LiteRT 대체 내보내기 예제를 살펴보기 전에 TFLite 모델이 일반적으로 어떻게 사용되는지 알아보겠습니다.
TFLite는 머신 러닝 모델을 위한 다양한 디바이스 내 배포 옵션을 제공하며, 다음을 포함합니다.
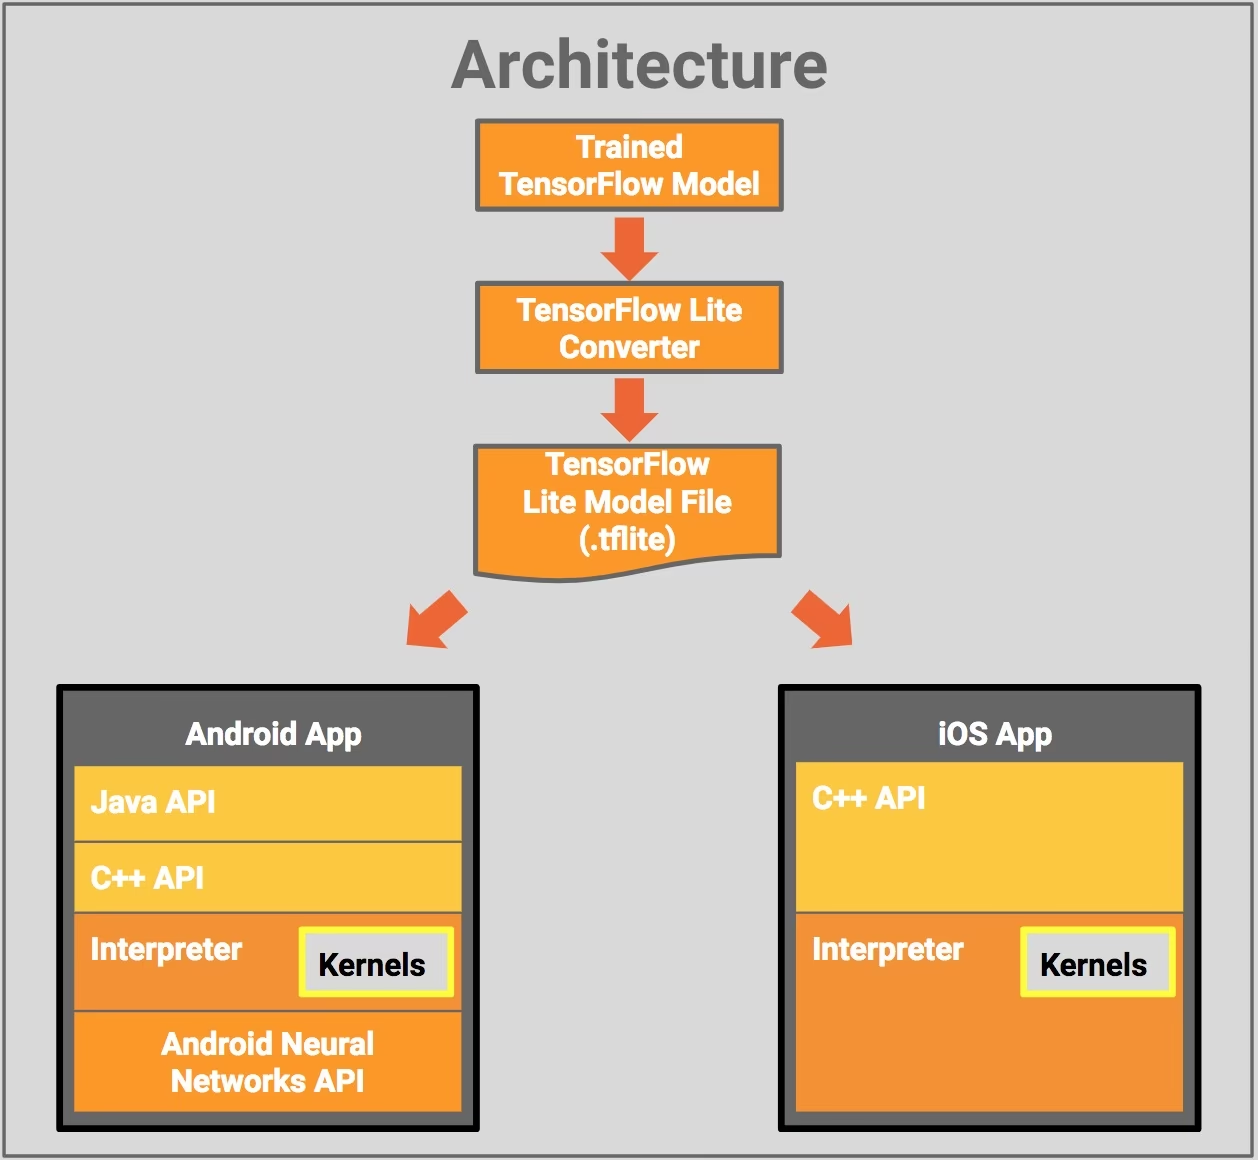
- Android 및 iOS로 배포: TFLite를 사용하는 Android 및 iOS 애플리케이션은 엣지 기반 카메라 피드와 센서를 분석하여 객체를 감지하고 식별할 수 있습니다. TFLite는 Swift 및 Objective-C로 작성된 네이티브 iOS 라이브러리도 제공합니다. 아래 아키텍처 다이어그램은 TensorFlow Lite를 사용하여 학습된 모델을 Android 및 iOS 플랫폼에 배포하는 프로세스를 보여줍니다.
-
임베디드 Linux로 구현: Ultralytics 가이드를 사용하여 Raspberry Pi에서 추론을 실행하는 방식이 사용 사례의 속도 요구 사항을 충족하지 못한다면, 내보낸 TFLite 모델을 사용하여 추론 시간을 단축할 수 있습니다. 또한 Coral Edge TPU 디바이스를 활용하여 성능을 더욱 개선할 수 있습니다.
-
마이크로컨트롤러로 배포: TFLite 모델은 메모리가 수 킬로바이트에 불과한 마이크로컨트롤러 및 기타 디바이스에도 배포할 수 있습니다. 핵심 런타임은 Arm Cortex M3에서 16KB에 맞으며 여러 기본 모델을 실행할 수 있습니다. 운영 체제 지원, 표준 C 또는 C++ 라이브러리, 동적 메모리 할당이 필요하지 않습니다.
TFLite 내보내기를 LiteRT로 대체#
새로 내보낼 때는 모델을 LiteRT로 변환하십시오. 결과 모델은 .tflite 파일 확장자를 유지합니다.
설치#
필요한 패키지를 설치하려면 다음을 실행합니다:
# Install the required package for YOLO26
pip install ultralytics
설치 과정에 대한 자세한 지침과 모범 사례는 Ultralytics 설치 가이드를 확인하세요. YOLO26에 필요한 패키지를 설치하는 동안 문제가 발생하면 해결 방법과 팁이 포함된 일반적인 문제 가이드를 참조하세요.
사용법#
모든 Ultralytics YOLO26 모델은 기본적으로 Export를 지원하도록 설계되어 있어 선호하는 배포 워크플로에 쉽게 통합할 수 있습니다. 애플리케이션에 가장 적합한 설정을 선택하려면 지원되는 전체 Export 형식 및 구성 옵션 목록을 확인할 수 있습니다.
대체 LiteRT 형식은 내보내기, 예측 및 검증 모드를 지원합니다. 모델을 내보낸 다음 내보낸 .tflite 모델을 로드하여 추론을 실행하거나 정확도를 검증하십시오.
from ultralytics import YOLO

# Load a YOLO26 model
model = YOLO("yolo26n.pt")

# Export the model to LiteRT format
model.export(format="litert", imgsz=640) # use imgsz=224 for classificationfrom ultralytics import YOLO
# Load the exported TFLite model
model = YOLO("yolo26n.tflite")
# Run inference
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Load the exported TFLite model
model = YOLO("yolo26n.tflite")
# Validate accuracy on the COCO8 dataset
metrics = model.val(data="coco8.yaml")내보내기 인수#
| 인수 | 유형 | 기본값 | 설명 |
|---|---|---|---|
format | str | 'litert' | 내보낸 모델의 대상 형식으로, 다양한 deployment environment와의 호환성을 정의합니다. |
imgsz | int 또는 tuple | 640 | 모델 입력에 사용할 이미지 크기입니다. 정사각형 이미지에는 정수를 사용하고, 특정 크기에는 (height, width) tuple을 사용할 수 있습니다. |
quantize | int 또는 str | None | 양자화 정밀도: 8(정적 INT8, int8 가중치 + int8 활성화값; 보정 data/fraction 필요), 'w8a16'(정적, int8 가중치 + int16 활성화값; 보정 data/fraction 필요), 'w8a32'(동적 INT8, int8 가중치 + FP32 활성화값; 보정 불필요) 또는 32/설정되지 않음(FP32)입니다. FP16은 별도로 내보내지 않습니다. GPU delegate에서 FP32 모델이 자동으로 FP16으로 실행됩니다. 지원 중단된 half/int8 플래그를 대체합니다. |
batch | int | 1 | 내보낼 모델의 배치 추론 크기 또는 predict 모드에서 내보낸 모델이 동시에 처리할 최대 이미지 수를 지정합니다. |
data | str | None | 양자화에 필요한 데이터셋 YAML 경로입니다. 분류의 경우 데이터셋 디렉터리 또는 기본 제공 데이터셋 이름을 사용합니다. quantize=8 또는 'w8a16'와 함께 생략하면 Ultralytics가 모델 작업에 적합한 기본 보정 데이터셋을 선택합니다. |
fraction | float, int 또는 list | 1.0 | Calibration subset은 비율, 이미지 수 또는 [train, val, test] 비율/개수로 지정합니다. 두 항목으로 구성된 목록에서는 test을 전체로 유지하고 0를 건너뜁니다. |
device | str | None | 내보내기에 사용할 디바이스를 지정합니다. CPU(device=cpu), Apple 실리콘용 MPS(device=mps)를 사용할 수 있습니다. |
내보내기 프로세스에 대한 자세한 내용은 Ultralytics 내보내기 문서 페이지를 참조하십시오.
내보낸 YOLO26 TFLite 모델 배포#
Ultralytics YOLO26 모델을 LiteRT 형식으로 내보낸 후 결과 .tflite 모델을 배포할 수 있습니다. TFLite 모델을 실행하는 기본적이고 권장되는 첫 단계는 이전 사용 코드 스니펫에 설명된 YOLO("model.tflite") 메서드를 사용하는 것입니다. 그러나 다양한 다른 환경에서 TFLite 모델을 배포하는 자세한 지침은 다음 리소스를 참조하십시오.
-
Android: TensorFlow Lite를 Android 애플리케이션에 통합하는 빠른 시작 가이드로, 머신 러닝 모델을 설정하고 실행하는 따라 하기 쉬운 단계를 제공합니다.
-
iOS: TensorFlow Lite 모델을 iOS 애플리케이션에 통합하고 배포하는 방법을 개발자에게 단계별 지침과 리소스로 제공하는 자세한 가이드입니다.
-
엔드투엔드 예제: 이 페이지에서는 다양한 TensorFlow Lite 예제를 개괄하며, 개발자가 모바일 및 엣지 디바이스의 머신 러닝 프로젝트에 TensorFlow Lite를 구현하는 데 도움이 되는 실용적인 애플리케이션과 튜토리얼을 소개합니다.
요약#
이 가이드는 기존 TFLite 배포 워크플로를 유지합니다. 새로 내보낼 때는 LiteRT를 사용하여 엣지 컴퓨팅 환경을 위한 .tflite 모델을 생성하십시오.
사용법에 대한 자세한 내용은 TFLite 공식 문서를 참조하십시오.
또한 다른 Ultralytics YOLO26 통합에 관심이 있다면 통합 가이드 페이지를 확인하십시오. 이곳에서 유용한 정보와 인사이트를 다양하게 확인할 수 있습니다.
FAQ#
새로 내보낼 때는 LiteRT 형식을 사용하십시오. 먼저 다음을 사용하여 필요한 패키지를 설치합니다.
pip install ultralytics그런 다음 다음 코드 스니펫을 사용하여 모델을 내보냅니다.
from ultralytics import YOLO

# Load a YOLO26 model
model = YOLO("yolo26n.pt")

# Export the model to LiteRT format
model.export(format="litert", imgsz=640)  # use imgsz=224 for classification
CLI 사용자는 다음 명령으로 이를 수행할 수 있습니다.
yolo export model=yolo26n.pt format=litert imgsz=640 # use imgsz=224 for classification자세한 내용은 Ultralytics export guide를 참조하십시오.
TensorFlow Lite(TFLite)는 디바이스 내 추론을 위해 설계된 오픈 소스 딥러닝 프레임워크로, 모바일, 임베디드 및 IoT 디바이스에 YOLO26 모델을 배포하는 데 적합합니다. 주요 이점은 다음과 같습니다.
- 디바이스 내 최적화: 데이터를 로컬에서 처리하여 지연 시간을 최소화하고 개인정보 보호를 강화합니다.
- 플랫폼 호환성: Android, iOS, 임베디드 Linux 및 MCU를 지원합니다.
- 성능: 하드웨어 가속을 활용하여 모델 속도와 효율성을 최적화합니다.
자세한 내용은 TFLite 가이드를 참조하십시오.
예, Raspberry Pi에서 YOLO26 TFLite 모델을 실행하여 추론 속도를 개선할 수 있습니다. 먼저 위에서 설명한 대로 모델을 LiteRT 형식으로 내보내십시오. 그런 다음 TensorFlow Lite Interpreter와 같은 도구를 사용하여 Raspberry Pi에서 모델을 실행하십시오.
추가 최적화를 위해 Coral Edge TPU 사용을 고려할 수 있습니다. 자세한 단계는 Raspberry Pi 배포 가이드와 Edge TPU 통합 가이드를 참조하십시오.
예, TFLite는 리소스가 제한된 마이크로컨트롤러에 배포할 수 있습니다. TFLite 핵심 런타임은 Arm Cortex M3에서 16KB의 메모리만 필요로 하며 기본적인 YOLO26 모델을 실행할 수 있습니다. 따라서 연산 성능과 메모리가 최소한인 디바이스에 배포하기에 적합합니다.
시작하려면 마이크로컨트롤러용 TFLite Micro 가이드를 참조하십시오.
TensorFlow Lite는 폭넓은 플랫폼 호환성을 제공하므로 다음을 포함한 다양한 디바이스에 YOLO26 모델을 배포할 수 있습니다.
- Android 및 iOS: TFLite Android 및 iOS 라이브러리를 통한 네이티브 지원입니다.
- 임베디드 Linux: Raspberry Pi와 같은 싱글 보드 컴퓨터에 적합합니다.
- 마이크로컨트롤러: 리소스가 제한된 MCU에 적합합니다.
배포 옵션에 대한 자세한 내용은 배포 가이드를 참조하십시오.
YOLO26 모델을 LiteRT로 내보내는 동안 오류가 발생하면 다음과 같은 일반적인 해결 방법을 시도할 수 있습니다.
- 패키지 호환성 확인: 호환되는 버전의 Ultralytics,
litert-torch및ai-edge-litert을 사용하고 있는지 확인하십시오. 설치 가이드를 참조하십시오. - 모델 지원: Ultralytics 내보내기 문서 페이지를 확인하여 특정 YOLO26 모델이 LiteRT 내보내기를 지원하는지 검증하십시오.
- Quantization 문제: INT8 quantization을 사용할 때
dataparameter에 dataset path가 올바르게 지정되어 있는지 확인하십시오.
추가 문제 해결 팁은 Common Issues guide를 참조하십시오.
- 패키지 호환성 확인: 호환되는 버전의 Ultralytics,