Conjunto de dados CIFAR-10#
O conjunto de dados CIFAR-10 (Instituto Canadiano de Investigação Avançada) é um benchmark clássico de classificação de imagens com 60.000 imagens a cores de 32x32, distribuídas uniformemente por 10 classes — avião, automóvel, pássaro, gato, veado, cão, rã, cavalo, navio e camião. É fornecido com uma divisão predefinida de 50.000 imagens de treino e 10.000 imagens de teste (6.000 por classe), o que o torna um ponto de partida leve e equilibrado para treinar e comparar modelos de classificação. Para um desafio mais detalhado, consulte o conjunto de dados relacionado CIFAR-100.
Explore o CIFAR-10 na Ultralytics Platform para pré-visualizar amostras, consultar as estatísticas do conjunto de dados e cloná-lo para treino.
Principais funcionalidades#
- O CIFAR-10 contém 60.000 imagens a cores de 32x32 píxeis, divididas uniformemente em 10 classes.
- Cada classe contém exatamente 6.000 imagens — 5.000 para treino e 1.000 para teste — pelo que o conjunto de dados é perfeitamente equilibrado.
- As 10 classes são avião, automóvel, pássaro, gato, veado, cão, rã, cavalo, navio e camião.
- O conjunto de dados é fornecido com uma divisão predefinida entre treino e teste, pelo que não é necessária qualquer divisão manual ou automática.
- O CIFAR-10 é um benchmark padrão para investigação em classificação de imagens e reconhecimento de objetos.
Estrutura do Conjunto de Dados#
O CIFAR-10 é fornecido com uma divisão oficial e predefinida, pelo que não é necessária qualquer partição automática ou manual:
- Classes: 10 (avião, automóvel, pássaro, gato, veado, cão, rã, cavalo, navio, camião)
- Total de imagens: 60.000 (a cores, 32x32)
- Conjunto de treino: 50.000 imagens (5.000 por classe)
- Conjunto de teste: 10.000 imagens (1.000 por classe)
O CIFAR-10 não tem uma pasta de validação separada, pelo que a Ultralytics utiliza, por predefinição, o conjunto de teste com 10.000 imagens como divisão de validação durante o treino.
Aplicações#
O CIFAR-10 é amplamente utilizado para treinar e avaliar modelos de classificação de imagens, desde Redes Neuronais Convolucionais clássicas (CNNs) e Máquinas de Vetores de Suporte (SVMs) até arquiteturas profundas modernas. O seu tamanho de imagem reduzido e as classes equilibradas tornam-no ideal para experimentação rápida, comparação de novos algoritmos e ensino dos fundamentos da visão computacional.
Utilização#
Treine um modelo YOLO no CIFAR-10 durante 100 épocas, com um tamanho de imagem de 32. Para consultar a lista completa de argumentos disponíveis, veja a página de Treino e o guia da tarefa de classificação de imagens.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar10", epochs=100, imgsz=32)
Imagens de exemplo e anotações#
O conjunto de dados CIFAR-10 contém imagens a cores de vários objetos, fornecendo um conjunto de dados bem estruturado para tarefas de classificação de imagens. Eis alguns exemplos de imagens do conjunto de dados:
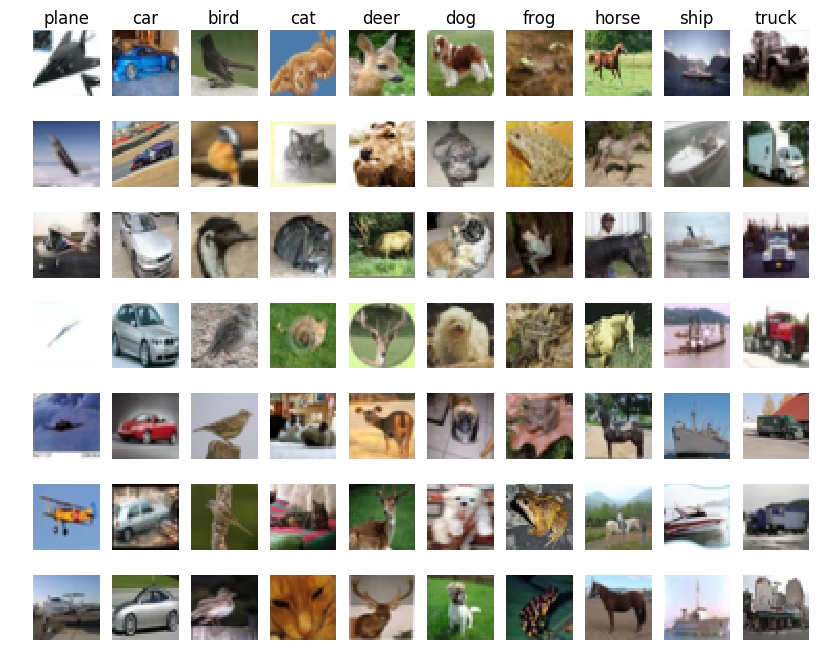
As amostras mostram a diversidade dos objetos no conjunto de dados CIFAR-10, destacando o valor de um conjunto de dados variado para treinar modelos robustos de classificação de imagens.
Citações e agradecimentos#
Se utilizar o conjunto de dados CIFAR-10 no seu trabalho de investigação ou desenvolvimento, cite o artigo seguinte:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Gostaríamos de agradecer a Alex Krizhevsky por criar e manter o conjunto de dados CIFAR-10 como um recurso valioso para a comunidade de investigação em aprendizagem automática e visão computacional. Para obter mais informações sobre o conjunto de dados CIFAR-10 e o seu criador, visite o site do conjunto de dados CIFAR-10.
Perguntas frequentes#
O conjunto de dados CIFAR-10 é amplamente utilizado para treinar e comparar modelos de classificação de imagens e reconhecimento de objetos. Contém 60.000 imagens a cores de 32x32, distribuídas uniformemente por 10 classes, e o seu tamanho reduzido e as classes equilibradas fazem dele um benchmark rápido e fiável para algoritmos como Redes Neuronais convolucionais (CNNs) e Máquinas de Vetores de Suporte (SVMs).
Para treinar um modelo Ultralytics YOLO no CIFAR-10, utilize os fragmentos de código abaixo. O conjunto de dados é descarregado automaticamente na primeira utilização. Para consultar a lista completa de argumentos, veja a página de Treino do modelo.
Exemplo de treinofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar10", epochs=100, imgsz=32)O CIFAR-10 tem 10 classes — avião, automóvel, pássaro, gato, veado, cão, rã, cavalo, navio e camião — com exatamente 6.000 imagens cada, num total de 60.000 imagens. As classes são mutuamente exclusivas e perfeitamente equilibradas, sem sobreposição entre categorias.
O CIFAR-10 é fornecido com uma divisão predefinida de 50.000 imagens de treino e 10.000 imagens de teste, com exatamente 5.000 imagens de treino e 1.000 imagens de teste por classe. Ao contrário dos conjuntos de dados de classificação baseados em pastas, que a Ultralytics divide automaticamente, a partição oficial do CIFAR-10 é utilizada tal como está, e o conjunto de teste serve, por predefinição, como divisão de validação durante o treino.
Sim. A Ultralytics Platform permite gerir conjuntos de dados, treinar modelos de classificação de imagens e implementá-los sem programação extensa. É uma forma prática de executar experiências com o CIFAR-10 na nuvem, e pode explorar mais opções na nossa visão geral dos conjuntos de dados de classificação.