Conjunto de dados TT100K#
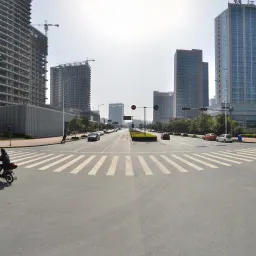
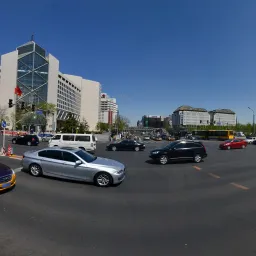
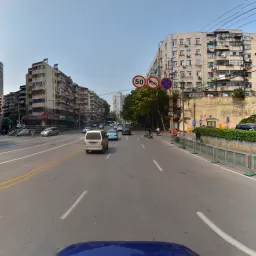
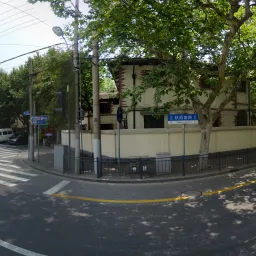
O conjunto de dados Tsinghua-Tencent 100K (TT100K) é uma referência para a deteção de objetos em sinais de trânsito, criada por Zhu et al. para o artigo da CVPR 2016 Traffic-Sign Detection and Classification in the Wild. A configuração TT100K da Ultralytics disponibiliza 16 817 imagens (6 105 para treino / 7 641 para validação / 3 071 para teste) em 221 categorias de sinais de trânsito, sendo que a referência original indica mais de 30 000 ocorrências de sinais. O «100K» do nome refere-se às cerca de 100 000 imagens do Tencent Street View a partir das quais a referência foi criada — não ao número de imagens que transferes e usas no treino. Como o artigo original mantém apenas categorias com pelo menos 100 ocorrências no conjunto de treino, existe um subconjunto muito utilizado de 45 classes, mas a configuração da Ultralytics mantém as 221 categorias anotadas (muitas delas pouco representadas).
As imagens de alta resolução de vista de rua captam grandes variações de iluminação, condições meteorológicas, ângulo de visão e distância, o que faz do TT100K uma referência exigente para a deteção de objetos pequenos em cenários de condução reais.
Principais funcionalidades#
- Deteção multiclasse: 221 categorias de sinais de trânsito, incluindo sinais chineses de limite de velocidade, proibição, aviso, limite de altura/largura e informação.
- Alta resolução: imagens de 2048×2048 píxeis, nas quais os sinais vão de grandes planos a marcadores minúsculos ao longe, que põem à prova a deteção de detalhes.
- Condições reais: grandes variações nas condições meteorológicas, na iluminação, no ângulo de visão e na oclusão.
- Anotações de caixas delimitadoras: Cada sinal é identificado com uma classe e uma caixa delimitadora no formato YOLO após a conversão automática.
- Divisões predefinidas: divisões fixas de treino / validação / teste (6 105 / 7 641 / 3 071 imagens) para uma avaliação consistente.
Estrutura do conjunto de dados#
A configuração TT100K da Ultralytics está dividida em três subconjuntos, todos com as mesmas 221 categorias:
| Divisão | Imagens | Descrição |
|---|---|---|
| Treinar | 6,105 | Imagens de cenas de trânsito anotadas, usadas para treinar o detetor |
| Validação | 7,641 | A divisão original «other» do conjunto de dados, usada para avaliação |
| Teste | 3,071 | Imagens reservadas para a avaliação final do modelo treinado |
As 221 categorias estão organizadas em vários grupos principais:
- Sinais de limite de velocidade — limites de proibição
pl*(por exemplo, pl5–pl120) e velocidades mínimaspm*(por exemplo, pm5–pm55). - Sinais de proibição — proibições gerais
p1–p29, proibição de entrada/estacionamentopn/pnee restriçõespr*(pr10–pr100). - Sinais de aviso —
w1–w67para perigos na estrada, como passagens, curvas apertadas, pisos escorregadios e obras. - Sinais de limite de altura/largura — limites de altura
ph*(por exemplo, ph2–ph5.5) e limites de largurapb/pw*. - Sinais informativos — informações gerais
i1–i15, informações sobre limites de velocidadeil*(il50–il110), outrosioe painéis informativosip.
Aplicações#
O TT100K é amplamente utilizado para criar e avaliar sistemas de reconhecimento de sinais de trânsito em condições reais. As aplicações mais comuns incluem:
- Sistemas de perceção para condução autónoma
- Sistemas avançados de assistência ao condutor (ADAS)
- Monitorização do trânsito e análise de infraestruturas rodoviárias
- Planeamento urbano e estudos do fluxo de trânsito
- Investigação em visão computacional sobre objetos pequenos em imagens de alta resolução
YAML do conjunto de dados#
O ficheiro TT100K.yaml define a configuração do conjunto de dados — os caminhos dos dados, os nomes das classes e o script automático de transferência e conversão. É mantido no repositório da Ultralytics em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)Uso#
O TT100K é transferido automaticamente na primeira vez que treinas e requer cerca de 18 GB de espaço livre em disco. Na primeira utilização, o script de transferência obtém os dados originais e converte as anotações para o formato YOLO, o que pode demorar vários minutos.
Para treinares um modelo YOLO26n no conjunto de dados TT100K durante 100 épocas, com um tamanho de imagem de 640, podes usar os seguintes excertos de código. Para consultares a lista completa de argumentos disponíveis, visita a página de Treino do modelo.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo - o conjunto de dados será transferido automaticamente na primeira execução
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Para rotulares imagens adicionais de sinais de trânsito e gerires execuções de treino do TT100K no navegador, usa a Ultralytics Platform.
Dados de exemplo e anotações#
As imagens do TT100K são cenas de rua de 2048×2048 nas quais as placas de trânsito costumam ocupar apenas uma pequena parte do enquadramento. Uma única imagem pode conter várias placas em diferentes escalas e distâncias, algumas parcialmente obstruídas por veículos, vegetação ou estruturas, e capturadas durante o dia ou à noite, em condições de tempo bom ou chuvoso. Essa combinação de objetos pequenos e condições desafiadoras faz do conjunto de dados um excelente teste de robustez para detectores.
Citações e agradecimentos#
Se você usar o conjunto de dados TT100K em seu trabalho de pesquisa ou desenvolvimento, cite o artigo a seguir:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Gostaríamos de reconhecer a colaboração entre a Universidade Tsinghua e a Tencent pela criação e manutenção desse valioso recurso para as comunidades de visão computacional e direção autônoma. Para saber mais sobre o conjunto de dados TT100K, acesse o site oficial do conjunto de dados.
Perguntas frequentes#
O conjunto de dados Tsinghua-Tencent 100K (TT100K) é usado para detectar e classificar placas de trânsito em condições reais. Suas 221 categorias e imagens de alta resolução de vistas de rua fazem dele um benchmark comum para percepção em direção autônoma, sistemas avançados de assistência ao condutor (ADAS) e pesquisas sobre detecção de objetos pequenos.
A configuração TT100K da Ultralytics contém 16,817 imagens: 6,105 para treinamento, 7,641 para validação (a divisão original "other" do conjunto de dados) e 3,071 para teste. Consulte a seção Estrutura do conjunto de dados para ver a divisão completa.
"100K" se refere às cerca de 100.000 imagens do Tencent Street View usadas para criar o benchmark original. A configuração de detecção da Ultralytics disponibiliza 16,817 dessas imagens com rótulos no formato YOLO; o nome reflete a coleção de origem, não o tamanho do conjunto de treinamento.
O TT100K define 221 categorias, que abrangem placas de limite de velocidade, proibição, advertência, limite de altura/largura e informativas. O artigo original mantém apenas as 45 categorias com pelo menos 100 instâncias de treinamento, mas a configuração da Ultralytics mantém todas as 221. Consulte Estrutura do conjunto de dados para ver a divisão por grupo.
O TT100K tem cerca de 18 GB e é baixado automaticamente na primeira vez que você treina com
data="TT100K.yaml"— não é necessário fazer o download manualmente. O script também converte as anotações originais para o formato YOLO na primeira execução.Treine um modelo YOLO26n no TT100K por 100 épocas, com tamanho de imagem de 640:
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Para ver configurações detalhadas, consulte a página de Treinamento e as dicas de treinamento de modelos.
Comece com
imgsz=640para os experimentos iniciais; depois, aumente paraimgsz=1280(com umbatchmenor) se você tiver memória GPU suficiente, pois a resolução mais alta ajuda a recuperar placas pequenas e distantes:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # maior resolução para placas pequenasVocê também pode ajustar o aumento de dados e considerar estratégias de divisão em blocos para objetos muito pequenos. Consulte Dicas para treinamento de modelos para saber mais.