Conjunto de dados COCO128-Seg#
Introdução#
O COCO128-Seg da Ultralytics é um conjunto de dados pequeno, mas versátil, de segmentação de instâncias, composto pelas primeiras 128 imagens do conjunto COCO train 2017. Esse conjunto de dados é ideal para testar e depurar modelos de segmentação ou experimentar novas abordagens de segmentação. Com 128 imagens, é pequeno o bastante para ser facilmente gerenciável, mas diversificado o bastante para testar erros nos pipelines de treinamento e servir como verificação básica antes de treinar com conjuntos de dados maiores.
Estrutura do conjunto de dados#
- Imagens: 128 no total, com as divisões train e val idênticas (veja a observação abaixo).
- Classes: as mesmas 80 categorias de objetos do COCO.
- Rótulos: polígonos no formato YOLO armazenados em
labels/train2017para o diretório compartilhado de imagens train e val. - Tamanho do download: ~7 MB.
O YAML padrão aponta train e val para as mesmas 128 imagens; assim, as métricas de validação medem o ajuste ao conjunto de treinamento, e não a generalização para dados não vistos. Duplique ou personalize a divisão se precisar de um conjunto realmente separado para avaliação.
Este conjunto de dados destina-se a ser usado com a Ultralytics Platform e o YOLO26.
YAML do conjunto de dados#
Um arquivo YAML é usado para definir a configuração do conjunto de dados. Ele contém informações sobre os caminhos, as classes e outros dados relevantes do conjunto de dados. No caso do conjunto de dados COCO128-Seg, o arquivo coco128-seg.yaml é mantido em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128-seg dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/coco128-seg
# Example usage: yolo train data=coco128-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128-seg ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128-seg # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128-seg.zipUso#
Para treinar um modelo YOLO26n-seg no conjunto de dados COCO128-Seg por 100 épocas, com tamanho de imagem 640, você pode usar os trechos de código a seguir. Para ver a lista completa de argumentos disponíveis, consulte a página de treinamento do modelo.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-seg.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)
Imagens de exemplo e anotações#
Veja alguns exemplos de imagens do conjunto de dados COCO128-Seg e suas anotações correspondentes:
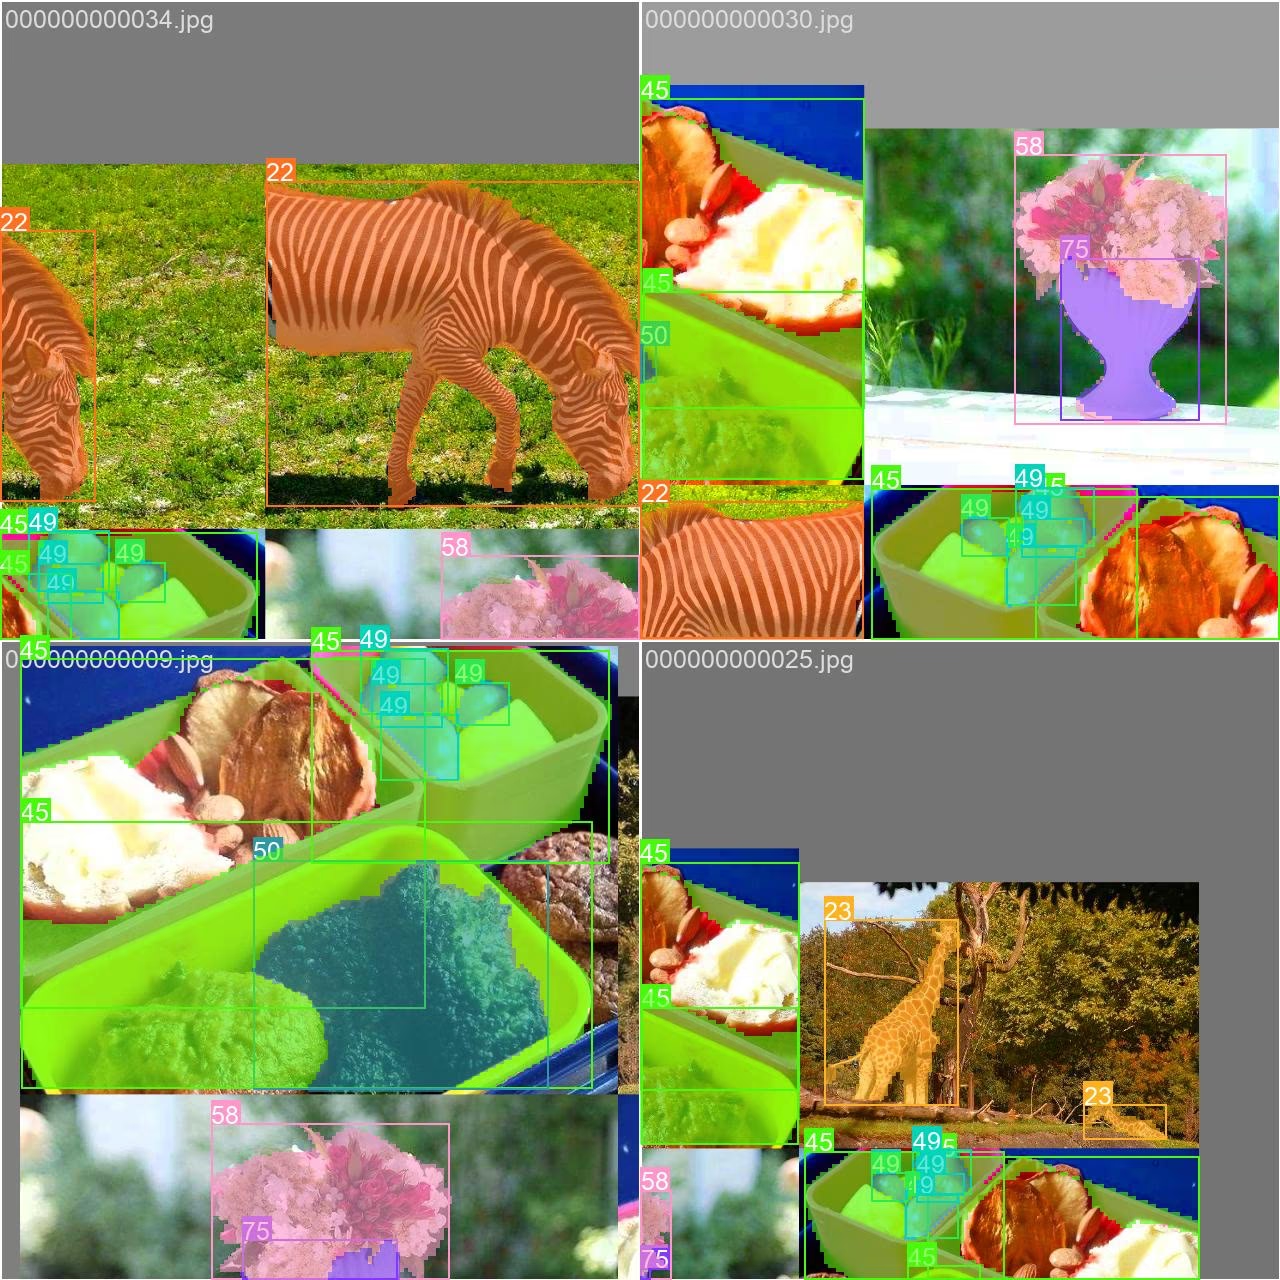
- Imagem em mosaico: esta imagem mostra um lote de treinamento composto por imagens do conjunto de dados organizadas em mosaico. A criação de mosaicos é uma técnica usada durante o treinamento que combina várias imagens numa só para aumentar a variedade de objetos e cenas em cada lote de treinamento. Isso ajuda a melhorar a capacidade do modelo de generalizar para diferentes tamanhos de objetos, proporções e contextos.
Citações e agradecimentos#
Se usares o conjunto de dados COCO no teu trabalho de pesquisa ou desenvolvimento, cita o seguinte artigo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Gostaríamos de agradecer ao Consórcio COCO por criar e manter este valioso recurso para a comunidade de visão computacional. Para mais informações sobre o conjunto de dados COCO e os seus criadores, visita o site do conjunto de dados COCO.
Perguntas frequentes#
O conjunto de dados COCO128-Seg é um conjunto compacto de dados de segmentação de instâncias da Ultralytics, composto pelas primeiras 128 imagens do conjunto COCO train 2017. Esse conjunto de dados foi desenvolvido para testar e depurar modelos de segmentação ou experimentar novos métodos de segmentação. Ele é particularmente útil com o YOLO26 e a Platform da Ultralytics para iterações rápidas e verificação de erros no pipeline antes de expandir para conjuntos de dados maiores. Para informações detalhadas sobre o uso, consulte a página de treinamento do modelo.
Para treinar um modelo YOLO26n-seg no conjunto de dados COCO128-Seg por 100 épocas, com tamanho de imagem 640, você pode usar comandos Python ou CLI. Veja um exemplo rápido:
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n-seg.pt") # Carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)Para obter uma explicação completa dos argumentos disponíveis e das opções de configuração, consulte a documentação de treinamento.
Como o download e o ciclo de treinamento/validação são muito menores do que no COCO completo, o COCO128-Seg permite executar uma verificação básica de 1 época em um pipeline novo — confirmando que o modelo treina, valida e salva checkpoints corretamente — antes de expandir para o conjunto de dados COCO-Seg completo. Saiba mais sobre os formatos de conjuntos de dados compatíveis no guia de conjuntos de dados de segmentação da Ultralytics.
O arquivo de configuração YAML do conjunto de dados COCO128-Seg está disponível no repositório da Ultralytics. Você pode acessar o arquivo diretamente em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yaml. O arquivo YAML inclui informações essenciais sobre os caminhos e as classes do conjunto de dados, além das configurações necessárias para o treinamento e a validação do modelo.
Em termos de tamanho, o COCO128-Seg (128 imagens) fica entre o COCO8-Seg (8 imagens) e o conjunto de dados COCO-Seg completo (118.287 imagens de treinamento):
- COCO8-Seg: 8 imagens (4 train, 4 val) — ideal para verificações básicas rápidas e depuração.
- COCO128-Seg: 128 imagens — equilíbrio entre tamanho e diversidade, com train e val compartilhando o mesmo diretório.
- COCO-Seg completo: 118.287 imagens de treinamento — abrangente, mas exige muitos recursos e cerca de ~20 GB no primeiro download.
O COCO128-Seg oferece mais diversidade que o COCO8-Seg e, ao mesmo tempo, é muito mais gerenciável que o conjunto de dados COCO-Seg completo para experimentação e desenvolvimento inicial de modelos.