Guia de início rápido: NVIDIA Jetson com Ultralytics YOLO26#
Este guia abrangente apresenta instruções detalhadas para implementar o Ultralytics YOLO26 em dispositivos NVIDIA Jetson. Além disso, inclui testes de desempenho que demonstram as capacidades do YOLO26 nestes dispositivos pequenos e potentes.
Atualizámos este guia com o mais recente NVIDIA Jetson AGX Thor Developer Kit, que oferece até 2070 FP4 TFLOPS de capacidade de processamento de IA e 128 GB de memória, com potência configurável entre 40 W e 130 W. Oferece mais de 7,5 vezes a capacidade de processamento de IA do NVIDIA Jetson AGX Orin, com uma eficiência energética 3,5 vezes superior, permitindo executar sem problemas os modelos de IA mais populares.
Assista: Como usar Ultralytics YOLO26 em dispositivos NVIDIA Jetson
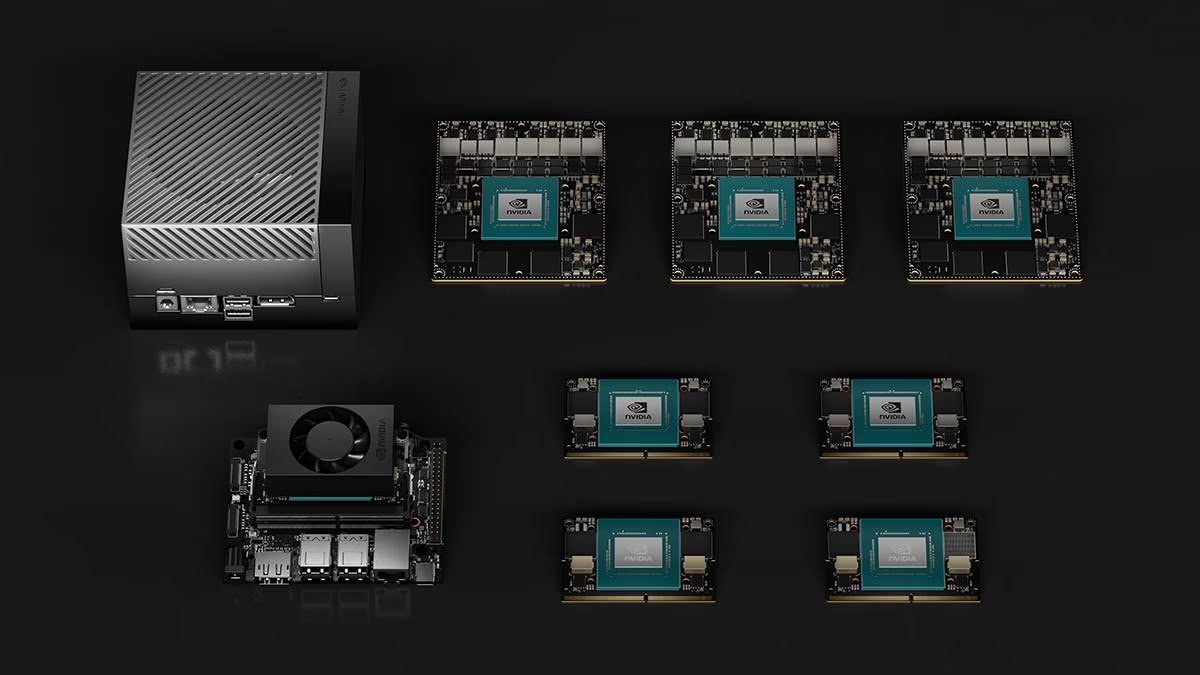
Este guia foi testado com o NVIDIA Jetson AGX Thor Developer Kit (Jetson T5000) e o NVIDIA Jetson AGX Orin Developer Kit (64GB), com a versão estável mais recente do JetPack 7.2; com o NVIDIA Jetson Orin Nano Super Developer Kit, com a versão JP6.1 do JetPack; com o Seeed Studio reComputer J4012, baseado no NVIDIA Jetson Orin NX 16GB e com a versão JP6.0/JP5.1.3 do JetPack; e com o Seeed Studio reComputer J1020 v2, baseado no NVIDIA Jetson Nano 4GB e com a versão JP4.6.1 do JetPack. Espera-se que funcione com toda a gama de hardware NVIDIA Jetson, incluindo os dispositivos mais recentes e os mais antigos.
O que é o NVIDIA Jetson?#
NVIDIA Jetson é uma série de placas de computação incorporada concebidas para levar a computação acelerada de IA (inteligência artificial) a dispositivos de edge. Estes dispositivos compactos e potentes são construídos com base na arquitetura de GPU da NVIDIA e conseguem executar algoritmos complexos de IA e modelos de aprendizagem profunda diretamente no dispositivo, sem depender de recursos de computação na nuvem. As placas Jetson são frequentemente utilizadas em robótica, veículos autónomos, automação industrial e outras aplicações em que a inferência de IA tem de ser executada localmente, com baixa latência e elevada eficiência. Além disso, estas placas baseiam-se na arquitetura ARM64 e consomem menos energia do que os dispositivos tradicionais de computação com GPU.
Comparação das séries NVIDIA Jetson#
O NVIDIA Jetson AGX Thor é a mais recente geração da família NVIDIA Jetson, baseada na arquitetura NVIDIA Blackwell, que proporciona um desempenho de IA muito superior ao das gerações anteriores. A tabela abaixo compara alguns dos dispositivos Jetson do ecossistema.
| Jetson AGX Thor (T5000) | Jetson AGX Orin 64GB | Jetson Orin NX 16GB | Jetson Orin Nano Super | Jetson AGX Xavier | Jetson Xavier NX | Jetson Nano | |
|---|---|---|---|---|---|---|---|
| Desempenho de IA | 2070 TFLOPS | 275 TOPS | 100 TOPS | 67 TOPS | 32 TOPS | 21 TOPS | 472 GFLOPS |
| GPU | GPU de arquitetura NVIDIA Blackwell com 2560 núcleos e 96 Tensor Cores | GPU de arquitetura NVIDIA Ampere com 2048 núcleos e 64 Tensor Cores | GPU de arquitetura NVIDIA Ampere com 1024 núcleos e 32 Tensor Cores | GPU de arquitetura NVIDIA Ampere com 1024 núcleos e 32 Tensor Cores | GPU de arquitetura NVIDIA Volta com 512 núcleos e 64 Tensor Cores | GPU de arquitetura NVIDIA Volta™ com 384 núcleos e 48 Tensor Cores | GPU de arquitetura NVIDIA Maxwell™ com 128 núcleos |
| Frequência máxima da GPU | 1.57 GHz | 1.3 GHz | 918 MHz | 1020 MHz | 1377 MHz | 1100 MHz | 921MHz |
| CPU | CPU Arm® Neoverse®-V3AE de 64 bits com 14 núcleos, 1 MB de L2 + 16 MB de L3 | CPU NVIDIA Arm® Cortex A78AE v8.2 de 64 bits com 12 núcleos, 3 MB de L2 + 6 MB de L3 | CPU NVIDIA Arm® Cortex A78AE v8.2 de 64 bits com 8 núcleos, 2 MB de L2 + 4 MB de L3 | CPU Arm® Cortex®-A78AE v8.2 de 64 bits e 6 núcleos, 1,5 MB de L2 + 4 MB de L3 | CPU NVIDIA Carmel Arm®v8.2 de 64 bits e 8 núcleos, 8 MB de L2 + 4 MB de L3 | CPU NVIDIA Carmel Arm®v8.2 de 64 bits e 6 núcleos, 6 MB de L2 + 4 MB de L3 | Processador Quad-Core Arm® Cortex®-A57 MPCore |
| Frequência máxima da CPU | 2.6 GHz | 2.2 GHz | 2.0 GHz | 1.7 GHz | 2.2 GHz | 1.9 GHz | 1.43GHz |
| Memória | 128 GB LPDDR5X de 256 bits, 273 GB/s | 64 GB LPDDR5 de 256 bits, 204,8 GB/s | 16 GB LPDDR5 de 128 bits, 102,4 GB/s | 8 GB LPDDR5 de 128 bits, 102 GB/s | 32 GB LPDDR4x de 256 bits, 136,5 GB/s | 8 GB LPDDR4x de 128 bits, 59,7 GB/s | 4 GB LPDDR4 de 64 bits, 25,6 GB/s |
Para ver uma tabela comparativa mais detalhada, visita a secção Compare Specifications da página oficial da NVIDIA Jetson.
O que é o NVIDIA JetPack?#
O NVIDIA JetPack SDK, que alimenta os módulos Jetson, é a solução mais abrangente e disponibiliza um ambiente de desenvolvimento completo para criar aplicações de IA aceleradas de ponta a ponta, reduzindo o tempo de chegada ao mercado. O JetPack inclui o Jetson Linux com carregador de arranque, kernel Linux, ambiente de desktop Ubuntu e um conjunto completo de bibliotecas para aceleração de computação GPU, multimédia, gráficos e visão computacional. Também inclui exemplos, documentação e ferramentas de desenvolvimento para o computador anfitrião e o kit de desenvolvimento, além de suportar SDKs de nível superior, como o DeepStream para análise de vídeo em streaming, o Isaac para robótica e o Riva para IA conversacional.
Instalar o JetPack na NVIDIA Jetson#
O primeiro passo depois de obteres um dispositivo NVIDIA Jetson é instalar o NVIDIA JetPack no dispositivo. Existem várias formas diferentes de instalar o JetPack em dispositivos NVIDIA Jetson.
- Para o JetPack 7.2 num kit de desenvolvimento oficial Jetson AGX Thor, AGX Orin ou Orin Nano, transfere a ISO unificada do Jetson, grava-a numa unidade USB e segue o guia de início rápido específico do dispositivo para AGX Thor, AGX Orin ou Orin Nano. A partir do JetPack 7.2, o Orin Nano já não utiliza uma imagem transferível para cartão SD; a instalação da ISO por USB instala o Jetson Linux no cartão microSD ou SSD NVMe do dispositivo.
- Se optares intencionalmente por usar o JetPack 6 num kit de desenvolvimento Jetson Orin Nano, segue as instruções da NVIDIA para atualizar o JetPack 6.x e usar o cartão SD.
- Se tiveres qualquer outro kit de desenvolvimento NVIDIA, podes instalar o JetPack no dispositivo com o SDK Manager.
- Se tiveres um dispositivo Seeed Studio reComputer J4012, podes instalar o JetPack no SSD incluído; se tiveres um dispositivo Seeed Studio reComputer J1020 v2, podes instalar o JetPack na eMMC/ SSD.
- Se tiveres qualquer outro dispositivo de terceiros equipado com um módulo NVIDIA Jetson, recomenda-se que sigas as instruções de instalação pela linha de comandos.
Para os métodos 1, 4 e 5 acima, depois de instalar o sistema e iniciar o dispositivo, introduz "sudo apt update && sudo apt install nvidia-jetpack -y" no terminal do dispositivo para instalar todos os componentes JetPack restantes necessários.
Suporte do JetPack por dispositivo Jetson#
A tabela abaixo destaca as versões do NVIDIA JetPack suportadas pelos diferentes dispositivos NVIDIA Jetson.
| JetPack 4 | JetPack 5 | JetPack 6 | JetPack 7 | |
|---|---|---|---|---|
| Jetson Nano | ✅ | ❌ | ❌ | ❌ |
| Jetson TX2 | ✅ | ❌ | ❌ | ❌ |
| Jetson Xavier NX | ✅ | ✅ | ❌ | ❌ |
| Jetson AGX Xavier | ✅ | ✅ | ❌ | ❌ |
| Jetson AGX Orin | ❌ | ✅ | ✅ | ✅ |
| Jetson Orin NX | ❌ | ✅ | ✅ | ✅ |
| Jetson Orin Nano | ❌ | ✅ | ✅ | ✅ |
| Jetson AGX Thor | ❌ | ❌ | ❌ | ✅ |
Início rápido com Docker#
A forma mais rápida de começar a usar o Ultralytics YOLO26 na NVIDIA Jetson é executar imagens Docker pré-compiladas para Jetson. Consulta a tabela acima e escolhe a versão do JetPack de acordo com o dispositivo Jetson que tens.
t=ultralytics/ultralytics:latest-jetson-jetpack4
sudo docker pull $t && sudo docker run -it --ipc=host --runtime=nvidia $tA imagem latest-nvidia-arm64 utiliza o NVIDIA PyTorch 26.08, incluindo CUDA 13.4 e TensorRT 11.2. A NVIDIA indica o JetPack 7.1 para PyTorch na sua tabela de compatibilidade, mas o TensorRT 11.2.1 não é compatível com o JetPack, incluindo Thor. Utiliza esta imagem apenas para cargas de trabalho PyTorch num anfitrião compatível. Para exportações Jetson com TensorRT, utiliza a instalação nativa abaixo com o runtime TensorRT 10.x suportado pela tua versão do JetPack. O JetPack 7.2 em Thor ou Orin requer validação separada do contentor. Volta a compilar os engines para a GPU e a versão do TensorRT de destino.
Para imagens do JetPack 4, 5 e 6, continua para Utilizar o TensorRT na NVIDIA Jetson. A imagem do JetPack 7.1 acima destina-se apenas a cargas de trabalho PyTorch.
Começar com a instalação nativa#
Para uma instalação nativa sem Docker, consulta os passos abaixo.
Executar no JetPack 7.2#
Instalar o pacote Ultralytics#
Aqui vamos instalar o pacote Ultralytics na Jetson. As dependências de exportação são instaladas automaticamente na primeira vez que exportas um modelo, por isso, aqui só é necessário instalar o pacote base. Vamos concentrar-nos sobretudo nas exportações NVIDIA TensorRT, porque o TensorRT permite obter o máximo desempenho dos dispositivos Jetson.
-
Atualizar a lista de pacotes, instalar o pip e atualizá-lo para a versão mais recente
sudo apt update sudo apt install python3-pip -y pip install -U pip -
Instalar o pacote pip
ultralyticspip install ultralytics -
Reiniciar o dispositivo
sudo reboot
Instalar o PyTorch e o Torchvision#
A instalação do Ultralytics acima instala o Torch e o Torchvision. No entanto, estes dois pacotes instalados através do pip não são compatíveis com dispositivos JetPack 7.2 que utilizam CUDA 13. Por isso, temos de os instalar manualmente.
Instalar torch e torchvision de acordo com o JP7.2
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130Instalar onnxruntime-gpu#
Utiliza uma wheel de ONNX Runtime GPU compatível com as versões do JetPack, Python e CUDA. As versões atuais no PyPI incluem wheels ARM64, mas não substituem os pacotes específicos do dispositivo em todas as versões do JetPack.
Aqui vamos transferir e instalar onnxruntime-gpu 1.24.0 com suporte para Python3.12.
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/onnxruntime_gpu-1.24.0-cp312-cp312-linux_aarch64.whlExecutar no JetPack 6.1#
Instalar o pacote Ultralytics#
Aqui vamos instalar o pacote Ultralytics na Jetson. As dependências de exportação são instaladas automaticamente na primeira vez que exportas um modelo, por isso, aqui só é necessário instalar o pacote base. Vamos concentrar-nos sobretudo nas exportações NVIDIA TensorRT, porque o TensorRT permite obter o máximo desempenho dos dispositivos Jetson.
-
Atualizar a lista de pacotes, instalar o pip e atualizá-lo para a versão mais recente
sudo apt update sudo apt install python3-pip -y pip install -U pip -
Instalar o pacote pip
ultralyticspip install ultralytics -
Reiniciar o dispositivo
sudo reboot
Instalar o PyTorch e o Torchvision#
A instalação do Ultralytics acima instala o Torch e o Torchvision. No entanto, estes dois pacotes instalados através do pip não são compatíveis com a plataforma Jetson, baseada na arquitetura ARM64. Por isso, temos de instalar manualmente uma wheel pip pré-compilada do PyTorch e compilar o Torchvision a partir do código-fonte ou instalá-lo a partir do código-fonte.
Instalar torch 2.10.0 e torchvision 0.25.0 de acordo com o JP6.1
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torch-2.10.0-cp310-cp310-linux_aarch64.whl
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torchvision-0.25.0-cp310-cp310-linux_aarch64.whlVisita a página do PyTorch para Jetson para aceder a todas as versões do PyTorch disponíveis para as diferentes versões do JetPack. Para obter uma lista mais detalhada da compatibilidade entre PyTorch e Torchvision, visita a página de compatibilidade entre PyTorch e Torchvision.
Instala cuDSS para corrigir um problema de dependências com torch 2.10.0
wget https://developer.download.nvidia.com/compute/cudss/0.7.1/local_installers/cudss-local-tegra-repo-ubuntu2204-0.7.1_0.7.1-1_arm64.deb
sudo dpkg -i cudss-local-tegra-repo-ubuntu2204-0.7.1_0.7.1-1_arm64.deb
sudo cp /var/cudss-local-tegra-repo-ubuntu2204-0.7.1/cudss-*-keyring.gpg /usr/share/keyrings/
sudo apt-get update
sudo apt-get -y install cudss
Instalar onnxruntime-gpu#
Utiliza uma wheel de ONNX Runtime GPU compatível com as versões do JetPack, Python e CUDA. As versões atuais no PyPI incluem wheels ARM64, mas não substituem os pacotes específicos do dispositivo em todas as versões do JetPack.
Podes encontrar todos os pacotes onnxruntime-gpu disponíveis — organizados por versão do JetPack, versão do Python e outros detalhes de compatibilidade — na matriz de compatibilidade do ONNX Runtime do Jetson Zoo.
Para o JetPack 6 com suporte para Python 3.10, podes instalar onnxruntime-gpu 1.23.0:
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/onnxruntime_gpu-1.23.0-cp310-cp310-linux_aarch64.whlEm alternativa, para onnxruntime-gpu 1.20.0:
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/onnxruntime_gpu-1.20.0-cp310-cp310-linux_aarch64.whlExecutar no JetPack 5.1.2#
Instalar o pacote Ultralytics#
Aqui vamos instalar o pacote Ultralytics na Jetson. As dependências de exportação são instaladas automaticamente na primeira vez que exportas um modelo, por isso, aqui só é necessário instalar o pacote base. Vamos concentrar-nos sobretudo nas exportações NVIDIA TensorRT, porque o TensorRT permite obter o máximo desempenho dos dispositivos Jetson.
-
Atualizar a lista de pacotes, instalar o pip e atualizá-lo para a versão mais recente
sudo apt update sudo apt install python3-pip -y pip install -U pip -
Instalar o pacote pip
ultralyticspip install ultralytics -
Reiniciar o dispositivo
sudo reboot
Instalar o PyTorch e o Torchvision#
A instalação do Ultralytics acima instala o Torch e o Torchvision. No entanto, estes dois pacotes instalados através do pip não são compatíveis com a plataforma Jetson, baseada na arquitetura ARM64. Por isso, temos de instalar manualmente uma wheel pip pré-compilada do PyTorch e compilar o Torchvision a partir do código-fonte ou instalá-lo a partir do código-fonte.
-
Desinstalar o PyTorch e o Torchvision atualmente instalados
pip uninstall torch torchvision -
Instalar
torch 2.1.0etorchvision 0.16.2de acordo com o JP5.1.2pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torch-2.1.0a0+41361538.nv23.06-cp38-cp38-linux_aarch64.whl pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torchvision-0.16.2+c6f3977-cp38-cp38-linux_aarch64.whl
Visita a página do PyTorch para Jetson para aceder a todas as versões do PyTorch disponíveis para as diferentes versões do JetPack. Para obter uma lista mais detalhada da compatibilidade entre PyTorch e Torchvision, visita a página de compatibilidade entre PyTorch e Torchvision.
Instalar onnxruntime-gpu#
Utiliza uma wheel de ONNX Runtime GPU compatível com as versões do JetPack, Python e CUDA. As versões atuais no PyPI incluem wheels ARM64, mas não substituem os pacotes específicos do dispositivo em todas as versões do JetPack.
Podes encontrar todos os pacotes onnxruntime-gpu disponíveis — organizados por versão do JetPack, versão do Python e outros detalhes de compatibilidade — na matriz de compatibilidade do ONNX Runtime do Jetson Zoo. Aqui vamos transferir e instalar onnxruntime-gpu 1.17.0 com suporte para Python3.8.
wget https://nvidia.box.com/shared/static/zostg6agm00fb6t5uisw51qi6kpcuwzd.whl -O onnxruntime_gpu-1.17.0-cp38-cp38-linux_aarch64.whl
pip install onnxruntime_gpu-1.17.0-cp38-cp38-linux_aarch64.whlonnxruntime-gpu reverte automaticamente a versão do NumPy para a mais recente. Por isso, temos de reinstalar o NumPy na versão 1.23.5 para corrigir um problema, executando:
pip install numpy==1.23.5
Utilizar o TensorRT na NVIDIA Jetson#
Entre todos os formatos de exportação de modelos suportados pelo Ultralytics, o TensorRT oferece o melhor desempenho de inferência nos dispositivos NVIDIA Jetson, sendo a nossa principal recomendação para implementações em Jetson. Antes de exportar, instala os bindings Python do TensorRT fornecidos para a tua versão do JetPack e verifica-os com python3 -c "import tensorrt; print(tensorrt.__version__)". Mantém o runtime TensorRT 10.x suportado no JetPack 6/7; não o substituas pelo TensorRT 11.2.1. Para instruções de configuração e utilização avançada, consulta o nosso guia dedicado à integração do TensorRT.
Também podes exportar a partir do browser sem configurar localmente o ambiente de compilação. No separador Export do modelo na Ultralytics Platform, seleciona TensorRT e o dispositivo Jetson de destino. As seleções Thor são validadas em hardware Thor físico. As seis seleções Orin geram atualmente engines candidatos compilados para AGX-Orin; valida-os no modelo Orin pretendido antes da implementação.
O TensorRT cria perfis e otimiza um engine na GPU utilizada para a compilação. Usa a arquitetura de GPU e o runtime TensorRT/CUDA do dispositivo de destino e valida todos os engines transferidos no dispositivo de implementação. Os modelos Orin com a mesma arquitetura não têm portabilidade garantida automaticamente, e a calibração INT8 deve ser feita no dispositivo de destino para obter os melhores resultados.
Converter o modelo para TensorRT e executar a inferência#
O modelo YOLO26n no formato PyTorch é convertido para TensorRT para executar a inferência com o modelo exportado.
from ultralytics import YOLO

# Carregar um modelo YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Exportar o modelo para TensorRT
model.export(format="engine")  # cria 'yolo26n.engine'

# Carregar o modelo TensorRT exportado
trt_model = YOLO("yolo26n.engine")

# Executar inferência
results = trt_model("https://ultralytics.com/images/bus.jpg")Visita a página de exportação para aceder a argumentos adicionais ao exportar modelos para diferentes formatos
Utilizar o NVIDIA Deep Learning Accelerator (DLA)#
O NVIDIA Deep Learning Accelerator (DLA) é um componente de hardware especializado integrado nos dispositivos NVIDIA Jetson que otimiza a inferência de aprendizagem profunda para eficiência energética e desempenho. Ao transferir tarefas da GPU (libertando-a para processos mais exigentes), o DLA permite executar modelos com menor consumo de energia e, ao mesmo tempo, manter um elevado débito, algo ideal para sistemas integrados e aplicações de IA em tempo real.
A NVIDIA indica que o TensorRT 10.7 é a última versão com suporte para DLA; o TensorRT 11.0, 11.1 e 11.2 não são compatíveis com DLA. Utiliza uma versão do TensorRT compatível com DLA e suportada pela tua versão do JetPack. O TensorRT 11.2.1 não é compatível com o JetPack, incluindo exportações apenas para GPU.
Os seguintes dispositivos Jetson estão equipados com hardware DLA:
| Dispositivo Jetson | Núcleos DLA | Frequência máxima do DLA |
|---|---|---|
| Série Jetson AGX Orin | 2 | 1.6 GHz |
| Jetson Orin NX 16GB | 2 | 614 MHz |
| Jetson Orin NX 8GB | 1 | 614 MHz |
| Série Jetson AGX Xavier | 2 | 1.4 GHz |
| Série Jetson Xavier NX | 2 | 1.1 GHz |
from ultralytics import YOLO

# Carregar um modelo YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Exportar o modelo para TensorRT com DLA ativado (só funciona com FP16 ou INT8)
model.export(format="engine", device="dla:0", quantize=16)  # dla:0 ou dla:1 corresponde aos núcleos DLA

# Carregar o modelo TensorRT exportado
trt_model = YOLO("yolo26n.engine")

# Executar inferência
results = trt_model("https://ultralytics.com/images/bus.jpg")Ao utilizar exportações DLA, algumas camadas podem não ser compatíveis com a execução no DLA e serão executadas na GPU. Esta alternativa pode introduzir latência adicional e afetar o desempenho geral da inferência. Por isso, o DLA não foi concebido principalmente para reduzir a latência de inferência em comparação com o TensorRT a funcionar inteiramente na GPU. O seu objetivo principal é, antes, aumentar o débito e melhorar a eficiência energética.
Benchmarks do NVIDIA Jetson com YOLO26#
A equipa Ultralytics executou benchmarks do YOLO26 em 11 formatos de modelo diferentes, medindo a velocidade e a precisão: PyTorch, TorchScript, ONNX, OpenVINO, TensorRT, TF SavedModel, TF GraphDef, TF Lite, MNN, NCNN e ExecuTorch. Os benchmarks foram executados no kit de desenvolvimento NVIDIA Jetson AGX Thor, no kit de desenvolvimento NVIDIA Jetson AGX Orin (64GB), no kit de desenvolvimento NVIDIA Jetson Orin Nano Super e no Seeed Studio reComputer J4012 equipado com um dispositivo Jetson Orin NX 16GB, com precisão FP32 e um tamanho de imagem de entrada predefinido de 640.
Gráficos comparativos#
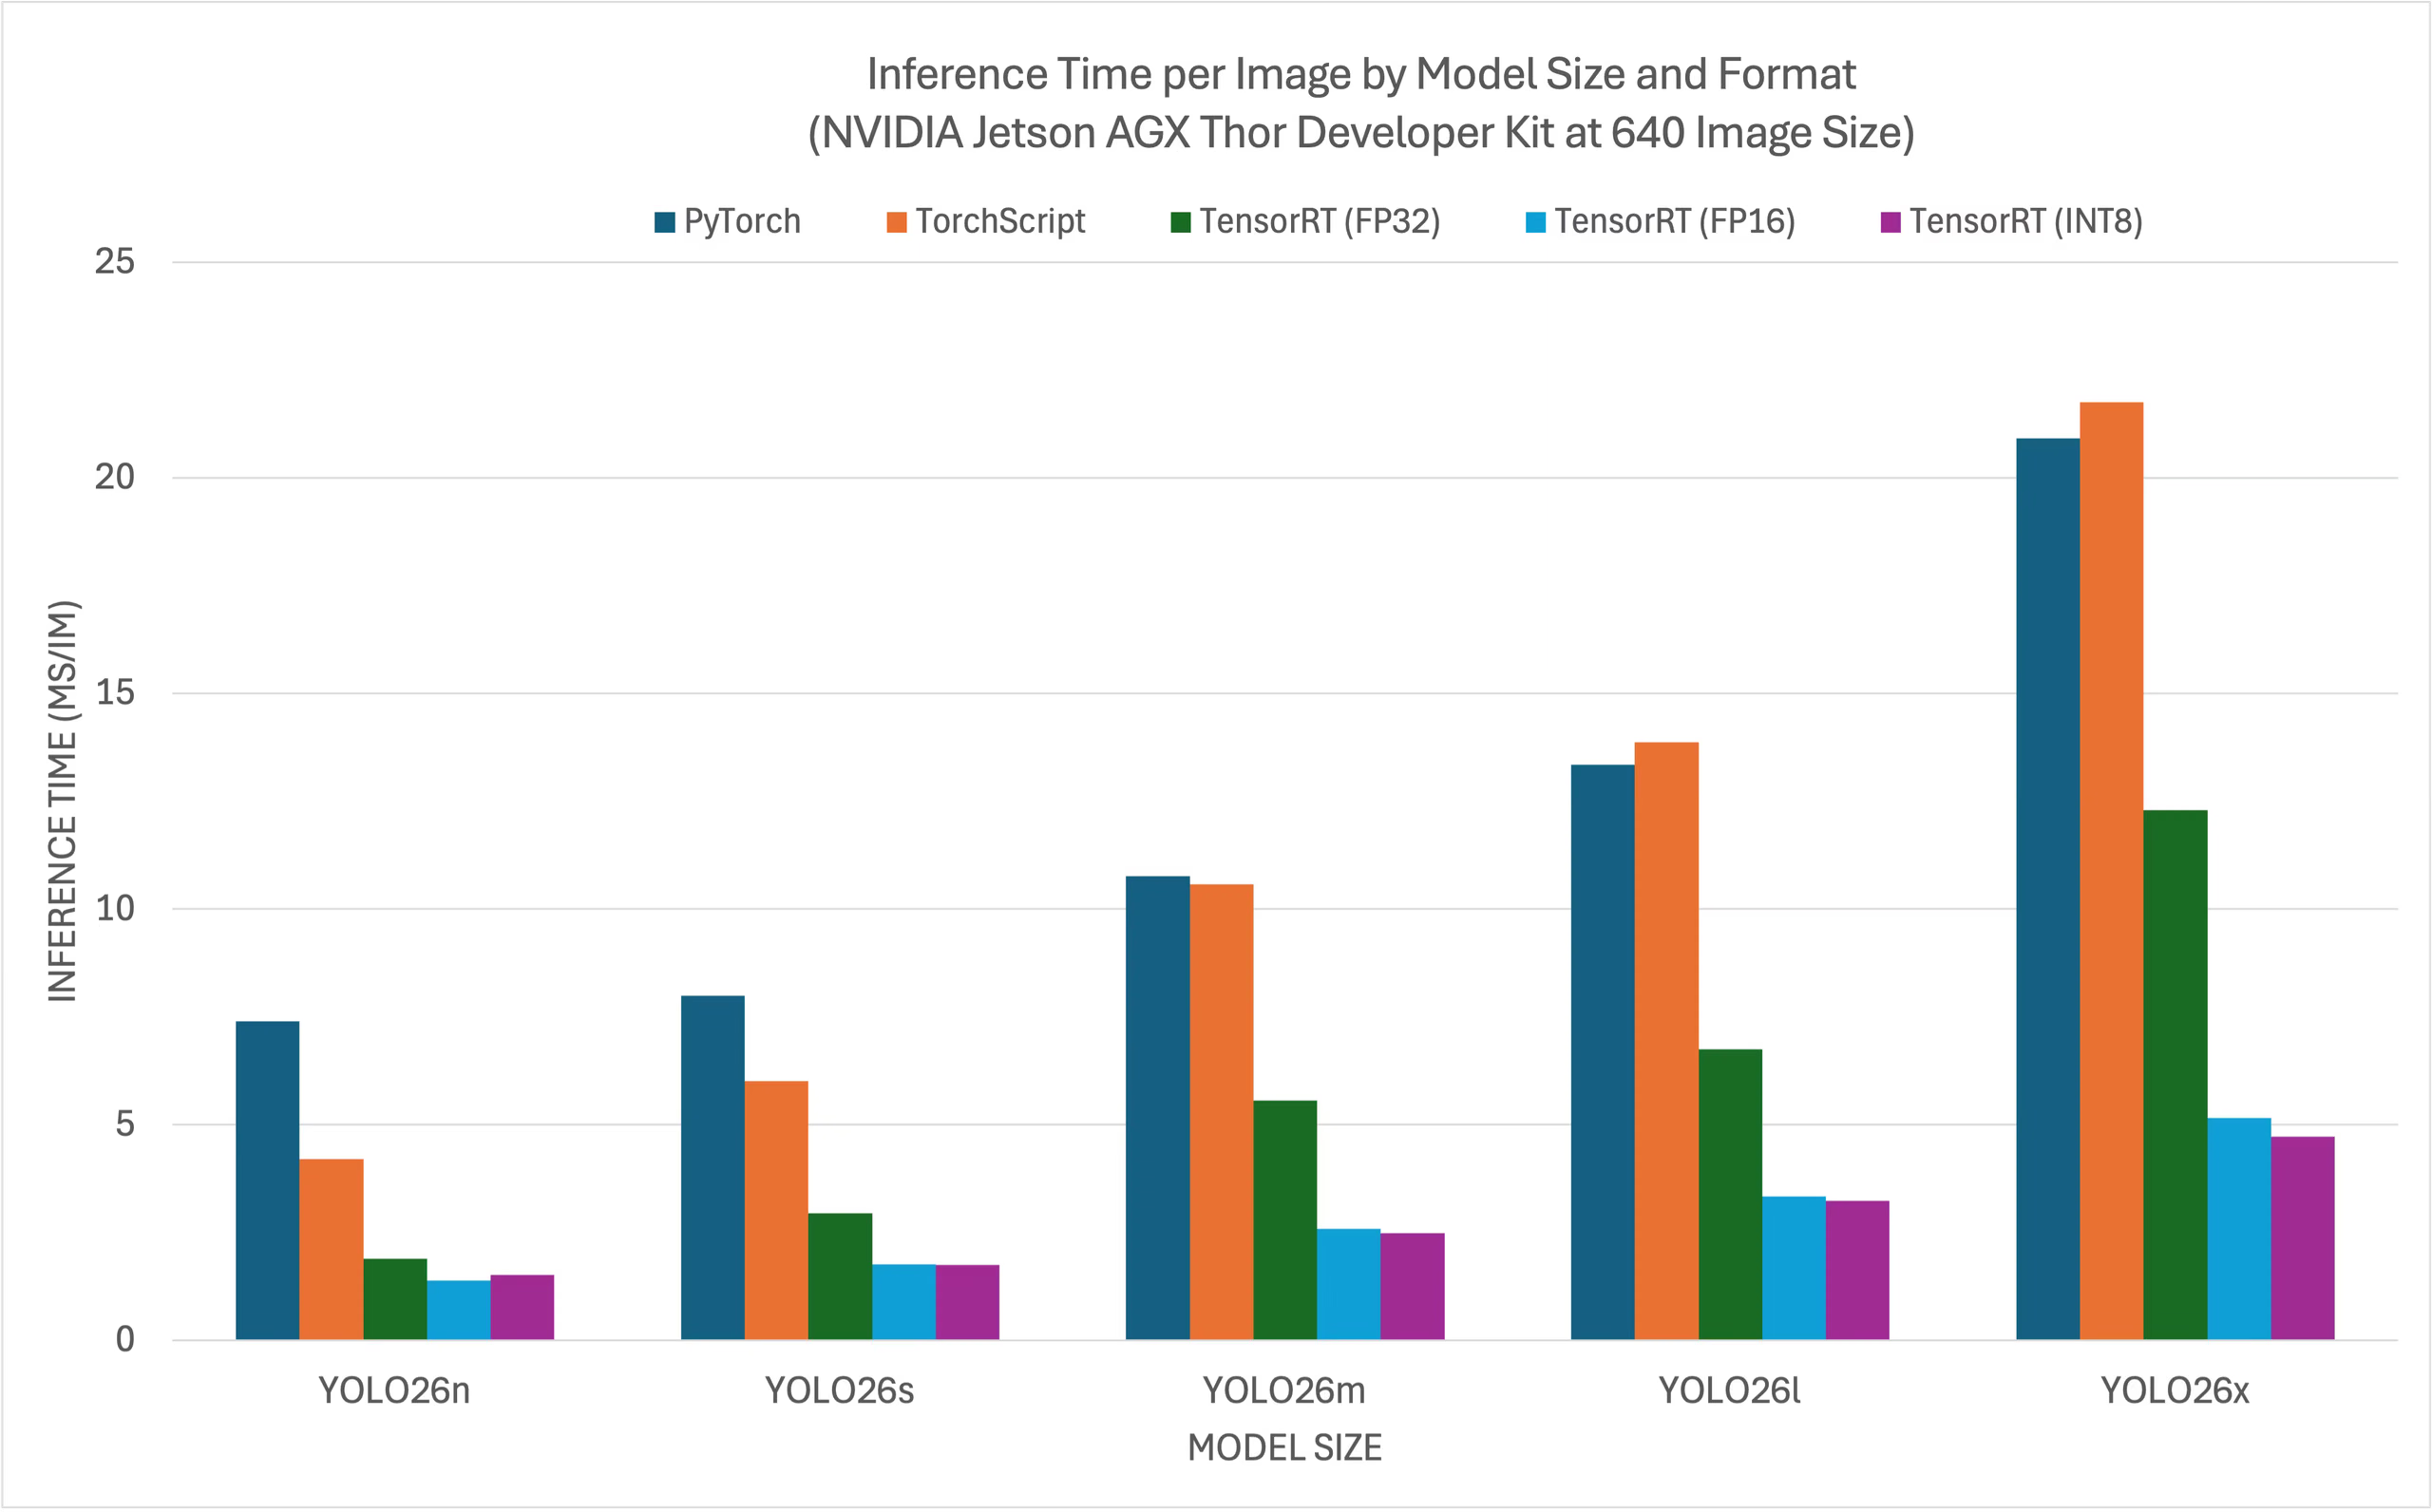
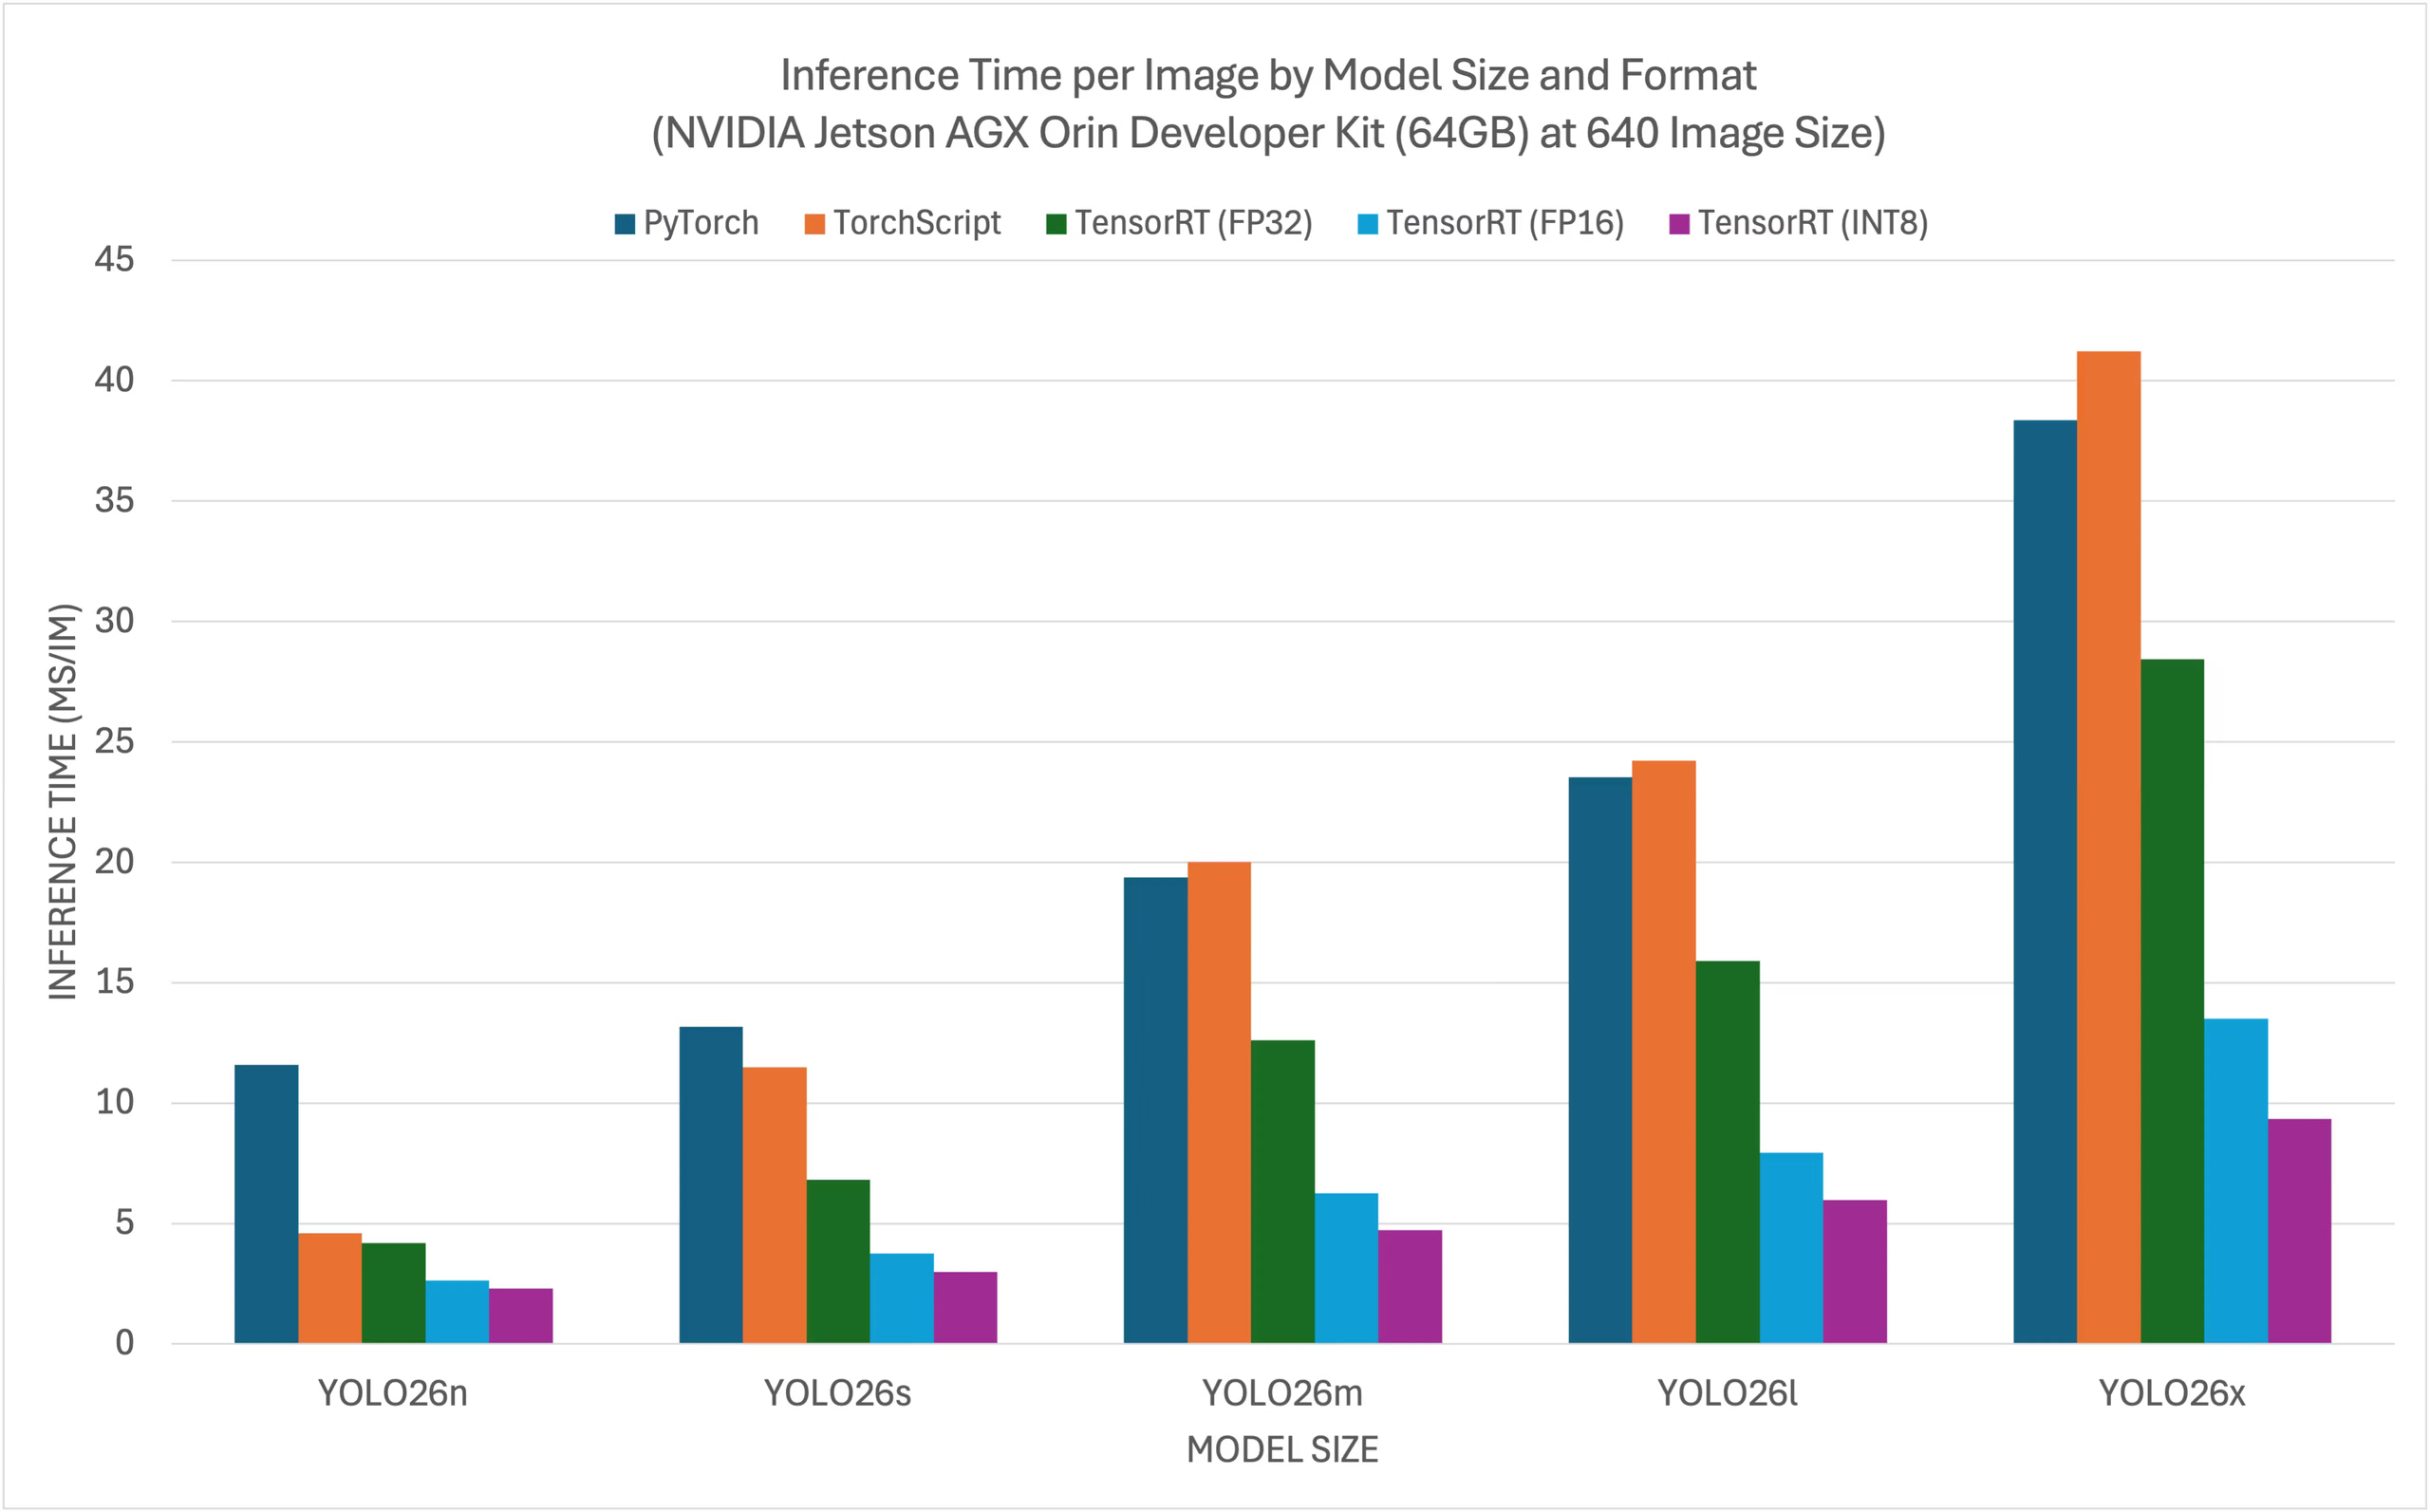
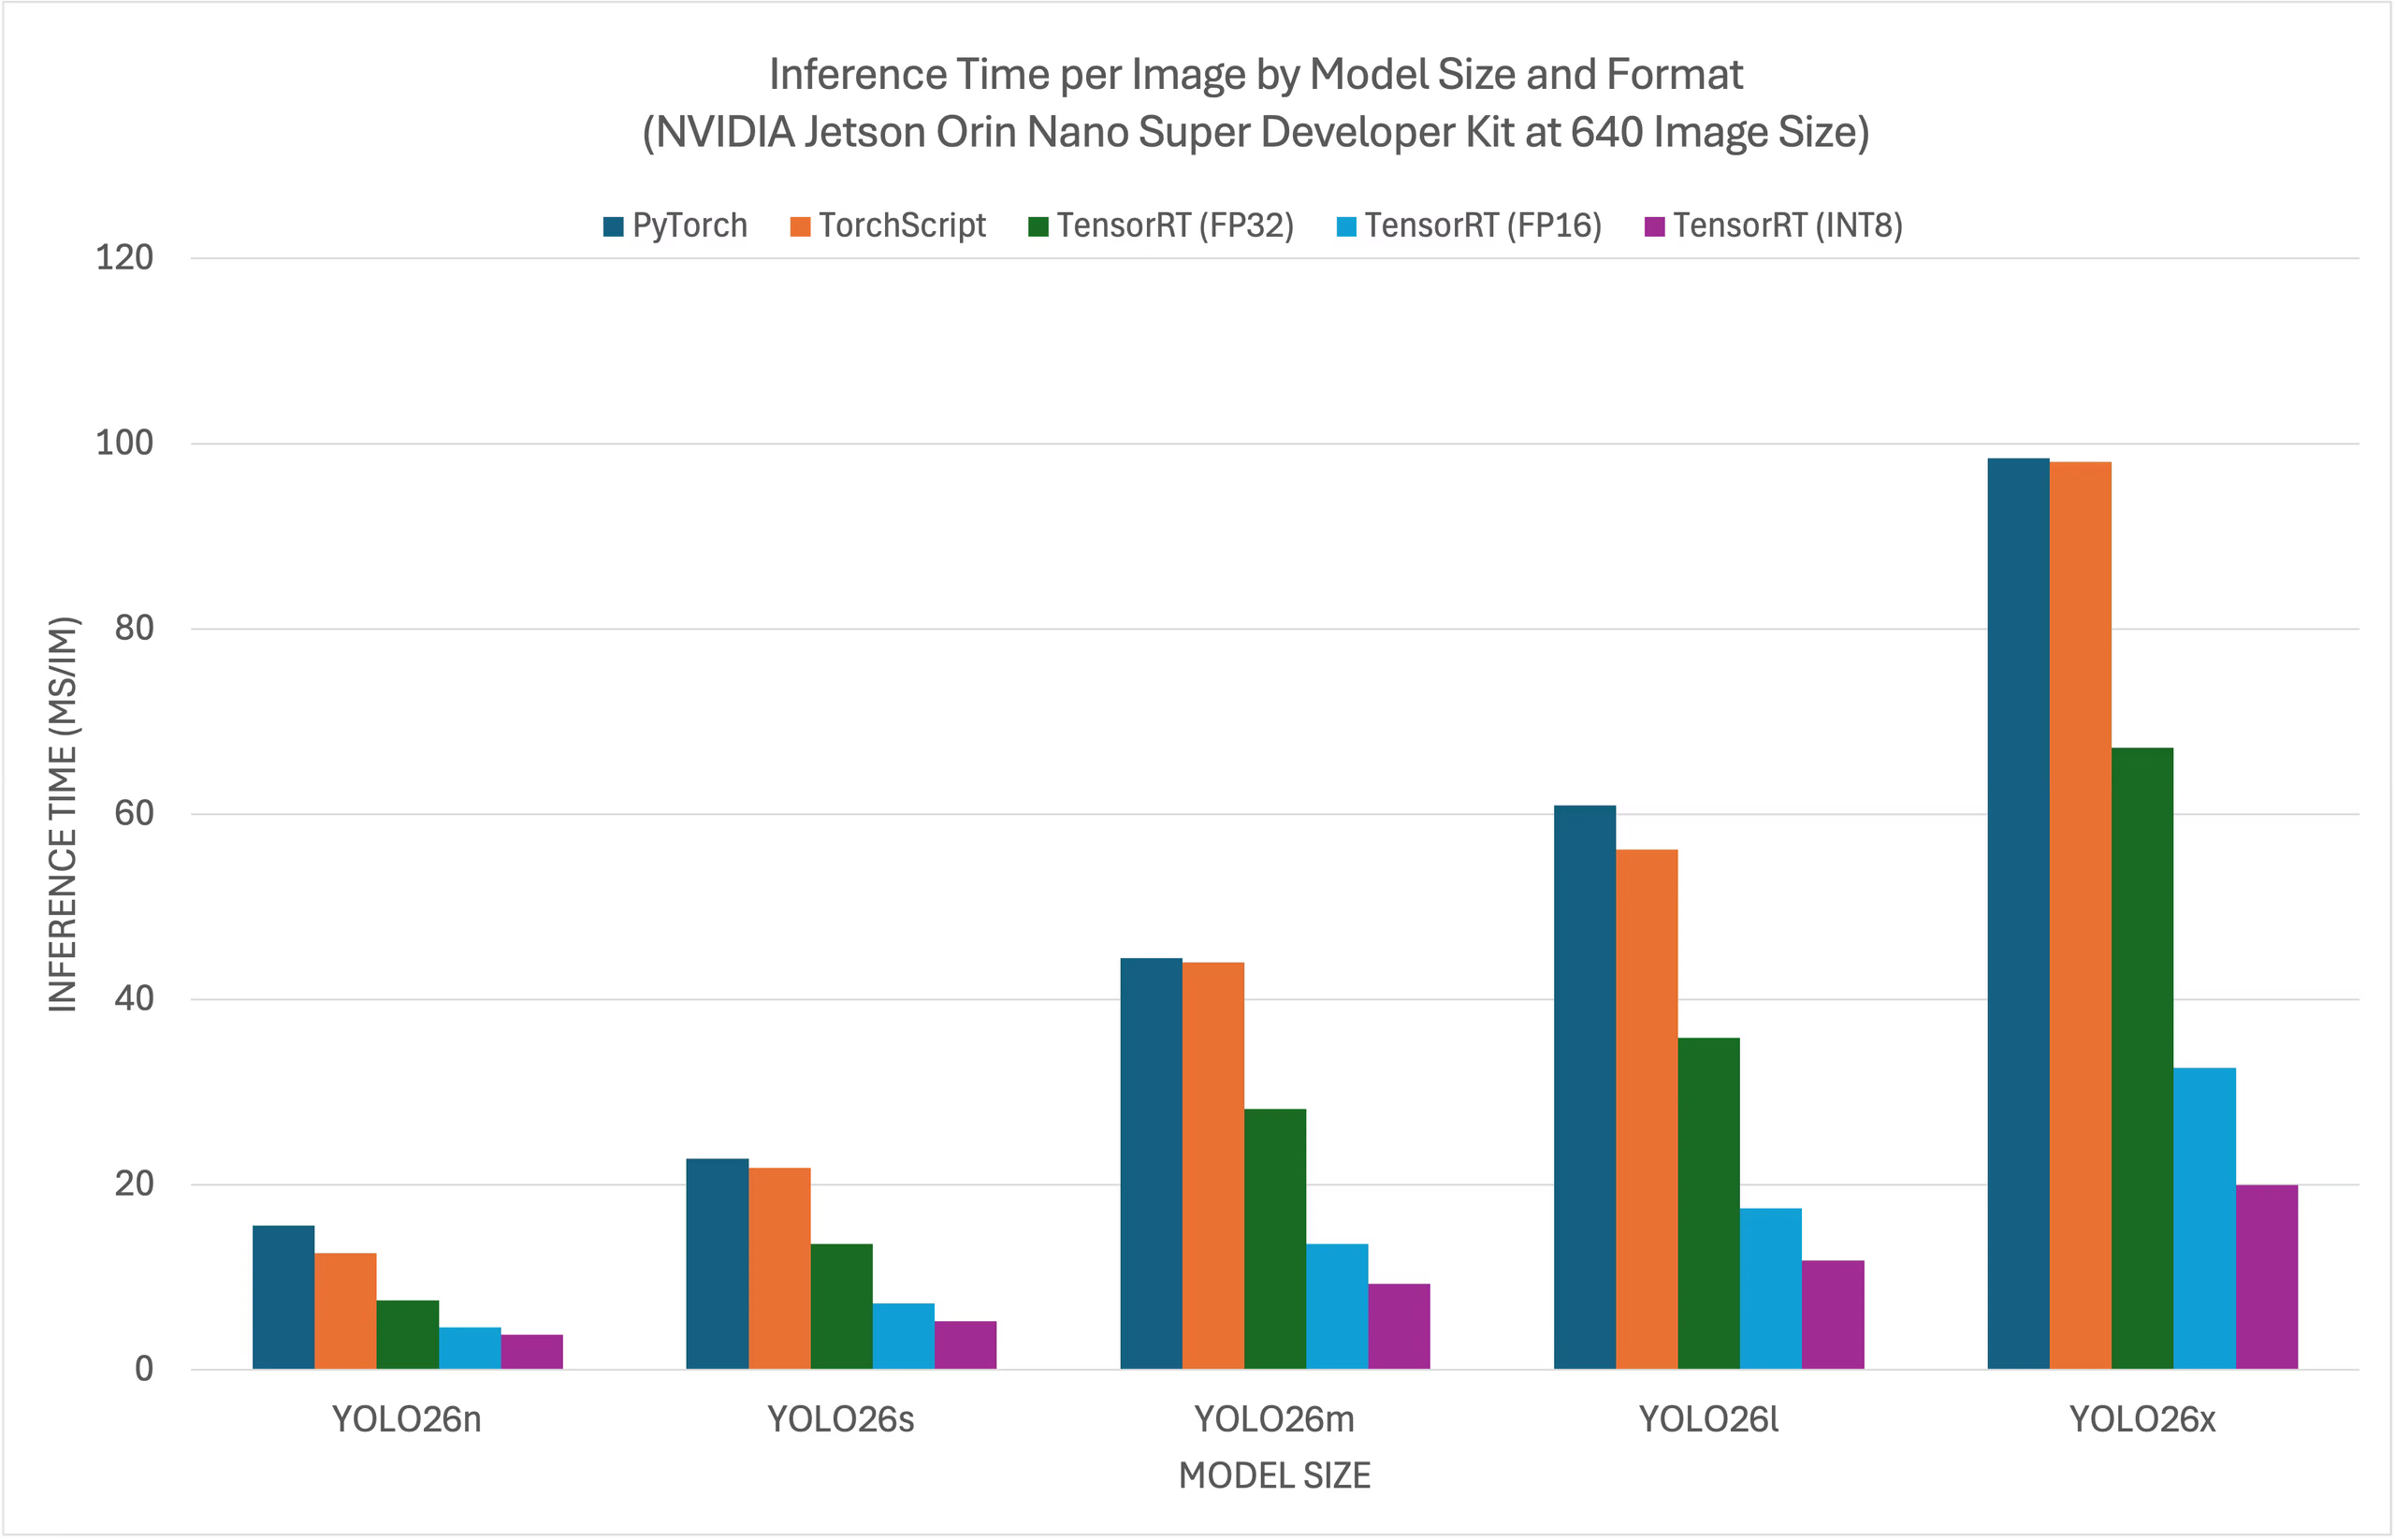
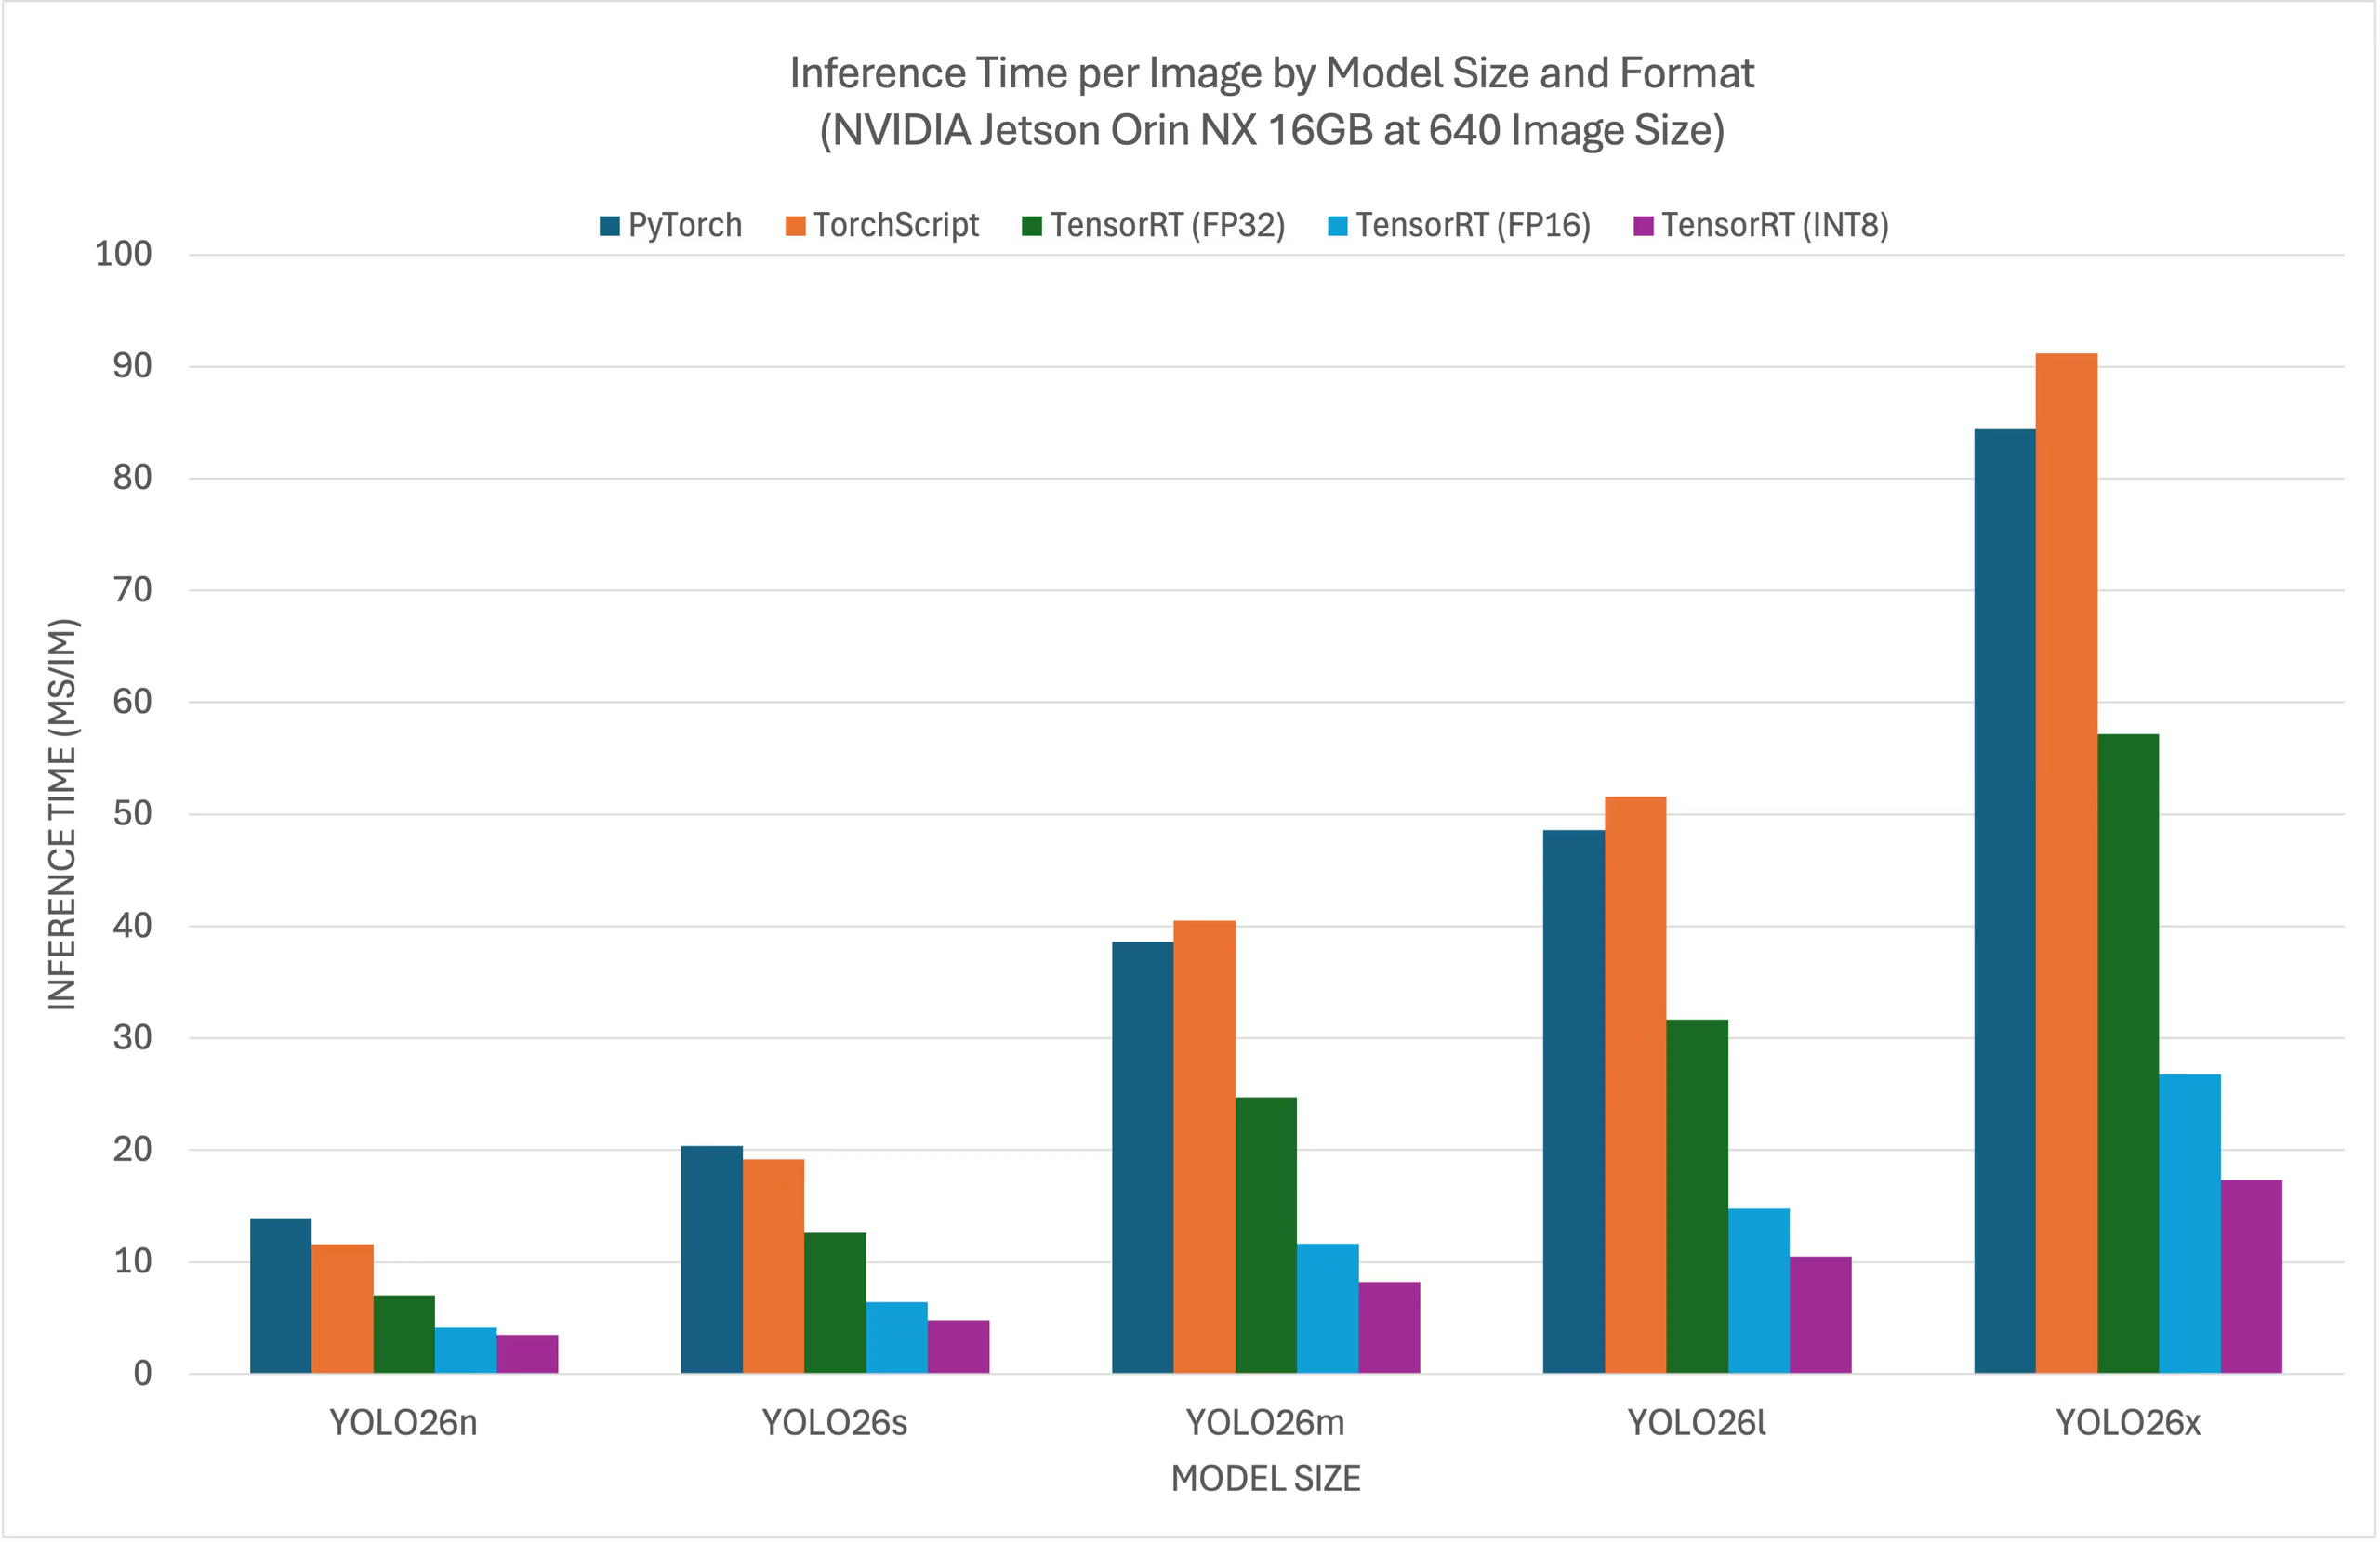
Embora todas as exportações de modelos funcionem na NVIDIA Jetson, incluímos apenas PyTorch, TorchScript, TensorRT no gráfico comparativo abaixo, porque utilizam a GPU da Jetson e garantem os melhores resultados. Todas as outras exportações utilizam apenas a CPU e têm um desempenho inferior ao dos três formatos acima. Podes encontrar os benchmarks de todas as exportações na secção após este gráfico.
Kit de desenvolvimento NVIDIA Jetson AGX Thor#
Kit de desenvolvimento NVIDIA Jetson AGX Orin (64GB)#
Kit de desenvolvimento NVIDIA Jetson Orin Nano Super#
NVIDIA Jetson Orin NX 16GB#
Tabelas de comparação detalhadas#
A tabela abaixo apresenta os resultados de benchmark de cinco modelos diferentes (YOLO26n, YOLO26s, YOLO26m, YOLO26l, YOLO26x) em 11 formatos diferentes (PyTorch, TorchScript, ONNX, OpenVINO, TensorRT, TF SavedModel, TF GraphDef, TF Lite, MNN, NCNN, ExecuTorch), mostrando o status, o tamanho, a métrica mAP50-95(B) e o tempo de inferência de cada combinação.
Kit de desenvolvimento NVIDIA Jetson AGX Thor#
| Formato | Status | Tamanho em disco (MB) | mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4798 | 7.39 |
| TorchScript | ✅ | 9.8 | 0.4789 | 4.21 |
| ONNX | ✅ | 9.5 | 0.4767 | 6.58 |
| OpenVINO | ✅ | 10.1 | 0.4794 | 17.50 |
| TensorRT (FP32) | ✅ | 13.9 | 0.4791 | 1.90 |
| TensorRT (FP16) | ✅ | 7.6 | 0.4797 | 1.39 |
| TensorRT (INT8) | ✅ | 6.5 | 0.4273 | 1.52 |
| TF SavedModel | ✅ | 25.7 | 0.4764 | 47.24 |
| TF GraphDef | ✅ | 9.5 | 0.4764 | 45.98 |
| TF Lite | ✅ | 9.9 | 0.4764 | 182.04 |
| MNN | ✅ | 9.4 | 0.4784 | 21.83 |
Benchmark realizado com Ultralytics 8.4.7
O tempo de inferência não inclui o pré/pós-processamento.
Kit de desenvolvimento NVIDIA Jetson AGX Orin (64GB)#
| Formato | Status | Tamanho em disco (MB) | mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4790 | 11.58 |
| TorchScript | ✅ | 9.8 | 0.4770 | 4.60 |
| ONNX | ✅ | 9.5 | 0.4770 | 9.87 |
| OpenVINO | ✅ | 9.6 | 0.4820 | 28.80 |
| TensorRT (FP32) | ✅ | 11.5 | 0.4770 | 4.18 |
| TensorRT (FP16) | ✅ | 7.9 | 0.4789 | 2.62 |
| TensorRT (INT8) | ✅ | 5.4 | 0.4640 | 2.30 |
| TF SavedModel | ✅ | 24.6 | 0.4760 | 71.10 |
| TF GraphDef | ✅ | 9.5 | 0.4760 | 70.02 |
| TF Lite | ✅ | 9.9 | 0.4760 | 227.94 |
| MNN | ✅ | 9.4 | 0.4760 | 32.46 |
| NCNN | ✅ | 9.3 | 0.4810 | 29.93 |
Benchmark realizado com Ultralytics 8.4.32
O tempo de inferência não inclui o pré/pós-processamento.
Kit de desenvolvimento NVIDIA Jetson Orin Nano Super#
| Formato | Status | Tamanho em disco (MB) | mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4790 | 15.60 |
| TorchScript | ✅ | 9.8 | 0.4770 | 12.60 |
| ONNX | ✅ | 9.5 | 0.4760 | 15.76 |
| OpenVINO | ✅ | 9.6 | 0.4820 | 56.23 |
| TensorRT (FP32) | ✅ | 11.3 | 0.4770 | 7.53 |
| TensorRT (FP16) | ✅ | 8.1 | 0.4800 | 4.57 |
| TensorRT (INT8) | ✅ | 5.3 | 0.4490 | 3.80 |
| TF SavedModel | ✅ | 24.6 | 0.4760 | 118.33 |
| TF GraphDef | ✅ | 9.5 | 0.4760 | 116.30 |
| TF Lite | ✅ | 9.9 | 0.4760 | 286.00 |
| MNN | ✅ | 9.4 | 0.4760 | 68.77 |
| NCNN | ✅ | 9.3 | 0.4810 | 47.50 |
Benchmark realizado com Ultralytics 8.4.33
O tempo de inferência não inclui o pré/pós-processamento.
NVIDIA Jetson Orin NX 16GB#
| Formato | Status | Tamanho em disco (MB) | mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4799 | 13.90 |
| TorchScript | ✅ | 9.8 | 0.4787 | 11.60 |
| ONNX | ✅ | 9.5 | 0.4763 | 14.18 |
| OpenVINO | ✅ | 9.6 | 0.4819 | 40.19 |
| TensorRT (FP32) | ✅ | 11.4 | 0.4770 | 7.01 |
| TensorRT (FP16) | ✅ | 8.0 | 0.4789 | 4.13 |
| TensorRT (INT8) | ✅ | 5.5 | 0.4489 | 3.49 |
| TF SavedModel | ✅ | 24.6 | 0.4764 | 92.34 |
| TF GraphDef | ✅ | 9.5 | 0.4764 | 92.06 |
| TF Lite | ✅ | 9.9 | 0.4764 | 254.43 |
| MNN | ✅ | 9.4 | 0.4760 | 48.55 |
| NCNN | ✅ | 9.3 | 0.4805 | 34.31 |
Benchmark realizado com Ultralytics 8.4.33
O tempo de inferência não inclui o pré/pós-processamento.
Explore mais iniciativas de benchmarking da Seeed Studio executadas em diferentes versões do hardware NVIDIA Jetson.
Reproduza nossos resultados#
Para reproduzir os benchmarks da Ultralytics acima em todos os formatos de exportação, execute este código:
from ultralytics import YOLO

# Carregar um modelo YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Benchmarke a velocidade e a precisão do YOLO26n no conjunto de dados COCO128 para todos os formatos de exportação
results = model.benchmark(data="coco128.yaml", imgsz=640)
Observe que os resultados do benchmark podem variar conforme a configuração exata de hardware e software de um sistema, bem como a carga de trabalho atual do sistema no momento da execução dos benchmarks. Para obter resultados mais confiáveis, use um conjunto de dados com um grande número de imagens, por exemplo, data='coco.yaml' (5000 imagens de validação).
Práticas recomendadas ao usar NVIDIA Jetson#
Ao usar NVIDIA Jetson, há algumas práticas recomendadas a seguir para obter o máximo desempenho do YOLO26 em NVIDIA Jetson.
-
Ative o modo de potência MAX
Ativar o modo de potência MAX no Jetson garante que todos os núcleos de CPU e GPU estejam ligados.
sudo nvpmodel -m 0 -
Ative os Jetson Clocks
Ativar os Jetson Clocks garante que todos os núcleos de CPU e GPU operem na frequência máxima.
sudo jetson_clocks -
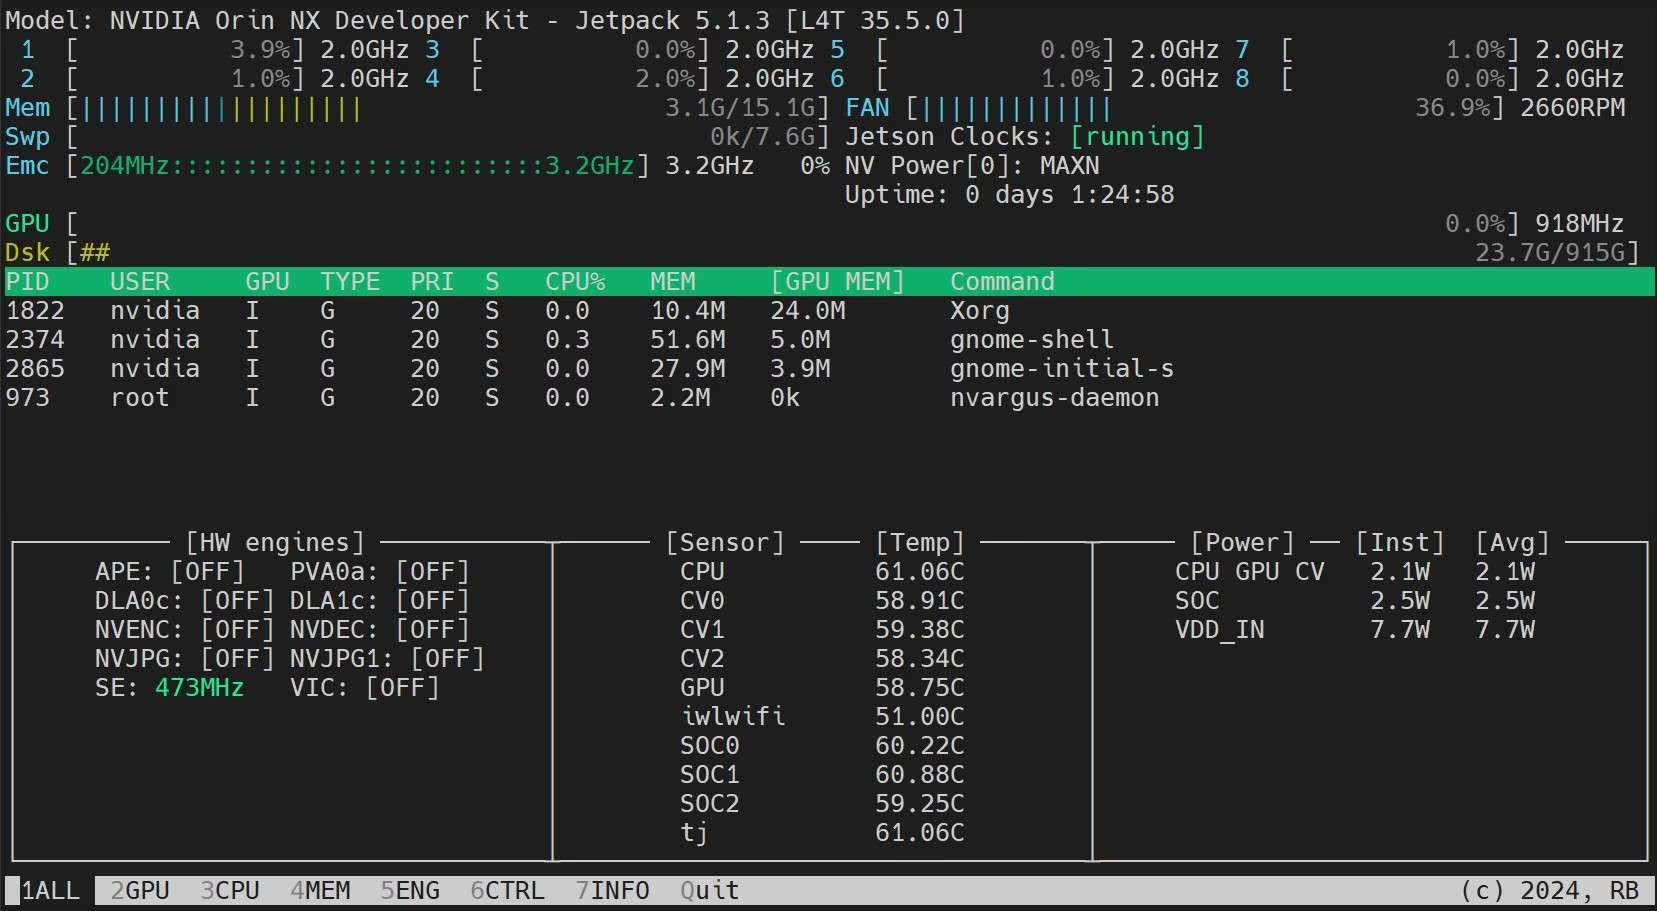
Instale o aplicativo Jetson Stats
Podemos usar o aplicativo jetson stats para monitorar as temperaturas dos componentes do sistema e verificar outros detalhes, como o uso de CPU, GPU e RAM, alterar modos de energia, definir as frequências máximas e consultar informações do JetPack.
sudo apt update
sudo pip install jetson-stats
sudo reboot
jtop
Dicas de otimização de memória para NVIDIA Jetson#
A memória disponível costuma ser o fator limitante nos dispositivos Jetson, principalmente nas variantes com menos memória, como o Jetson Orin Nano (8 GB) ou o Orin NX 8 GB. As dicas abaixo são mudanças práticas e de baixo risco que, em conjunto, podem liberar várias centenas de megabytes e permitir executar modelos YOLO maiores ou oferecer suporte a mais cargas de trabalho paralelas. Para uma visão abrangente, consulte o artigo da NVIDIA sobre como maximizar a eficiência da memória no Jetson.
1. Mude para a inicialização sem interface gráfica (headless)#
Se o Jetson estiver conectado por SSH ou funcionando como um dispositivo de produção sem monitor conectado, eliminar o ambiente de desktop e o servidor de exibição pode liberar até 865 MB de RAM:
sudo systemctl set-default multi-user.target
sudo reboot
Para restaurar o ambiente de desktop mais tarde:
sudo systemctl set-default graphical.target
sudo reboot
2. Desative serviços do sistema não utilizados#
Serviços em segundo plano não essenciais (Bluetooth, gerenciadores de conectividade, daemons de hardware não utilizados) consomem cerca de 32 MB no total. Liste os serviços ativos e desative tudo de que sua implantação não precisa:
# List running services
systemctl list-units --type=service --state=running

# Disable a service
sudo systemctl disable SERVICE_NAME
3. Analise o uso de memória#
Antes de otimizar, identifique quais processos estão realmente consumindo RAM. procrank ordena os processos por PSS (Proportional Set Size), que reflete o uso de memória real de cada processo com mais precisão do que RSS (Resident Set Size, o total de páginas de RAM física mapeadas por um processo, incluindo páginas compartilhadas com outros processos):
git clone https://github.com/csimmonds/procrank_linux.git
cd procrank_linux && make
sudo ./procrank
Para ver as alocações de GPU e NvMap (pipeline CUDA/vídeo) por processo:
sudo cat /sys/kernel/debug/nvmap/iovmm/clients4. Execute inferência sem monitor em produção#
Em pipelines de inferência que não precisam de pré-visualização ao vivo, desativar componentes relacionados à exibição (Tiler, OSD, DisplaySink) pode economizar mais de 200 MB apenas no pipeline. Com Ultralytics YOLO, desative o visualizador e grave os resultados em disco:
from ultralytics import YOLO

model = YOLO("yolo26n.engine")

# show=False impede qualquer janela de exibição; save=True grava a saída anotada em disco
results = model.predict(source="video.mp4", show=False, save=True)
Impacto acumulado#
| Otimização | Memória aproximada liberada |
|---|---|
| Desativar a interface gráfica do desktop | ~865 MB |
| Desativar serviços do sistema operacional não utilizados | ~32 MB |
| Pipeline de inferência sem interface gráfica (sem exibição) | ~200+ MB |
| Total (ganhos fáceis) | ~1 GB+ |
Combinar essas mudanças é especialmente valioso ao usar modelos TensorRT INT8 em dispositivos com memória limitada — pode ser a diferença entre conseguir ou não manter na memória uma variante maior do modelo.
Próximas etapas#
Para saber mais e obter suporte, consulte a documentação do Ultralytics YOLO26.
Perguntas frequentes#
Implantar o Ultralytics YOLO26 em dispositivos NVIDIA Jetson é um processo simples. Primeiro, grave o NVIDIA JetPack SDK no dispositivo Jetson. Em seguida, use uma imagem Docker pré-compilada para uma configuração rápida ou instale manualmente os pacotes necessários. Você encontra instruções detalhadas para cada abordagem nas seções Introdução rápida com Docker e Comece com a instalação nativa.
Os modelos YOLO26 foram avaliados em vários dispositivos NVIDIA Jetson, com melhorias significativas de desempenho. Por exemplo, o formato TensorRT oferece o melhor desempenho de inferência. A tabela da seção Tabelas de comparação detalhadas apresenta uma visão abrangente de métricas de desempenho, como mAP50-95 e tempo de inferência, em diferentes formatos de modelo.
TensorRT é altamente recomendado para implantar modelos YOLO26 em NVIDIA Jetson devido ao seu desempenho ideal. Ele acelera a inferência aproveitando os recursos de GPU do Jetson, garantindo máxima eficiência e velocidade. Saiba mais sobre como converter para TensorRT e executar inferência na seção Use TensorRT em NVIDIA Jetson.
Para instalar PyTorch e Torchvision em NVIDIA Jetson, primeiro desinstale as versões existentes que possam ter sido instaladas via pip. Em seguida, instale manualmente as versões compatíveis de PyTorch e Torchvision para a arquitetura ARM64 do Jetson. As instruções detalhadas desse processo estão na seção Instale PyTorch e Torchvision.
Para maximizar o desempenho de YOLO26 em NVIDIA Jetson, siga estas práticas recomendadas:
- Ative o modo de potência MAX para utilizar todos os núcleos de CPU e GPU.
- Ative os Jetson Clocks para operar todos os núcleos na frequência máxima.
- Instale o aplicativo Jetson Stats para monitorar as métricas do sistema.
Para ver os comandos e mais detalhes, consulte a seção Práticas recomendadas ao usar NVIDIA Jetson.
A RAM disponível costuma ser o gargalo nos dispositivos Jetson com menos memória. Três ganhos fáceis que, juntos, podem liberar mais de 1 GB:
- Mude para a inicialização sem interface gráfica (
sudo systemctl set-default multi-user.target) para eliminar a interface gráfica do desktop (~865 MB liberados). - Desative serviços não utilizados, como Bluetooth ou gerenciadores de conectividade (~32 MB liberados).
- Execute inferência sem monitor definindo
show=Falsena chamada YOLOpredict, o que evita alocar memória para o pipeline de exibição (~200+ MB liberados).
Use
procrankpara analisar o uso de RAM por processo esudo cat /sys/kernel/debug/nvmap/iovmm/clientspara inspecionar as alocações de GPU. Consulte a seção Dicas de otimização de memória para ver todos os detalhes.- Mude para a inicialização sem interface gráfica (
TensorRT 10.3.0, incluído no JetPack 6, tem um problema conhecido que impede a criação de mecanismos INT8 sem NMS (
nms=False). Quando a Ultralytics detecta essa combinação, seleciona automaticamente a cabeça one-to-many para garantir que a exportação seja concluída.Para restaurar as exportações INT8 sem NMS, atualize TensorRT para uma versão mais recente (por exemplo, 10.7.0+):
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/arm64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb
sudo apt-get update
sudo apt-get install -y tensorrt
Após a atualização, execute a exportação novamente. Para mais detalhes, consulte o problema #23841 no GitHub.