Guia para usar o Kaggle no treino dos teus modelos YOLO26
Se você está aprendendo sobre IA e trabalhando em pequenos projetos, talvez ainda não tenha acesso a recursos computacionais potentes, e o hardware de ponta pode ser caro. O Kaggle, uma plataforma pertencente ao Google, oferece um ambiente gratuito na nuvem, onde você pode acessar recursos de GPU, trabalhar com grandes conjuntos de dados e colaborar com uma comunidade diversificada de cientistas de dados e entusiastas de aprendizado de máquina.
O Kaggle é uma opção prática para treinar e experimentar os modelos Ultralytics YOLO26. Os notebooks do Kaggle vêm com bibliotecas e frameworks populares de aprendizado de máquina pré-instalados. Este guia explora os principais recursos do Kaggle e mostra como treinar modelos YOLO26 na plataforma.
O que é o Kaggle?#
O Kaggle é uma plataforma que reúne cientistas de dados do mundo todo para colaborar, aprender e competir na resolução de problemas reais de ciência de dados. Lançado em 2010 por Anthony Goldbloom e Jeremy Howard e adquirido pelo Google em 2017, o Kaggle permite que os usuários se conectem, descubram e compartilhem conjuntos de dados, usem notebooks com GPU e participem de competições de ciência de dados. A plataforma atende tanto profissionais experientes quanto pessoas em aprendizagem.
Com mais de 10 milhões de usuários em 2022, o Kaggle oferece um ambiente rico para desenvolver e experimentar modelos de aprendizado de máquina. Você não precisa se preocupar com as especificações ou a configuração do seu computador local; basta ter uma conta no Kaggle e um navegador da Web.
Instalação#
Antes de começar a treinar modelos YOLO26 no Kaggle, você precisa garantir que o ambiente do notebook esteja configurado corretamente. Siga estas etapas:
Ativa o acesso à Internet#
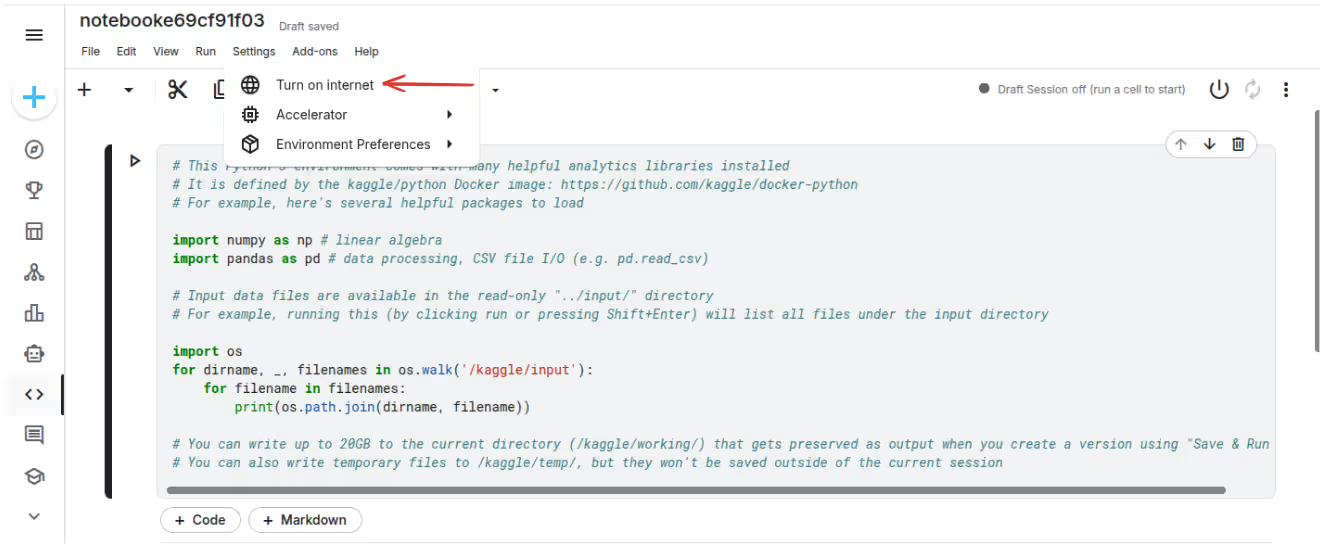
Os notebooks do Kaggle precisam de acesso à Internet para transferir pacotes e dependências. Para ativar a Internet no teu notebook Kaggle:
- Abre o teu notebook Kaggle
- Clica no painel Settings à direita da interface do notebook
- Desloca-te para baixo até à secção Internet
- Ativa o interruptor para ON para permitir a ligação à Internet
Observação: É necessário ter acesso à internet para instalar o pacote Ultralytics e baixar modelos pré-treinados ou conjuntos de dados. Sem acesso à internet, as instalações de pacotes falharão.
Instalar Ultralytics#
Depois de ativar o acesso à Internet, instala o pacote Ultralytics executando o seguinte comando numa célula do notebook:
!pip install ultralyticsPara instalar a versão de desenvolvimento mais recente, podes instalá-la diretamente a partir do GitHub:
!pip install git+https://github.com/ultralytics/ultralytics.gitResolver conflitos de dependências#
Durante a instalação, podes encontrar conflitos de dependências, especialmente com pacotes como opencv-python, numpy ou torch. Eis algumas soluções comuns:
Método 1: Forçar a reinstalação com --upgrade#
Se encontrares conflitos com pacotes existentes, força uma atualização:
!pip install --upgrade --force-reinstall ultralyticsMétodo 2: Reiniciar o kernel após a instalação#
Por vezes, tens de reiniciar o kernel após a instalação para resolver problemas de importação:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
Soluções para erros comuns#
Erro: "No module named 'ultralytics'"
- Solução: confirma que a Internet está ativada e executa novamente o comando de instalação
- Reinicia o kernel após a instalação
Erro: "ERROR: pip's dependency resolver does not currently take into account..."
- Solução: normalmente, trata-se de um aviso que podes ignorar em segurança. A instalação costuma ser concluída apesar da mensagem
Erro: "ModuleNotFoundError" após a instalação
- Solução: reinicia o kernel com o botão de reinício na interface do notebook
- Volta a executar as instruções de importação numa nova célula
Verificar a instalação#
Após a instalação, confirma se o Ultralytics foi instalado corretamente executando:
import ultralytics

ultralytics.checks()
Isto vai apresentar informações do sistema e confirmar que todas as dependências estão instaladas corretamente.
Treinar YOLO26 com o Kaggle#
As GPUs gratuitas do Kaggle facilitam o treinamento de modelos YOLO26.
Para começar, abra o notebook do tutorial Ultralytics YOLO26 no Kaggle. O ambiente do Kaggle inclui bibliotecas pré-instaladas, como TensorFlow e PyTorch, o que simplifica a configuração.
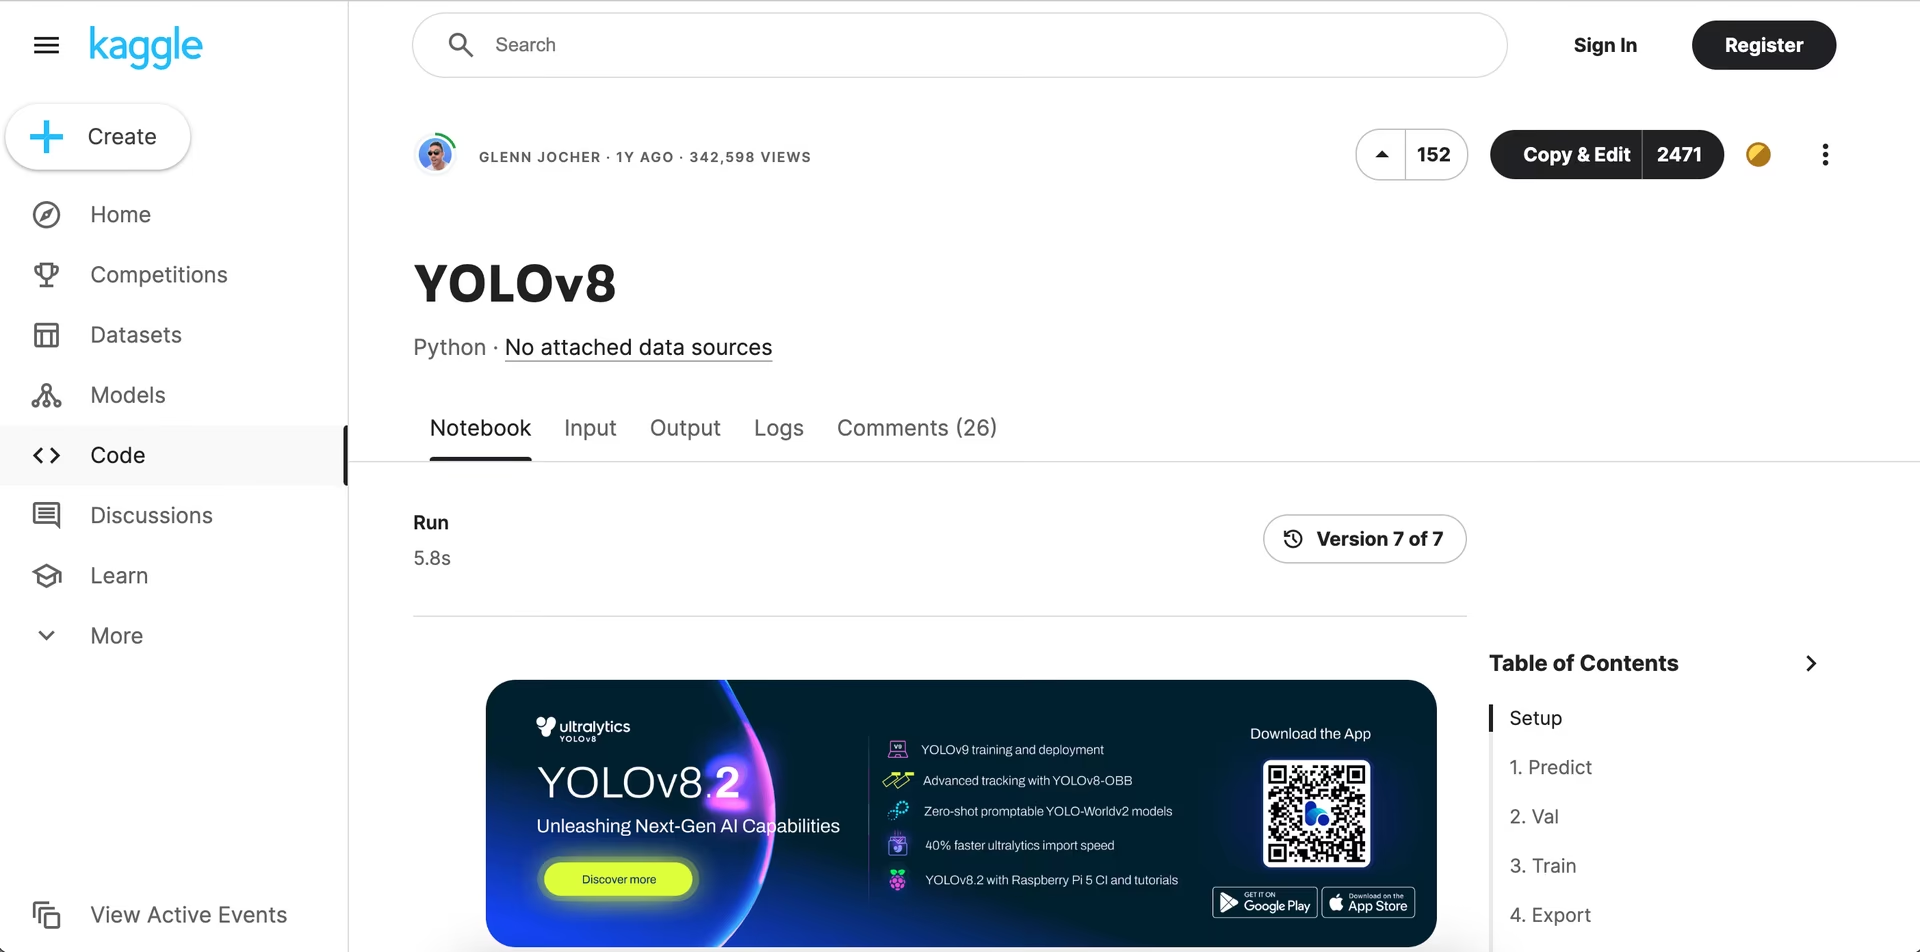
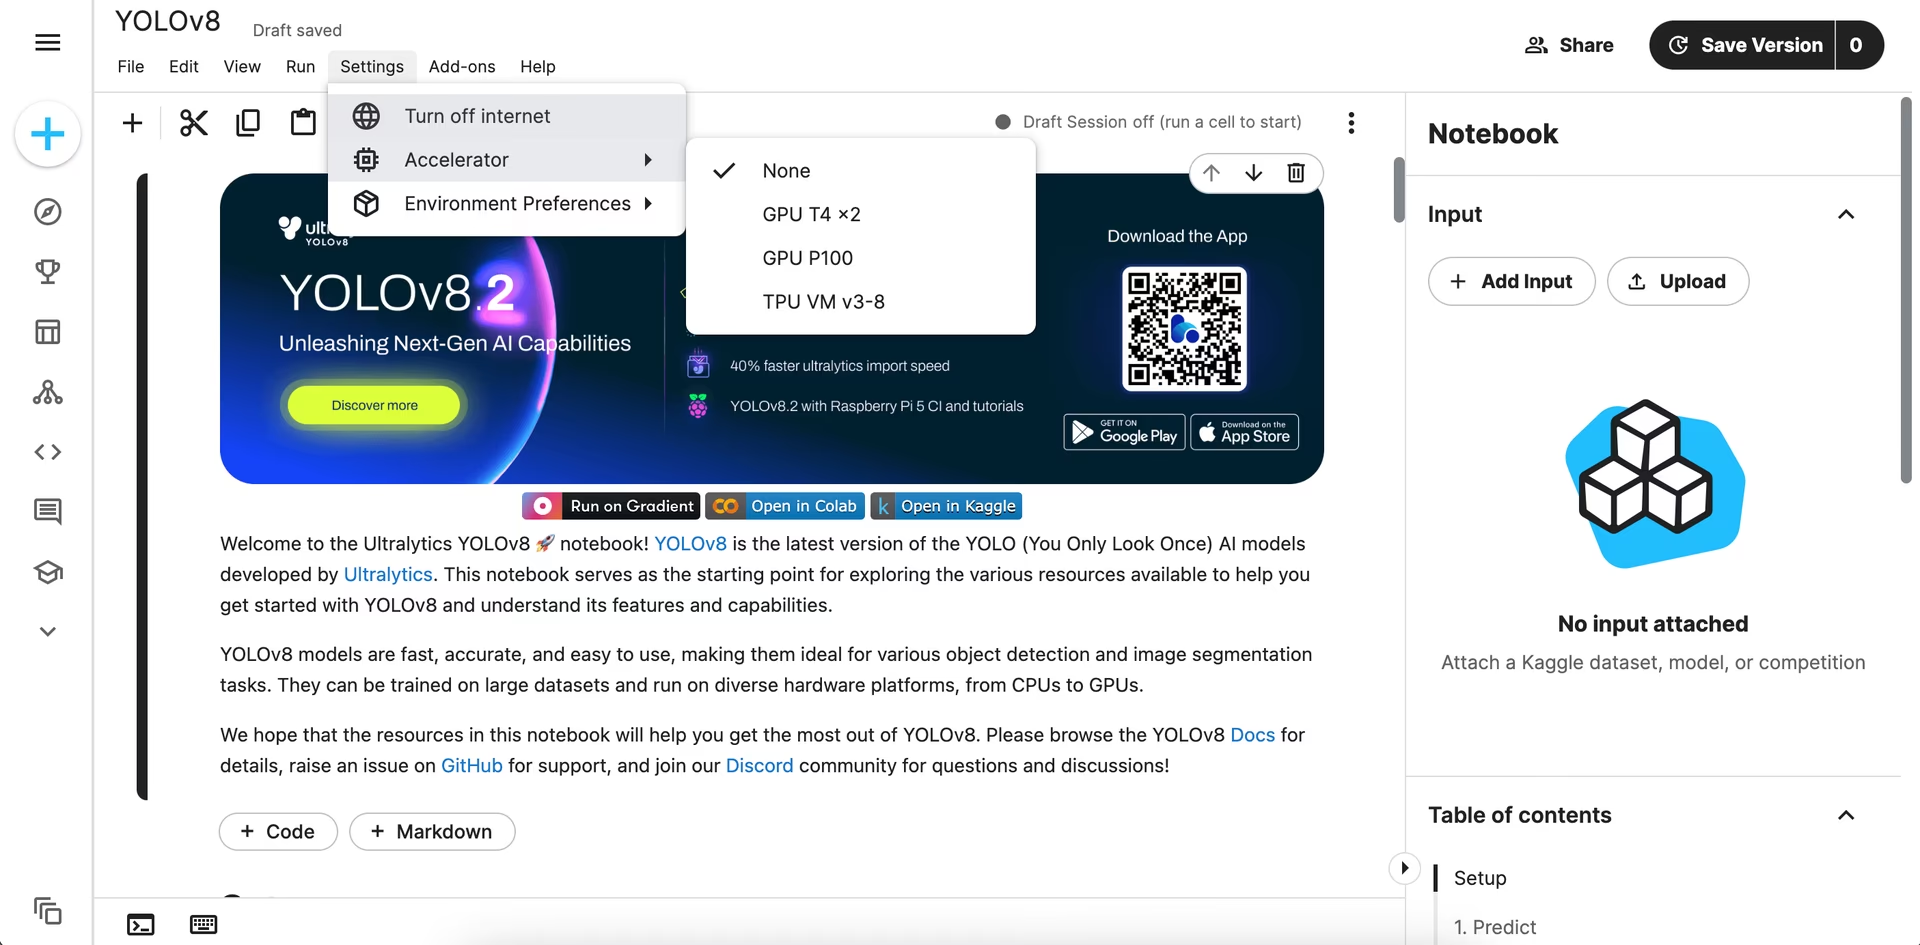
Depois de iniciar sessão na tua conta do Kaggle, o notebook abre como uma cópia tua editável: seleciona uma GPU nas configurações do acelerador e executa as células do notebook para começar a treinar o modelo. Para entender detalhadamente o processo de treinamento do modelo e as práticas recomendadas, consulta nosso guia de treinamento de modelos YOLO26.
Problemas comuns ao trabalhar com o Kaggle#
Ao trabalhar com o Kaggle, podes deparar-te com alguns problemas comuns. Eis alguns pontos importantes para te ajudar a utilizar a plataforma:
- Acesso a GPUs: Nos notebooks do Kaggle, você pode ativar uma GPU a qualquer momento, com uso permitido por até 30 horas por semana. O Kaggle oferece a GPU NVIDIA Tesla P100 com 16 GB de memória e também uma opção NVIDIA T4 x2. A aceleração por GPU torna o treinamento e a inferência dos modelos muito mais rápidos.
- Kernels do Kaggle: os kernels do Kaggle são servidores gratuitos de notebooks Jupyter que podem integrar GPUs, permitindo-te realizar operações de aprendizagem automática em computadores na nuvem. Não precisas de depender da CPU do teu próprio computador, evitando sobrecarregá-lo e libertando os recursos locais.
- Conjuntos de dados do Kaggle: os conjuntos de dados do Kaggle podem ser transferidos gratuitamente. No entanto, é importante verificar a licença de cada conjunto de dados para compreender quaisquer restrições de utilização. Alguns conjuntos de dados podem ter limitações quanto a publicações académicas ou utilização comercial. Podes transferir conjuntos de dados diretamente para o teu notebook do Kaggle ou para qualquer outro local através da API do Kaggle.
- Guardar e confirmar notebooks: para guardar e confirmar um notebook no Kaggle, clica em "Save Version". Isto guarda o estado atual do notebook. Quando o kernel em segundo plano terminar de gerar os ficheiros de saída, podes aceder-lhes no separador Output da página principal do notebook.
- Colaboração: o Kaggle permite a colaboração, mas vários utilizadores não podem editar um notebook em simultâneo. A colaboração no Kaggle é assíncrona, o que significa que os utilizadores podem partilhar e trabalhar no mesmo notebook em momentos diferentes.
- Reverter para uma versão anterior: se precisares de reverter o notebook para uma versão anterior, abre o notebook e clica nos três pontos verticais no canto superior direito para selecionar "View Versions". Encontra a versão para a qual queres reverter, clica no menu "..." ao lado e seleciona "Revert to Version". Depois de o notebook ser revertido, clica em "Save Version" para confirmar as alterações.
Principais funcionalidades do Kaggle#
Veja alguns dos principais recursos que o Kaggle oferece para ciência de dados e aprendizado de máquina:
- Conjuntos de dados: O Kaggle hospeda uma grande coleção de conjuntos de dados sobre diversos temas. Você pode pesquisar e usar esses conjuntos de dados nos seus projetos, o que é especialmente útil para treinar e testar seus modelos YOLO26.
- Competições: As competições do Kaggle permitem que cientistas de dados e profissionais de aprendizado de máquina resolvam problemas do mundo real. Competir ajuda você a aprimorar suas habilidades, aprender novas técnicas e conquistar reconhecimento na comunidade.
- Acesso gratuito a TPUs: O Kaggle oferece acesso gratuito a TPUs para frameworks compatíveis. O treinamento do Ultralytics YOLO26 é executado nas GPUs ou na CPU do Kaggle, não em TPUs.
- Integração com GitHub: O Kaggle permite conectar seu repositório do GitHub para enviar notebooks e salvar seu trabalho. Essa integração facilita o gerenciamento e o acesso aos seus arquivos.
- Comunidade e discussões: O Kaggle tem uma grande comunidade de cientistas de dados e profissionais de aprendizado de máquina. Os fóruns de discussão e os notebooks compartilhados são recursos úteis para aprender e solucionar problemas. Você pode pedir ajuda, compartilhar seus conhecimentos e colaborar com outras pessoas.
Por que deves utilizar o Kaggle nos teus projetos YOLO26?#
Há várias plataformas para treinar e avaliar modelos de aprendizado de máquina. Veja alguns benefícios de usar o Kaggle nos seus projetos de aprendizado de máquina:
- Notebooks públicos: podes tornar públicos os teus notebooks do Kaggle, permitindo que outros utilizadores vejam, votem, criem bifurcações e discutam o teu trabalho. O Kaggle promove a colaboração, o feedback e a partilha de ideias, ajudando-te a melhorar os teus modelos YOLO26.
- Histórico completo de confirmações do notebook: o Kaggle cria um histórico detalhado das confirmações do teu notebook. Isto permite-te rever e acompanhar as alterações ao longo do tempo, facilitando a compreensão da evolução do teu projeto e o regresso a versões anteriores, se necessário.
- Acesso ao console: O Kaggle oferece um console, dando a você mais controle sobre o ambiente. Esse recurso permite realizar várias tarefas diretamente pela linha de comando.
- Disponibilidade de recursos: cada sessão de edição de notebooks no Kaggle disponibiliza recursos significativos: 12 horas de execução para sessões com CPU e GPU, 9 horas de execução para sessões com TPU e 20 gigabytes de espaço em disco com gravação automática.
- Agendamento de notebooks: o Kaggle permite-te agendar a execução dos teus notebooks para horas específicas. Podes automatizar tarefas repetitivas sem intervenção manual, como treinar o teu modelo a intervalos regulares.
Continua a aprender sobre o Kaggle#
Se quiseres saber mais sobre o Kaggle, aqui tens alguns recursos úteis:
- Kaggle Learn: Descubra uma variedade de tutoriais interativos e gratuitos no Kaggle Learn. Esses cursos abordam tópicos essenciais de ciência de dados com exercícios práticos.
- Primeiros passos com o Kaggle: Este guia apresenta os conceitos básicos do Kaggle, desde participar de competições até criar seu primeiro notebook.
- Página do Kaggle no Medium: Explore tutoriais, atualizações e contribuições da comunidade na página do Kaggle no Medium.
- Treine modelos Ultralytics YOLO usando a integração com o Kaggle: Esta publicação do blog mostra como usar o Kaggle especificamente com modelos Ultralytics YOLO.
Resumo#
O Kaggle oferece aos seus projetos YOLO26 acesso gratuito a GPUs para treinamento e avaliação de modelos, além de bibliotecas pré-instaladas para uma configuração rápida. Juntos, Ultralytics YOLO26 e Kaggle permitem desenvolver, treinar e implantar modelos de visão computacional sem precisar de hardware caro.
Para mais informações, visita a documentação do Kaggle.
Perguntas frequentes#
Para instalar o Ultralytics YOLO26 no Kaggle:
- Ativar a Internet: acede ao painel Settings e ativa a opção Internet
- Instalar o pacote: executa
!pip install ultralyticsnuma célula do notebook - Verificar a instalação: executa
import ultralytics; ultralytics.checks()para confirmar
Se encontrares conflitos entre dependências, experimenta
!pip install --upgrade --force-reinstall ultralyticsou reinicia o kernel após a instalação. Para obteres ajuda detalhada na resolução de problemas, consulta a secção Instalação acima.Treinar um modelo YOLO26 no Kaggle é simples. Primeiro, abre o notebook do tutorial Ultralytics YOLO26 no Kaggle. Inicia sessão na tua conta do Kaggle e seleciona uma GPU nas configurações do acelerador. Executa as células do notebook para iniciar o treinamento. Para ver etapas mais detalhadas, consulta nosso guia de treinamento de modelos YOLO26.
O Kaggle oferece várias vantagens para treinar modelos YOLO26:
- Acesso gratuito a GPUs: Use GPUs como a NVIDIA Tesla P100 ou a T4 x2 por até 30 horas por semana.
- Bibliotecas pré-instaladas: bibliotecas como TensorFlow e PyTorch já estão instaladas, o que simplifica a configuração.
- Colaboração com a comunidade: Interaja com uma grande comunidade de cientistas de dados e entusiastas de aprendizado de máquina.
- Controle de versões: Gerencie diferentes versões dos seus notebooks e reverta para versões anteriores, se necessário.
Os problemas comuns incluem:
- Acesso a GPUs: certifica-te de que ativaste uma GPU nas definições do notebook. O Kaggle permite até 30 horas de utilização de GPU por semana.
- Internet não ativada: não te esqueças de ativar a Internet no painel Settings antes de instalar pacotes.
- Conflitos de dependências: usa
!pip install --upgrade --force-reinstall ultralytics. - Licenças dos conjuntos de dados: verifica a licença de cada conjunto de dados para compreender as restrições de utilização.
- Guardar e confirmar notebooks: clica em "Save Version" para guardar o estado do notebook e aceder aos ficheiros de saída no separador Output.
- Colaboração: o Kaggle permite a colaboração assíncrona; vários utilizadores não podem editar um notebook em simultâneo.
Para obteres mais sugestões para resolver problemas, consulta a secção Instalação e o nosso guia de problemas comuns.
O Kaggle oferece vários recursos que o diferenciam do Google Colab:
- Notebooks públicos: partilha o teu trabalho com a comunidade para receber feedback e colaborar.
- Histórico completo: acompanha as alterações ao longo do tempo com um histórico detalhado das confirmações do notebook.
- Disponibilidade de recursos: cada sessão de notebook disponibiliza recursos significativos, incluindo 12 horas de execução para sessões com CPU e GPU.
Para reverter para uma versão anterior:
- Abre o notebook e clica nos três pontos verticais no canto superior direito.
- Seleciona "View Versions".
- Encontra a versão para a qual queres reverter, clica no menu "..." ao lado e seleciona "Revert to Version".
- Clica em "Save Version" para confirmar as alterações.


Comentários3
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?