Plataforma Ultralytics
O Ultralytics Platform é uma plataforma de ponta a ponta de visão computacional que abrange todo o fluxo de trabalho de aprendizado de máquina, da preparação de dados à implantação de modelos. Foi desenvolvido para equipes e profissionais que querem treinar e implantar modelos de visão prontos para produção sem gerenciar a própria infraestrutura.
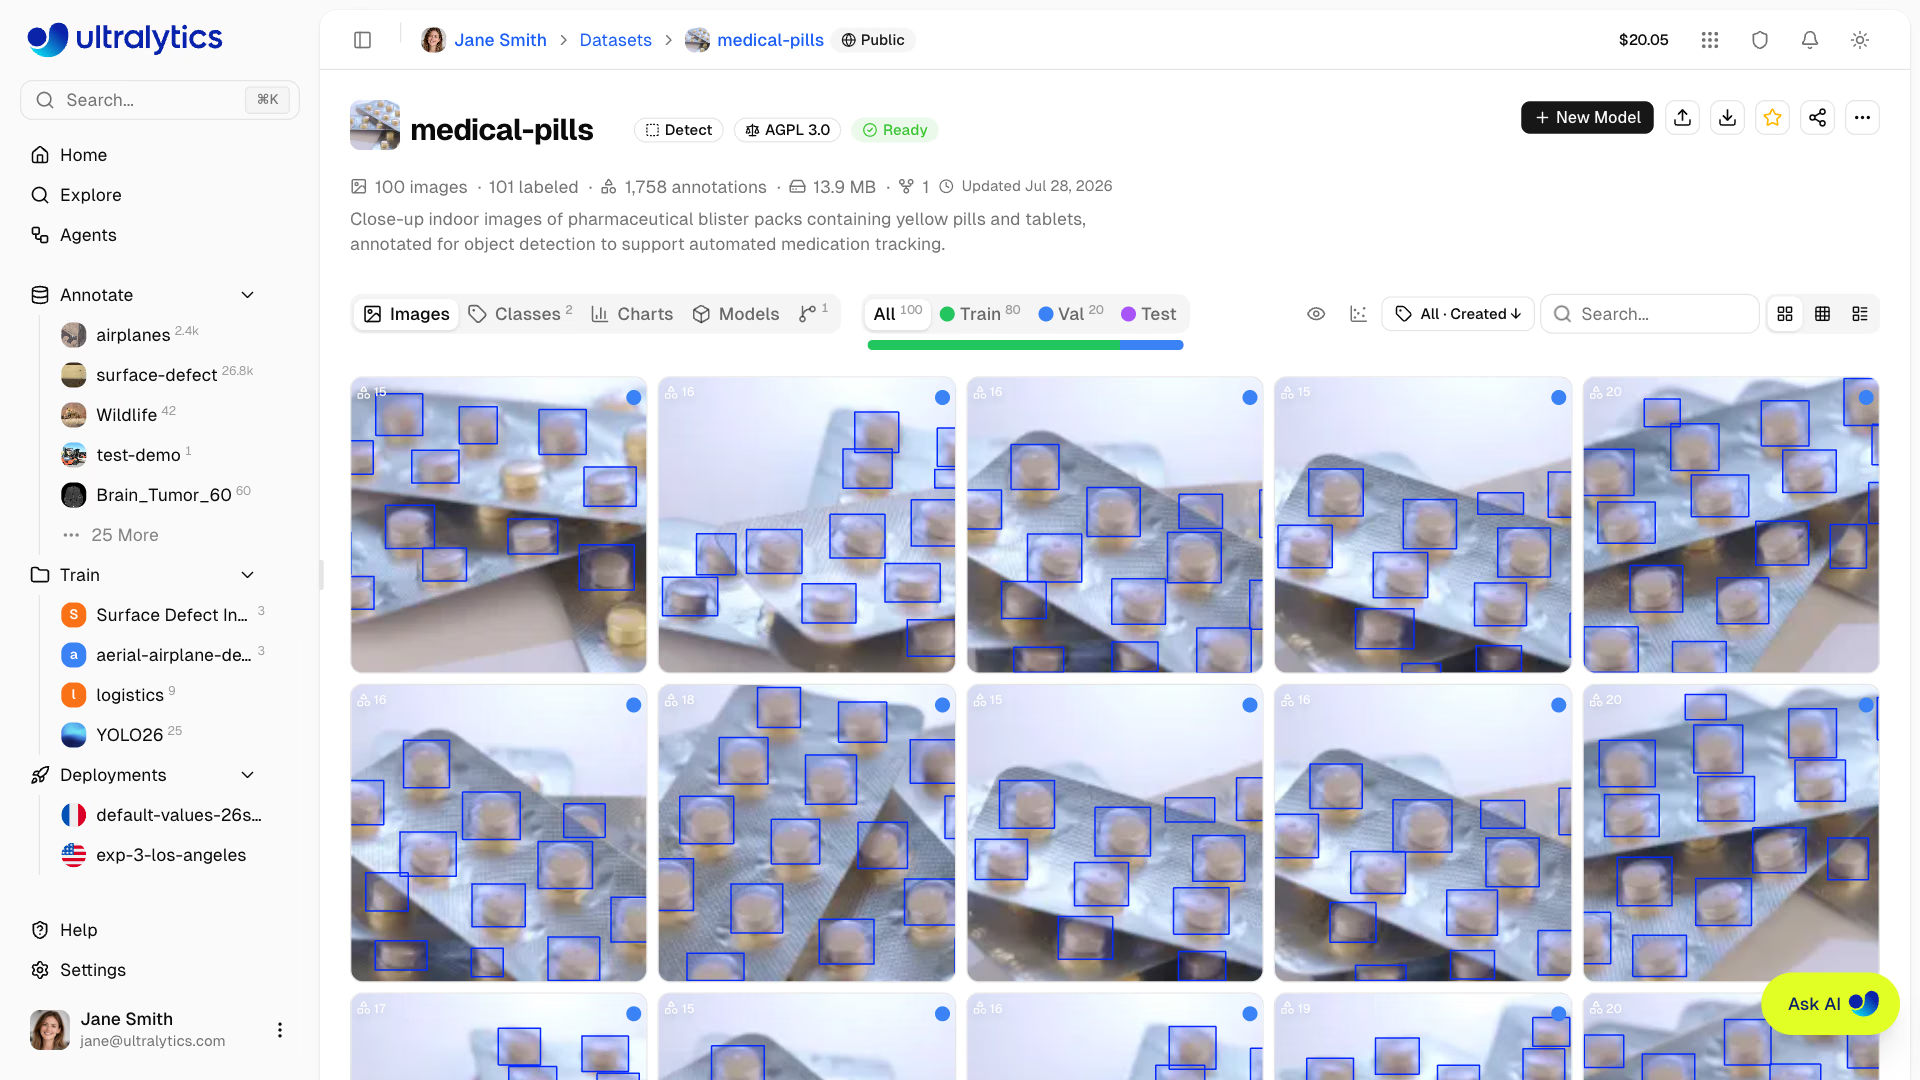
O que é a Plataforma Ultralytics?#
O Ultralytics Platform reúne gerenciamento e anotação de conjuntos de dados, acompanhamento de experimentos, treinamento na nuvem e remoto, exportação de modelos, endpoints de inferência dedicados e monitoramento de implantação em um único espaço de trabalho. Oferece suporte nativo aos modelos YOLO26, YOLO11, YOLOv8 e YOLOv5.
Fluxo de trabalho: Enviar → Anotar → Treinar → Exportar ou implantar#
A Plataforma oferece um fluxo de trabalho de ponta a ponta:
| Estágio | Recursos |
|---|---|
| Enviar | Imagens (50MB), vídeos (1GB) e arquivos de conjuntos de dados (ZIP, TAR, incluindo .tar.gz/.tgz, NDJSON) do seu computador, de uma URL, do armazenamento na nuvem ou de um host local |
| Anotar | Ferramentas de anotação manual para 6 tipos de tarefa, além da Anotação Inteligente com modelos SAM para detecção, segmentação, semântica e OBB; modelos YOLO para essas tarefas e pose; ou modelos com prompts de classe (modelos de código aberto hospedados ou modelos pagos de provedores) para conjuntos de dados de detecção com 1–200 classes (consulte tipos de tarefa compatíveis) |
| Treinar | GPUs na nuvem (24 em todos os planos + 2 exclusivos dos planos Pro/Enterprise: B200, B300), métricas em tempo real e organização de projetos |
| Exportar | 23 formatos de implantação (ONNX, TensorRT, CoreML, LiteRT, Hailo, Ascend etc.; consulte formatos compatíveis) |
| Implantar | 42 regiões globais com endpoints dedicados, escala para zero por padrão (uma única instância ativa) e monitoramento |
O que você pode fazer:
- Enviar imagens, vídeos e arquivos de conjuntos de dados para criar conjuntos de dados de treinamento
- Visualizar anotações com sobreposições interativas para os 6 tipos de tarefa YOLO compatíveis com o editor de anotações (consulte os tipos de tarefa compatíveis)
- Treinar modelos em GPUs na nuvem (24 em todos os planos, 26 com Pro ou Enterprise para B200 e B300) com métricas em tempo real
- Exporte para 23 formatos de implantação (ONNX, TensorRT, CoreML, LiteRT, Hailo, Ascend etc.)
- Implantar em 42 regiões globais com endpoints dedicados em um clique
- Criar fluxos de trabalho de Agents que conectam modelos, condições, coleta de conjuntos de dados, alertas do Slack e webhooks
- Monitorar o progresso do treinamento, a integridade da implantação e as métricas de uso
- Conectar armazenamento na nuvem, ferramentas de anotação e Slack por meio de integrações
- Colaborar tornando projetos e conjuntos de dados públicos para a comunidade
Infraestrutura multirregional#
Seus dados permanecem na sua região. A Plataforma Ultralytics opera infraestrutura em três regiões globais:
| Região | Rótulo | Localização | Ideal para |
|---|---|---|---|
| US | Américas | Iowa, EUA | Usuários das Américas; menor latência para as Américas |
| EU | Europa, Oriente Médio e África | Bélgica, Europa | Usuários europeus; conformidade com o GDPR |
| AP | Ásia-Pacífico | Taiwan, Ásia-Pacífico | Usuários da Ásia-Pacífico; menor latência na região APAC |
Você seleciona a região dos seus dados durante o cadastro. Os conjuntos de dados, os modelos e os dados de treinamento gerenciados permanecem nessa região. Os endpoints dedicados são implantados separadamente em uma região que você escolhe no mapa global de implantação.
Você não pode alterar a região dos seus dados por conta própria após criar a conta. Durante o cadastro, a Plataforma mede a latência para cada região e recomenda a mais próxima. Entre em contato com o suporte se precisar solicitar uma alteração de região mais tarde. Isso se aplica ao conteúdo de conjuntos de dados e modelos; os dados da conta, como perfil, cobrança e registros de atividade, são processados globalmente, conforme descrito na nossa Política de Privacidade e no nosso Acordo de Processamento de Dados.
Principais funcionalidades#
Preparação de dados#
- Gerenciamento de conjuntos de dados: Crie conjuntos de dados a partir de arquivos locais, de uma URL, de um armazenamento na nuvem conectado ou de um host local, com processamento automático
- Editor de anotações: Ferramentas de anotação manual para 6 tipos de tarefa YOLO (detecção, segmentação, semântica, classificação, pose, OBB; consulte os tipos de tarefa compatíveis)
- Modelos de esqueleto: Modelos de esqueleto integrados (Pessoa, Mão, Cão, Rosto, Caixa) e personalizados para anotar poses com um clique
- Anotação inteligente: usa SAM 2.1 (Tiny, Small, Base, Large), SAM 3 ou SAM 3.1 (predefinido) na barra de ferramentas de anotação para tarefas de detecção, segmentação, semântica e OBB; modelos Ultralytics YOLO pré-treinados e os teus próprios modelos YOLO ajustados para essas tarefas e pose; ou modelos com indicação de classe em conjuntos de dados de detecção com 1–200 classes: nove modelos de código aberto hospedados (Moondream 3.1 por predefinição em Anotação em lote, e mais um com Acesso antecipado ativado), SAM 3 e SAM 3.1 hospedados e orientados por texto, ou modelos de visão pagos da OpenAI, Anthropic, Google, Meta, SpaceXAI, DeepSeek, Z.ai, Kimi, Xiaomi MiMo, Alibaba, MiniMax e Tencent, usando uma chave do fornecedor em Settings > API Keys
- Controle de versões de conjuntos de dados: Crie snapshots numerados em NDJSON com descrições e, em seguida, baixe ou restaure qualquer versão para garantir um treinamento reproduzível
- Estatísticas: Distribuição de classes, distribuição de divisões, mapas de calor de localização e análise das dimensões das caixas delimitadoras
O editor de anotações oferece ferramentas para 6 tipos de tarefa YOLO: detectar (caixas delimitadoras), segmentar (polígonos), semântica (regiões por classe), classificar (rótulos no nível da imagem), pose (pontos-chave) e OBB (caixas orientadas). Cada tipo de tarefa tem controles de anotação e atalhos de teclado próprios.
Treinamento de modelos#
- Treinamento na nuvem: Treine em GPUs na nuvem (24 em todos os planos, 26 com Pro ou Enterprise para B200 e B300) com métricas em tempo real e uma estimativa de custo atualizada
- Treinamento remoto: Treine em qualquer lugar e transmita métricas para a Plataforma Ultralytics
- Configurações avançadas: Substitua qualquer argumento de treinamento da Ultralytics usando um editor YAML integrado na janela de treinamento
- Organização de projetos: Agrupe modelos relacionados, compare experimentos e acompanhe atividades
- 23 formatos de exportação: ONNX, TensorRT, CoreML, LiteRT, Hailo, Ascend e outros (consulte formatos compatíveis)
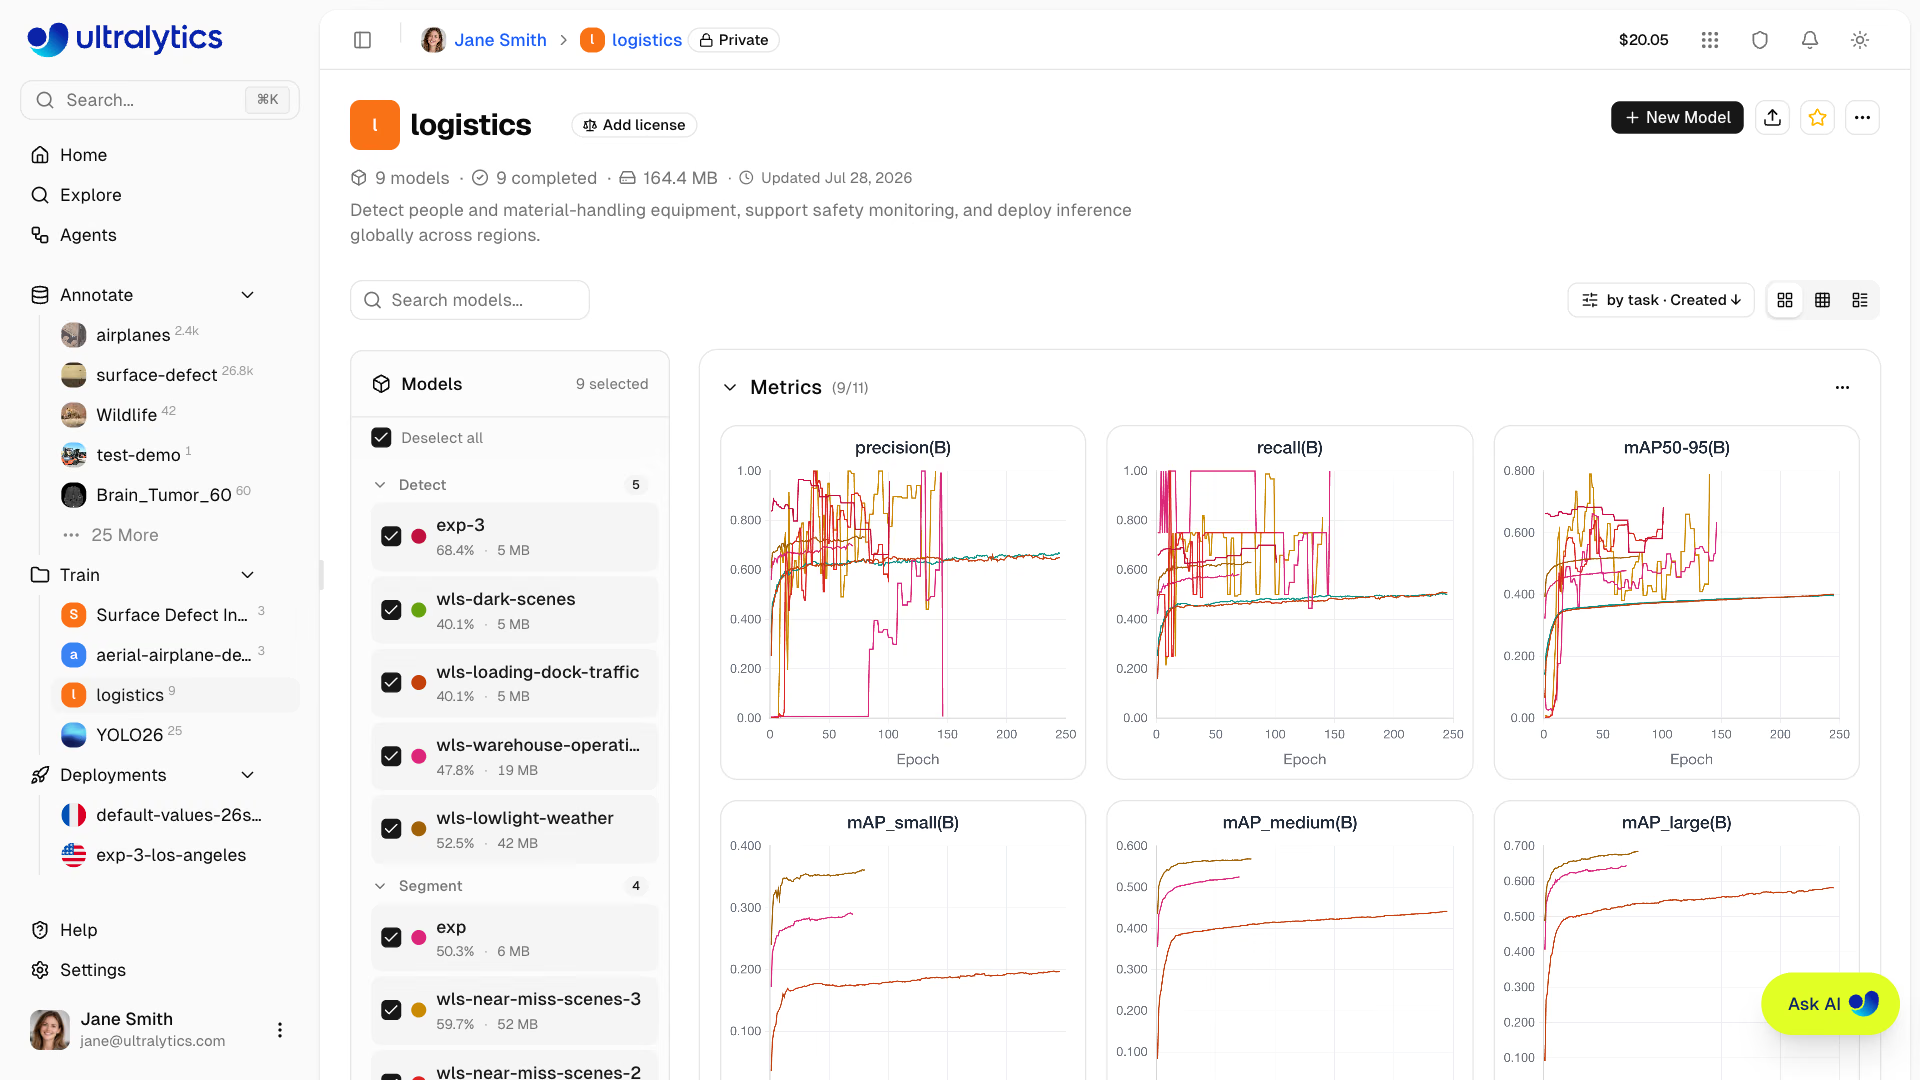
Você pode treinar modelos pela interface web (treinamento na nuvem) ou no seu próprio computador (treinamento remoto):
- Acesse seu projeto
- Clique em
New Model - Selecione o conjunto de dados, o modelo, a GPU e o número de épocas
- Monitore as curvas de perda e as métricas em tempo real
Implantação#
- Teste de inferência: Teste modelos diretamente no navegador com suas próprias imagens, uma captura da webcam ou os exemplos integrados
- Endpoints dedicados: Implante em 42 regiões globais com escala para zero por padrão (uma única instância ativa)
- Monitoramento: métricas em tempo real, registros de solicitações e painéis de desempenho
Após a implantação, chame seu endpoint de qualquer linguagem. conf, iou e imgsz são campos de formulário opcionais que, por padrão, usam 0.25, 0.5 e o tamanho de imagem usado no treinamento do modelo (640, se indisponível):
import requests

url = "https://your-deployment-url.run.app/predict"
api_key = "YOUR_API_KEY"
args = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(
        url,
        headers={"Authorization": f"Bearer {api_key}"},
        data=args,
        files={"file": f},
    )

print(response.json())
Gerenciamento da conta#
- Equipes e organizações: colabore com membros da equipe, gerencie funções e convites e alterne entre espaços de trabalho pelo menu da conta
- Chaves de API: gerenciamento seguro de chaves para treinamento remoto e acesso à API
- Créditos e cobrança: treinamento com pagamento conforme o uso, preços transparentes e recargas de US$ 5 a US$ 1.000
- Feed de atividades: acompanhe todos os eventos e ações da conta
- Lixeira e restauração: exclusão reversível por 30 dias com recuperação de itens
- Conformidade com o GDPR: exportação de dados e exclusão da conta
Consulte a comparação oficial dos planos Free, Pro e Enterprise para ver os limites atuais, o acesso a GPUs, os recursos de colaboração e o licenciamento.
Links rápidos#
Comece a usar estes recursos:
- Início rápido: crie seu primeiro projeto e treine um modelo em minutos
- Explorar: navega e clona conjuntos de dados e projetos públicos e pesquisa imagens pelo que mostram
- Dados: visão geral da preparação de conjuntos de dados
- Conjuntos de dados: envie e gerencie seus dados de treinamento
- Anotação: rotule seus dados com ferramentas manuais e assistidas por IA
- Treinar: visão geral do treinamento
- Projetos: organize seus modelos e experimentos
- Modelos: páginas de modelos, downloads e exportações
- Treinamento na nuvem: treine em GPUs na nuvem
- Implantar: visão geral da implantação
- Inferência: teste seus modelos
- Endpoints: implante modelos em produção
- Monitoramento: acompanhe o desempenho das implantações
- Conta: visão geral da conta
- Configurações: preferências de perfil e espaço de trabalho
- Equipes: membros, funções e convites
- Chaves de API: gerencie o acesso à API
- Cobrança: créditos e pagamentos
- Atividade: acompanhe os eventos da conta
- Lixeira: recupere itens excluídos
- Integrações: armazenamento na nuvem, ferramentas de anotação e Slack
- REST API: referência da API
Solução de problemas#
Problemas com conjuntos de dados#
| Problema | Solução |
|---|---|
| O conjunto de dados não é processado | Verifique se o formato do arquivo é compatível (JPEG, PNG, WebP, TIFF, HEIC, AVIF, BMP, JP2, DNG, MPO para imagens). Tamanho máximo de arquivo: imagens 50 MB, vídeos 1 GB, arquivos de conjunto de dados 10 GB (Free) / 20 GB (Pro) / 50 GB (Enterprise) |
| Anotações ausentes | Verifique se os rótulos estão no formato YOLO, com arquivos .txt que correspondam aos nomes dos arquivos de imagem, ou envie um arquivo JSON do COCO |
| "É necessário um conjunto de treinamento" | Adicione a pasta train/ à estrutura do conjunto de dados ou redistribua as divisões pela barra de divisão |
| Nomes de classes indefinidos | Adicione um arquivo data.yaml com uma lista names: (consulte formato YOLO) ou defina as classes na aba Classes |
Problemas de treinamento#
| Problema | Solução |
|---|---|
| O treinamento não começa | Verifique o saldo de créditos em Configurações > Cobrança. É necessário ter saldo positivo |
| Erro de falta de memória | Reduza o tamanho do lote, use um modelo menor (n/s) ou selecione uma GPU com mais VRAM |
| Métricas insatisfatórias | Verifique a qualidade do conjunto de dados, aumente o número de épocas, experimente o aumento de dados e confira o equilíbrio entre as classes |
| Treinamento lento | Selecione uma GPU mais rápida, reduza o tamanho da imagem e verifique se o conjunto de dados não é o gargalo |
Problemas de implantação#
| Problema | Solução |
|---|---|
| O endpoint não responde | Verifique o status do endpoint (Ready ou Stopped). Uma inicialização a frio após um período de inatividade pode levar até um minuto na primeira solicitação |
| 401 Não autorizado | Verifique se a chave de API está ativa e foi copiada corretamente |
| Inferência lenta | Verifique o tamanho do modelo, considere a exportação para TensorRT e selecione uma região mais próxima |
| Falha na exportação | Alguns formatos exigem arquiteturas de modelo específicas. Experimente ONNX para obter a maior compatibilidade |
Perguntas frequentes#
Posso alterar meu nome de usuário depois de me cadastrar?
Não, os nomes de usuário são permanentes e não podem ser alterados. Escolha com cuidado durante o cadastro.
Posso alterar minha região de dados?
Sua região de dados é selecionada durante a integração e você não pode alterá-la por conta própria. Para mudar de região, entre em contato com o suporte e solicite a alteração.
Como posso obter mais créditos?
Acesse Configurações > Cobrança e clique em Adicionar créditos. Compre créditos de US$ 5 a US$ 1.000. Os créditos comprados nunca expiram.
O que acontece se o treinamento falhar?
Se a computação na nuvem tiver sido iniciada, o tempo de GPU decorrido será cobrado. Falhas ocorridas antes da inicialização de uma GPU não geram cobrança pelo uso de computação.
Posso baixar meu modelo treinado?
Sim. Clique no ícone de download na página do modelo para baixar os pesos .pt ou abra a aba Exportar para acessar os formatos exportados concluídos.
Como compartilho meu trabalho publicamente?
Abra o projeto ou conjunto de dados, clique no selo Privado na barra de navegação superior e confirme em Tornar público. O conteúdo público aparece na página Explorar.
Quais são os limites de tamanho dos arquivos?
Imagens: 50 MB; vídeos: 1 GB; conjuntos de dados: 10 GB no Free, 20 GB no Pro e 50 GB no Enterprise. Para arquivos maiores, divida-os em vários envios.
Por quanto tempo os itens excluídos ficam na Lixeira?
30 dias. Depois disso, os itens são excluídos permanentemente e não podem ser recuperados.
Posso usar comercialmente os modelos da Platform?
Os planos Free e Pro usam a licença AGPL. Para uso comercial sem as exigências da AGPL, consulte Licenciamento da Ultralytics.
Perguntas frequentes#
Para começar a usar a Ultralytics Platform:
- Cadastre-se: crie uma conta em platform.ultralytics.com
- Selecione uma região: escolha sua região de dados (US, EU ou AP) durante a integração
- Envie um conjunto de dados: abra
Annotatena barra lateral e envie seus dados - Treine um modelo: crie um projeto e comece a treinar em GPUs na nuvem
- Implante: teste seu modelo e implante-o em um endpoint dedicado
Para ver um guia detalhado, consulte a página Início rápido.
A Ultralytics Platform oferece:
- Fluxo de trabalho unificado: dados, treinamento e implantação em um só lugar
- Várias regiões: residência de dados em regiões dos EUA, da UE ou da AP
- Treinamento sem código: treine modelos YOLO avançados sem escrever código
- Métricas em tempo real: acompanhe o progresso do treinamento em tempo real e monitore as implantações
- 42 regiões de implantação: implante modelos perto de seus usuários em todo o mundo
- 7 tipos de tarefa: suporte para detecção, segmentação de instâncias, segmentação semântica, estimativa de profundidade, classificação, pose e OBB (consulte a documentação das tarefas)
- Anotação assistida por IA: anotação inteligente com SAM, YOLO e modelos orientados por classes (conjuntos de dados de detecção com 1–200 classes) para acelerar a preparação dos dados
A Ultralytics Platform oferece suporte a vários tipos de GPU para treinamento na nuvem:
GPU Geração VRAM Ideal para RTX 2000 Ada Ada 16 GB Conjuntos de dados pequenos, testes RTX A4500 Ampere 20 GB Conjuntos de dados pequenos e médios RTX A5000 Ampere 24 GB Conjuntos de dados médios RTX 4000 Ada Ada 20 GB Conjuntos de dados médios RTX 3090 Ampere 24 GB Treinamento geral RTX PRO 4000 Blackwell 24 GB Blackwell econômica L4 Ada 24 GB Otimizada para inferência A40 Ampere 48 GB Tamanhos de lote maiores RTX A6000 Ampere 48 GB Modelos grandes RTX PRO 4500 Blackwell 32 GB Ótima relação preço/desempenho L40 Ada 48 GB Modelos grandes RTX 4090 Ada 24 GB Treinamento geral RTX PRO 5000 Blackwell 48 GB Treinamento com lotes grandes RTX 6000 Ada Ada 48 GB Treinamento com lotes grandes L40S Ada 48 GB Treinamento com lotes grandes RTX 5090 Blackwell 32 GB Geração mais recente para consumidores A100 PCIe Ampere 80 GB Treinamento em produção A100 SXM Ampere 80 GB Treinamento em produção RTX PRO 6000 Blackwell 96 GB Padrão recomendado H100 PCIe Hopper 80 GB Treinamento de alto desempenho H100 NVL Hopper 94 GB Desempenho máximo H200 NVL Hopper 143 GB Memória máxima H100 SXM Hopper 80 GB Treinamento mais rápido H200 SXM Hopper 141 GB Desempenho máximo B200 Blackwell 180 GB Modelos grandes (Pro+) B300 Blackwell 288 GB Os maiores modelos (Pro+) Os preços atuais por hora são exibidos no seletor de GPU da janela de treinamento e na página de preços.
Consulta Treinamento na nuvem para ver todas as opções de GPU.
Você pode treinar modelos no seu próprio hardware e transmitir métricas em tempo real para a Ultralytics Platform.
Requisito de versão do pacoteA integração com a Platform requer Python>=3.11 e ultralytics>=8.4.120. Versões anteriores NÃO funcionarão com a Platform.
pip install "ultralytics>=8.4.120"# Set your API key export ULTRALYTICS_API_KEY="YOUR_API_KEY" # Train with project/name to stream metrics yolo train model=yolo26n.pt data=coco.yaml epochs=100 project=username/my-project name=exp1Confira Treinamento na nuvem para saber mais sobre o treinamento remoto.
A Platform inclui um editor de anotação completo que oferece suporte a:
- Ferramentas manuais: caixas delimitadoras, polígonos, pontos-chave com modelos de esqueleto, caixas orientadas, classificação
- Modelos de esqueleto: posicione todos os pontos-chave de uma só vez usando modelos integrados (Person, Hand, Dog, Face, Box) ou modelos personalizados
- Anotação inteligente: usa SAM 2.1, SAM 3 ou SAM 3.1 (predefinido) para anotação por cliques em conjuntos de dados de detecção, segmentação, semântica e OBB; executa modelos Ultralytics YOLO pré-treinados e os teus próprios modelos YOLO ajustados na barra de ferramentas para essas tarefas e pose; ou executa modelos com indicação de classe em conjuntos de dados de detecção com 1–200 classes: nove modelos de código aberto hospedados (Moondream 3.1 por predefinição em Anotação em lote, e mais um com Acesso antecipado ativado), SAM 3 e SAM 3.1 hospedados e orientados por texto, ou modelos de visão pagos da OpenAI, Anthropic, Google, Meta, SpaceXAI, DeepSeek, Z.ai, Kimi, Xiaomi MiMo, Alibaba, MiniMax e Tencent, usando uma chave do fornecedor em Settings > API Keys
- Atalhos de teclado: fluxos de trabalho eficientes com teclas de atalho, listadas no popover de atalhos do editor
Atalho Ação VModo manual (desenhar) SModo inteligente (SAM, YOLO ou modelo com prompt de classe) PFazer previsão (no modo inteligente) AAtivar/desativar aplicação automática (modo inteligente do SAM) 1-9Selecionar classe pelo número HMostrar/ocultar anotações Space+ arrastar ou arrastar com o botão do meioDeslocar a tela Delete/BackspaceExcluir anotação selecionada Ctrl+SSalvar anotações Ctrl+ZDesfazer Ctrl+YRefazer EscapeSalvar / desmarcar / sair Confira Anotação para ver o guia completo.
A Platform oferece suporte aos mesmos 23 formatos de implantação que o modo Export do Ultralytics. PyTorch é o formato de origem; cada linha com um argumento
formatrepresenta um destino de exportação.Formato Argumento formatModelo Metadados Argumentos PyTorch - yolo26n.pt✅ - TorchScript torchscriptyolo26n.torchscript✅ imgsz,quantize,dynamic,nms,batch,deviceONNX onnxyolo26n.onnx✅ imgsz,quantize,dynamic,simplify,opset,nms,batch,data,fraction,deviceOpenVINO openvinoyolo26n_openvino_model/✅ imgsz,quantize,dynamic,nms,batch,data,fraction,deviceTensorRT engineyolo26n.engine✅ imgsz,quantize,dynamic,simplify,opset,workspace,nms,batch,data,fraction,deviceCoreML coremlyolo26n.mlpackage✅ imgsz,dynamic,quantize,nms,batch,deviceApple Core AI coreaiyolo26n.aimodel✅ imgsz,batch,quantizeTF SavedModel saved_modelyolo26n_saved_model/✅ imgsz,quantize,opset,nms,batch,data,fraction,deviceTF GraphDef pbyolo26n.pb❌ imgsz,opset,batch,deviceTF Edge TPU edgetpuyolo26n_edgetpu.tflite✅ imgsz,quantize,opset,data,fraction,deviceLiteRT litertyolo26n.tflite✅ imgsz,quantize,batch,data,fraction,devicePaddlePaddle paddleyolo26n_paddle_model/✅ imgsz,batch,deviceMNN mnnyolo26n.mnn✅ imgsz,batch,dynamic,quantize,simplify,opset,nms,deviceNCNN ncnnyolo26n_ncnn_model/✅ imgsz,quantize,deviceIMX500 imxyolo11n_imx_model/✅ imgsz,quantize,data,fraction,nms,deviceRKNN rknnyolo26n_rknn_model/✅ imgsz,batch,name,quantize,simplify,opset,data,fraction,deviceExecuTorch executorchyolo26n_executorch_model/✅ imgsz,batch,deviceAxelera axelerayolo26n_axelera_model/✅ imgsz,batch,quantize,data,fraction,deviceDEEPX deepxyolo26n_deepx_model/✅ imgsz,quantize,simplify,opset,data,optimize,deviceQualcomm QNN qnnyolo26n_qnn.onnx✅ imgsz,batch,name,quantize,simplify,opset,data,fraction,deviceHailo hailoyolo26n_hailo_model/✅ imgsz,name,quantize,data,fraction,simplify,conf,iou,deviceHuawei Ascend ascendyolo26n_ascend_model/✅ imgsz,batch,name,quantize,opset,simplify,nms,deviceAMD Xilinx xilinxyolo26n_xilinx_model/✅ imgsz,name,quantize,data,fraction,opset,simplify,deviceNXP nxpyolo26n_nxp.tflite✅ imgsz,quantize,data,fraction,devicenms=Noneusa por padrão saídas brutas para NMS externo (YOLO26 mantém sua cabeça sem NMS na Axelera). Definenms=Falsepara selecionar uma cabeça sem NMS disponível; os formatos não compatíveis recorrem ao caminho de saída nativo. As entradasnmsacima identificam os formatos que podem incorporar NMS comnms=True.Consulte Exportação de modelos, o guia do modo Export e o índice de integrações para ver opções específicas de cada formato.


Comentários4
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
WDWeihua Duan 我觉得在上传数据集方面还可以再改进改进,具体说明上传的文件夹的格式,而且现在只能上传训练集images和labels,之前我们用的数据集还有验证集哪些val,需要手工改,比较麻烦,能不能自动识别
WDWeihua Duan 表达有一点错误“哪些”=“那些”
 Glenn JocherUltralytics
感谢反馈,也收到“那些”的笔误说明;关于上传,平台已支持按标准 YOLO 目录自动识别
train/val/test,无显式 split 的平铺图片上传时也可按当前目标 split 导入并在缺少划分时自动生成一部分val,可参考 Datasets 文档,如果你愿意也欢迎把你的目录树直接贴在这里,Ultralytics 团队会据此补充更清晰的中文示例。
Sebastian Borja Hello Ultralytics Support Team,
I’m currently experiencing an issue on the Ultralytics Platform while trying to train a model. My dataset is approximately 21 GB, and when I attempt to download the dataset or start training, the platform returns a “500 Internal Server Error.”
Could you please help me investigate and resolve this issue?
Details:
Dataset size: ~21 GB
Action: Download dataset / Start training
Error: 500 Internal Server Error
If helpful, I can provide the project/workspace link, timestamp of the failure, browser/OS details, and any logs or screenshots you need to diagnose it.
Thank you in advance for your support.