SAM 3: segmenta tudo com conceitos
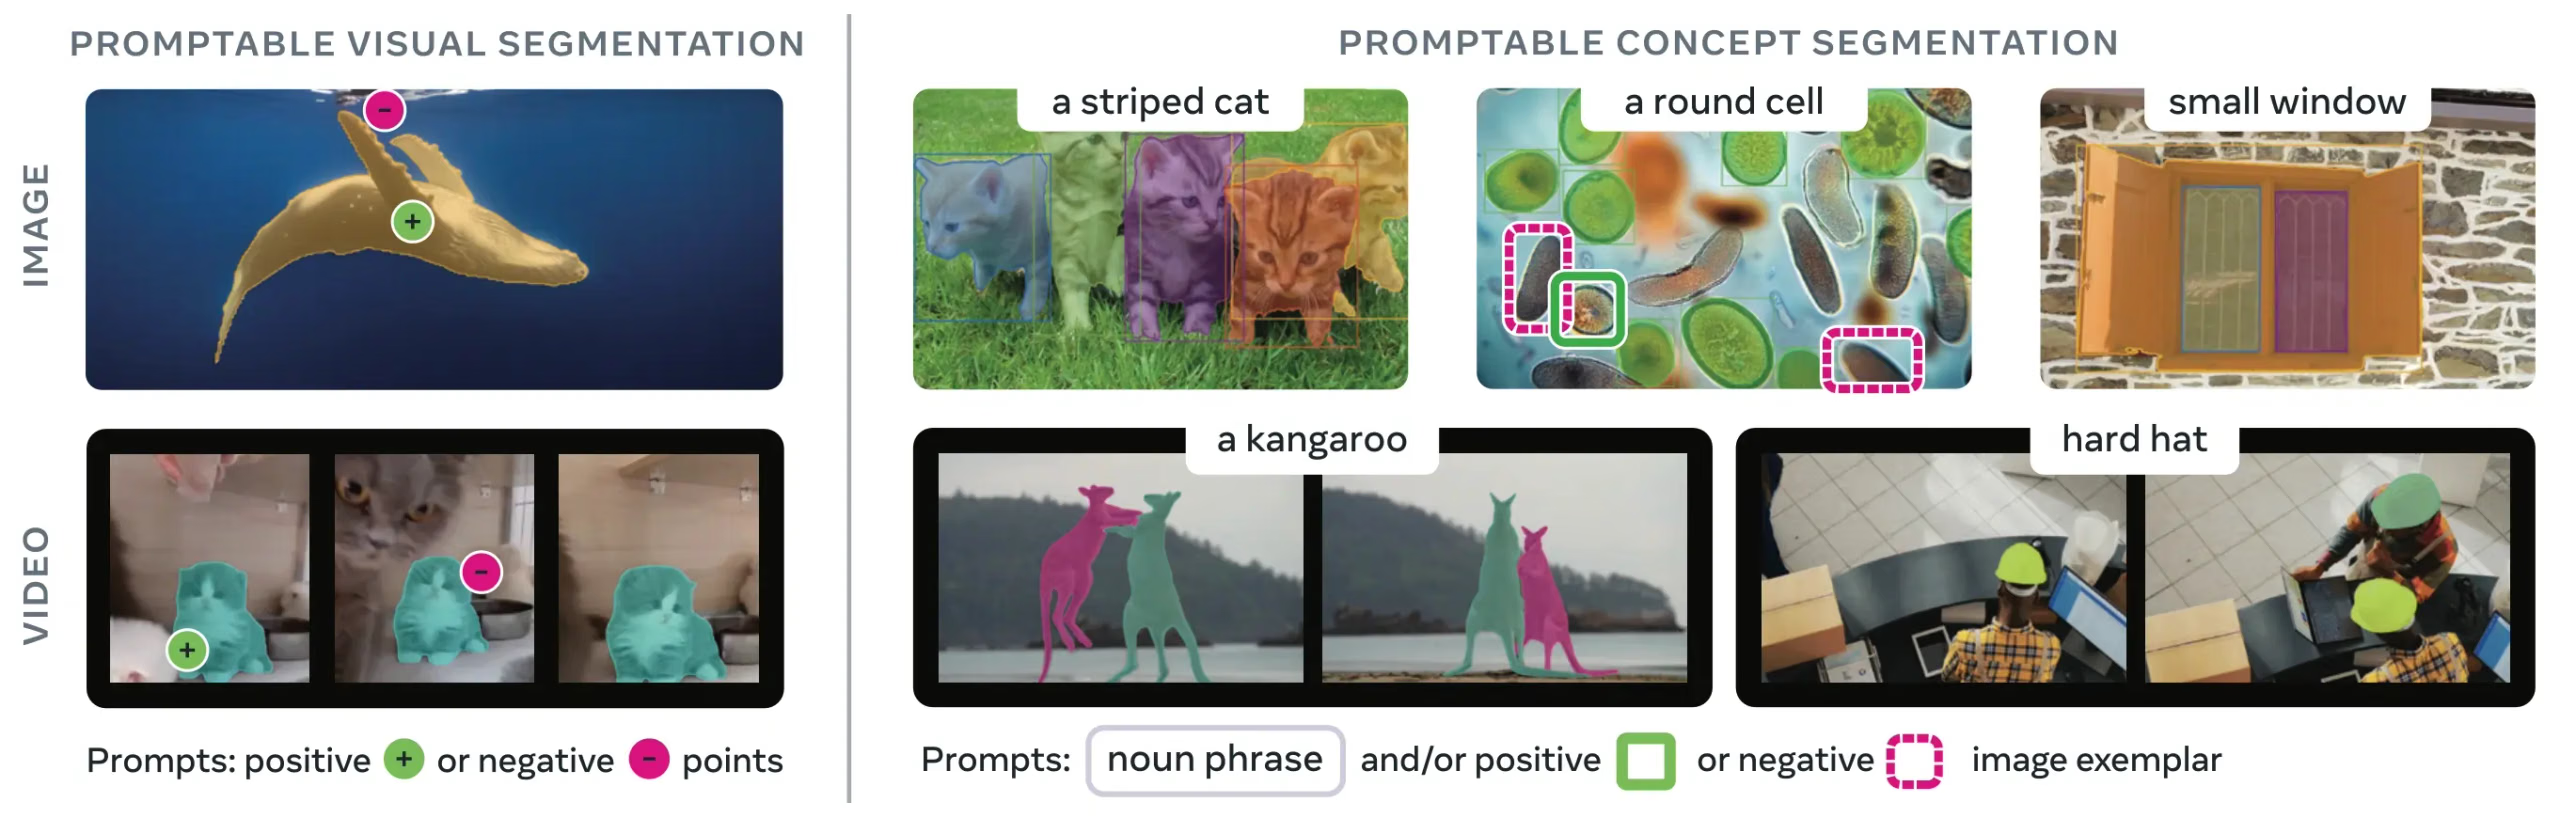
O SAM 3 (Modelo Segment Anything 3) é o modelo de base da Meta para a segmentação de conceitos orientada por prompts (PCS). Com base no SAM 2, o SAM 3 introduz uma nova capacidade: detetar, segmentar e acompanhar todas as instâncias de um conceito visual especificado por prompts de texto, exemplos de imagens ou ambos. Ao contrário das versões anteriores do SAM, que segmentam um único objeto por prompt, o SAM 3 consegue encontrar e segmentar todas as ocorrências de um conceito em qualquer parte de imagens ou vídeos, em linha com os objetivos de vocabulário aberto da segmentação de instâncias moderna.
Assista: Como usar o Meta Segment Anything 3 com Ultralytics | Segmentação por prompt de texto em imagens e vídeos
O SAM 3 está totalmente integrado no pacote ultralytics, que oferece suporte nativo à segmentação de conceitos com prompts de texto, prompts de exemplos de imagem e acompanhamento de vídeo. O checkpoint mais recente SAM 3.1 é suportado para a previsão de imagens.
Visão geral#
O SAM 3 alcança um ganho de desempenho de 2× em relação aos sistemas existentes na segmentação de conceitos orientada por prompts, mantendo e melhorando as capacidades do SAM 2 para a segmentação visual interativa. O modelo destaca-se na segmentação de vocabulário aberto, permitindo aos utilizadores especificar conceitos através de expressões nominais simples (por exemplo, «autocarro escolar amarelo», «gato às riscas») ou fornecer imagens de exemplo do objeto pretendido. Na Ultralytics, o SAM 3 funciona no modo predict, com preditores de vídeo dedicados para o seguimento.
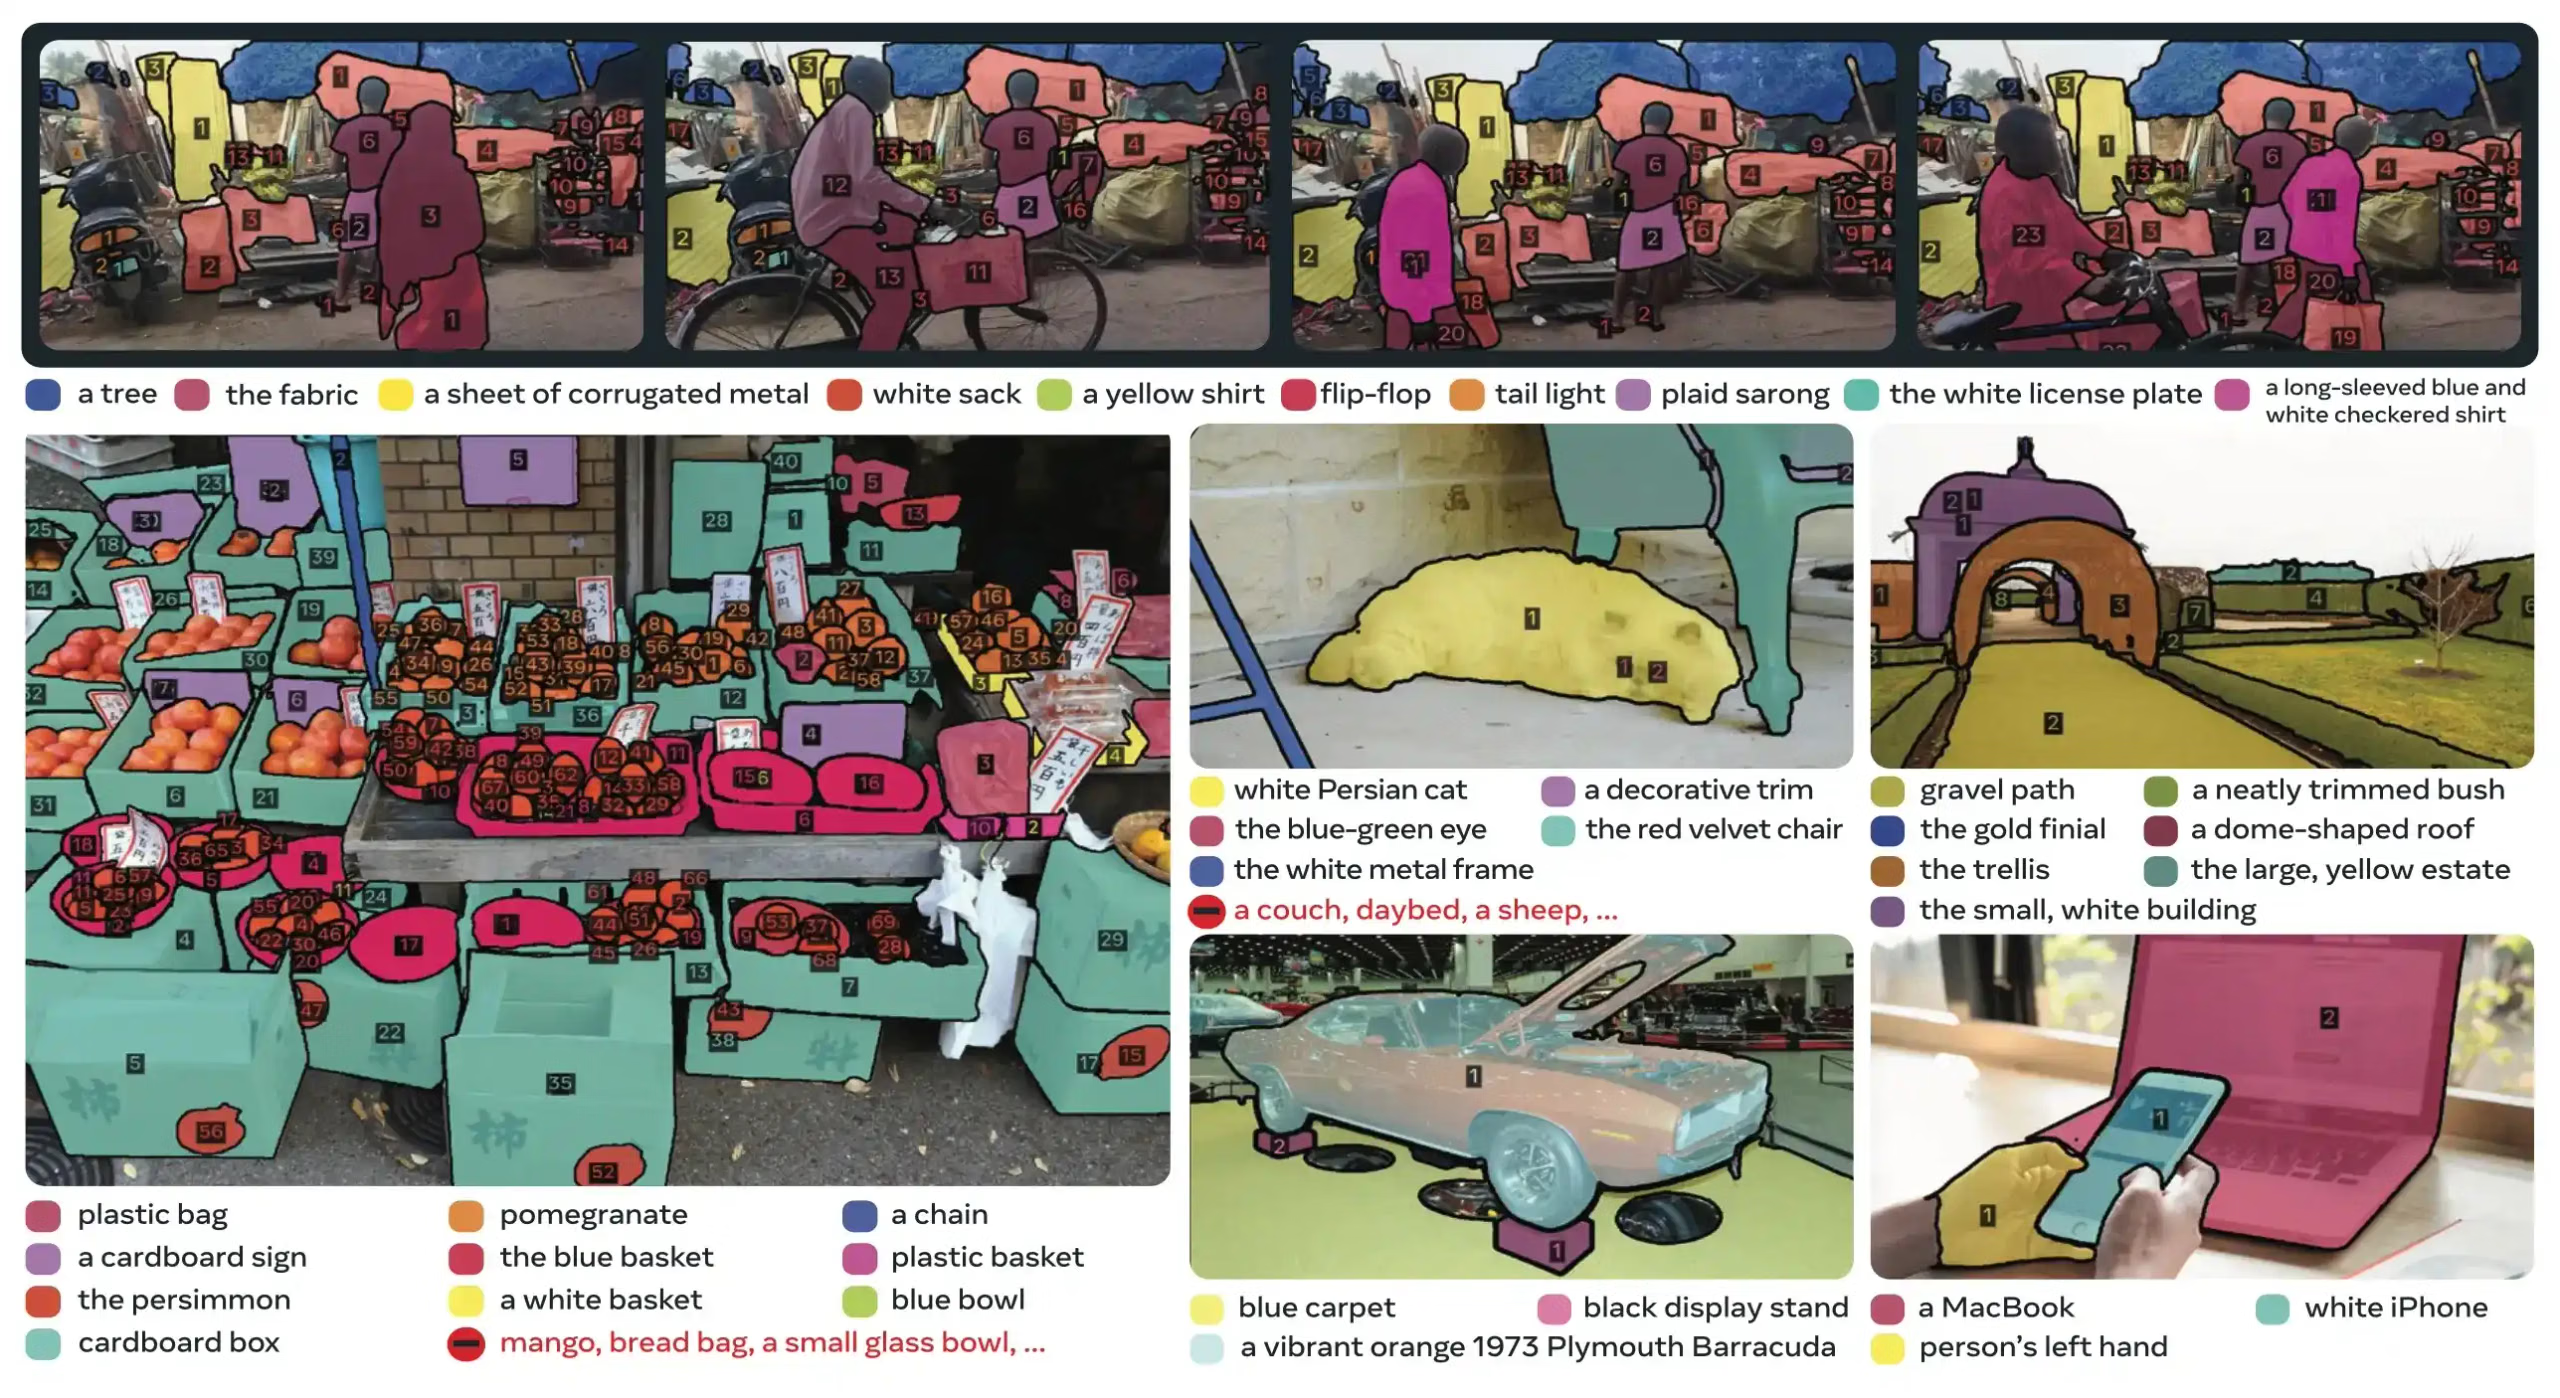
O que é a Segmentação de Conceitos com Prompts (PCS)?#
A tarefa PCS recebe um prompt de conceito como entrada e devolve máscaras de segmentação com identificadores únicos para todas as instâncias de objetos correspondentes. Os prompts de conceito podem ser:
- Texto: frases nominais simples, como "maçã vermelha" ou "pessoa com chapéu", semelhantes à aprendizagem zero-shot
- Exemplos de imagem: caixas delimitadoras à volta de objetos de exemplo (positivas ou negativas) para uma generalização rápida
- Combinados: texto e exemplos de imagem em conjunto, para um controlo preciso
Isto difere dos prompts visuais tradicionais (pontos, caixas, máscaras), que segmentam apenas uma instância específica de um único objeto, como popularizado pela família SAM original.
Principais métricas de desempenho#
| Métrica | Resultado do SAM 3 |
|---|---|
| AP de máscara zero-shot no LVIS | 47.0 (face ao melhor resultado anterior de 38.5, melhoria de +22%) |
| Referência SA-Co | 2× melhor do que os sistemas existentes |
| Velocidade de inferência (GPU H200) | 30 ms por imagem com mais de 100 objetos detetados |
| Desempenho em vídeo | Quase em tempo real para ~5 objetos simultâneos |
| Referência MOSEv2 VOS | 60.1 J&F (+25.5% em relação ao SAM 2.1, +17% em relação ao anterior SOTA) |
| Refinamento interativo | Melhoria de +18.6 CGF1 após 3 prompts de exemplo |
| Diferença em relação ao desempenho humano | Alcança 88% do limite inferior estimado no SA-Co/Gold |
Para contextualizar as métricas dos modelos e os compromissos envolvidos na produção, consulta as análises de avaliação de modelos e as métricas de desempenho do YOLO.
SAM 3.1#
O SAM 3.1, lançado pela Meta a 27 de março de 2026, é um novo checkpoint do SAM 3 que adiciona Object Multiplex, uma abordagem de memória partilhada para o acompanhamento de vários objetos em vídeo. Em vez de processar cada objeto acompanhado de forma independente, o SAM 3.1 agrupa os objetos em conjuntos de capacidade fixa e processa-os em conjunto; segundo a Meta, isto permite uma aceleração de ~7× com 128 objetos numa única GPU H100. O detetor de imagens e a cabeça interativa de prompts de pontos mantêm a arquitetura do SAM 3.
| Benchmark | Métrica | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (teste) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (teste) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (teste) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (validação) | J&F | 78.4 | 79.6 |
| DAVIS17 (validação) | J&F | 92.2 | 92.7 |
| SA-V (teste) | J&F | 84.4 | 85.1 |
| YTVOS19 (validação) | G | 89.7 | 89.3 |
| MOSEv2 (validação) | J&Ḟ | 60.3 | 62.3 |
A Ultralytics carrega o checkpoint SAM 3.1 (sam3.1_multiplex.pt) nos preditores de imagem do SAM 3: SAM("sam3.1_multiplex.pt") para prompts de pontos e caixas, e SAM3SemanticPredictor para prompts de texto e exemplos. O acompanhamento de vídeo Object Multiplex ainda não é suportado, por isso continua a utilizar sam3.pt com SAM3VideoPredictor e SAM3VideoSemanticPredictor.
Arquitetura#
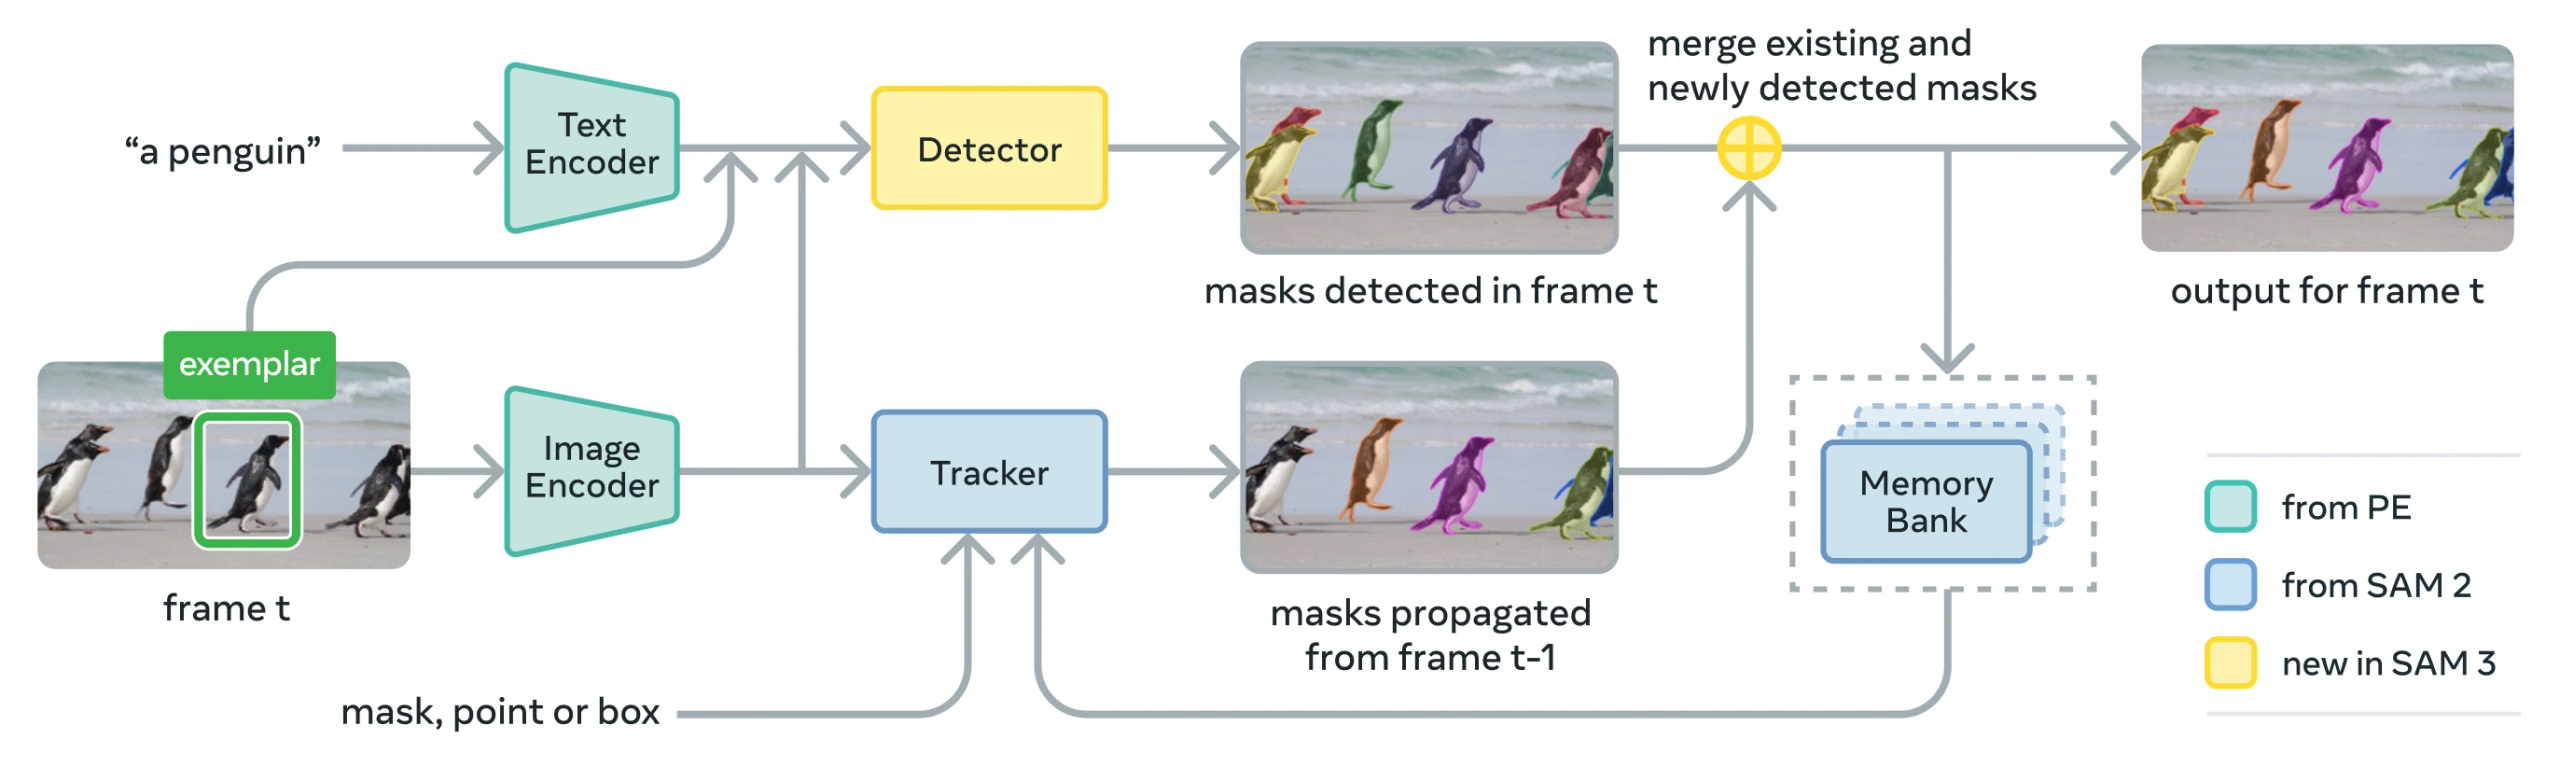
O SAM 3 é composto por um detetor e um rastreador que partilham um backbone de visão Perception Encoder (PE). Este design desacoplado evita conflitos entre tarefas e permite a deteção ao nível da imagem e o acompanhamento ao nível do vídeo, através de uma interface compatível com a utilização de Python e a utilização de CLI da Ultralytics.
Componentes principais#
-
Detetor: Arquitetura baseada em DETR para deteção de conceitos ao nível da imagem
- Codificador de texto para prompts de frases nominais
- Codificador de exemplos para prompts baseados em imagens
- Codificador de fusão para condicionar as características da imagem aos prompts
- Cabeça de presença inovadora, que separa o reconhecimento ("o quê") da localização ("onde")
- Cabeça de máscaras para gerar máscaras de segmentação de instâncias
-
Rastreador: Segmentação de vídeo baseada em memória, herdada do SAM 2
- Codificador de prompts, descodificador de máscaras, codificador de memória
- Banco de memória para armazenar a aparência dos objetos entre fotogramas
-
Token de presença: token global aprendido que prevê se o conceito-alvo está presente na imagem/fotograma, melhorando a deteção ao separar o reconhecimento da localização.
Principais inovações#
- Reconhecimento e localização desacoplados: O cabeçalho de presença prevê globalmente a presença do conceito, enquanto as consultas de proposta se concentram apenas na localização, evitando objetivos conflitantes.
- Prompts de conceito e visuais unificados: Oferece suporte a PCS (prompts de conceito) e PVS (prompts visuais, como cliques/caixas do SAM 2) em um único modelo.
- Refinamento interativo com exemplares: Os usuários podem adicionar exemplares positivos ou negativos de imagens para refinar os resultados iterativamente, e o modelo generaliza para objetos semelhantes em vez de apenas corrigir instâncias individuais.
- Desambiguação temporal: Usa pontuações de detecção de masklets e novos prompts periódicos para lidar com oclusões, cenas lotadas e falhas de rastreamento em vídeos, seguindo as práticas recomendadas de segmentação e rastreamento de instâncias.
Conjunto de dados SA-Co#
O SAM 3 é treinado com o Segment Anything with Concepts (SA-Co), o maior e mais diversificado conjunto de dados de segmentação da Meta até hoje, que vai além de benchmarks comuns como COCO e LVIS.
Dados de treinamento#
| Componente do conjunto de dados | Descrição | Escala |
|---|---|---|
| SA-Co/HQ | Dados de imagens de alta qualidade anotados por humanos, provenientes de um mecanismo de dados de 4 fases | 5,2 milhões de imagens, 4 milhões de frases nominais exclusivas |
| SA-Co/SYN | Conjunto de dados sintético rotulado por IA sem envolvimento humano | 38 milhões de frases nominais, 1,4 bilhão de máscaras |
| SA-Co/EXT | 15 conjuntos de dados externos enriquecidos com negativos difíceis | Varia conforme a origem |
| SA-Co/VIDEO | Anotações de vídeo com rastreamento temporal | 52,5 mil vídeos, 24,8 mil frases nominais exclusivas |
Dados de benchmark#
O benchmark de avaliação SA-Co contém 214 mil frases exclusivas em 126 mil imagens e vídeos, oferecendo mais de 50× mais conceitos do que os benchmarks existentes. Ele inclui:
- SA-Co/Gold: 7 domínios, com três anotações para medir os limites do desempenho humano
- SA-Co/Silver: 10 domínios, com uma anotação humana
- SA-Co/Bronze e SA-Co/Bio: 9 conjuntos de dados existentes adaptados para segmentação de conceitos
- SA-Co/VEval: Benchmark de vídeo com 3 domínios (SA-V, YT-Temporal-1B, SmartGlasses)
Inovações no mecanismo de dados#
O mecanismo de dados escalável com humanos e modelos no ciclo do SAM 3 alcança 2× mais produtividade de anotação por meio de:
- Anotadores de IA: modelos baseados em Llama propõem diversas expressões nominais, incluindo negativos difíceis
- Verificadores de IA: LLMs multimodais ajustados verificam a qualidade das máscaras e a exaustividade com desempenho quase humano
- Mineração ativa: Concentra o esforço humano em casos difíceis de falha nos quais a IA tem dificuldades
- Orientado por ontologia: Utiliza uma ontologia abrangente baseada no Wikidata para cobrir conceitos
Instalação#
Instala ou atualiza o pacote ultralytics:
pip install -U ultralyticsAo contrário de outros modelos Ultralytics, os pesos do SAM 3 (sam3.pt) não são baixados automaticamente. Primeiro, solicita acesso aos pesos do modelo na página do modelo SAM 3 no Hugging Face e, depois que o acesso for aprovado, baixa sam3.pt nessa página. Coloca o arquivo sam3.pt baixado no diretório de trabalho ou especifica o caminho completo ao carregar o modelo.
Os pesos do SAM 3.1 (sam3.1_multiplex.pt) têm o mesmo controle de acesso na página do modelo SAM 3.1. Passa sam3.1_multiplex.pt em qualquer lugar onde os exemplos de imagem abaixo usem sam3.pt.
Se ocorrer o erro acima durante a predição, isso significa que tens instalado o pacote clip incorreto. Instala o pacote clip correto executando:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
Como usar o SAM 3: versatilidade na segmentação de conceitos#
O SAM 3 oferece suporte às tarefas de segmentação de conceitos com prompts (PCS) e segmentação visual com prompts (PVS) por meio de diferentes interfaces de preditor:
Tarefas e modelos compatíveis#
| Tipo de tarefa | Tipos de prompt | Saída |
|---|---|---|
| Segmentação de conceitos (PCS) | Texto (frases nominais), exemplares de imagem | Todas as instâncias que correspondem ao conceito |
| Segmentação visual (PVS) | Pontos, caixas, máscaras | Instância de objeto única (estilo SAM 2) |
| Refinamento interativo | Adicionar/remover exemplares ou cliques iterativamente | Segmentação refinada com maior precisão |
Exemplos de segmentação de conceitos#
Segmentar com prompts de texto#
Encontra e segmenta todas as instâncias de um conceito usando uma descrição em texto. Os prompts de texto exigem a interface SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Inicializa o preditor com a configuração
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Usa FP16 para inferência mais rápida
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Define a imagem uma vez para várias consultas
predictor.set_image("path/to/image.jpg")

# Consulta com vários prompts de texto
results = predictor(text=["person", "bus", "glasses"])

# Funciona com frases descritivas
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Consulta com um único conceito
results = predictor(text=["a person"])
Segmentar com exemplares de imagem#
Usa caixas delimitadoras como prompts visuais para encontrar todas as instâncias semelhantes. Isso também exige SAM3SemanticPredictor para a correspondência baseada em conceitos.
from ultralytics.models.sam import SAM3SemanticPredictor

# Inicializa o preditor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Define a imagem
predictor.set_image("path/to/image.jpg")

# Fornece exemplos de caixas delimitadoras para segmentar objetos semelhantes
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Várias caixas delimitadoras como exemplares do mesmo conceito visual
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Inferência baseada em recursos para maior eficiência#
Extrai os recursos da imagem uma vez e reutiliza-os em várias consultas de segmentação para melhorar a eficiência.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Inicializa os preditores
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Extrai recursos do primeiro preditor
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Configura o segundo preditor e reutiliza os recursos
predictor2.setup_model()

# Executa a inferência usando recursos compartilhados com um prompt de texto
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Executa a inferência usando recursos compartilhados com um prompt de caixa delimitadora
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Visualiza os resultados
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Segmentação de conceitos em vídeo#
Rastrear conceitos em um vídeo com caixas delimitadoras#
Deteta e rastreia instâncias de objetos em quadros de vídeo usando prompts de caixa delimitadora.
from ultralytics.models.sam import SAM3VideoPredictor

# Cria o preditor de vídeo
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Rastreia objetos usando prompts de caixa delimitadora
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Processa e apresenta os resultados
for r in results:
    r.show()  # Apresenta o quadro com máscaras de segmentação
Rastrear conceitos com prompts de texto#
Rastreia todas as instâncias dos conceitos especificados por texto em quadros de vídeo.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Inicializa o preditor semântico de vídeo
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Rastreia conceitos usando prompts de texto
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Processa os resultados
for r in results:
    r.show()  # Apresenta o quadro com objetos rastreados

# Alternativa: rastrear com prompts de caixa delimitadora
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Rótulos positivos
    stream=True,
)
Prompts visuais (compatibilidade com SAM 2)#
O SAM 3 mantém compatibilidade retroativa total com os prompts visuais do SAM 2 para segmentação de objetos individuais:
A interface básica SAM funciona exatamente como o SAM 2, segmentando apenas a área específica indicada pelos prompts visuais (pontos, caixas ou máscaras).
from ultralytics import SAM

model = SAM("sam3.pt")

# Prompt de ponto único - segmenta o objeto num local específico
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Vários pontos - segmenta um único objeto com várias indicações de pontos
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Prompt de caixa - segmenta o objeto dentro de uma caixa delimitadora
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()Usar SAM("sam3.pt") com prompts visuais (pontos/caixas/máscaras) segmenta apenas o objeto específico nesse local, tal como o SAM 2. Para segmentar todas as instâncias de um conceito, usa SAM3SemanticPredictor com prompts de texto ou de exemplos, como mostrado acima.
Testes de desempenho#
Segmentação de imagens#
O SAM 3 alcança resultados de ponta em várias avaliações de referência, incluindo conjuntos de dados do mundo real como LVIS e COCO para segmentação:
| Benchmark | Métrica | SAM 3 | Melhor resultado anterior | Melhoria |
|---|---|---|---|---|
| LVIS (zero-shot) | AP de máscara | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34,3 (OWLv2) | +89.5% |
| COCO (zero-shot) | AP de caixa | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (segmentação semântica) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (segmentação semântica) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Explora opções de conjuntos de dados para experimentação rápida em conjuntos de dados Ultralytics.
Desempenho da segmentação de vídeo#
O SAM 3 apresenta melhorias significativas em relação ao SAM 2 e aos modelos anteriores de última geração em benchmarks de vídeo, como DAVIS 2017 e YouTube-VOS:
| Benchmark | Métrica | SAM 3 | SAM 2.1 L | Melhoria |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Adaptação com poucos exemplos#
O SAM 3 adapta-se a novos domínios com poucos exemplos, algo relevante para fluxos de trabalho de IA centrada nos dados:
| Benchmark | AP com 0 exemplos | AP com 10 exemplos | Melhor resultado anterior (10 exemplos) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Eficácia do refinamento interativo#
A solicitação baseada em conceitos do SAM 3, com exemplos, converge muito mais rapidamente do que a solicitação visual:
| Prompts adicionados | Pontuação CGF1 | Ganho em relação a apenas texto | Ganho em relação à referência PVS |
|---|---|---|---|
| Apenas texto | 46.4 | referência | referência |
| +1 exemplo | 57.6 | +11.2 | +6.7 |
| +2 exemplos | 62.2 | +15.8 | +9.7 |
| +3 exemplos | 65.0 | +18.6 | +11.2 |
| +4 exemplos | 65.7 | +19.3 | +11.5 (estabilização) |
Precisão da contagem de objetos#
O SAM 3 fornece contagens precisas ao segmentar todas as instâncias, um requisito comum na contagem de objetos:
| Benchmark | Precisão | MAE | em relação ao melhor MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
Comparação entre SAM 3, SAM 2 e YOLO#
Aqui comparamos as capacidades do SAM 3 com as do SAM 2 e dos modelos YOLO26:
| Capacidade | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Segmentação de conceitos | ✅ Todas as instâncias a partir de texto/exemplos | ❌ Não suportado | ❌ Não suportado |
| Segmentação visual | ✅ Instância única (compatível com SAM 2) | ✅ Instância única | ✅ Todas as instâncias |
| Capacidade zero-shot | ✅ Vocabulário aberto | ✅ Prompts geométricos | ❌ Conjunto fechado |
| Refinamento interativo | ✅ Exemplos + cliques | ✅ Apenas cliques | ❌ Não suportado |
| Rastreamento de vídeo | ✅ Vários objetos com identidades | ✅ Vários objetos | ✅ Vários objetos |
| AP de máscara LVIS (zero-shot) | 47.0 | N/D | N/D |
| MOSEv2 J&F | 60.1 | 47.9 | N/D |
| Velocidade (GPU, ms/im) | 2921 | 857 | 8.4 |
| Tamanho do modelo | 3.45 GB | 162 MB (base) | 6.4 MB |
Velocidade medida numa NVIDIA RTX PRO 6000 com torch==2.9.1 e ultralytics==8.4.19.
Principais conclusões:
- SAM 3: Ideal para segmentação de conceitos com vocabulário aberto, encontrando todas as instâncias de um conceito com prompts de texto ou de exemplos
- SAM 2: Ideal para a segmentação interativa de um único objeto em imagens e vídeos com prompts geométricos
- YOLO26: Ideal para segmentação em tempo real e alta velocidade, com inferência de ponta a ponta opcional sem NMS, exportável para muitos formatos para implementação em GPUs, CPUs e dispositivos de borda
- YOLOE: ideal para detecção e segmentação de vocabulário aberto em tempo real com prompts de texto ou visuais
Comparação entre SAM e YOLO#
Compara o SAM 3, o SAM 2, o SAM, o MobileSAM e o FastSAM com os modelos de segmentação Ultralytics YOLO (YOLOv8, YOLO11, YOLO26) em tamanho, parâmetros e velocidade de inferência na GPU:
| Modelo | Tamanho (MB) | Parâmetros (M) | Velocidade (GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s com backbone YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515x menor) | 3.4 (139.1x menos) | 17.4 (167x mais rápido) |
| Ultralytics YOLO11n-seg | 5.9 (585x menor) | 2.9 (163.1x menos) | 12.6 (231x mais rápido) |
| Ultralytics YOLO26n-seg | 6.4 (539x menor) | 2.7 (175.2x menos) | 8.4 (347x mais rápido) |
Esta comparação demonstra as diferenças substanciais entre os tamanhos e as velocidades dos modelos das variantes SAM e dos modelos de segmentação YOLO. Embora o SAM ofereça recursos exclusivos de segmentação automática, os modelos YOLO, especialmente YOLOv8n-seg, YOLO11n-seg e YOLO26n-seg, são significativamente menores, mais rápidos e mais eficientes em termos computacionais.
Testes executados numa NVIDIA RTX PRO 6000 com 96 GB de VRAM usando torch==2.9.1 e ultralytics==8.4.19. Para reproduzir este teste:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Perfilar SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Perfilar FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Perfilar modelos YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # Cabeça sem NMS do YOLO26; sem efeito para YOLOv8/YOLO11
Métricas de avaliação#
O SAM 3 introduz novas métricas desenvolvidas para a tarefa PCS, complementando medidas conhecidas, como pontuação F1, precisão e revocação.
F1 condicionado à classificação (CGF1)#
A métrica principal, que combina localização e classificação:
CGF1 = 100 × pmF1 × IL_MCC
Onde:
- pmF1 (F1 macro positivo): mede a qualidade da localização em exemplos positivos
- IL_MCC (coeficiente de correlação de Matthews no nível da imagem): mede a precisão da classificação binária ("o conceito está presente?")
Por que estas métricas?#
As métricas AP tradicionais não têm em conta a calibração, o que dificulta a utilização prática dos modelos. Ao avaliar apenas as previsões com confiança superior a 0,5, as métricas do SAM 3 exigem uma boa calibração e reproduzem padrões de utilização do mundo real em ciclos interativos de previsão e seguimento.
Principais ablações e conclusões#
Impacto da cabeça de presença#
A cabeça de presença separa o reconhecimento da localização, proporcionando melhorias significativas:
| Configuração | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Sem presença | 57.6 | 0.77 | 74.7 |
| Com presença | 63.3 | 0.82 | 77.1 |
A cabeça de presença proporciona um aumento de 5.7 no CGF1 (+9.9%), melhorando principalmente a capacidade de reconhecimento (IL_MCC +6.5%).
Efeito dos exemplos negativos difíceis#
| Exemplos negativos difíceis/imagem | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Os exemplos negativos difíceis são essenciais para o reconhecimento de vocabulário aberto, melhorando o IL_MCC em 54.5% (0.44 → 0.68).
Escalonamento dos dados de treinamento#
| Fontes de dados | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Somente externos | 30.9 | 0.46 | 66.3 |
| Externos + sintéticos | 39.7 | 0.57 | 70.6 |
| Externos + HQ | 51.8 | 0.71 | 73.2 |
| Os três | 54.3 | 0.74 | 73.5 |
Anotações humanas de alta qualidade proporcionam grandes ganhos em relação a dados sintéticos ou externos usados isoladamente. Para saber mais sobre práticas de qualidade de dados, consulta coleta e anotação de dados.
Aplicações#
O recurso de segmentação de conceitos do SAM 3 possibilita novos casos de uso:
- Moderação de conteúdo: encontrar todas as ocorrências de tipos específicos de conteúdo em bibliotecas de mídia
- Comércio eletrônico: segmentar todos os produtos de um determinado tipo em imagens de catálogo, permitindo a anotação automática
- Imagiologia médica: Identificar todas as ocorrências de tipos específicos de tecido ou anomalias
- Sistemas autônomos: rastrear todas as ocorrências de sinais de trânsito, pedestres ou veículos por categoria
- Análise de vídeo: contar e rastrear todas as pessoas que usam roupas específicas ou realizam determinadas ações
- Anotação de conjuntos de dados: anotar rapidamente todas as ocorrências de categorias raras de objetos
- Pesquisa científica: quantificar e analisar todos os espécimes que correspondem a critérios específicos
Agente SAM 3: raciocínio linguístico ampliado#
O SAM 3 pode ser combinado com modelos de linguagem grandes multimodais (MLLMs) para lidar com consultas complexas que exigem raciocínio, de forma semelhante a sistemas de vocabulário aberto como OWLv2 e T-Rex.
Desempenho em tarefas de raciocínio#
| Benchmark | Métrica | Agente SAM 3 (Gemini 2.5 Pro) | Melhor resultado anterior |
|---|---|---|---|
| ReasonSeg (validação) | gIoU | 76.0 | 65.0 (estado da arte) |
| ReasonSeg (teste) | gIoU | 73.8 | 61.3 (estado da arte) |
| OmniLabel (validação) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Exemplos de consultas complexas#
O agente SAM 3 consegue lidar com consultas que exigem raciocínio:
- "Pessoas sentadas, mas sem segurar uma caixa de presente nas mãos"
- "O cachorro mais perto da câmera que não está usando coleira"
- "Objetos vermelhos maiores que a mão da pessoa"
O MLLM propõe consultas com sintagmas nominais simples ao SAM 3, analisa as máscaras retornadas e repete o processo até ficar satisfeito.
Limitações#
O SAM 3 tem as seguintes limitações:
- Complexidade das frases: é mais adequado para sintagmas nominais simples; expressões referenciais longas ou raciocínios complexos podem exigir integração com MLLM
- Como lida com ambiguidades: alguns conceitos continuam sendo inerentemente ambíguos (por exemplo, "janela pequena", "quarto aconchegante")
- Requisitos computacionais: É maior e mais lento do que modelos de deteção especializados, como o YOLO
- Escopo do vocabulário: concentra-se em conceitos visuais atômicos; o raciocínio composicional é limitado sem a assistência de MLLM
- Conceitos raros: o desempenho pode cair em conceitos extremamente raros ou específicos que não estejam bem representados nos dados de treinamento
Citação#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Perguntas frequentes#
O SAM 3 foi lançado pela Meta em 19 de novembro de 2025 e está totalmente integrado no pacote
ultralytics, com suporte para previsões de imagens e seguimento de vídeo através de preditores dedicados.Sim. O SAM 3 está totalmente integrado no pacote Python da Ultralytics, incluindo a segmentação de conceitos, os prompts visuais ao estilo do SAM 2 e o seguimento de vários objetos em vídeo. O SAM 3 e o SAM 3.1 também alimentam a funcionalidade de anotação inteligente na Ultralytics Platform, onde o SAM 3.1 é o modelo predefinido e podes anotar imagens com apenas alguns cliques. Em conjuntos de dados de deteção com 1–200 classes, o SAM 3 Text e o SAM 3.1 Text também fazem anotações automáticas a partir dos nomes das classes, e o quadro de classificação de VLM compara a respetiva precisão com a de modelos de visão e linguagem.
Sim, para predição de imagens. Carrega
sam3.1_multiplex.ptonde os exemplos de imagem nesta página usamsam3.pt:SAM("sam3.1_multiplex.pt")para prompts de pontos e caixas, eSAM3SemanticPredictorpara prompts de texto e exemplos. O rastreamento de vídeo Object Multiplex ainda não é compatível, por isso continua a usarsam3.ptcom os preditores de vídeo. Consulta SAM 3.1 para ver os benchmarks da Meta.PCS é uma nova tarefa introduzida no SAM 3 que segmenta todas as ocorrências de um conceito visual em uma imagem ou vídeo. Ao contrário da segmentação tradicional, que tem como alvo uma ocorrência específica de um objeto, PCS encontra todas as ocorrências de uma categoria. Por exemplo:
- Prompt de texto: "ônibus escolar amarelo" → segmenta todos os ônibus escolares amarelos na cena
- Exemplo de imagem: caixa à volta de um cão → segmenta todos os cães na imagem
- Combinado: «gato às riscas» + caixa de exemplo → segmenta todos os gatos às riscas que correspondem ao exemplo
Funcionalidade SAM 2 SAM 3 Tarefa Um objeto por prompt Todas as instâncias de um conceito Tipos de prompt Pontos, caixas, máscaras + Frases de texto, exemplos de imagem Capacidade de deteção Requer um detetor externo Detetor de vocabulário aberto integrado Reconhecimento Apenas com base na geometria Reconhecimento textual e visual Arquitetura Apenas rastreador Detetor + rastreador com uma cabeça de presença Desempenho zero-shot N/D (requer prompts visuais) 47,0 AP no LVIS, 2× melhor no SA-Co Refinamento interativo Apenas cliques Cliques + generalização a partir de exemplos O SAM 3 mantém a compatibilidade com versões anteriores dos prompts visuais do SAM 2, acrescentando capacidades baseadas em conceitos.
O SAM 3 é treinado no conjunto de dados Segment Anything with Concepts (SA-Co):
Dados de treino:
- 5,2 milhões de imagens com 4 milhões de frases nominais únicas (SA-Co/HQ) — anotações humanas de alta qualidade
- 52,5 mil vídeos com 24,8 mil frases nominais únicas (SA-Co/VIDEO)
- 1,4 mil milhões de máscaras sintéticas em 38 milhões de frases nominais (SA-Co/SYN)
- 15 conjuntos de dados externos enriquecidos com negativos difíceis (SA-Co/EXT)
Dados de benchmark:
- 214 mil conceitos únicos em 126 mil imagens/vídeos
- 50× mais conceitos do que os benchmarks existentes (por exemplo, o LVIS tem ~4 mil conceitos)
- Anotação tripla no SA-Co/Gold para medir os limites do desempenho humano
Esta escala e diversidade sustentam a generalização zero-shot do SAM 3 a conceitos de vocabulário aberto.
O SAM 3 e o YOLO26 destinam-se a casos de utilização diferentes:
Vantagens do SAM 3:
- Vocabulário aberto: segmenta qualquer conceito através de prompts de texto, sem treino
- Zero-shot: funciona imediatamente com novas categorias
- Interativo: o refinamento baseado em exemplos generaliza-se a objetos semelhantes
- Baseado em conceitos: encontra automaticamente todas as instâncias de uma categoria
- Precisão: 47,0 AP na segmentação zero-shot de instâncias no LVIS
Vantagens do YOLO26:
- Velocidade: inferência muitas ordens de grandeza mais rápida, com uma cabeça ponta a ponta opcional sem NMS
- Eficiência: modelos 539× mais pequenos (6,4 MB vs. 3,45 GB)
- Eficiente em recursos: funciona em dispositivos de edge e telemóveis
- Tempo real: otimizado para implementações em produção
Recomendação:
- Usa o SAM 3 para segmentação flexível de vocabulário aberto, quando precisas de encontrar todas as instâncias de conceitos descritos por texto ou exemplos
- Usa o YOLO26 para implementações de alta velocidade em produção, quando as categorias são conhecidas antecipadamente
- Usa o SAM 2 para segmentação interativa de um único objeto com prompts geométricos
O SAM 3 foi concebido para frases nominais simples (por exemplo, «maçã vermelha», «pessoa com chapéu»). Para consultas complexas que exigem raciocínio, combina o SAM 3 com um MLLM como SAM 3 Agent:
Consultas simples (SAM 3 nativo):
- «autocarro escolar amarelo»
- «gato às riscas»
- «pessoa com chapéu vermelho»
Consultas complexas (SAM 3 Agent com MLLM):
- «Pessoas sentadas, mas sem segurar uma caixa de presente»
- «O cão mais próximo da câmara sem coleira»
- "Objetos vermelhos maiores que a mão da pessoa"
O SAM 3 Agent alcança 76,0 gIoU na validação do ReasonSeg (contra 65,0 do melhor resultado anterior, uma melhoria de +16,9%) ao combinar a segmentação do SAM 3 com as capacidades de raciocínio do MLLM.
No benchmark SA-Co/Gold com anotação humana tripla:
- Limite inferior humano: 74,2 CGF1 (anotador mais conservador)
- Desempenho do SAM 3: 65,0 CGF1
- Resultado: 88% do limite inferior humano estimado
- Limite superior humano: 81,4 CGF1 (anotador mais permissivo)
O SAM 3 alcança um desempenho elevado, aproximando-se da precisão humana na segmentação de conceitos de vocabulário aberto, com a diferença a verificar-se sobretudo em conceitos ambíguos ou subjetivos (por exemplo, «janela pequena», «sala acolhedora»).


Comentários105
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
 Glenn JocherUltralytics(editado)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(editado)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(editado)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(editado)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(editado)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.