Exportação Rockchip RKNN
RKNN é o formato de modelo das NPU nos processadores Rockchip, como o RK3588 e o RK3566. Exportar um modelo Ultralytics YOLO26 com format="rknn" cria um diretório yolo26n_rknn_model/ que contém um arquivo .rknn criado para um chip Rockchip, selecionado com o argumento name, com precisão FP16 ou INT8.
Visão geral#
| Propriedade | Detalhes |
|---|---|
Argumento format | rknn |
| Saída | yolo26n_rknn_model/, um diretório com yolo26n-rk3588.rknn e metadata.yaml; exportações INT8 de modelos de detecção, segmentação, pose e OBB também incluem tail.onnx |
| Funciona em | A NPU de um chip Rockchip por exportação: RK3588, RK3576, RK3566, RK3568, RK3562, RK2118, RV1126B, RV1103, RV1106, RV1103B ou RV1106B; consulte Chips de destino |
| Ambiente de execução | RKNN Toolkit Lite2 (o pacote Python rknn-toolkit-lite2) no dispositivo Rockchip |
| Precisão | FP16 (predefinição) e INT8; apenas INT8 no RV1103, RV1106, RV1103B e RV1106B. Não há exportação FP32. O YOLO26n para o RK3588 tem 7,4 MB em FP16 e 4,3 MB em INT8 |
| Máquina de exportação | Linux x86-64 com Python 3.12 ou anterior. Faça a exportação num PC e copie o diretório exportado para o dispositivo Rockchip |
A Ultralytics Platform pode exportar um modelo treinado para RKNN para o chip Rockchip selecionado, sem precisar de um ambiente de exportação local.
Início rápido#
Instale o pacote Ultralytics num ambiente virtual separado numa máquina Linux x86-64, juntamente com as versões protobuf e numpy necessárias para o RKNN Toolkit:
pip install ultralytics "protobuf<7" "numpy<2.4"A primeira exportação instala onnx, onnxslim, onnxruntime e rknn-toolkit2 com as respetivas dependências, caso ainda não estejam instaladas. Com um pip install ultralytics simples, a primeira exportação também substitui numpy, protobuf e setuptools quando as respetivas versões estão fora dos intervalos abaixo; por isso, use um ambiente separado. Se for necessário substituir protobuf ou numpy, a exportação falha, mas a seguinte, iniciada num novo processo, é concluída. A exportação tem estes requisitos de versão:
| Pacote | Versão necessária |
|---|---|
| Python | 3.12 ou anterior, a versão mais recente para a qual rknn-toolkit2 2.3.2 tem compilações |
rknn-toolkit2 | 2.3.2, a única versão publicada no PyPI dentro do intervalo exigido (2.3.2 ou superior e inferior a 2.5) |
onnx | 1.16.1 ou superior e inferior a 1.19.0 |
numpy | inferior a 2.4 |
protobuf | inferior a 7 |
setuptools | inferior a 82 |
Para conhecer outros métodos de instalação, consulte o guia de instalação. Em seguida, exporte o modelo no PC, copie o diretório exportado para o dispositivo Rockchip e carregue-o nesse dispositivo para executar inferências ou validar a precisão.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# # Exporta o modelo para o formato RKNN para o RK3588 em FP16
model.export(format="rknn", name="rk3588")  # creates 'yolo26n_rknn_model/'

# # Ou exporta um modelo RKNN quantizado em INT8 com dados de calibração
model.export(format="rknn", name="rk3588", quantize=8, data="coco8.yaml")  # creates 'yolo26n_rknn_model/'
Ambas as exportações gravam no mesmo diretório yolo26n_rknn_model/, por isso a segunda substitui a primeira. Predict e Validate só são executados num dispositivo Rockchip:
from ultralytics import YOLO

# # Carrega o modelo RKNN exportado no dispositivo Rockchip
model = YOLO("yolo26n_rknn_model")

# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # Carrega o modelo RKNN exportado no dispositivo Rockchip
model = YOLO("yolo26n_rknn_model")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Tarefas suportadas#
A exportação RKNN é compatível com todas as sete tarefas da Ultralytics e com os modelos YOLOv8, YOLO11 e YOLO26: detecção, segmentação, segmentação semântica, estimativa de profundidade, classificação, estimativa de pose e OBB. A segmentação semântica e a estimativa de profundidade só estão disponíveis no YOLO26, a única família que inclui essas cabeças.
Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'rknn' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
name | str | 'rk3588' | Chip Rockchip para o qual o modelo é criado, em maiúsculas ou minúsculas. Consulte Chips de destino. |
imgsz | int ou tuple | 640 | Tamanho da imagem de entrada do modelo: um número inteiro para imagens quadradas ou uma tupla (height, width). Se não for especificado, a exportação usa o tamanho com que o checkpoint foi treinado. Os checkpoints oficiais do YOLO26 usam 640 para modelos de detecção, segmentação e pose, bem como para modelos semânticos pré-treinados no ADE20K; 1024 para modelos OBB e modelos semânticos pré-treinados no Cityscapes; 768 para profundidade; e 224 para classificação. |
quantize | int ou str | None | Precisão: 16 ou a omissão do parâmetro gera FP16, e 8 gera INT8 calibrado com data. Nos chips compatíveis apenas com INT8, a omissão do parâmetro gera INT8, e 16 gera um erro. 32 gera um erro, e não é possível exportar para RKNN um checkpoint treinado com quantize=8; consulte Limitações e resolução de problemas. Substitui as flags obsoletas half/int8. |
data | str | None | Ficheiro YAML do conjunto de dados usado para a calibração INT8; a classificação usa, em vez disso, um diretório de conjunto de dados ou um nome de conjunto de dados integrado. A calibração usa a divisão val, a menos que split esteja definido. Se for omitido com quantize=8, Ultralytics usa o pequeno conjunto de dados predefinido para a tarefa do modelo, como coco8.yaml para deteção. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração: uma proporção, um número de imagens (números inteiros acima de 1) ou uma lista [train, val, test], da qual é usada a entrada da divisão de calibração. |
batch | int | 1 | Tamanho do lote do modelo exportado, fixado na forma de entrada. |
simplify | bool | True | Simplifica o grafo ONNX intermediário com onnxslim. |
opset | int | None | Versão do opset ONNX do grafo ONNX intermédio. Se não for especificada, usa 19 e reduz valores superiores para 19. |
nms | bool, opcional | None | Os modelos RKNN devolvem sempre previsões brutas para NMS externa. A cabeça sem NMS (False) e a NMS incorporada (True) não estão disponíveis; consulte Limitações e resolução de problemas. |
device | str | None | Dispositivo usado para rastrear o grafo ONNX intermédio: cpu (predefinição) ou 0 para uma GPU CUDA. |
Para consultar os argumentos compartilhados por todos os formatos, veja a documentação do modo de exportação.
Chips de destino#
Um arquivo .rknn é criado para um único chip, selecionado por name. Os tamanhos referem-se a um modelo de detecção YOLO26n exportado com imgsz=640 e quantize omitido:
name | Precisões | Se quantize não for especificado, gera | Arquivo YOLO26n | Tamanho |
|---|---|---|---|---|
rk3588 | FP16, INT8 | FP16 | yolo26n-rk3588.rknn | 7.4 MB |
rk3576 | FP16, INT8 | FP16 | yolo26n-rk3576.rknn | 10.5 MB |
rk3566 | FP16, INT8 | FP16 | yolo26n-rk3566.rknn | 6.8 MB |
rk3568 | FP16, INT8 | FP16 | yolo26n-rk3568.rknn | 6.8 MB |
rk3562 | FP16, INT8 | FP16 | yolo26n-rk3562.rknn | 6.8 MB |
rk2118 | FP16, INT8 | FP16 | yolo26n-rk2118.rknn | 6.8 MB |
rv1126b | FP16, INT8 | FP16 | yolo26n-rv1126b.rknn | 7.1 MB |
rv1103 | INT8 | INT8 | yolo26n-rv1103.rknn | 4.2 MB |
rv1106 | INT8 | INT8 | yolo26n-rv1106.rknn | 4.2 MB |
rv1103b | INT8 | INT8 | yolo26n-rv1103b.rknn | 4.2 MB |
rv1106b | INT8 | INT8 | yolo26n-rv1106b.rknn | 4.2 MB |
Os quatro chips compatíveis apenas com INT8 são calibrados com coco8.yaml, a predefinição desta tabela, e as respetivas exportações também gravam tail.onnx.
Quantização#
quantize seleciona a precisão do arquivo .rknn. Os tamanhos referem-se a uma exportação com imgsz=640 e batch=1:
quantize | Precisão | Dados de calibração | Arquivos para YOLO26n e rk3588 | Tamanho |
|---|---|---|---|---|
omitido ou 16 | FP16 | Não | yolo26n-rk3588.rknn | 7.4 MB |
8 | INT8 | Sim | yolo26n-rk3588.rknn e tail.onnx | 4,3 MB e 0,2 MB |
- FP16: a predefinição para os sete chips compatíveis. Não requer dados de calibração.
- INT8:
quantize=8executa as imagens de calibração através do modelo e armazena os pesos e as ativações como números inteiros de 8 bits. A exportação calibra com a divisãovaldedata, ou com a divisão especificada porsplit, e emite um aviso se houver menos de 300 imagens. Usefractionpara limitar o número de imagens. - Precisão mista: nos sete chips compatíveis com FP16, uma exportação INT8 permite que o RKNN Toolkit mantenha as camadas em FP16 quando a quantização altera demasiado a respetiva saída (
auto_hybrid). Os quatro chips compatíveis apenas com INT8 não executam esta etapa. - Cabeça de detecção: para modelos de detecção, segmentação, pose e OBB, o arquivo INT8
.rknntermina nas convoluções de saída da cabeça. As operações que descodificam essas saídas em caixas são guardadas comotail.onnxe executadas em ponto flutuante na CPU do dispositivo, porque o INT8 por tensor não consegue representar os valores do intervalo de píxeis da descodificação das caixas. - Modelos de profundidade: as exportações INT8 de profundidade são calibradas com imagens de um conjunto de dados de profundidade que tenham mapas de profundidade correspondentes. Escolha imagens de calibração que abranjam os intervalos de profundidade próximo e distante da cena de implementação. Com a predefinição
depth8.yaml, que tem 4 imagens de validação, um modelo YOLO26n-depth INT8 no simulador rknn-toolkit2 devolveu profundidades até 3.9 numa imagem de rua, enquanto o modelo FP16 devolveu valores até 13.9. - Estado no dispositivo: as exportações INT8 de todas as tarefas foram executadas no simulador rknn-toolkit2 e comparadas com o modelo ONNX numa única imagem. A respetiva precisão não foi medida num conjunto de dados nem em hardware Rockchip; por isso, valide o modelo INT8 no seu dispositivo e com os seus próprios dados antes de o implementar.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Calibrar com 10% das imagens de validação COCO (500 imagens); substitua coco.yaml pelo seu próprio conjunto de dados
model.export(format="rknn", name="rk3588", quantize=8, data="coco.yaml", fraction=0.1)
Formato de saída#
A exportação grava um diretório:
| Ficheiro | Conteúdo |
|---|---|
yolo26n-rk3588.rknn | O modelo, com o chip definido por name no nome do arquivo |
tail.onnx | Apenas para modelos INT8 de detecção, segmentação, pose e OBB: as operações que descodificam as saídas da cabeça em previsões brutas, para serem executadas na CPU |
metadata.yaml | Nomes das classes, tarefa, tamanho da imagem, tamanho do lote, stride e argumentos de exportação, que Ultralytics lê ao carregar o modelo |
O arquivo intermédio yolo26n.onnx fica ao lado do diretório. O modelo .rknn recebe uma entrada com a forma (batch, height, width, 3): RGB, canais por último (NHWC), uint8 com valores entre 0 e 255. A divisão por 255 faz parte do modelo; por isso, não redimensione os valores da imagem. Isto difere da exportação ONNX, que recebe imagens float32 com os canais primeiro, redimensionadas para o intervalo 0–1.
As saídas dependem da tarefa e da precisão. As formas abaixo correspondem aos checkpoints oficiais YOLO26n com o tamanho de exportação predefinido e ao checkpoint Cityscapes yolo26n-sem.pt para segmentação semântica:
| Tarefa | imgsz padrão | Saída FP16 e saída tail.onnx para INT8 | Saída INT8 .rknn |
|---|---|---|---|
| Detecção | 640 | (1, 84, 8400) | 6 tensores da cabeça, descodificados por tail.onnx |
| Segmentação | 640 | (1, 116, 8400) e (1, 32, 160, 160) | 9 tensores da cabeça e (1, 32, 160, 160), descodificados por tail.onnx |
| Semântica | 1024 | (1, 19, 1024, 1024), uma pontuação para cada classe e píxel | Igual a FP16 |
| Profundidade | 768 | (1, 1, 768, 768), mapa de profundidade | Igual a FP16 |
| Classificação | 224 | (1, 1000), probabilidades das classes | Igual a FP16 |
| Pose | 640 | (1, 56, 8400) | 9 tensores da cabeça, descodificados por tail.onnx |
| OBB | 1024 | (1, 20, 21504) | 9 tensores da cabeça, descodificados por tail.onnx |
- Previsões brutas: os modelos FP16 e
tail.onnxpara modelos INT8 devolvem as mesmas previsões brutas que uma exportação ONNX predefinida: para cada âncora, centro x da caixa, centro y, largura e altura em píxeis de entrada, seguidos pelas pontuações das classes e pelos valores da tarefa (32 coeficientes de máscara, 17 valores de pontos-chave x 3 ou o ângulo OBB em radianos). Aplique a NMS por conta própria. Consulte o formato de saída ONNX para ver a disposição de cada tarefa. - Tensores da cabeça INT8: um modelo de detecção INT8 devolve dois tensores para cada uma das três escalas de detecção: um com os valores das caixas e outro com as pontuações das classes. Os modelos de segmentação, pose e OBB devolvem mais um tensor por escala com os valores adicionais. Passe-os para
tail.onnxpela ordem em que o modelo os devolve; um modelo de segmentação também passa os respetivos protótipos de máscara portail.onnxsem alterações. - Segmentação semântica: a saída contém uma pontuação para cada classe e píxel, não o mapa de classes da exportação ONNX; por isso, calcule o argmax no eixo das classes no seu próprio código.
- NMS: não há saída sem NMS nem com NMS incorporada; consulte Limitações e resolução de problemas.
YOLO("yolo26n_rknn_model") lê a disposição de metadata.yaml, executa tail.onnx e aplica NMS; por isso, só precisa destes detalhes se executar o modelo no seu próprio código. As chaves de metadata.yaml incluem names, task, imgsz, stride, batch, end2end, args e, para modelos de pose, kpt_shape.
Executar com RKNN Toolkit Lite2#
Para executar o modelo no dispositivo sem usar o pacote Ultralytics, carregue-o com o pacote rknn-toolkit-lite2 e, no caso de um modelo INT8 de detecção, segmentação, pose ou OBB, passe as saídas para tail.onnx com o ONNX Runtime:
# # Exporta primeiro: yolo export model=yolo26n.pt format=rknn name=rk3588 quantize=8 data=coco8.yaml
import numpy as np
import onnxruntime as ort
from rknnlite.api import RKNNLite

rknn = RKNNLite()
assert rknn.load_rknn("yolo26n_rknn_model/yolo26n-rk3588.rknn") == 0
assert rknn.init_runtime() == 0

image = np.zeros((1, 640, 640, 3), dtype=np.uint8)  # # a imagem com letterbox: RGB, NHWC, 0-255
outputs = rknn.inference(inputs=[image])  # # seis tensores da cabeça para um modelo de detecção INT8

tail = ort.InferenceSession("yolo26n_rknn_model/tail.onnx", providers=["CPUExecutionProvider"])
feed = {t.name: x.astype(np.float32) for t, x in zip(tail.get_inputs(), outputs)}
predictions = tail.run(None, feed)[0]  # # forma (1, 84, 8400), previsões brutas que requerem NMS
assert predictions.shape == (1, 84, 8400), "export a detection model at imgsz=640 with quantize=8"
tail.onnx tem sempre um tamanho de lote igual a 1, independentemente de batch da exportação; por isso, execute-o uma vez por imagem se o modelo tiver sido exportado com um lote maior. Um modelo FP16 não tem tail.onnx, e outputs[0] já contém as previsões brutas.
Implantar#
No dispositivo Rockchip, instale o pacote com pip install ultralytics e copie o diretório yolo26n_rknn_model/ para o dispositivo; as versões protobuf e numpy do Guia de introdução só são necessárias para a exportação. Em seguida, YOLO("yolo26n_rknn_model") executa o modelo na NPU com o pacote Python rknn-toolkit-lite2, que a Ultralytics instala na primeira utilização juntamente com onnxruntime quando o diretório contém um tail.onnx. O dispositivo precisa de Python 3.12 ou anterior, a versão mais recente para a qual rknn-toolkit-lite2 tem compilações.
- É necessário um dispositivo Rockchip: a Ultralytics só carrega um modelo RKNN em sistemas Linux ARM de 64 bits cuja cadeia
compatibleda árvore de dispositivos termina com um dos nomes de chips compatíveis. Em todos os outros casos, o carregamento falha; consulte Limitações e resolução de problemas.rknn-toolkit-lite2também só tem compilações para Linux ARM de 64 bits; por isso, num destino que não cumpra estas condições, execute o arquivo.rknncom a API C da Rockchip e executetail.onnxou implemente a mesma descodificação no seu próprio código. - Chip correspondente: exporte usando o
namedo chip da sua placa. - Forma de entrada fixa: o modelo é sempre executado com
imgszebatchdefinidos na exportação, que a Ultralytics lê demetadata.yaml. Umimgszpassado parapredictouvalé ignorado. Os lotes maiores são divididos em blocos do tamanho do lote de exportação, e os menores são preenchidos; assim, é possível usar qualquer número de imagens. device: não há nenhum dispositivo para selecionar. O modelo.rknné executado através do runtime RKNN, etail.onnxé executado com o ONNX Runtime na CPU.
Uma versão anterior deste fluxo de trabalho foi testada numa Radxa Rock 5B (RK3588) e numa Radxa Zero 3W (RK3566). A exportação INT8 atual ainda não foi executada em hardware.
Guias de implantação#
- Configuração da placa: instale primeiro um sistema operativo, conforme descrito nos guias de introdução da Radxa Rock 5B e da Radxa Zero 3W.
- RKNN Toolkit2 no GitHub: o kit de ferramentas de conversão, o runtime RKNN Toolkit Lite2 e a biblioteca de runtime
librknnrt.socom a respetiva API C. - RKNN Model Zoo: exemplos de implementação da Rockchip em C e Python.
- Implemente Ultralytics YOLO em Rockchip: uma visão geral do fluxo de trabalho no blogue da Ultralytics.
- Opções de implementação de modelos: compare RKNN com os outros formatos de exportação.
Limitações e solução de problemas#
-
Máquina de exportação: faça a exportação numa máquina Linux x86-64. No macOS, não é possível instalar
rknn-toolkit2durante a exportação, que falha comNo module named 'rknn'; o pacote não tem compilações para macOS nem Windows. A exportação em Linux ARM64, incluindo em placas Rockchip, não foi testada nem é compatível: a Ultralytics testa a exportação RKNN apenas em Linux x86-64. -
Versão do Python:
rknn-toolkit22.3.2 tem compilações para Python 3.12 e versões anteriores. Se estiver a usar uma versão mais recente do Python, crie o ambiente com Python 3.12. -
Primeira exportação num ambiente novo: num ambiente sem as versões
protobufenumpydo Guia de introdução, a primeira exportação substitui estes pacotes durante a execução e falha. Quando substituiprotobuf7, que o pip instala juntamente comonnx, o erro éAttributeError: 'google._upb._message.FieldDescriptor' object has no attribute 'label'; quando substitui apenasnumpy, o erro éTypeError: only 0-dimensional arrays can be converted to Python scalars. Volte a executar a exportação num novo processo, o que significa reiniciar o kernel num notebook, ou instale"protobuf<7" "numpy<2.4"antes da primeira exportação, conforme indicado no Guia de introdução. -
Os modelos RKNN não são executados num PC: a previsão ou validação com
YOLO("yolo26n_rknn_model")falha comRKNN inference is only supported on Rockchip devices.num PC e numa placa cuja cadeia/proc/device-tree/compatiblenão termina com um dos nomes de chips compatíveis. Imprima-a comcat /proc/device-tree/compatible. -
FP32:
quantize=32falha comquantize=32 (FP32) is not supported; format='rknn' supports quantize=16 (FP16), 8 (INT8). -
Chips compatíveis apenas com INT8: para
rv1103,rv1106,rv1103berv1106b, uma exportação semquantizeregistaRockchip target 'rv1106' requires INT8 quantization, enabling it.e cria um modelo INT8;quantize=16falha comRockchip target 'rv1106' only supports INT8, but got quantize=16. -
nameem falta ou incorreto: semname, a exportação registaRockchip RKNN export requires a missing 'name' arg for processor type. Using default name='rk3588'.. Um valor desconhecido falha comInvalid processor name 'rk9999' for Rockchip RKNN export., seguido dos nomes válidos. -
Cabeça sem NMS: os modelos RKNN devolvem sempre previsões brutas que requerem NMS. Com
nms=False, a exportação de um modelo YOLO26 ou YOLOv10 registaThis export format does not support end2end models, disabling the end2end branch.e usa a cabeça um-para-muitos; para outros modelos de detecção, segmentação, pose e OBB, como o YOLO11, registaThis model has no one-to-one head; using one-to-many outputs.. Os modelos de classificação, segmentação semântica e profundidade ignoramnms=False. -
NMS incorporada:
nms=Trueregistaformat=rknn does not support embedded NMS; exporting native outputs for external NMS.e grava a saída bruta. -
Checkpoints treinados com
quantize=8: um checkpoint ajustado com treino com reconhecimento de quantização falha comformat='rknn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. Em vez disso, exporte o checkpoint usado como ponto de partida para o ajuste fino comquantize=8. -
RT-DETR: com
rknn-toolkit22.3.2, a exportação de um modelo RT-DETR falha dentro do kit de ferramentas, tanto em FP16 como em INT8, parartdetr-l.ptemimgsz=640comValueError: operands could not be broadcast together with shapes (256,256) (8400,1). -
Forma de entrada fixa:
dynamic=Truefalha comargument 'dynamic' is not supported for format='rknn'. Volte a exportar para alterar o tamanho da imagem ou do lote. -
Calibração sem
data: uma exportaçãoquantize=8de um modelo de detecção registaINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.e calibra com esse pequeno conjunto de dados; as outras tarefas especificam o respetivo conjunto de dados predefinido. Passedatacom imagens representativas dos dados de implementação. -
Tamanho da calibração: a exportação regista
>300 images recommended for INT8 calibration, found 4 images.quando a divisão de calibração tem menos de 300 imagens.coco8.yamltem apenas 4 imagens de validação, o que é suficiente para testar a exportação, mas não para calibrar um modelo para implementação. -
Diretório de saída: cada exportação do mesmo checkpoint grava no mesmo diretório
yolo26n_rknn_model/, independentemente dename,quantize,imgszoubatch, e elimina primeiro o conteúdo anterior. Mude o nome do diretório antes de exportar para um segundo chip ou uma segunda precisão e mantenha_rknn_modelno nome, por exemployolo26n_rk3566_rknn_model/, pois a Ultralytics identifica o formato por esse nome. -
opset do ONNX: um
opsetsuperior a 19 registrarknn-toolkit2 requires opset<=19, setting opset=19. -
Modelos INT8 de versões anteriores: exporta novamente os modelos de detecção, segmentação, pose e OBB INT8 exportados antes de
ultralytics8.4.191, versão que adicionoutail.onnx. Esses modelos retornam coordenadas de caixas e pontos-chave relativas ao tamanho da entrada, que as versões atuais já não redimensionam; por isso, são carregados sem erro, mas retornam caixas incorretas. -
Incompatibilidade de versão do runtime: se o log no dispositivo indicar que a versão do runtime RKNN não corresponde à versão do RKNN Toolkit e a inferência falhar, substitui
/usr/lib/librknnrt.sopelo arquivo oficiallibrknnrt.so.
Para outros erros, consulte o guia de problemas comuns.
Benchmarks#
Os benchmarks do YOLO26 abaixo foram executados pela equipe da Ultralytics no Radxa Rock 5B, baseado no Rockchip RK3588, usando o formato de modelo rknn para medir velocidade e precisão.
| Modelo | Formato | Precisão | Status | Tamanho (MB) | mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | rknn | FP16 | ✅ | 7.2 | 0.477 | 58.5 |
| YOLO26n | rknn | INT8 | ✅ | 4.1 | 0.463 | 41.2 |
| YOLO26s | rknn | FP16 | ✅ | 21.0 | 0.569 | 93.8 |
| YOLO26s | rknn | INT8 | ✅ | 12.0 | 0.554 | 61.9 |
| YOLO26m | rknn | FP16 | ✅ | 43.0 | 0.608 | 226.3 |
| YOLO26m | rknn | INT8 | ✅ | 22.0 | 0.603 | 122.0 |
| YOLO26l | rknn | FP16 | ✅ | 53.0 | 0.628 | 264.7 |
| YOLO26l | rknn | INT8 | ✅ | 28.0 | 0.617 | 145.3 |
| YOLO26x | rknn | FP16 | ✅ | 113.0 | 0.664 | 655.4 |
| YOLO26x | rknn | INT8 | ✅ | 58.0 | 0.649 | 287.4 |
Benchmark executado com ultralytics 8.4.60
A validação dos benchmarks acima foi feita com o conjunto de dados COCO128. O tempo de inferência não inclui o pré-processamento nem o pós-processamento. As linhas INT8 serão atualizadas quando o caminho de exportação INT8 atual (decodificação no host e auto_hybrid) for validado no hardware Rockchip.
Os tamanhos da tabela foram registrados com essa versão anterior; os tamanhos indicados no restante desta página correspondem ao arquivo .rknn de uma exportação atual, em MB (10^6 bytes). A página do modelo YOLO26 lista a precisão dos checkpoints do PyTorch no conjunto completo de validação do COCO.
Sobre o RKNN#
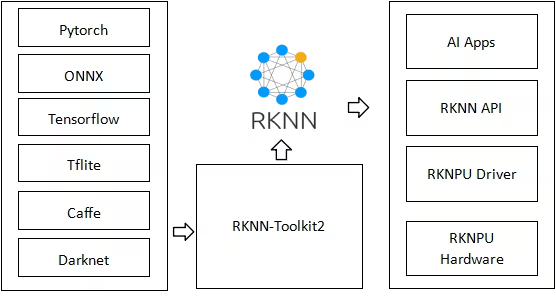
Rockchip projeta sistemas em chip baseados em ARM com NPUs integradas, usados em computadores de placa única e produtos embarcados de empresas como Radxa, ASUS, Pine64, Orange Pi, Odroid, Khadas e Banana Pi. RKNN, abreviação de Rede Neural Rockchip, é o formato de modelo dessas NPUs, e o RKNN Toolkit converte modelos para esse formato em um PC e os executa no dispositivo.
Perguntas frequentes#
Usa o nome do processador da placa, não o nome da placa:
rk3588para uma Radxa Rock 5B, por exemplo, ourk3566para uma Radxa Zero 3W. Na placa,cat /proc/device-tree/compatibleimprime a string que a Ultralytics usa para identificar o chip. Um modelo exportado para um chip não funciona em outro; por isso, exporta uma vez para cada chip. Consulta Chips de destino para ver os nomes aceitos.Começa com FP16, que é o padrão. Não requer dados de calibração e retorna as previsões brutas sem usar um segundo modelo na CPU. Escolhe INT8 (
quantize=8) quando precisares de um modelo menor e mais rápido ou quando o chip só aceita INT8: o YOLO26n para o RK3588 tem 4.3 MB em INT8, contra 7.4 MB em FP16, e, nos benchmarks, medidos com uma exportação anterior, o INT8 executou o YOLO26n em 41.2 ms por imagem, contra 58.5 ms em FP16. INT8 requer dados de calibração representativos e, nos modelos de detecção, segmentação, pose e OBB, executa a descodificação das caixas na CPU comtail.onnx. Mede a latência e a precisão no teu dispositivo antes de escolheres.Não com
YOLO(), que carrega modelos RKNN apenas em dispositivos Rockchip. Para verificar o próprio modelo no PC, valida o checkpoint do PyTorch ou o arquivo intermediárioyolo26n.onnxque a exportação deixa junto ao diretório, usando o ONNX Runtime: o modelo RKNN é convertido a partir desse grafo. Isso não substitui a validação no dispositivo, principalmente para INT8, porque a quantização altera as saídas.Sim, usando o formato de exportação de cada acelerador: um modelo RKNN só funciona em NPUs Rockchip. Consulta TensorRT para NVIDIA Jetson, Hailo, Axelera, DeepX e Coral Edge TPU, ou o guia de opções de implantação de modelos para uma visão geral.


Comentários45
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
as-jackson
We are pleased to confirm that the following ArmSoM boards based on Rockchip RK3576 have been successfully tested with Ultralytics projects (e.g., YOLO11n):
Validation Scope:
Model training/inference pipeline
1yizi72
I tried to convert the yolo11n.pt into a rknn model through codes below: from ultralytics import YOLO model = YOLO("yolo11n.pt") model.export(format="rknn", name="rk3588") and everything went correct. A rknn model named yolo11n-rk3588.rknn was build and used to infer a very traditional yolo demo image "bus"(a blue bus with several people in front of it), but no detection result was obtained.
I tried to convert the yolol11n.pt into onnx model through above codes firstly, and then used a convert.py offered by rknn_model_zoo/examples/yolo11/python,
import sys from rknn.api import RKNN
DATASET_PATH = '../../../datasets/COCO/coco_subset_20.txt' DEFAULT_RKNN_PATH = '/home/yizi/model/yolo11/yolodet.rknn' DEFAULT_QUANT = False
def parse_arg(): if len(sys.argv) < 3: print("Usage: python3 {} onnx_model_path [platform] [dtype(optional)] [output_rknn_path(optional)]".format(sys.argv[0])) print(" platform choose from [rk3562,rk3566,rk3568,rk3588,rk3576,rk1808,rv1109,rv1126]") print(" dtype choose from [i8, fp] for [rk3562,rk3566,rk3568,rk3588,rk3576]") print(" dtype choose from [u8, fp] for [rk1808,rv1109,rv1126]") exit(1)
model_path = sys.argv[1]
platform = sys.argv[2]

do_quant = DEFAULT_QUANT
if len(sys.argv) > 3:
    model_type = sys.argv[3]
    if model_type not in ['i8', 'u8', 'fp']:
        print("ERROR: Invalid model type: {}".format(model_type))
        exit(1)
    elif model_type in ['i8', 'u8']:
        do_quant = True
    else:
        do_quant = False

if len(sys.argv) > 4:
    output_path = sys.argv[4]
else:
    output_path = DEFAULT_RKNN_PATH

return model_path, platform, do_quant, output_path
if name == 'main': model_path, platform, do_quant, output_path = parse_arg()
# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform=platform)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path)
if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=do_quant, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')

# Release
rknn.release()
Still everything went correct. A rknn model was created and applied to "bus.jpg", and there was no detection at all. I wonder what's wrong in the whole process?
1 Glenn JocherUltralytics
@yizi72 thanks for the detailed report. For RKNN inference issues with YOLO11, please ensure:
- You're using matching RKNN Toolkit and runtime versions (update both if needed)
- Input images are 640x640 with pixel values normalized 0-255
- You load models via
YOLO('./yolo11n_rknn_model')as shown in our RKNN deployment docs
If issues persist, please share your full environment details and validation results from both export methods.
1、I used rknn-toolkit2-2.3.0 which is the latest version ,bu I still did "pip install rknn-toolkit2 --upgrade" again. 2、The input image is 640*640, uchar, 0-255. 3. I used the following setting to transfer yolo11n.pt to onnx, from ultralytics import YOLO
加载一个模型,路径为 YOLO 模型的 .pt 文件
model = YOLO("yolo11n.pt")
导出模型,设置多种参数
model.export( format="onnx", imgsz=(640, 640),
keras=False,
optimize=True,
half=False,
int8=False,
dynamic=False,
simplify=True,
opset=12,
#workspace=4.0,
nms=False,
batch=1
) and applied the following codes to verify yolo11n.onnx model:from ultralytics import YOLO from PIL import Image
Load a model
model = YOLO("/home/yizi/models/yolo11/yolo11n.onnx") # load an official model
Predict with the model
results = model("bus.jpg") # predict on an image #results = rknn_model("bus.jpg")
Access the results
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf # confidence score of each box
The results are good. All objects in bus.jpg were detected. Then I run the following code to transfer onnx to rknn:
from rknn.api import RKNN import cv2 import numpy as np
if name == 'main': rknn = RKNN(verbose=True,verbose_file="log.txt") rknn.config( mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform="rk3588", optimization_level=3 )
rknn.load_onnx(
    model="/home/yizi/models/yolo11/yolo11n.onnx",
    input_size_list=[[1,3,640,640]],
)
rknn.build(
    do_quantization=False
)

rknn.export_rknn(
    export_path="/home/yizi/models/yolo11/yolo11n.rknn"
)

rknn.release()
The transferring process went smooth, two problems appeared.
Firstly,when this rknn model was pushed into a rk3588 tablet, and run with a binary executable file generated by cross-compilation, no result was detected.
Secondly, I tried to run the following codes:
from ultralytics import YOLO from PIL import Image
rknn_model = YOLO("/home/yizi/models/yolo11/yolo11n.rknn", task=detect)
results = model("bus.jpg")
An error message, "model='/home/yizi/models/yolo11/yolo11n.rknn' is not a supported model format. Ultralytics supports: ('PyTorch', 'TorchScript', 'ONNX', 'OpenVINO', 'TensorRT', 'CoreML', 'TensorFlow SavedModel', 'TensorFlow GraphDef', 'TensorFlow Lite', 'TensorFlow Edge TPU', 'TensorFlow.js', 'PaddlePaddle', 'MNN', 'NCNN', 'IMX', 'RKNN') See https://docs.ultralytics.com/modes/predict for help. " appeared.
Last question, how many outputs does yolo11 yield? one or six?
- Glenn JocherUltralytics
@yizi72 thank you for the detailed report. For RKNN deployment issues:
- When using Ultralytics RKNN export, load models via the exported directory (not .rknn file), as shown in our RKNN deployment docs:
model = YOLO('./yolo11n_rknn_model') # directory path-
Ensure your RK3588 runtime uses matching librknnrt.so versions with your RKNN Toolkit 2.3.0 installation
-
YOLO11 detection models output 3 tensors by default (different from older YOLO versions). For conversion issues, we recommend using our native
model.export(format='rknn')rather than manual ONNX conversion.
Let me know if you still face issues after verifying these points.
Thanks for replies. I did verify all points you've mentioned above. When running model("bus.jpg"), error messages show:
File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 182, in call return self.predict(source, stream, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 543, in predict self.predictor.setup_model(model=self.model, verbose=is_cli) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/predictor.py", line 378, in setup_model self.model = AutoBackend( File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/torch/utils/_contextlib.py", line 116, in decorate_context return func(*args, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/nn/autobackend.py", line 495, in init raise OSError("RKNN inference is only supported on Rockchip devices.") OSError: RKNN inference is only supported on Rockchip devices.
It's very strange because I did connect a RK3588 tablet with my virtual machine.
I still have a quesiton on yolo11n output: yolo11n.pt has one output with shape (1, 84, 8400), and yolo11n-rk3588.rknn has one output with shape (1,84, 8400, 0). Are they correct? If so, can I use the similar codes to analyze rknn output, such as :
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf
- Glenn JocherUltralytics
@yizi72 thanks for the details. For the RKNN inference error: ensure your Python script is running directly on the RK3588 hardware (not through a VM) as RKNN models require native Rockchip NPU access. Regarding outputs, YOLO11 detection models produce 3 output tensors by default (see our RKNN deployment docs), but your code should work if using the exported RKNN directory with the included postprocessing. Let me know if you still face issues after verifying native hardware execution.
 Yufeng Wu
Hello, Ultralytics team. I wonder if it's possible to port yolo26n-pose to rknn? I'm not sure if it's difficult to work out on my own? Is there any model architecture problems that prevent porting the pose models to rknn?
- Glenn JocherUltralytics
@kamosmkey exports fine. See https://platform.ultralytics.com/glenn-jocher/example-project/exp-24?tab=export
2
montemadjo
It appears it does not support rv1106 platform yet
When I try to export the model using this command
model.export(format="rknn", name="rv1106", imgsz=320)It gives the following error
E build: Current target_platform(rv1106) not support do_quantization = False!
E export_rknn: RKNN model does not exist, please load & build model first!
🤔
- Glenn JocherUltralytics(editado)
rv1106is an INT8-only target, so it needs a quantized RKNN build. Older Ultralytics releases always built withdo_quantization=False, which fails with the message you saw. Current releases support it: upgrade withpip install -U ultralyticsand export withquantize=8plus calibration data:model.export(format="rknn", name="rv1106", imgsz=320, quantize=8, data="coco8.yaml")See the Rockchip RKNN export guide. If it still fails, share your
!yolo checksoutput andrknn-toolkit2version here and we can sanity-check the environment.1 Here's the quick workaround for those who want to work with yolo26 on RV1106 chip (like Luckfox pico etc). I ran into a couple of issues there, including quantization erasing my confidence results.
Long story short - first you need to monkey-patch head.Detect.forward function in order to get two tensors - one for bboxes and one for scores. That way you escape all the heavy non-supported tensor functions. Then you export your yolo26 model to onnx format and finally to rknn like this
import torch
from ultralytics.nn.modules import head

# 1. First we monkey-patch the forward function
def patched_forward(self, x):
    if self.end2end:
        h = self.one2one
    else:
        h = self.one2many

    box_head = h["box_head"]
    cls_head = h["cls_head"]

    if box_head is None or cls_head is None:
        raise RuntimeError("Head moduls are None")

    bs = x[0].shape[0]
    boxes = torch.cat([box_head[i](x[i]).view(bs, 4 * self.reg_max, -1) for i in range(self.nl)], dim=-1)
    scores = torch.cat([cls_head[i](x[i]).view(bs, self.nc, -1) for i in range(self.nl)], dim=-1)

    preds = {"boxes": boxes, "scores": scores, "feats": x}
    y = self._inference(preds)

    # We are splitting into 2 tensors - both gets its own scale/zp at INT8 quantization
    bboxes = y[:, :4, :]   # [1, 4, 2100] — range 0-640
    scores = y[:, 4:, :]   # [1, 1, 2100] — range 0-1 (already sigmoid-ed)
    score_max_idx = scores[0, 0, :].argmax()
    return bboxes, scores

head.Detect.forward = patched_forward

# 2. Then we export to onnx model (we got best.pt model from ultralytics platform)
from ultralytics import YOLO
model = YOLO("best.pt")
model.export(format="onnx", dynamic=False, opset=12, imgsz=320)

# 3. Then we export to RKNN format
from rknn.api import RKNN

rknn = RKNN()

# 3.1. Konfiguracija specifična za RV1106
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform='rv1106',
    quantized_algorithm='normal', # Ili 'mmse' za bolju preciznost
    quantized_dtype='asymmetric_quantized-8'
)

# 3.2. Load the ONNX model
print("Loading ONNX model...")
rknn.load_onnx(model='best.onnx')

# 3.3. Build modela sa INT8 kvantizacijom
# calib.txt should contain paths to calibration images
print("Building RKNN model with quantization...")
rknn.build(do_quantization=True, dataset='./calib.txt')

# 3.4. Exporting final .rknn file
print("Exporting RKNN model...")
rknn.export_rknn('./yolo26_rv1106_model_optimized.rknn')

rknn.release()
After this you need to postprocess those two outputs like this
yolo26_postprocess.h
/**
 * YOLO26 Post-processing header for Fish Counter
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#ifndef _YOLO26_POSTPROCESS_H_
#define _YOLO26_POSTPROCESS_H_

#include <stdint.h>
#include <vector>
#include "rknn_api.h"
#include "rknn_detector.h"

// YOLO26 model configuration defaults
#define YOLO26_CONF_THRESHOLD 0.25f
#define YOLO26_NMS_THRESHOLD 0.45f

// Detection result (same structure as postprocess.h for compatibility)
typedef struct
{
    float x1, y1, x2, y2; // Bounding box (in model coordinates)
    float confidence;
    int class_id;
} yolo26_detection_t;

// YOLO26 context for format detection and caching
typedef struct
{
    int num_predictions;
    int num_classes;
    bool boxes_transposed; // true = [1, 4, N], false = [1, N, 4]
} yolo26_context_t;

/**
 * Initialize YOLO26 post-processing
 * Detects the output format from model attributes
 *
 * @param app_ctx The RKNN app context with model info
 * @param yolo26_ctx Output: YOLO26 context for format info
 * @return 0 on success, -1 on error
 */
int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx);

/**
 * Deinitialize YOLO26 post-processing
 */
void yolo26_deinit_postprocess();

/**
 * YOLO26 post_process: processes model outputs and returns detections
 * Uses 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * @param app_ctx The RKNN app context
 * @param yolo26_ctx YOLO26 context from init
 * @param outputs Pointer to output tensor memory array
 * @param letter_box Letterbox transform info for coordinate mapping
 * @param conf_threshold Confidence threshold
 * @param nms_threshold NMS threshold
 * @param od_results Output: detection results (compatible with existing code)
 * @return 0 on success, -1 on error
 */
int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results);

#endif // _YOLO26_POSTPROCESS_H_
yolo26_postprocess.cc
/**
 * YOLO26 Post-processing for Fish Counter on RV1106
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#include "yolo26_postprocess.h"

#include <math.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <algorithm>
#include <vector>

// Clamp value to range
inline static int clamp(float val, int min, int max)
{
    return val > min ? (val < max ? val : max) : min;
}

// Dequantize INT8 to float
static inline float dequantize(int8_t qnt, int32_t zp, float scale)
{
    return ((float)qnt - (float)zp) * scale;
}

// Sigmoid function
static inline float sigmoid(float x)
{
    return 1.0f / (1.0f + expf(-x));
}

// Calculate IoU between two boxes
static float calculate_iou(float x1_a, float y1_a, float x2_a, float y2_a,
                           float x1_b, float y1_b, float x2_b, float y2_b)
{
    float x1 = std::max(x1_a, x1_b);
    float y1 = std::max(y1_a, y1_b);
    float x2 = std::min(x2_a, x2_b);
    float y2 = std::min(y2_a, y2_b);

    float inter_w = std::max(0.0f, x2 - x1);
    float inter_h = std::max(0.0f, y2 - y1);
    float inter_area = inter_w * inter_h;

    float area_a = (x2_a - x1_a) * (y2_a - y1_a);
    float area_b = (x2_b - x1_b) * (y2_b - y1_b);
    float union_area = area_a + area_b - inter_area;

    return union_area > 0 ? inter_area / union_area : 0;
}

// Non-Maximum Suppression for YOLO26 detections
static std::vector<yolo26_detection_t> yolo26_nms(std::vector<yolo26_detection_t> &detections, float nms_threshold)
{
    // Sort by confidence (descending)
    std::sort(detections.begin(), detections.end(),
              [](const yolo26_detection_t &a, const yolo26_detection_t &b)
              { return a.confidence > b.confidence; });

    std::vector<yolo26_detection_t> result;
    std::vector<bool> suppressed(detections.size(), false);

    for (size_t i = 0; i < detections.size(); i++)
    {
        if (suppressed[i])
            continue;

        result.push_back(detections[i]);

        for (size_t j = i + 1; j < detections.size(); j++)
        {
            if (suppressed[j])
                continue;

            // Only suppress same class
            if (detections[i].class_id != detections[j].class_id)
                continue;

            float iou = calculate_iou(
                detections[i].x1, detections[i].y1, detections[i].x2, detections[i].y2,
                detections[j].x1, detections[j].y1, detections[j].x2, detections[j].y2);

            if (iou > nms_threshold)
            {
                suppressed[j] = true;
            }
        }
    }

    return result;
}

// Parse YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
static std::vector<yolo26_detection_t> parse_yolo26_2output(
    rknn_tensor_mem **output_mems,
    rknn_tensor_attr *output_attrs,
    int model_width, int model_height,
    float conf_threshold, int num_classes,
    bool boxes_transposed)
{
    std::vector<yolo26_detection_t> detections;

    int8_t *boxes_data = (int8_t *)output_mems[0]->virt_addr;
    int32_t boxes_zp = output_attrs[0].zp;
    float boxes_scale = output_attrs[0].scale;

    int8_t *scores_data = (int8_t *)output_mems[1]->virt_addr;
    int32_t scores_zp = output_attrs[1].zp;
    float scores_scale = output_attrs[1].scale;

    // Determine number of anchors
    int num_anchors;
    if (boxes_transposed)
    {
        num_anchors = output_attrs[0].dims[2];
    }
    else
    {
        num_anchors = output_attrs[0].dims[1];
    }

    // Check if scores are already sigmoid or logits
    float scores_min = 9999, scores_max = -9999;
    for (int i = 0; i < (int)output_attrs[1].n_elems; i++)
    {
        float val = dequantize(scores_data[i], scores_zp, scores_scale);
        if (val < scores_min)
            scores_min = val;
        if (val > scores_max)
            scores_max = val;
    }
    bool scores_are_sigmoid = (scores_min >= -0.1f && scores_max <= 1.1f);

    for (int i = 0; i < num_anchors; i++)
    {
        // Get box coordinates
        float x1, y1, x2, y2;
        if (boxes_transposed)
        {
            // [1, 4, N] - channel first
            x1 = dequantize(boxes_data[0 * num_anchors + i], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[1 * num_anchors + i], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[2 * num_anchors + i], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[3 * num_anchors + i], boxes_zp, boxes_scale);
        }
        else
        {
            // [1, N, 4] - anchor first
            x1 = dequantize(boxes_data[i * 4 + 0], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[i * 4 + 1], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[i * 4 + 2], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[i * 4 + 3], boxes_zp, boxes_scale);
        }

        // Check if format is xywh instead of xyxy
        if (x2 < x1 || y2 < y1)
        {
            // Assume xywh format: convert to xyxy
            float cx = x1, cy = y1, w = x2, h = y2;
            x1 = cx - w / 2.0f;
            y1 = cy - h / 2.0f;
            x2 = cx + w / 2.0f;
            y2 = cy + h / 2.0f;
        }

        // Find max class score
        float max_score = -9999;
        int max_class = 0;
        for (int c = 0; c < num_classes; c++)
        {
            float score;
            if (boxes_transposed)
            {
                // [1, nc, N]
                score = dequantize(scores_data[c * num_anchors + i], scores_zp, scores_scale);
            }
            else
            {
                // [1, N, nc]
                score = dequantize(scores_data[i * num_classes + c], scores_zp, scores_scale);
            }

            if (!scores_are_sigmoid)
            {
                score = sigmoid(score);
            }

            if (score > max_score)
            {
                max_score = score;
                max_class = c;
            }
        }

        if (max_score < conf_threshold)
            continue;

        // Clamp to model bounds
        x1 = std::max(0.0f, std::min(x1, (float)model_width));
        y1 = std::max(0.0f, std::min(y1, (float)model_height));
        x2 = std::max(0.0f, std::min(x2, (float)model_width));
        y2 = std::max(0.0f, std::min(y2, (float)model_height));

        // Skip invalid boxes
        if (x2 <= x1 || y2 <= y1)
            continue;

        yolo26_detection_t det;
        det.x1 = x1;
        det.y1 = y1;
        det.x2 = x2;
        det.y2 = y2;
        det.confidence = max_score;
        det.class_id = max_class;

        detections.push_back(det);
    }

    return detections;
}

int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx)
{
    if (!app_ctx || !yolo26_ctx)
    {
        printf("[YOLO26] ERROR: Invalid parameters\n");
        return -1;
    }

    memset(yolo26_ctx, 0, sizeof(yolo26_context_t));

    int n_output = app_ctx->io_num.n_output;

    printf("[YOLO26] Initializing 2-output format (%d outputs)...\n", n_output);

    // Print output tensor info
    for (int i = 0; i < n_output; i++)
    {
        printf("  Output %d: dims=[%d,%d,%d,%d], size=%d\n", i,
               app_ctx->output_attrs[i].dims[0],
               app_ctx->output_attrs[i].dims[1],
               app_ctx->output_attrs[i].dims[2],
               app_ctx->output_attrs[i].dims[3],
               app_ctx->output_attrs[i].size);
    }

    if (n_output != 2)
    {
        printf("[YOLO26] ERROR: Expected 2 outputs (boxes + scores), got %d\n", n_output);
        return -1;
    }

    // Parse 2-output format: boxes + scores
    int boxes_dim1 = app_ctx->output_attrs[0].dims[1];
    int boxes_dim2 = app_ctx->output_attrs[0].dims[2];
    int scores_dim1 = app_ctx->output_attrs[1].dims[1];
    int scores_dim2 = app_ctx->output_attrs[1].dims[2];

    if (boxes_dim1 == 4)
    {
        // [1, 4, N] boxes format
        yolo26_ctx->num_predictions = boxes_dim2;
        yolo26_ctx->boxes_transposed = true;
        yolo26_ctx->num_classes = scores_dim1;
        printf("[YOLO26] Format: boxes [1,4,%d], scores [1,%d,%d]\n",
               boxes_dim2, scores_dim1, scores_dim2);
    }
    else if (boxes_dim2 == 4)
    {
        // [1, N, 4] boxes format
        yolo26_ctx->num_predictions = boxes_dim1;
        yolo26_ctx->boxes_transposed = false;
        yolo26_ctx->num_classes = scores_dim2;
        printf("[YOLO26] Format: boxes [1,%d,4], scores [1,%d,%d]\n",
               boxes_dim1, scores_dim1, scores_dim2);
    }
    else
    {
        printf("[YOLO26] ERROR: Invalid boxes dimensions [1,%d,%d], expected [1,4,N] or [1,N,4]\n",
               boxes_dim1, boxes_dim2);
        return -1;
    }

    printf("[YOLO26] Predictions: %d, Classes: %d\n",
           yolo26_ctx->num_predictions, yolo26_ctx->num_classes);

    return 0;
}

void yolo26_deinit_postprocess()
{
    // Nothing to cleanup currently
}

int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results)
{
    if (!app_ctx || !yolo26_ctx || !outputs || !letter_box || !od_results)
    {
        return -1;
    }

    rknn_tensor_mem **output_mems = (rknn_tensor_mem **)outputs;

    int model_width = app_ctx->model_width;
    int model_height = app_ctx->model_height;

    // Parse 2-output format
    std::vector<yolo26_detection_t> raw_detections = parse_yolo26_2output(
        output_mems,
        app_ctx->output_attrs,
        model_width, model_height,
        conf_threshold,
        yolo26_ctx->num_classes > 0 ? yolo26_ctx->num_classes : 1,
        yolo26_ctx->boxes_transposed);

    // Apply NMS
    std::vector<yolo26_detection_t> final_detections = yolo26_nms(raw_detections, nms_threshold);

    // Convert to output format with letterbox coordinate mapping
    memset(od_results, 0, sizeof(object_detect_result_list));
    int count = 0;

    for (const auto &det : final_detections)
    {
        if (count >= OBJ_NUMB_MAX_SIZE)
            break;

        // Map coordinates back to original image space
        float x1 = det.x1 - letter_box->x_pad;
        float y1 = det.y1 - letter_box->y_pad;
        float x2 = det.x2 - letter_box->x_pad;
        float y2 = det.y2 - letter_box->y_pad;

        // Scale back to original coordinates
        od_results->results[count].box.left = (int)(clamp(x1, 0, model_width) / letter_box->scale);
        od_results->results[count].box.top = (int)(clamp(y1, 0, model_height) / letter_box->scale);
        od_results->results[count].box.right = (int)(clamp(x2, 0, model_width) / letter_box->scale);
        od_results->results[count].box.bottom = (int)(clamp(y2, 0, model_height) / letter_box->scale);
        od_results->results[count].prop = det.confidence;
        od_results->results[count].cls_id = det.class_id;

        count++;
    }

    od_results->count = count;

    return 0;
}
And you're good to go! 🚀
- Glenn JocherUltralytics(editado)
Thanks for sharing this—splitting the head into 2 outputs (boxes + scores) is a sensible RV1106 workaround to keep RKNN-friendly ops and avoid INT8 scale/zero-point coupling issues; just note that monkey-patching
head.Detect.forwardis inherently version-fragile. Current Ultralytics already provides an INT8 flow for RV1106 viaquantize=8withdata=calibration images (see the Rockchip RKNN export guide), so please try that first. If you still need your custom split, open a GitHub issue linking back to this thread and include!yolo checks, yourrknn-toolkit2version, and a minimal calibration set description so we can evaluate it.
dttvn0010
99ms per image is too bad. Using rknn native with 3 npu cores, I can achieve ~11ms per image
NikolayKash
Hi, what did you done to achieve this performance?
- Glenn JocherUltralytics
@Arshapjoy thanks for the detailed info; for YOLO11 detection heads the export output shape is
(1, nc + 4, 8400)(4 box coords plusncclass scores), so with 2 classes(1, 6, 8400)is expected and both classes are present, whereas a postprocessor assuming5 + nc(old YOLO layout with an extra objectness channel) will effectively drop one class. I’d suggest updating your RKNN-side decoder to treat channels[0:4]as[x, y, w, h]and[4:]as class logits for allncclasses; if you still see a true(1, 7, 8400)PyTorch output on the same checkpoint, please share yourultralyticsversion andyolo checksoutput so we can dig deeper. The overall YOLO11 head behaviour is also outlined in the YOLO11 model documentation.@BakhtiariB the high-level
YOLO("./yolo11n_rknn_model")interface is designed to keep preprocessing, NPU inference and postprocessing together, so if you need to run only the core RKNN inference on the NPU while fully controlling pre/post on the CPU you’ll need to load the exported.rknnwith Rockchip’sRKNNAPI directly and implement your own preprocessing and YOLO11 postprocessing around it.@dttvn0010 the ~99 ms figure is a conservative end-to-end pipeline measurement on our RK3588 test setup, so seeing ~11 ms from a highly tuned RKNN deployment using all three NPU cores is quite reasonable; if you are open to sharing your exact model variant, quantization mode, input size and NPU core configuration, we can use that to cross-check and better explain the gap between baseline and fully optimized numbers.
@NikolayKash in practice, large gains like that usually come from combining INT8-quantized RKNN models, all three NPU cores enabled, a suitable input resolution and very lean Python-side pre/postprocessing, so it would be great if @dttvn0010 can share their exact script and RK3588 configuration for others to replicate.
guojieli
he YOLO11 benchmark was run by the Ultralytics team on a Radxa Rock 5B based on the Rockchip RK3588, using the RKNN model format to evaluate speed and accuracy. Could you please clarify whether this was an INT8-quantized model?
- Glenn JocherUltralytics(editado)
Those RKNN benchmarks were not INT8-quantized; they used the floating-point RKNN build. INT8 RKNN export is now available with
quantize=8anddata=for calibration; see the Rockchip RKNN export guide.
BakhtiariB
I used ultralytics for rk3588 by below code, but i want do inference in NPU and do preprocess and postprocess in CPU, how can separate them. while, in below code, line: "results = rknn_model("https://ultralytics.com/images/bus.jpg")" just all of them!
from ultralytics import YOLO
Load the exported RKNN model
rknn_model = YOLO("./yolo11n_rknn_model")
Run inference
results = rknn_model("https://ultralytics.com/images/bus.jpg")
Arshapjoy
Exported RKNN/ONNX model only has 1 output class instead of 2
Overview
I’m using Ultralytics YOLOv11s with two custom classes and exporting it to ONNX and RKNN formats. After conversion, inference on the RKNN device only detects a single class, and the output tensor shape is
(1, 6, 8400)instead of the expected(1, 7, 8400). I’ve validated that the source.ptmodel correctly reports 2 classes, but both ONNX and RKNN exports drop one class.
Model Details
- Checkpoint path:
path/to/yolo11s_custom.pt - Number of classes: 2
- Input size: 640×640
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("custom_yolo11s.pt")
Export the model to RKNN format
rknn_path = model.export(format="rknn", name="rk3588") print(f"RKNN model saved to: {rknn_path}")
Actual Behavior
- Received ONNX , RKNN and metadata.yaml after conversion
- Exported ONNX model output shape:
(1, 6, 8400) - Exported RKNN model output shape:
(1, 6, 8400) - Only one class is detected during inference on the RK3588 board.
7. Logs & Metadata
- metadata.yaml generated alongside the RKNN model:
model: name: yolo11s_custom format: rknn input_shape: [1, 3, 640, 640] output_shape: [1, 6, 8400] classes: 2 - ONNX graph info: Attached minimal
onnx.shape_inferencelog shows only 6 channels in the final layer.
8. Additional Notes
- Manual ONNX export yields the same issue, so it’s unlikely to be an Ultralytics export bug alone.
- I’ve confirmed that the PyTorch forward pass on the
.ptcheckpoint produces a shape(1, 7, 8400).
9. Request Could you please:
- Confirm whether there’s an option/flag in the YOLO-Ultralytics or RKNN export pipeline I’m missing to preserve all classes.
- Suggest any workarounds or patches to ensure correct output-channel dimensionality.
- Identify if this might be a known issue in RKNN-Toolkit 1.5.0 or Ultralytics YOLO v11.
Thank you for your assistance!
- Checkpoint path:
WeiIIzz
Hello, when I exported the rknn model, I performed int8 quantization, but I had an error like this: E build: If set do_quantization = True, dataset file need be provided. But it`s value is None! E export_rknn: RKNN model does not exist, please load build model first! My export code is: from ultralytics import YOLO
model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/data.yaml") The path pointed to by data is the same as the training dataset. How to solve it
The content of data.yaml is as follows path: /home/ky/dfxw/split_jiaqian # dataset root dir train: images/train val: images/val
names: 0: 0 1: 1
- Glenn JocherUltralytics(editado)
@WeiIIzz INT8 export for RKNN is supported with
quantize=8(it replaces the deprecatedint8=True) together withdatapointing to a dataset YAML, which Ultralytics converts into the calibration image list that RKNN needs:from ultralytics import YOLO model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", quantize=8, data="/home/ky/rknn_yolo_test/data.yaml")The error you saw comes from an older version that did not pass a calibration dataset to RKNN, so run
pip install -U ultralyticsand retry. Make sure the YAML points to existing images. Let us know if this resolves your issue! @glenn-jocher I followed your steps to modify the code as follows. But I still encountered the same problem.
from ultralytics import YOLO

model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt")
model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/images")
Is there only images in the data path?
- Glenn JocherUltralytics(editado)
@WeiIIzz older releases ignored
int8=Truefor RKNN and built the model without quantization. Current Ultralytics supports INT8 RKNN export, so afterpip install -U ultralyticsyou can export with:model.export(format="rknn", name="rk3576", quantize=8, data="data.yaml")Here
datais used for the calibration images. Withoutquantize, the export builds a floating-point (FP16) model.
VictorAboba
Good day,
Is RKNN available for obb tasks? I tried to use it directly, but got an error saying that some operations (cos) are not available in RKNN. As a fix, RKNN suggested adding disable_rules = ['reduce_reshape_op_around_concat'] to my configuration. I actually did this inside the YOLO library. Model was exported first to ONNX and then from ONNX to RKNN works and returns the responses in the format (1,6,21504), which seems what I expected. However, if I use this model through YOLO ("path_to_rknn_model", task = 'obb'), will I still get the results in the standard YOLO format? I just don't want to prescribe pre - and post-processing on my own :)
Thank you!
- Glenn JocherUltralytics(editado)
@VictorAboba thank you for your question! RKNN export now supports all seven Ultralytics tasks, including OBB, so you can export OBB models directly with
format="rknn"and load the exported_rknn_modeldirectory withYOLO(...)to get standard YOLO results without writing your own pre- and post-processing. See the Rockchip RKNN guide for details. Spidrre
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hello, after @glenn-jocher answer, I didn't attempt to convert the OBB model. We have a few other models, and all of them except YOLO were converted to the RKNN format. We will try using this stuff (YOLO without an NPU and others with it) ^_^ After conversion, the OCR model, for example, has almost the same quality, but it doesn't need 'reduce_reshape_op_around_concat' to be used.