SAM 2: Modelo que Segmenta Tudo 2

O SAM 2, sucessor do Modelo Segment Anything (SAM) da Meta, é um modelo unificado para segmentação de objetos orientada por prompts em imagens e vídeos. A sua arquitetura única e orientada por prompts suporta processamento em tempo real e generalização zero-shot.
Os modelos SAM 2.1 alimentam a funcionalidade de anotação inteligente na plataforma Ultralytics, permitindo a segmentação baseada em cliques para uma rotulagem rápida de conjuntos de dados. Consulta o guia de anotação para mais detalhes.
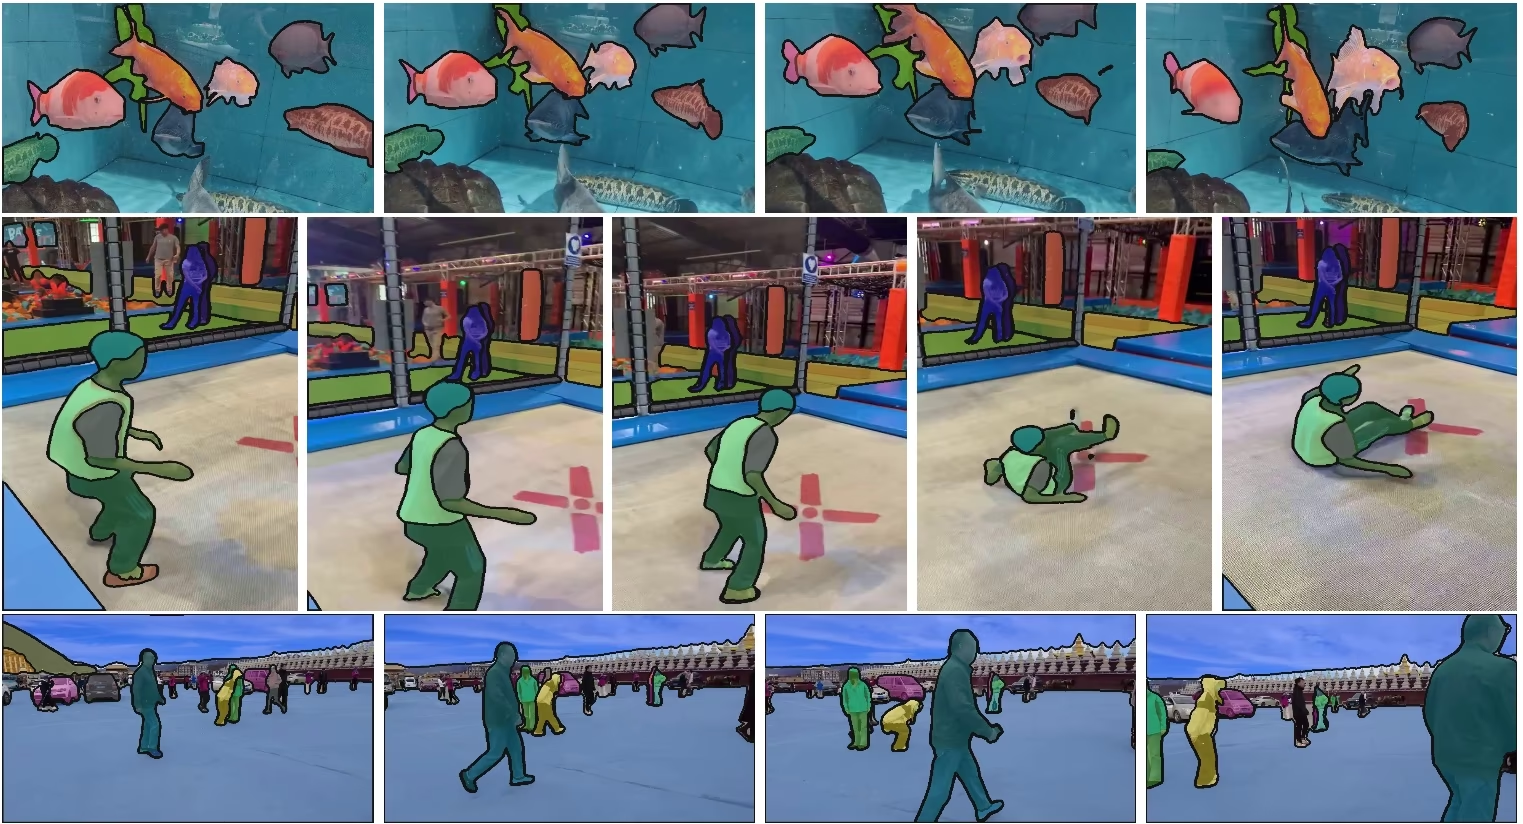
Principais funcionalidades#
Ver: Como executar inferências com o SAM2 da Meta usando Ultralytics | Guia passo a passo
Arquitetura de modelo unificada#
O SAM 2 combina as capacidades de segmentação de imagens e vídeos num único modelo. Esta unificação simplifica a implementação e permite um desempenho consistente em diferentes tipos de conteúdos multimédia. Utiliza uma interface flexível baseada em prompts, que permite aos utilizadores especificar os objetos de interesse através de vários tipos de prompt, como pontos, caixas delimitadoras ou máscaras.
Desempenho em tempo real#
O modelo alcança velocidades de inferência em tempo real, processando aproximadamente 44 fotogramas por segundo. Isto torna o SAM 2 adequado para aplicações que exigem resposta imediata, como edição de vídeo e realidade aumentada.
Generalização zero-shot#
O SAM 2 consegue segmentar objetos que nunca encontrou antes, demonstrando forte capacidade de generalização zero-shot. Isso é particularmente útil em domínios visuais diversos ou em evolução, nos quais categorias predefinidas podem não abranger todos os objetos possíveis.
Refinamento interativo#
Os utilizadores podem aperfeiçoar iterativamente os resultados da segmentação ao fornecer prompts adicionais, o que permite um controlo preciso da saída. Esta interatividade é essencial para aperfeiçoar os resultados em aplicações como a anotação de vídeo ou a imagiologia médica.
Tratamento avançado de desafios visuais#
O SAM 2 inclui mecanismos para gerir desafios comuns da segmentação de vídeo, como a oclusão e o reaparecimento de objetos. Utiliza um mecanismo de memória para acompanhar os objetos ao longo dos fotogramas, garantindo a continuidade mesmo quando os objetos ficam temporariamente ocultos ou saem e voltam a entrar na cena.
Para entender melhor a arquitetura e os recursos do SAM 2, consulta o artigo de pesquisa do SAM 2.
Desempenho e detalhes técnicos#
Segundo a Meta, o SAM 2 supera os modelos anteriores em várias métricas:
| Métrica | SAM 2 | Melhor desempenho de ponta anterior |
|---|---|---|
| Segmentação interativa de vídeos | Melhor | - |
| Interações humanas necessárias | 3x menos | Referência |
| Precisão da segmentação de imagens | Melhorado | SAM |
| Velocidade de inferência | 6x mais rápido | SAM |
Arquitetura do modelo#
Componentes principais#
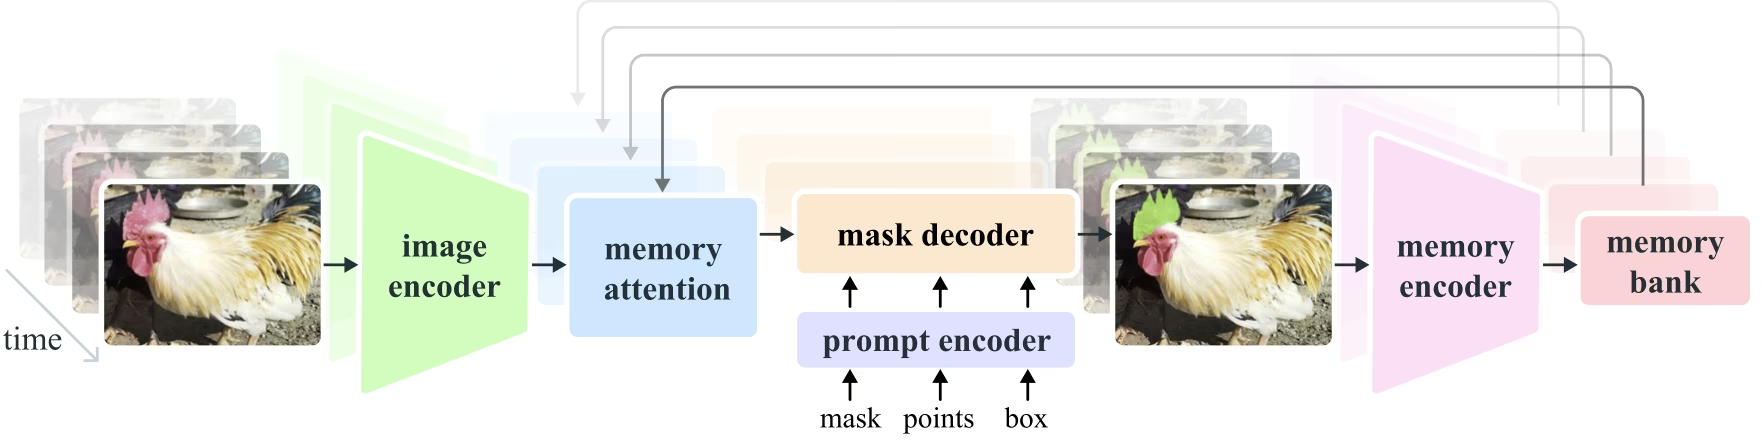
- Codificador de imagens e vídeos: utiliza uma arquitetura baseada em transformer para extrair características de alto nível de imagens e frames de vídeo. Esse componente é responsável por compreender o conteúdo visual em cada instante.
- Codificador de prompts: processa os prompts fornecidos pelo usuário (pontos, caixas, máscaras) para orientar a tarefa de segmentação. Isso permite que o SAM 2 se adapte à entrada do usuário e direcione a segmentação para objetos específicos da cena.
- Mecanismo de memória: Inclui um codificador de memória, um banco de memória e um módulo de atenção de memória. Em conjunto, estes componentes armazenam e utilizam informações de fotogramas anteriores, permitindo ao modelo manter um seguimento de objetos consistente ao longo do tempo.
- Decodificador de máscaras: gera as máscaras de segmentação finais com base nas características codificadas da imagem e nos prompts. Em vídeos, também usa o contexto da memória para garantir o rastreamento preciso entre os frames.
Mecanismo de memória e tratamento de oclusões#
O mecanismo de memória permite que o SAM 2 lide com dependências temporais e oclusões em dados de vídeo. À medida que os objetos se movem e interagem, o SAM 2 registra suas características em um banco de memória. Quando um objeto fica ocluso, o modelo pode recorrer a essa memória para prever sua posição e aparência quando ele reaparecer. O cabeçalho de oclusão trata especificamente de situações em que os objetos não estão visíveis, prevendo a probabilidade de um objeto estar ocluso.
Resolução de ambiguidades com múltiplas máscaras#
Em situações ambíguas (por exemplo, objetos sobrepostos), o SAM 2 pode gerar várias previsões de máscara. Isto ajuda a representar cenas complexas em que uma única máscara pode não captar o objeto pretendido.
Conjunto de dados SA-V#
O conjunto de dados SA-V, desenvolvido para o treinamento do SAM 2, é um dos maiores e mais diversos conjuntos de dados de segmentação de vídeos disponíveis. Ele inclui:
- Mais de 51.000 vídeos: capturados em 47 países, abrangendo uma ampla variedade de cenários do mundo real.
- Mais de 600.000 anotações de máscaras: anotações detalhadas de máscaras espaço-temporais, chamadas de "masklets", que abrangem objetos inteiros e partes deles.
- Dimensão do conjunto de dados: Inclui 4,5 vezes mais vídeos e 53 vezes mais anotações do que os maiores conjuntos de dados de segmentação de vídeo anteriores.
Benchmarks#
Segmentação de objetos em vídeos#
O SAM 2 apresenta os seguintes resultados nas principais avaliações de referência de segmentação de vídeo:
| Conjunto de dados | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Segmentação interativa#
Em tarefas de segmentação interativa, o SAM 2 alcança os seguintes resultados:
| Conjunto de dados | NoC@90 | AUC |
|---|---|---|
| DAVIS Interativo | 1.54 | 0.872 |
Instalação#
O SAM 2 está incluído no pacote ultralytics. Instala-o com o seguinte comando; os pesos do SAM 2 são transferidos automaticamente na primeira utilização.
pip install ultralyticsComo usar o SAM 2: versatilidade na segmentação de imagens e vídeos#
A tabela seguinte detalha os modelos SAM 2 disponíveis, os respetivos pesos pré-treinados, as tarefas suportadas e a compatibilidade com diferentes modos de funcionamento, como treino, validação, inferência e exportação.
| Tipo de modelo | Pesos pré-treinados | Tarefas suportadas | Treinamento | Validação | Inferência | Exportar |
|---|---|---|---|---|---|---|
| SAM 2 tiny | sam2_t.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2 small | sam2_s.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2 large | sam2_l.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 tiny | sam2.1_t.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 small | sam2.1_s.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 large | sam2.1_l.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
Exemplos de predição do SAM 2#
O SAM 2 pode ser utilizado numa vasta gama de tarefas, incluindo edição de vídeo em tempo real, imagiologia médica e sistemas autónomos. A sua capacidade de segmentar dados visuais estáticos e dinâmicos faz dele uma ferramenta versátil para investigadores e programadores.
Segmentar com prompts#
Usa prompts para segmentar objetos específicos em imagens ou vídeos.
from ultralytics import SAM

# Carregar um modelo
model = SAM("sam2.1_b.pt")

# Exibir informações do modelo (opcional)
model.info()

# Executar inferência com prompt de bboxes
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Executar inferência com um único ponto
results = model(points=[900, 370], labels=[1])

# Executar inferência com vários pontos
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Executar inferência com prompt de vários pontos por objeto
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Executar inferência com prompt de pontos negativos
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Segmentar tudo#
Segmenta todo o conteúdo da imagem ou do vídeo sem prompts específicos.
from ultralytics import SAM

# Carregar um modelo
model = SAM("sam2.1_b.pt")

# Exibir informações do modelo (opcional)
model.info()

# Executar inferência
model("path/to/video.mp4")- Este exemplo demonstra como o SAM 2 pode ser usado para segmentar todo o conteúdo de uma imagem ou vídeo quando nenhum prompt (bboxes/pontos/máscaras) é fornecido.
Segmentar vídeo e rastrear objetos#
Segmenta todo o conteúdo do vídeo com prompts específicos e rastreia objetos.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Executar inferência com um único ponto
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Executar inferência com vários pontos
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Executar inferência com prompt de vários pontos por objeto
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Executar inferência com prompt de pontos negativos
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Segmentação e rastreamento interativos dinâmicos#
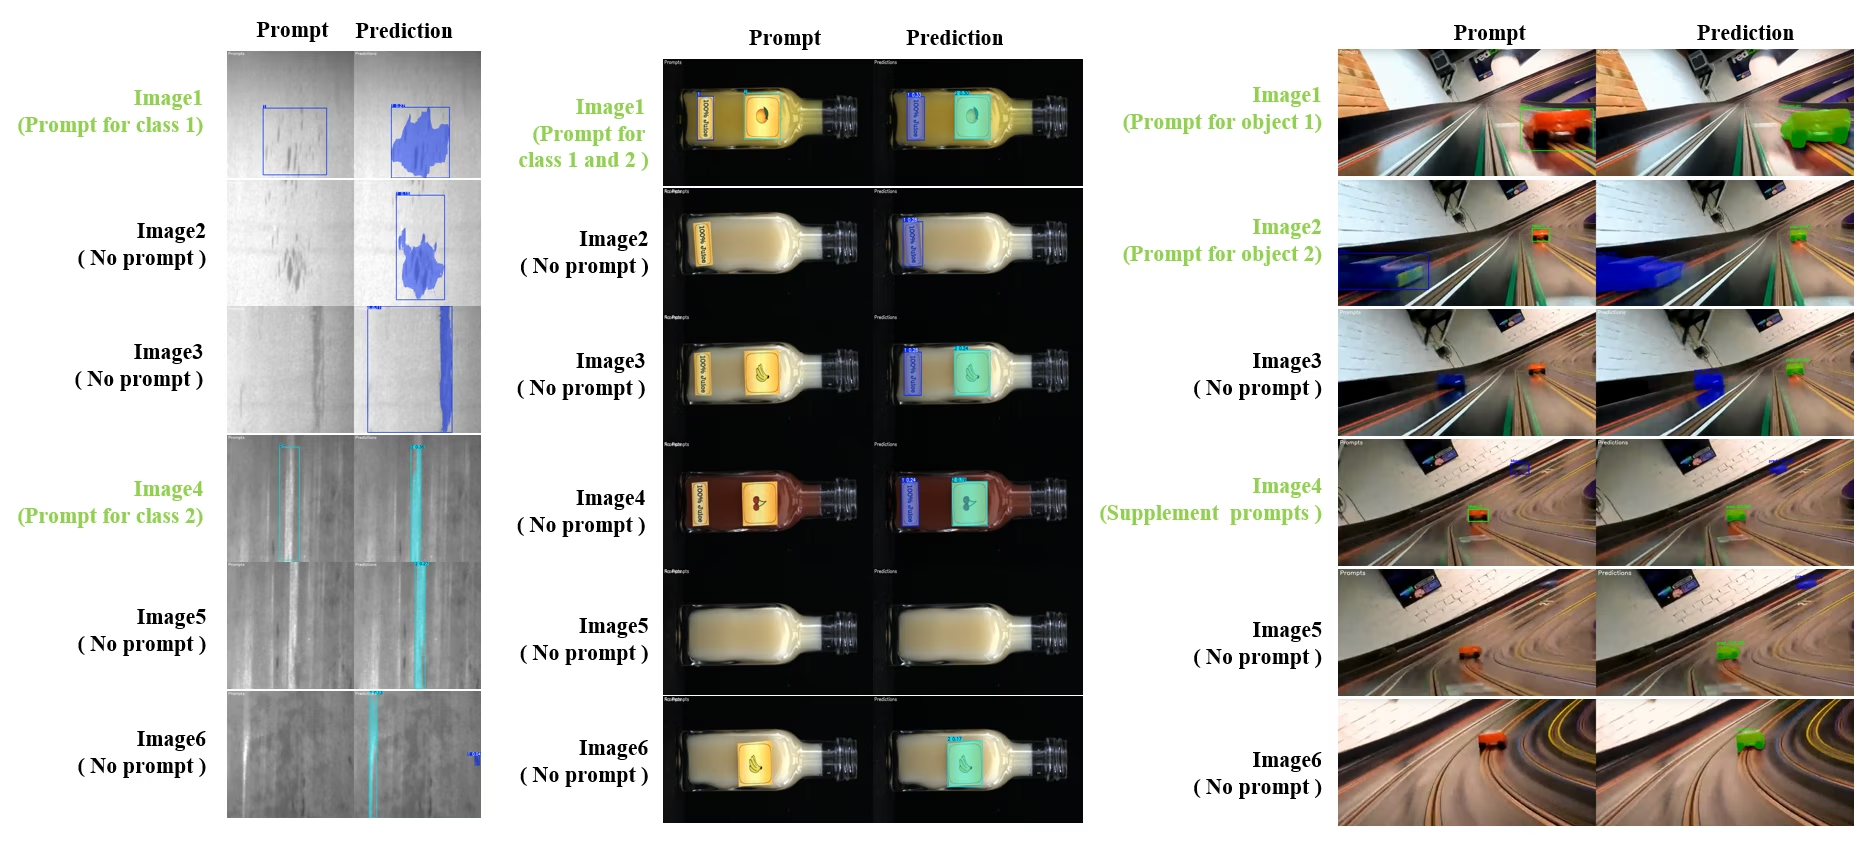
SAM2DynamicInteractivePredictor é uma extensão do SAM 2 que não requer treino e permite interação dinâmica com vários fotogramas e capacidades de aprendizagem contínua. Este preditor suporta atualizações de prompts em tempo real e gestão de memória para melhorar o desempenho do seguimento ao longo de uma sequência de imagens. Em comparação com o SAM 2 original, SAM2DynamicInteractivePredictor reformula o fluxo de inferência para tirar o máximo partido dos modelos SAM 2 pré-treinados sem exigir treino adicional.
Principais funcionalidades#
Oferece três melhorias:
- Interativo e dinâmico: Adiciona prompts para novas instâncias não acompanhadas em fotogramas posteriores, em qualquer altura durante o processamento do vídeo
- Aprendizado contínuo: adiciona novos prompts para instâncias existentes a fim de melhorar o desempenho do modelo ao longo do tempo
- Suporte independente a várias imagens: processa várias imagens independentes (não necessariamente de uma sequência de vídeo) com compartilhamento de memória e rastreamento de objetos entre imagens
Principais recursos#
- Flexibilidade dos prompts: aceita caixas delimitadoras, pontos e máscaras como prompts
- Gerenciamento do banco de memória: mantém um banco de memória dinâmico para armazenar os estados dos objetos entre os frames
- Rastreamento de vários objetos: permite rastrear vários objetos simultaneamente, cada um com seu próprio ID
- Atualizações em tempo real: permite adicionar novos prompts durante a inferência sem reprocessar frames anteriores
- Processamento independente de imagens: processa imagens avulsas com contexto de memória compartilhado para manter a consistência dos objetos entre imagens
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Define uma categoria com um prompt de caixa
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Detecta este objeto específico em uma nova imagem
results = predictor(source="image2.jpg")

# Adiciona uma nova categoria com um novo ID de objeto
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Novo objeto
    obj_ids=[1],  # Novo ID de objeto
    update_memory=True,  # Adicionar à memória
)
# Executar inferência
results = predictor(source="image5.jpg")

# Adicionar prompts de refinamento à mesma categoria para melhorar o desempenho
# Isso ajuda quando a aparência dos objetos muda significativamente
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Ponto de refinamento
    labels=[1],  # Ponto positivo
    obj_ids=[1],  # Mesmo ID de objeto
    update_memory=True,  # Atualizar a memória com novas informações
)
# Executar inferência na nova imagem
results = predictor(source="image7.jpg")O SAM2DynamicInteractivePredictor foi projetado para funcionar com modelos SAM 2 e oferece suporte à adição e ao refinamento de categorias usando todos os prompts de caixa, ponto e máscara compatíveis nativamente com SAM 2. Ele é particularmente útil em cenários nos quais os objetos aparecem ou mudam ao longo do tempo, como na anotação de vídeos ou em tarefas de edição interativa.
Argumentos#
| Nome | Valor padrão | Tipo de dados | Descrição |
|---|---|---|---|
max_obj_num | 3 | int | Número máximo predefinido de categorias |
update_memory | False | bool | Indica se a memória deve ser atualizada com novos prompts |
obj_ids | None | List[int] | Lista de IDs de objetos correspondentes aos prompts |
Casos de uso#
SAM2DynamicInteractivePredictor é ideal para:
- Fluxos de trabalho de anotação de vídeos em que novos objetos aparecem durante a sequência
- Edição interativa de vídeos que exige a adição e o refinamento de objetos em tempo real
- Aplicações de vigilância que precisam de rastreamento dinâmico de objetos
- Imagens médicas para rastrear estruturas anatômicas ao longo de séries temporais
- Sistemas autônomos que exigem detecção e rastreamento adaptativos de objetos
- Conjuntos de dados com várias imagens para segmentação consistente de objetos em imagens independentes
- Análise de coleções de imagens em que os objetos precisam ser rastreados em diferentes cenas
- Segmentação entre domínios que aproveita a memória de diversos contextos de imagem
- Anotação semiautomática para criar conjuntos de dados com eficiência e o mínimo de intervenção manual
Comparação entre SAM e YOLO#
Aqui comparamos os modelos SAM 2 da Meta, incluindo o modelo mais pequeno SAM2-t, com os modelos de segmentação da Ultralytics, incluindo o YOLO26:
| Modelo | Tamanho (MB) | Parâmetros (M) | Velocidade (CPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s com backbone YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0x menor) | 3.4 (11.4x menos) | 24.8 (945x mais rápido) |
| Ultralytics YOLO11n-seg | 6.2 (12.6x menor) | 2.9 (13.4x menos) | 24.3 (964x mais rápido) |
| Ultralytics YOLO26n-seg | 6.7 (11.7x menor) | 2.7 (14.4x menos) | 25.2 (930x mais rápido) |
Esta comparação demonstra as diferenças substanciais entre os tamanhos e as velocidades dos modelos das variantes SAM e dos modelos de segmentação YOLO. Embora o SAM ofereça recursos exclusivos de segmentação automática, os modelos YOLO, especialmente YOLOv8n-seg, YOLO11n-seg e YOLO26n-seg, são significativamente menores, mais rápidos e mais eficientes em termos computacionais.
As velocidades do SAM foram medidas com PyTorch; as velocidades do YOLO, com ONNX Runtime. Os testes foram executados em um Apple M4 Air de 2025 com 16 GB de RAM, usando torch==2.10.0, ultralytics==8.4.31 e onnxruntime==1.24.4. Para reproduzir este teste:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Avalie o desempenho de SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Perfilar FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Avalie o desempenho dos modelos YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Cabeça sem NMS do YOLO26; sem efeito para YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Anotação automática: criação eficiente de conjuntos de dados#
A anotação automática combina o SAM 2 com um modelo de deteção pré-treinado para gerar rapidamente conjuntos de dados de segmentação, sem necessidade de anotação manual extensa. A Ultralytics Platform também oferece anotação automática no navegador com modelos de visão alojados; compara a precisão de deteção, o custo e a velocidade no quadro de classificação de VLM.
Como fazer anotações automáticas com SAM 2#
Assista: Anotação automática com o modelo Segment Anything 2 da Meta usando Ultralytics | Rotulagem de dados
Para anotar automaticamente o teu conjunto de dados com um detetor YOLO26x e o SAM 2, segue este exemplo:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
data | str | obrigatório | Caminho para o diretório que contém as imagens de destino para anotação ou segmentação. |
det_model | str | 'yolo26x.pt' | Caminho para o modelo de detecção YOLO usado na detecção inicial de objetos. |
sam_model | str | 'sam_b.pt' | Caminho para o modelo SAM usado na segmentação (compatível com pesos de SAM, SAM 2, MobileSAM e SAM 3). |
device | str | '' | Dispositivo de computação (por exemplo, 'cuda:0', 'cpu' ou '' para detecção automática do dispositivo). |
conf | float | 0.25 | Limite de confiança para a detecção YOLO, usado para filtrar detecções fracas. |
iou | float | 0.5 | Limite de IoU para a supressão não máxima, usada para filtrar caixas sobrepostas. |
imgsz | int | 640 | Tamanho de entrada para redimensionar as imagens (arredondado para cima até um múltiplo de 32, se necessário). |
max_det | int | 300 | Número máximo de detecções por imagem para economizar memória. |
classes | list[int] | None | Lista de índices de classes a detectar (por exemplo, [0, 1] para pessoa e bicicleta). |
output_dir | str | None | Diretório para salvar as anotações (por padrão: diretório irmão de <data>_auto_annotate_labels). |
Esta função transforma uma pasta de imagens sem rótulos num conjunto de dados de segmentação, com o mínimo de trabalho manual.
Limitações#
Apesar de seus pontos fortes, SAM 2 tem algumas limitações:
- Estabilidade do rastreamento: SAM 2 pode perder o rastro dos objetos durante sequências longas ou mudanças significativas de ponto de vista.
- Confusão entre objetos: às vezes, o modelo pode confundir objetos de aparência semelhante, principalmente em cenas com muitos elementos.
- Eficiência com vários objetos: a eficiência da segmentação diminui ao processar vários objetos simultaneamente, devido à falta de comunicação entre eles.
- Precisão dos detalhes: pode deixar passar detalhes finos, especialmente em objetos que se movem rapidamente. Prompts adicionais podem ajudar parcialmente a resolver esse problema, mas não garantem suavidade temporal.
Citações e agradecimentos#
Se utilizares SAM 2 no teu trabalho de investigação ou desenvolvimento, cita-o com a seguinte referência:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Agradecemos à Meta AI por disponibilizar este modelo e conjunto de dados à comunidade de IA.
Perguntas frequentes#
SAM 2, sucessor do Segment Anything Model (SAM) da Meta, é um modelo unificado e orientável por prompts para segmentação de objetos em imagens e vídeos. SAM 2 oferece várias melhorias em relação ao SAM original, incluindo:
- Arquitetura unificada de modelo: combina recursos de segmentação de imagens e vídeos em um único modelo.
- Desempenho em tempo real: processa aproximadamente 44 quadros por segundo, sendo adequado para aplicações que exigem resposta imediata.
- Generalização de disparo zero: segmenta objetos que nunca encontrou antes, algo útil em diversos domínios visuais.
- Refinamento interativo: permite que os usuários refinem os resultados da segmentação de forma iterativa, fornecendo prompts adicionais.
- Tratamento avançado de desafios visuais: lida com desafios comuns da segmentação de vídeos, como oclusão e reaparecimento de objetos.
Para saber mais sobre a arquitetura e os recursos do SAM 2, consulte o artigo de pesquisa do SAM 2.
SAM 2 permite a segmentação de vídeo em tempo real através da sua interface orientável por prompts e da inferência rápida. Eis um exemplo básico:
Segmentar com promptsUsa prompts para segmentar objetos específicos em imagens ou vídeos.
from ultralytics import SAM

# Carregar um modelo
model = SAM("sam2_b.pt")

# Exibir informações do modelo (opcional)
model.info()

# Segmente usando um prompt de caixa delimitadora
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Segmente usando um prompt de ponto
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Para instruções de uso mais completas, consulte a seção Como usar SAM 2.
O SAM 2 é treinado no conjunto de dados SA-V, um dos maiores e mais diversificados conjuntos de dados de segmentação de vídeo disponíveis. O conjunto de dados SA-V inclui:
- Mais de 51.000 vídeos: capturados em 47 países, abrangendo uma ampla variedade de cenários do mundo real.
- Mais de 600.000 anotações de máscaras: anotações detalhadas de máscaras espaço-temporais, chamadas de "masklets", que abrangem objetos inteiros e partes deles.
- Escala do conjunto de dados: contém 4,5 vezes mais vídeos e 53 vezes mais anotações do que os maiores conjuntos de dados anteriores, oferecendo diversidade e complexidade sem precedentes.
Este conjunto de dados permite que o SAM 2 alcance resultados sólidos nos principais benchmarks de segmentação de vídeo e melhora as suas capacidades de generalização zero-shot.
SAM 2 inclui um mecanismo de memória para gerir dependências temporais e oclusões em dados de vídeo. O mecanismo de memória é composto por:
- Codificador de memória e banco de memória: armazenam recursos de quadros anteriores.
- Módulo de atenção à memória: usa as informações armazenadas para manter o rastreamento consistente dos objetos ao longo do tempo.
- Cabeça de oclusão: lida especificamente com cenários em que os objetos não estão visíveis, prevendo a probabilidade de um objeto estar ocluído.
Esse mecanismo garante a continuidade mesmo quando os objetos ficam temporariamente ocultos ou saem e voltam à cena. Para saber mais, consulte a seção Mecanismo de memória e tratamento de oclusões.
Os modelos SAM 2, como SAM2-t e SAM2-b da Meta, oferecem recursos poderosos de segmentação de disparo zero, mas são significativamente maiores e mais lentos do que os modelos YOLO. Por exemplo, YOLO26n-seg é aproximadamente 24 vezes menor e mais de 1145 vezes mais rápido do que SAM2-b em CPU. Embora SAM 2 se destaque em cenários versáteis de segmentação baseada em prompts e de disparo zero, YOLO26 é otimizado para velocidade, eficiência e aplicações em tempo real com inferência completa sem NMS, sendo mais adequado para implantação em ambientes com recursos limitados.


Comentários150
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(editado)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(editado)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(editado)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(editado)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.