Tarefas de visão computacional compatíveis com Ultralytics YOLO26
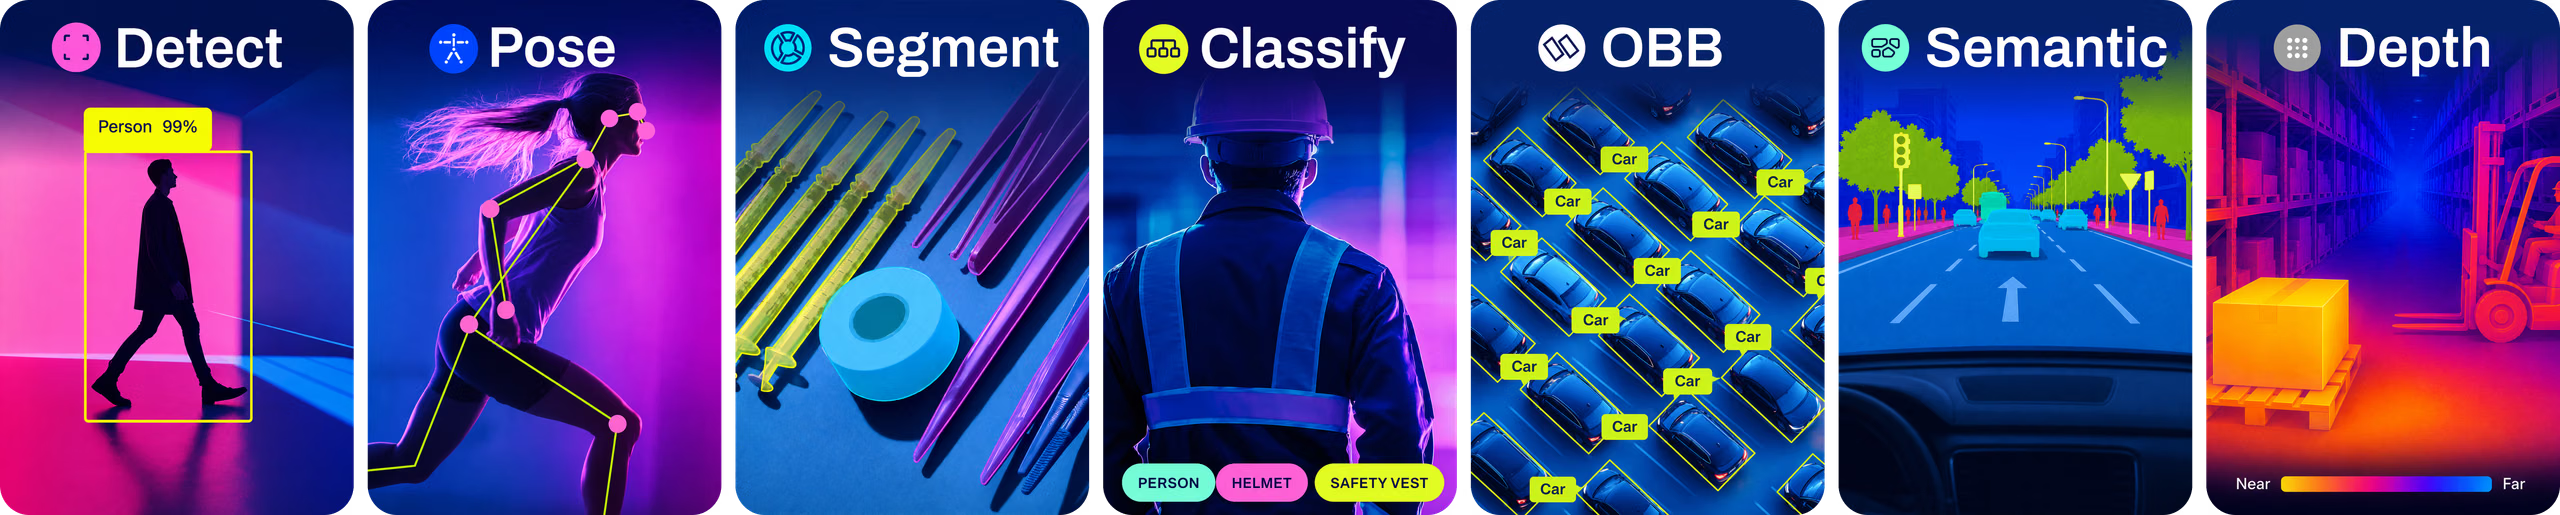
O Ultralytics YOLO26 é compatível com várias tarefas de visão computacional: detecção, segmentação, segmentação semântica, estimativa de profundidade, classificação, estimativa de pose e OBB. Cada tarefa tem um objetivo e caso de uso diferente, para que você possa resolver vários problemas de visão computacional com uma única estrutura.
Para saberes mais sobre o suporte planeado para YOLO27, consulta a pré-visualização do YOLO27. YOLO27 será lançado em breve e ainda não está disponível; este guia utiliza modelos YOLO26 já lançados.
Assista: Explore as tarefas do Ultralytics YOLO26: detecção de objetos, segmentação de instâncias, segmentação semântica, estimativa de profundidade, classificação, estimativa de pose e OBB.
Deteção#
A detecção de objetos é a principal tarefa compatível com YOLO26. Ela consiste em identificar objetos em uma imagem ou quadro de vídeo e desenhar caixas delimitadoras ao redor deles. Os objetos detectados são classificados em diferentes categorias com base em suas características. YOLO26 detecta vários objetos em uma única imagem ou quadro de vídeo com rapidez suficiente para aplicações em tempo real, como sistemas de vigilância e veículos autônomos.
Segmentação de instâncias#
A segmentação de instâncias vai além da detecção de objetos, gerando máscaras em nível de pixel para cada objeto. Essa precisão é útil em aplicações como imagens médicas, análise agrícola e controle de qualidade na fabricação.
Segmentação semântica#
A segmentação semântica atribui um rótulo de classe a cada pixel de uma imagem, gerando um mapa de classes denso de toda a cena. Ao contrário da segmentação de instâncias, ela não diferencia objetos individuais da mesma classe. Isso a torna adequada para condução autônoma, interpretação de cenas e mapeamento da cobertura do solo, quando compreender toda a disposição espacial é mais importante do que identificar objetos individuais.
Exemplos de segmentação semântica
Estimativa de profundidade#
A estimativa monocular de profundidade prevê um mapa de profundidade em metros para cada pixel, usando uma única imagem RGB. A saída é um mapa denso de valores de ponto flutuante alinhado à imagem de entrada, o que a torna adequada para reconstrução de cenas 3D, navegação de robôs e aplicações de AR/VR que precisam inferir a disposição espacial a partir de uma única câmera.
Exemplos de estimativa de profundidade
Classificação#
A classificação de imagens consiste em categorizar imagens inteiras com base em seu conteúdo. Essa tarefa é útil em aplicações como categorização de produtos no comércio eletrônico, moderação de conteúdo e monitoramento da vida selvagem.
Estimativa de pose#
A estimativa de pose detecta pontos-chave específicos em imagens ou quadros de vídeo para rastrear movimentos ou estimar poses. Esses pontos-chave podem representar articulações humanas, características faciais ou outros pontos de interesse importantes. Os modelos de pose YOLO26 detectam pontos-chave em tempo real, o que os torna úteis para aplicações de condicionamento físico, análise esportiva e interação humano-computador.
OBB#
A detecção de caixas delimitadoras orientadas (OBB) aprimora a detecção de objetos tradicional ao adicionar um ângulo de orientação para localizar melhor objetos girados. Esse recurso é especialmente valioso para análise de imagens aéreas, processamento de documentos e aplicações industriais, nas quais os objetos aparecem em vários ângulos. Os modelos OBB do YOLO26 são pré-treinados no conjunto de dados de imagens aéreas DOTAv1.
O que fazer a seguir#
Já escolheste uma tarefa? Formata os teus dados com o guia de conjuntos de dados e, em seguida, treina com as tuas próprias imagens.
Perguntas frequentes#
O Ultralytics YOLO26 é compatível com as seguintes tarefas de visão computacional:
- Deteção de objetos: Identificação e localização de objetos em imagens ou fotogramas de vídeo através do desenho de caixas delimitadoras à sua volta.
- Segmentação de instâncias: Geração de uma máscara ao nível dos píxeis para cada objeto detetado, útil em aplicações como imagiologia médica.
- Segmentação semântica: Atribuição de um rótulo de classe a cada píxel de uma imagem para uma compreensão densa da cena.
- Estimativa de profundidade: Previsão de um mapa de profundidade por píxel, em metros, a partir de uma única imagem RGB.
- Classificação: Categorização de imagens completas com base no seu conteúdo.
- Estimativa de pose: Deteção de pontos-chave específicos numa imagem ou num fotograma de vídeo para acompanhar movimentos ou poses.
- Deteção de objetos orientados (OBB): Deteção de objetos rodados com um ângulo de orientação adicional para maior precisão.
Para usar o Ultralytics YOLO26 na deteção de objetos, segue estes passos:
- Prepara o teu conjunto de dados no formato adequado.
- Treina o modelo YOLO26 com a tarefa de deteção.
- Usa o modelo para fazer previsões, fornecendo novas imagens ou fotogramas de vídeo.
Exemplofrom ultralytics import YOLO # Carrega um modelo YOLO pré-treinado (ajusta o tipo de modelo conforme necessário) model = YOLO("yolo26n.pt") # n, s, m, l, x versions available # Realizar detecção de objetos em uma imagem results = model.predict(source="image.jpg") # Também podes usar vídeo, diretório, URL, etc. # Apresenta os resultados results[0].show() # Mostra os resultados da primeira imagemPara obter instruções mais detalhadas, consulta os nossos exemplos de deteção.
Usar YOLO26 em tarefas de segmentação oferece várias vantagens:
- Elevada precisão: A tarefa de segmentação produz máscaras precisas ao nível dos píxeis.
- Velocidade: YOLO26 está otimizado para aplicações em tempo real e oferece processamento rápido, mesmo para imagens de alta resolução.
- Várias aplicações: É ideal para imagiologia médica, condução autónoma e outras aplicações que exigem segmentação detalhada de imagens.
Sabe mais sobre as vantagens e os casos de utilização de YOLO26 para segmentação na secção de segmentação de imagens.
Sim. Os modelos de pose YOLO26 detectam pontos-chave, como articulações humanas, em imagens e quadros de vídeo, e os conectam para formar poses. Isso é útil para rastrear movimentos em aplicações de análise esportiva, saúde e interação humano-computador.
Para mais detalhes e sugestões de implementação, consulta os nossos exemplos de estimativa de pose.
A detecção de objetos orientados (OBB) com YOLO26 prevê um parâmetro de ângulo adicional para cada caixa, permitindo localizar objetos girados com mais precisão do que caixas alinhadas aos eixos. Isso é útil em aplicações que exigem a localização precisa de objetos girados, como análise de imagens aéreas e automação de armazéns.
- Caixas mais ajustadas: As caixas giradas incluem menos elementos do fundo, o que ajuda a separar objetos densamente agrupados ou inclinados.
- Aplicações versáteis: Útil em tarefas de análise geoespacial, robótica, etc.
Consulta a secção de deteção de objetos orientados para mais detalhes e exemplos.


Comentários15
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(editado)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(editado)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(editado)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1