Exportação para TensorRT de modelos YOLO26
TensorRT é o SDK da NVIDIA para inferência de aprendizado profundo em alta velocidade. Exportar um modelo Ultralytics YOLO26 com format="engine" cria um arquivo .engine otimizado para a GPU NVIDIA em que é compilado, com precisão FP32, FP16 ou INT8.
O TensorRT ajusta um mecanismo para a GPU em que ele é compilado. Compile o mecanismo na GPU de implantação ou em uma GPU do mesmo modelo, usando a mesma versão do TensorRT; um arquivo .engine não é um formato de modelo portátil. Para implantação em dispositivos de borda, a Ultralytics Platform oferece oito opções de destino Jetson, com o status de compilação física e validação documentado para cada uma, ou você pode exportar localmente no dispositivo de destino.
Visão geral#
| Propriedade | Detalhes |
|---|---|
Argumento format | engine (aliases: tensorrt, trt) |
| Saída | yolo26n.engine, um arquivo que começa com um cabeçalho de metadados JSON (nomes das classes, tarefa, tamanho da imagem). O arquivo intermediário yolo26n.onnx permanece ao lado dele |
| Funciona em | GPUs NVIDIA: data center, estação de trabalho e Jetson, incluindo os núcleos DLA do Jetson (não no TensorRT 11) |
| Ambiente de execução | TensorRT 7.0 ou posterior (10.2.0 não é compatível) |
| Precisão | FP32, FP16, INT8 |
| Máquina de exportação | Uma máquina com GPU NVIDIA e CUDA. Compile na GPU de implantação ou em uma GPU do mesmo modelo |
A Ultralytics Platform pode compilar um mecanismo TensorRT para você no tipo de GPU selecionado, incluindo destinos NVIDIA Jetson, para que você não precise de um ambiente local de exportação.
Início rápido#
Instale o pacote Ultralytics em uma máquina com GPU NVIDIA e CUDA. No Linux, na primeira exportação, o pacote Python do TensorRT correspondente à sua versão do CUDA é instalado se estiver faltando. No NVIDIA Jetson, use a versão do TensorRT incluída no JetPack. No Windows, instale o TensorRT por conta própria antes de exportar.
pip install ultralyticsPara outros métodos de instalação, consulte o guia de instalação. Em seguida, exporte seu modelo e carregue o mecanismo exportado para executar a inferência ou validar a precisão. A inferência e a validação exigem uma GPU NVIDIA. A compilação de um mecanismo YOLO26n leva de um a três minutos em uma NVIDIA T4.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta o modelo para o formato TensorRT
model.export(format="engine")  # cria 'yolo26n.engine'

# Ou exportar um mecanismo FP16
model.export(format="engine", quantize=16) # cria 'yolo26n.engine'from ultralytics import YOLO
# Carregar o modelo TensorRT exportado
model = YOLO("yolo26n.engine")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carregar o modelo TensorRT exportado
model = YOLO("yolo26n.engine")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Tarefas suportadas#
A exportação TensorRT é compatível com todas as sete tarefas da Ultralytics usando modelos YOLOv8, YOLO11 e YOLO26: detecção, segmentação, segmentação semântica, estimativa de profundidade, classificação, estimativa de pose e OBB. A segmentação semântica e a estimativa de profundidade estão disponíveis apenas no YOLO26, a única família que inclui essas cabeças.
Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'engine' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
imgsz | int ou tuple | 640 | Tamanho de imagem desejado para a entrada do modelo. Pode ser um inteiro para imagens quadradas ou uma tupla (height, width) para dimensões específicas. |
quantize | int ou str | None | Precisão da quantização: 16 (FP16) ou 8 (INT8/PTQ; requer calibração data/fraction); 32/não definido corresponde a FP32. Um checkpoint treinado com quantize=8 exporta para INT8 usando os intervalos que contém, sem calibração, inclusive quando quantize não está definido; quantize=16 ou quantize=32 gera um erro. Substitui os sinalizadores obsoletos half/int8. |
dynamic | bool | False | Compila um mecanismo que aceita tamanhos de lote de 1 a batch e tamanhos de imagem de 32 pixels até o dobro de imgsz; o mínimo é maior para mecanismos INT8 dinâmicos em GPUs mais antigas. Quando False, o mecanismo aceita apenas os valores de exportação batch e imgsz. |
simplify | bool | True | Simplifica o grafo do modelo com onnxslim, podendo melhorar o desempenho e a compatibilidade. |
opset | int | None | Especifica a versão do opset do ONNX para o grafo ONNX intermediário. Se não for definido, usa o opset 18 (uma versão inferior no PyTorch < 2.4), limitado à versão instalada onnx. |
workspace | float ou None | None | Limite superior, em GiB, para a memória usada pelo TensorRT durante a compilação do mecanismo. Deixe como None para que o TensorRT aloque memória automaticamente. |
nms | bool, opcional | None | Selecione a saída bruta (None, padrão), NMS incorporado (True) ou a cabeça sem NMS (False). Com nms=True, conf (0.25 por padrão), iou, max_det e agnostic_nms ficam fixos na exportação; nms=True é ignorado nos modelos semânticos e de profundidade e gera um erro nos modelos de classificação. |
batch | int | 1 | Tamanho do lote do mecanismo ou tamanho máximo do lote com dynamic=True. Também é o tamanho do lote usado para a calibração INT8. |
data | str | None | Caminho para o YAML do conjunto de dados, usado para a calibração INT8; a classificação aceita um diretório de conjunto de dados ou o nome de um conjunto de dados integrado. A calibração usa a divisão val, a menos que split esteja definido. Se omitido com quantize=8, a Ultralytics usa o pequeno conjunto de dados padrão para a tarefa do modelo, como coco8.yaml para detecção; um checkpoint treinado com quantize=8 não precisa dele. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração como proporção, número de imagens ou proporções/contagens [train, val, test]. Listas de dois itens deixam test completo, enquanto 0 o ignora. |
device | str | None | Especifica o dispositivo para exportação: GPU (device=0, usado quando não definido), DLA para NVIDIA Jetson (device=dla:0 ou device=dla:1, com quantize=16 ou quantize=8). |
No NVIDIA Jetson, a Ultralytics exporta usando o ambiente de execução TensorRT da versão do JetPack. No JetPack 7, a exportação exige TensorRT 10.15 ou posterior, mas anterior à versão 11. device=dla:0 e device=dla:1 geram um erro no TensorRT 11. A NVIDIA lista o TensorRT 10.7 como a última versão 10.x com suporte a DLA, e o TensorRT 11.4.1 adiciona suporte ao JetPack 7.2.2, que a Ultralytics ainda não usa.
Para consultar os argumentos compartilhados por todos os formatos, veja a documentação do modo de exportação.
Exportação para TensorRT com quantização INT8#
quantize=8 compila um mecanismo INT8 usando quantização pós-treinamento (PTQ): a exportação executa imagens de calibração no modelo para medir o intervalo de valores de cada tensor. Um checkpoint ajustado com quantize=8 por meio de treinamento com reconhecimento de quantização já contém seus intervalos INT8, então sua exportação ignora a calibração.
Os argumentos quantize e data são iguais em todas as versões do TensorRT, mas a exportação de um checkpoint não treinado com quantize=8 funciona de maneira diferente internamente:
| TensorRT 7-10 | TensorRT 11 | |
|---|---|---|
| Método INT8 | Quantização implícita com a interface IInt8Calibrator | Quantização explícita: o NVIDIA ModelOpt insere nós Q/DQ no grafo ONNX |
| Algoritmo de calibração | MINMAX_CALIBRATION na GPU, ENTROPY_CALIBRATION_2 para DLA | ModelOpt max, executado na CPU |
| Imagens de calibração usadas | Cada lote completo da divisão | Cerca de 512 imagens em ordem aleatória ou cada lote completo de uma divisão menor |
dynamic=True com quantize=8 | Não coberto pelos testes; exporte sem dynamic=True | Compatível |
FP16 (quantize=16) | Sinalizador do compilador TensorRT | Conversão de precisão mista AutoCast do ModelOpt |
O ModelOpt é instalado no primeiro uso. A Ultralytics não reutiliza um cache de calibração, então cada exportação executa a calibração novamente. Para saber mais sobre os dois métodos, consulte Trabalhar com tipos quantizados na documentação do TensorRT.
Para um checkpoint não treinado com quantize=8, passe imagens de calibração com data, por exemplo, data="my_dataset.yaml". A calibração usa a divisão val desse conjunto de dados, a menos que você defina split, e fraction limita o número de imagens. A NVIDIA recomenda pelo menos 500 imagens representativas dos dados de implantação, e a exportação registra um aviso quando há menos de 300. Sem data, a exportação registra um aviso e usa o pequeno conjunto de dados de exemplo da tarefa do modelo, como coco8.yaml para detecção. A divisão de validação contém 4 imagens, o suficiente para testar a exportação, mas não para calibrar um modelo para implantação.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Calibrar com 10% das imagens de validação COCO (500 imagens); substitua coco.yaml pelo seu próprio conjunto de dados
model.export(format="engine", quantize=8, data="coco.yaml", fraction=0.1)

# Carregar o mecanismo INT8 exportado e executar a inferência
model = YOLO("yolo26n.engine")
result = model.predict("https://ultralytics.com/images/bus.jpg")
Na GPU de benchmark, os mecanismos INT8 foram de 1,04 a 2,3 vezes mais rápidos que os mecanismos FP32, mas superaram os mecanismos FP16 em velocidade em apenas três dos dez modelos. O INT8 perdeu de 1,7 a 2,9 mAP no YOLO26n a YOLO26l e muito mais no YOLO26x e no YOLO26n-pose. O mecanismo INT8 do YOLO26n era maior que o mecanismo FP32 (30 MB contra 11 MB), enquanto os modelos grandes ficaram menores (53 MB contra 103 MB no YOLO26l). O INT8 também pode alterar os valores de confiança, então escolha o limiar de confiança com base na curva F1 do próprio mecanismo INT8. Consulte os benchmarks de todos os modelos.
Formato de saída#
O mecanismo recebe uma entrada chamada images e retorna as mesmas saídas da exportação ONNX a partir da qual foi compilado, com uma exceção: em versões do TensorRT anteriores à 10, os modelos semânticos retornam pontuações de classe float com a forma (batch, classes, height, width) no lugar do mapa de classes uint8. Consulte o formato de saída ONNX para ver o formato de saída de cada tarefa e cada configuração de nms.
Carregar o mecanismo fora da Ultralytics#
Um arquivo .engine da Ultralytics não é um mecanismo TensorRT simples. Ele começa com um comprimento de 4 bytes em little-endian, seguido pelo número correspondente de bytes de metadados JSON e, em seguida, pelo mecanismo serializado. O deserialize_cuda_engine do TensorRT retorna None quando recebe o arquivo inteiro. Ignore o cabeçalho para carregar o mecanismo com a API do TensorRT:
import json

import tensorrt as trt

with open("yolo26n.engine", "rb") as f:
    n = int.from_bytes(f.read(4), byteorder="little")  # comprimento do cabeçalho de metadados
    metadata = json.loads(f.read(n))  # nomes das classes, tarefa, imgsz, lote, argumentos de exportação
    engine = trt.Runtime(trt.Logger(trt.Logger.WARNING)).deserialize_cuda_engine(f.read())
Quando outra ferramenta espera um arquivo de mecanismo TensorRT simples, grave os bytes após o cabeçalho em um novo arquivo ou compile o mecanismo nessa ferramenta usando o arquivo yolo26n.onnx que a exportação deixa ao lado do mecanismo. No TensorRT 11, as exportações FP16 e INT8 calibradas também deixam os arquivos yolo26n.fp16.onnx e yolo26n.int8.onnx; compile um mecanismo INT8 em outra ferramenta usando o arquivo .int8.onnx. Para um checkpoint treinado com quantize=8, yolo26n.onnx já contém os nós Q/DQ, e nenhum arquivo .int8.onnx é gravado; no TensorRT 11, essa exportação deixa yolo26n.fp16.onnx, o mesmo grafo Q/DQ com as outras camadas em FP16.
Implantar#
YOLO("yolo26n.engine") carrega o mecanismo com o ambiente de execução Python do TensorRT. O mecanismo é executado na GPU 0 por padrão, mesmo quando você passa device="cpu". Passe device=1 para executá-lo em outra GPU do mesmo modelo. Um mecanismo exportado com device=dla:0 ou device=dla:1 é executado nesse núcleo DLA.
Um mecanismo exportado sem dynamic=True tem uma forma de entrada fixa. Predict e val usam o valor imgsz da exportação e ignoram um argumento imgsz diferente. A Ultralytics divide lotes maiores em lotes do tamanho da exportação e preenche os menores; assim, qualquer número de imagens funciona. Um mecanismo exportado com dynamic=True aceita todos os tamanhos de lote e de imagem dentro do intervalo e gera ValueError: input size ... is outside the TensorRT optimization profile para uma forma fora dele. Com nms=True, um lote maior que o intervalo é dividido em lotes do tamanho da exportação.
Guias de implantação#
-
NVIDIA Triton Inference Server: disponibilize uma exportação ONNX com o acelerador TensorRT do Triton, que compila o mecanismo na GPU do servidor.
-
Início rápido do NVIDIA Jetson: configure a Ultralytics em dispositivos Jetson e exporte mecanismos TensorRT com o JetPack, incluindo DLA.
-
Início rápido do NVIDIA DGX Spark: configure a Ultralytics e o TensorRT no NVIDIA DGX Spark.
-
DeepStream no NVIDIA Jetson: execute modelos exportados em pipelines de vídeo do NVIDIA DeepStream.
-
NVIDIA TensorRT no GitHub: código-fonte, exemplos e ferramentas para TensorRT.
Limitações e solução de problemas#
- Os mecanismos não são portáteis: um mecanismo é compilado para um modelo de GPU e uma versão do TensorRT. Recompile-o quando você mudar a GPU, a versão do TensorRT ou a versão do JetPack. Quando um mecanismo não pode ser carregado, a Ultralytics registra
TensorRT model exported with a different version than expected. - É necessária uma GPU: a exportação usa
device=0quandodevicenão está definido e falha comexport running on CPU but must be on GPUparadevice=cpu. - O mecanismo não carrega em outras ferramentas: o arquivo
.enginecomeça com um cabeçalho de metadados, portanto a API do TensorRT não consegue lê-lo diretamente. Consulte Carregar o mecanismo fora da Ultralytics. - Versão do TensorRT: a Ultralytics requer TensorRT 7.0.0 ou posterior. O TensorRT 10.2.0 não é compatível, e a instalação automática o ignora. No JetPack 7 e em sistemas NVIDIA DGX, a exportação exige TensorRT 10.15 ou posterior (e anterior à versão 11 no Jetson) e tenta instalá-lo quando a versão instalada está fora desse intervalo.
- Cabeça sem NMS em versões antigas do TensorRT: versões do TensorRT anteriores à 8.5.0 não conseguem compilar a cabeça YOLO26 sem NMS. A exportação registra um aviso e grava predições brutas que precisam de NMS. Atualize o TensorRT para a versão 8.5.0 ou posterior para exportar com
nms=False. - INT8 no JetPack 6: com TensorRT 10.3.0 no JetPack 6, uma exportação INT8 com
nms=Truefalha, e uma exportação INT8 comnms=Falseretorna predições brutas. Consulte o guia do Jetson para ver a solução. - INT8 no TensorRT 10.16: a exportação INT8 com TensorRT 10.16.1 falhou nas GPUs NVIDIA RTX PRO 6000 Blackwell e RTX 6000D com
Could not find any implementation for node. Na RTX PRO 6000 Blackwell, o TensorRT 10.13, 10.14, 10.15 e 11.4 compilou o mecanismo INT8. - DLA:
device=dla:0edevice=dla:1funcionam apenas no NVIDIA Jetson e somente comquantize=16ouquantize=8. A exportação gera um erro no TensorRT 11. As camadas não compatíveis com DLA são executadas na GPU. - Formas dinâmicas:
dynamic=Trueprecisa de um tamanho máximo de lote, então defina tambémbatch, por exemplo,batch=8. Sem ele, a exportação registra um aviso e o tamanho máximo do lote é 1. O mecanismo aceita lotes de 1 abatche tamanhos de imagem de 32 pixels até o dobro do valor de exportaçãoimgsz. Por exemplo, um mecanismo exportado comimgsz=320 batch=4funciona com 640 pixels e rejeita 704 pixels ou um lote de 6 cominput size ... is outside the TensorRT optimization profile. Combinedynamic=Truecomquantize=8apenas no TensorRT 11. Em GPUs com capacidade de computação 7.5 ou inferior, como a T4, o tamanho mínimo desses mecanismos INT8 dinâmicos é 64 pixels (128 para modelos P6). - Tamanho de entrada fixo: um mecanismo exportado sem
dynamic=Truesempre é executado no valor de exportaçãoimgsz. Passar outroimgszpara predict ou val não tem efeito; exporte novamente para mudar o tamanho da entrada. - Exportação INT8 sem
data: a menos que o checkpoint tenha sido treinado comquantize=8, a exportação calibra usando o pequeno conjunto de dados padrão da tarefa, que tem 4 imagens de validação para detecção, e registra um aviso. Passedatacom imagens representativas; a exportação avisa quando há menos de 300. - Inferências iniciais lentas: as primeiras chamadas com um mecanismo novo ou com um novo
imgszem um mecanismo dinâmico demoram mais que as chamadas posteriores.
Para outros erros, consulte o guia de problemas comuns.
Benchmarks#
A página do modelo YOLO26 lista a velocidade no TensorRT 10 de cada modelo em uma GPU NVIDIA T4 para todas as tarefas, exceto segmentação semântica.
Comparação entre FP32, FP16 e INT8#
As tabelas abaixo comparam PyTorch com mecanismos TensorRT 11.4 FP32, FP16 e INT8 para todos os modelos de detecção YOLO26 e para o modelo YOLO26n em outras cinco tarefas. Todos os valores foram medidos em uma GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Milissegundos por imagem; valores menores são melhores. O formato mais rápido para cada modelo está em negrito; o mecanismo INT8 do YOLO26x foi excluído porque sua precisão era instável.
| Modelo | imgsz | PyTorch | TensorRT FP32 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 0.67 | 0.48 | 0.53 |
| YOLO26s | 640 | 2.98 | 1.15 | 0.61 | 0.66 |
| YOLO26m | 640 | 3.29 | 2.22 | 1.03 | 1.08 |
| YOLO26l | 640 | 4.70 | 3.03 | 1.49 | 1.43 |
| YOLO26x | 640 | 5.93 | 4.31 | 2.09 | 1.84 |
| YOLO26n-seg | 640 | 3.18 | 0.93 | 0.65 | 0.72 |
| YOLO26n-sem | 1024 | 1.74 | 0.74 | 0.45 | 0.71 |
| YOLO26n-cls | 224 | 1.75 | 0.29 | 0.24 | 0.20 |
| YOLO26n-pose | 640 | 3.39 | 0.76 | 0.51 | 0.59 |
| YOLO26n-obb | 1024 | 4.55 | 1.03 | 0.64 | 0.88 |
- FP16 manteve a precisão do FP32 dentro de 0,1 ponto em todos os modelos. Nos modelos de detecção, foi de 1,4 a 2,2 vezes mais rápido que o mecanismo FP32 e de 2,8 a 5,9 vezes mais rápido que o PyTorch.
- INT8 teve latência até 12% maior que FP16 nos modelos de detecção e perdeu de 1,7 a 2,9 mAP no YOLO26n, YOLO26s, YOLO26m e YOLO26l. Nesta GPU, foi mais rápido que FP16 apenas no YOLO26l, YOLO26x e YOLO26n-cls.
- A precisão do YOLO26x INT8 caiu para um intervalo entre 25,3 e 38,5 mAP em três compilações, em comparação com 57,5 em FP32. O YOLO26n-pose INT8 caiu de 56,7 para 33,4 mAP de pose. Valida cada mecanismo INT8 com os teus próprios dados antes de o implementar.
- Os mecanismos FP32 e FP16 do TensorRT 10.16 para YOLO26n e YOLO26s igualaram a precisão do TensorRT 11.4. Os mecanismos FP16 foram cerca de 7% mais rápidos, e os mecanismos FP32, de 4% a 9% mais lentos do que no TensorRT 11.4.
Para NVIDIA Jetson e DGX Spark, consulta os benchmarks do Jetson e o guia do DGX Spark.
Medido com ultralytics 8.4.211, TensorRT 11.4.0, PyTorch 2.15.0 e CUDA 13.2 em batch=1, em 13 de novembro de 2026. A latência corresponde à etapa de inferência reportada por val e não inclui o pré-processamento nem o pós-processamento.
Sobre o TensorRT#
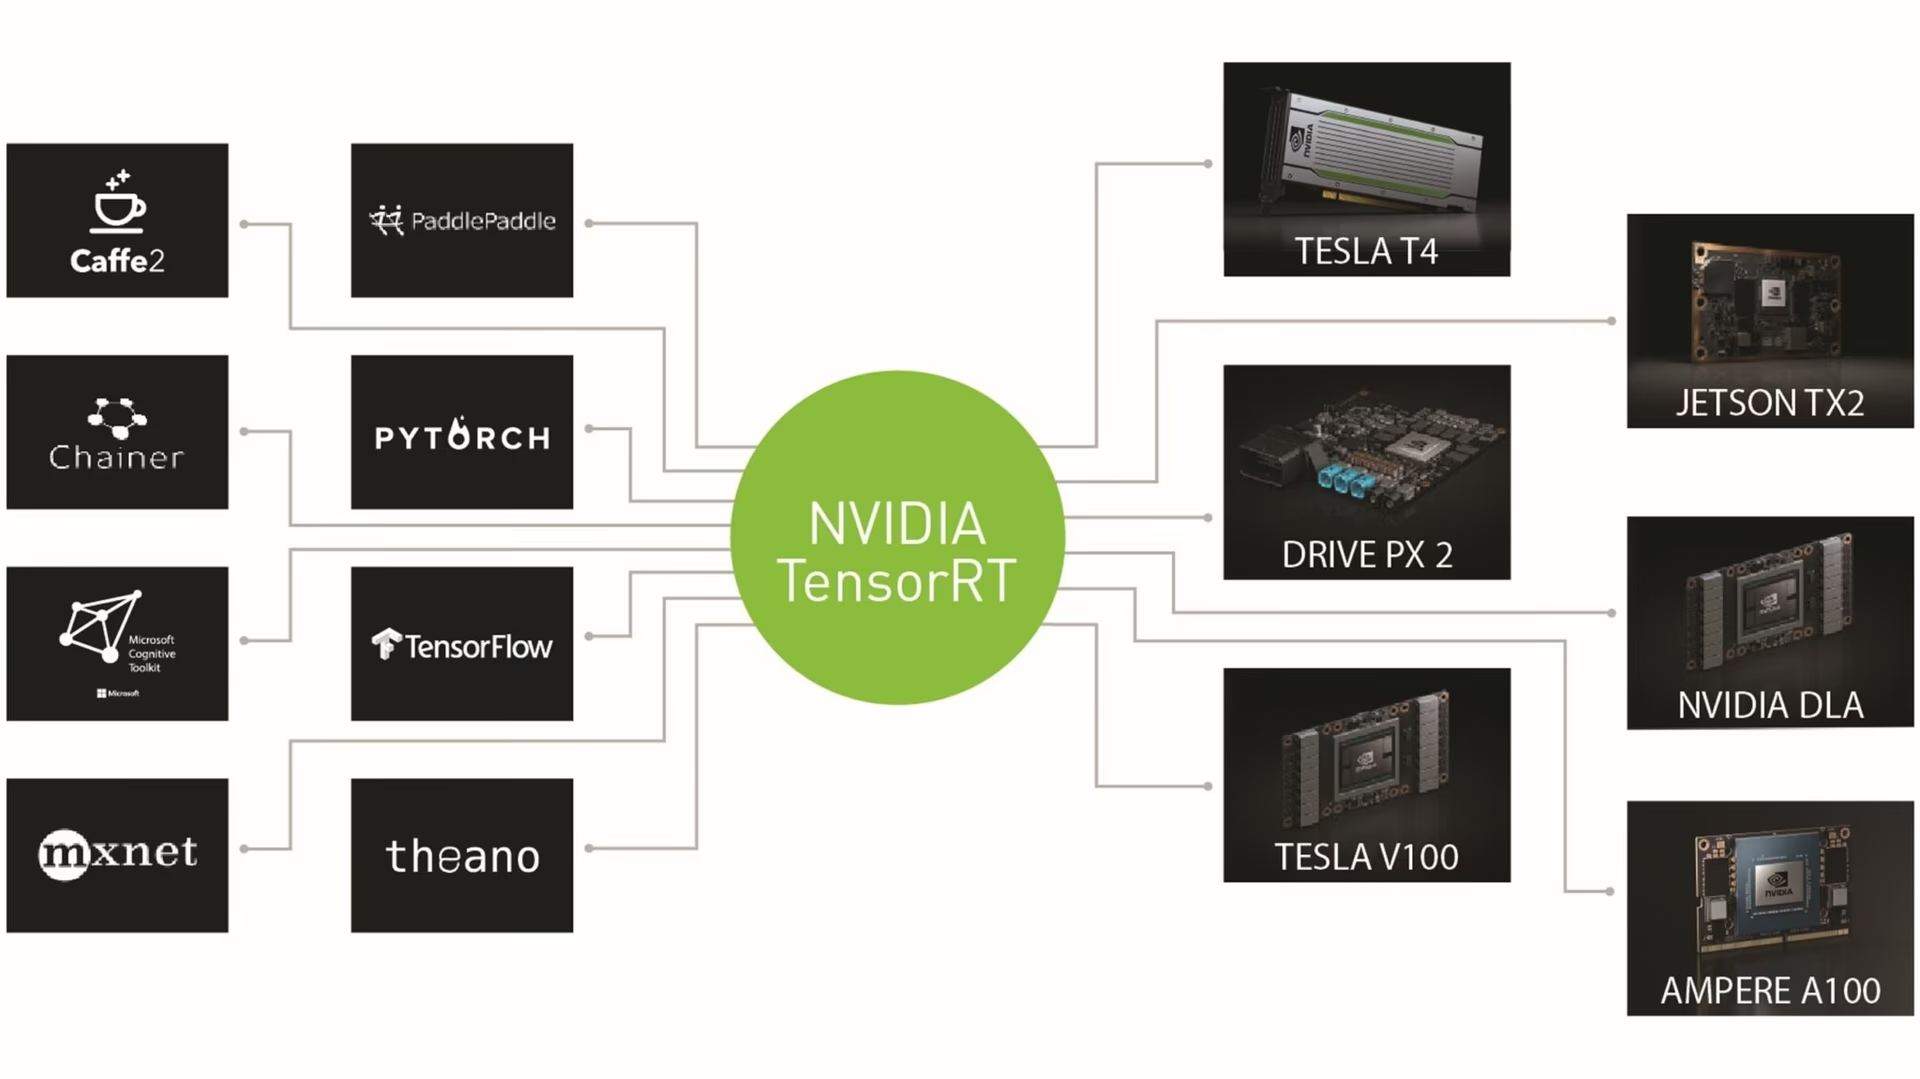
O TensorRT cria um mecanismo ao fundir camadas, selecionar o kernel mais rápido para cada camada na GPU de compilação e, opcionalmente, reduzir a precisão para FP16 ou INT8. Para consultar a referência completa, vê a documentação do TensorRT.
Perguntas frequentes#
Apenas numa GPU do mesmo modelo e com a mesma versão do TensorRT. Um mecanismo é compilado para um modelo de GPU e uma versão do TensorRT específicos. Para partilhar um único ficheiro entre diferentes hardwares, exporta para ONNX e compila o mecanismo em cada dispositivo. Para NVIDIA Jetson, a Ultralytics Platform pode compilar mecanismos para oito alvos Jetson.
Começa com FP16 (
quantize=16). Não requer dados de calibração e mantém a precisão do FP32. Nos benchmarks executados numa NVIDIA RTX PRO 6000 Blackwell com TensorRT 11.4, FP16 reduziu a latência do YOLO26s de 1,15 ms para 0,61 ms por imagem, mantendo os mesmos 48,5 mAPval 50-95. INT8 (quantize=8) teve latência de 0,66 ms e 46,3 mAPval 50-95; portanto, não foi mais rápido que FP16 nessa GPU e requer dados de calibração representativos, a menos que o checkpoint tenha sido treinado comquantize=8. INT8 pode compensar em outros hardwares: os benchmarks do Jetson apresentam resultados de FP16 e INT8 para dispositivos integrados. Mede ambas as precisões no dispositivo de implementação antes de escolher INT8.Exporta com
dynamic=Truee definebatchcomo o maior lote que pretendes executar. O mecanismo aceitará lotes de 1 abatche tamanhos de imagem de 32 pixels até ao dobro deimgszda exportação, com um mínimo maior para mecanismos INT8 dinâmicos em GPUs mais antigas. Semdynamic=True, o mecanismo tem uma única forma de entrada fixa, e o Ultralytics divide ou preenche cada lote para ajustá-lo.Mecanismo dinâmicofrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", dynamic=True, batch=8, quantize=16) model = YOLO("yolo26n.engine") results = model(["https://ultralytics.com/images/bus.jpg"] * 4, batch=4) # um lote de 4 imagensExecuta a exportação no próprio Jetson, usando a versão do TensorRT da tua versão do JetPack. Para usar um núcleo DLA, adiciona
device=dla:0comquantize=16ouquantize=8. Consulta o guia da NVIDIA Jetson para ver as instruções de configuração e os benchmarks.Exportar no Jetsonfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", quantize=16) # Mecanismo FP16 na GPU do Jetson # Ou compila o mecanismo FP16 para o núcleo DLA 0 model.export(format="engine", quantize=16, device="dla:0")O guia do Triton Inference Server exporta o modelo para ONNX e ativa o acelerador TensorRT do Triton em
config.pbtxt. O Triton compila então o mecanismo TensorRT na GPU do servidor durante o primeiro carregamento e guarda-o em cache, garantindo que o mecanismo corresponde sempre à GPU e à versão do TensorRT do servidor. O guia aborda a estrutura do repositório de modelos, o contentor do servidor e a inferência do cliente com Ultralytics.


Comentários116
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
AgbajeAyomipo
Hi Ultralytics team, I’ve trained a YOLOv11 model on (1024x1024) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True) but it fails silently. If I use a dynamic=true without specifying the imgsz parameter, the export succeeds and uses (1024, 1024). My questions:
Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround? Are there ways to improve performance with high-res inference on Jetson Orin Nano? What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1martinmclee
Have you gotten any workaround? Perhaps with the YOLO26?
Hi Ultralytics team, I’ve trained a YOLOv11 model on full-size 5MP (2592x1944) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True)but it fails silently. If I use a dynamic=true, the export succeeds and uses (1024, 1024). My questions:- Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround?
- Are there ways to improve performance with high-res inference on Jetson Orin Nano?
- What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1020423lzl
m的模型大小比n大的多,速度也慢了很多,输入图像尺寸越大,越吃显存,速度也越慢
李子乐控制工程 @.***
---Original--- From: @.> Date: Sat, May 9, 2026 10:30 AM To: @.>; Cc: @.@.>; Subject: Re: [ultralytics/ultralytics] zh/integrations/tensorrt/ (Discussion #9868)
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令: yolo export model=yolo11m.pt imgsz=1280 format='engine 推理代码为: model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')
另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
— Reply to this email directly, view it on GitHub, or unsubscribe. Triage notifications on the go with GitHub Mobile for iOS or Android. You are receiving this because you commented.Message ID: @.***>
 User
能不能读完再说话,肯定是m和m比,n和n比,同样尺寸输入和同样尺寸输入的比啊。 该显卡的RT core算力是普通fp32算力的近两倍。
 Glenn JocherUltralytics
是的,性能应当在同一模型、同一
imgsz、同一batch、同一后处理参数下比较;m比n更大、1280比640更吃显存且更慢是正常现象。对 RTX A6000 来说,FP32的 TensorRT 往往不会比.pt明显更快,建议先按 TensorRT 导出文档 用half=True重新导出,并在相同输入上预热后再统计平均耗时;如果engine与.pt结果仍明显不一致,请贴出!yolo checks、完整控制台日志文本和一个最小可复现示例,我们好继续排查环境或后处理差异。
- User
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令:
yolo export model=yolo11m.pt imgsz=1280 format='engine推理代码为:model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
etson@yahboom:~/ultralytics/ultralytics$ yolo predict model=best.engine source=0 save=False show WARNING ⚠️ Unable to automatically guess model task, assuming 'task=detect'. Explicitly define task for your model, i.e. 'task=detect', 'segment', 'classify','pose' or 'obb'. Ultralytics 8.3.172 🚀 Python-3.10.12 torch-2.5.0a0+872d972e41.nv24.08 CUDA:0 (Orin, 7620MiB) Loading best.engine for TensorRT inference... [12/18/2025-17:11:05] [TRT] [I] Loaded engine size: 75 MiB [12/18/2025-17:11:05] [TRT] [I] [MS] Running engine with multi stream info [12/18/2025-17:11:05] [TRT] [I] [MS] Number of aux streams is 7 [12/18/2025-17:11:05] [TRT] [I] [MS] Number of total worker streams is 8 [12/18/2025-17:11:05] [TRT] [I] [MS] The main stream provided by execute/enqueue calls is the first worker stream [12/18/2025-17:11:05] [TRT] [I] [MemUsageChange] TensorRT-managed allocation in IExecutionContext creation: CPU +1, GPU +88, now: CPU 1, GPU 158 (MiB)
[ WARN:0@2.771] global cap_gstreamer.cpp:1777 open OpenCV | GStreamer warning: Cannot query video position: status=0, value=-1, duration=-1 1/1: 0... Success ✅ (inf frames of shape 1920x1080 at 5.00 FPS)
Traceback (most recent call last): File "/home/jetson/.local/bin/yolo", line 7, in sys.exit(entrypoint()) File "/home/jetson/Downloads/ultralytics-main/ultralytics/cfg/init.py", line 983, in entrypoint getattr(model, mode)(**overrides) # default args from model File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/model.py", line 555, in predict return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 247, in predict_cli for _ in gen: # sourcery skip: remove-empty-nested-block, noqa File "/usr/local/lib/python3.10/dist-packages/torch/utils/_contextlib.py", line 36, in generator_context response = gen.send(None) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 351, in stream_inference s[i] += self.write_results(i, Path(paths[i]), im, s) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 434, in write_results string += f"{result.verbose()}{result.speed['inference']:.1f}ms" File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in verbose return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) KeyError: 171 terminate called without an active exception Aborted (core dumped) jetson@yahboom:~/ultralytics/ultralytics$ How to solve it
- Glenn JocherUltralytics
KeyError: 171表示模型输出了类别171,但当前names里没有这个索引(通常是自定义数据集的标签类别编号不在0..nc-1范围内、data.yaml里的names数量与nc不匹配,或导出/推理用的模型与数据配置不一致导致的元数据错配);请先把所有标注.txt的 class id 修正为连续的0..nc-1,同步修正data.yaml的nc/names,修正后删除数据集labels/下的*.cache,再用同一套环境从best.pt重新导出.engine(参考 TensorRT 导出文档),并在推理时显式加上task=detect。另外请把下面命令的完整输出(文本)贴在这个 discussion 里,以及你当时的导出命令,方便我们确认是否有多环境/路径冲突:yolo checks Thank you for your reply. The issue has been resolved. I was using the RT-DETR model, but I mistakenly used "from ultralytics import YOLO" when exporting
- Glenn JocherUltralytics
Glad you found it — RT-DETR models should be loaded/exported with
RTDETR(...)(mixing them withYOLO(...)can produce mismatched metadata likenames), see the RT-DETR model docs for details:from ultralytics import RTDETR model = RTDETR("best.pt") model.export(format="engine") # creates best.engine
fly2skyToEnjoy
May I ask : The following command exports the file, whether the box and mask are both nmsed at the same time ???
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("yolo11n.pt")
Export the model to TensorRT format
model.export(format="engine") # creates 'yolo11n.engine'
Load the exported TensorRT model
tensorrt_model = YOLO("yolo11n.engine")
Run inference
results = tensorrt_model("https://ultralytics.com/images/bus.jpg")
AK993
这个方法适用于rt-detr吗
dilanpatel195
I am trying to prediction model for the YOLOv11n-seg, I have exported the .py to .engine to back it run faster but keep getting a KEY error message:
KeyError Traceback (most recent call last) Cell In[4], line 109 106 # Inside the main loop after grabbing a frame 107 if inference_active and not inpainting_active: 108 # Perform YOLO inference --> 109 results = model(rgb_frame)[0] 110 masked_image = rgb_frame.copy() # Make a copy for masking 112 # Process YOLO masks (original functionality remains unchanged)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:176, in Model.call(self, source, stream, **kwargs) 147 def call( 148 self, 149 source: Union[str, Path, int, Image.Image, list, tuple, np.ndarray, torch.Tensor] = None, 150 stream: bool = False, 151 **kwargs, 152 ) -> list: 153 """ 154 Alias for the predict method, enabling the model instance to be callable for predictions. 155 (...) 174 ... print(f"Detected {len(r)} objects in image") 175 """ --> 176 return self.predict(source, stream, **kwargs)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:554, in Model.predict(self, source, stream, predictor, **kwargs) 552 if prompts and hasattr(self.predictor, "set_prompts"): # for SAM-type models 553 self.predictor.set_prompts(prompts) --> 554 return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:168, in BasePredictor.call(self, source, model, stream, *args, **kwargs) 166 return self.stream_inference(source, model, *args, **kwargs) 167 else: --> 168 return list(self.stream_inference(source, model, *args, **kwargs))
File c:\ProgramData\miniconda3\Lib\site-packages\torch\utils_contextlib.py:36, in _wrap_generator..generator_context(*args, **kwargs) 33 try: 34 # Issuing None to a generator fires it up 35 with ctx_factory(): ---> 36 response = gen.send(None) 38 while True: 39 try: 40 # Forward the response to our caller and get its next request
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:274, in BasePredictor.stream_inference(self, source, model, *args, **kwargs) 268 self.results[i].speed = { 269 "preprocess": profilers[0].dt * 1e3 / n, 270 "inference": profilers[1].dt * 1e3 / n, 271 "postprocess": profilers[2].dt * 1e3 / n, 272 } 273 if self.args.verbose or self.args.save or self.args.save_txt or self.args.show: --> 274 s[i] += self.write_results(i, Path(paths[i]), im, s) 276 # Print batch results 277 if self.args.verbose:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:334, in BasePredictor.write_results(self, i, p, im, s) 332 result = self.results[i] 333 result.save_dir = self.save_dir.str() # used in other locations --> 334 string += f"{result.verbose()}{result.speed['inference']:.1f}ms" 336 # Add predictions to image 337 if self.args.save or self.args.show:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\results.py:663, in Results.verbose(self) 661 for c in boxes.cls.unique(): 662 n = (boxes.cls == c).sum() # detections per class --> 663 log_string += f"{n} {self.names[int(c)]}{'s' * (n > 1)}, " 664 return log_string
KeyError: 2
Any help would be greatly appreciated!
Ranjith3436
Now, My TensorRT Sengment model used for track. if any detections not there the processing FPS is 75-80 in jetson. But once the person or people detected suddenly reused to 15-20. processing time going to 40ms. only when the object detected. What's the issue in model.track(), could i run all the tracking thing on GPU.
- Glenn JocherUltralytics(editado)
@Ranjith3436 the performance drop when objects are detected is expected behavior, as tracking introduces additional computational overhead. When objects are detected, the model.track() method performs several CPU-bound operations including feature extraction, association, and trajectory management.
To improve performance:
- Try using a smaller model variant (like YOLO26n-seg instead of larger variants)
- Consider reducing the image resolution for tracking
- Optimize tracking parameters by setting
persist=Trueand adjustingconfthresholds higher to track fewer objects - Use
half=True(FP16) orint8=Truewhen exporting your model to TensorRT for maximum GPU acceleration
For the tracking components specifically, the BoT-SORT or ByteTrack algorithms used by Ultralytics do have some CPU-bound operations, but you can minimize their impact with the above optimizations. For more details on tracking optimization, check our tracking documentation.
1
I convert Classification model that i retrained. But it throw the error "amax(): Expected reduction dim 1 to have non-zero size."
- Glenn JocherUltralytics
@Ranjith3436 this error typically occurs when TensorRT encounters an empty dimension during model conversion. For classification models, this could happen if:
- Your model architecture was modified or if you're using a custom architecture
- There might be an issue with batch normalization layers during export
- The class count in your retrained model might be causing dimension mismatches
Try these solutions:
- Ensure your model's forward pass works correctly before export
- Try exporting with
simplify=Falseto preserve the original graph structure - Check if your classification model has the correct output dimension for your number of classes
If the issue persists, share more details about your model architecture and export command for better assistance. For more guidance, refer to our TensorRT integration documentation.
The model trained use yolov8l-cls.pt and the error come from jetson device.
(model): ClassificationModel( (model): Sequential( (0): Conv( (conv): Conv2d(3, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (1): Conv( (conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (2): C2f( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(320, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (3): Conv( (conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (4): C2f( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(1024, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (5): Conv( (conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (6): C2f( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2048, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (7): Conv( (conv): Conv2d(512, 1024, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (8): C2f( (cv1): Conv( (conv): Conv2d(1024, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2560, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (9): Classify( (conv): Conv( (conv): Conv2d(1024, 1280, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1280, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (pool): AdaptiveAvgPool2d(output_size=1) (drop): Dropout(p=0.0, inplace=True) (linear): Linear(in_features=1280, out_features=2, bias=True) ) ) ) )
model architecture
This error sorted out