Visão geral dos conjuntos de dados de detecção de objetos
O treinamento de um modelo robusto e preciso de detecção de objetos exige um conjunto de dados abrangente. Este guia apresenta vários formatos de conjuntos de dados compatíveis com o modelo Ultralytics YOLO e explica sua estrutura, uso e como converter entre diferentes formatos.
Formatos de conjuntos de dados compatíveis#
Formato Ultralytics YOLO#
O formato Ultralytics YOLO é um formato de configuração de conjunto de dados que permite definir o diretório raiz do conjunto de dados, os caminhos relativos para os diretórios de imagens de treinamento/validação/teste ou arquivos *.txt que contêm caminhos de imagens, e um dicionário de nomes de classes. Veja um exemplo:
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8 dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8
# Example usage: yolo train data=coco8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8.zip
Cada um de train, val e test aceita um diretório, um arquivo de imagem, uma lista de diretórios ou arquivos de imagem, ou um arquivo UTF-8 *.txt que lista um caminho de imagem por linha (os caminhos que começam com ./ são resolvidos em relação ao arquivo *.txt). Um arquivo *.txt é útil para treinar com um subconjunto de um diretório, ignorar imagens sem rótulos ou combinar imagens de várias fontes em uma única divisão.
path: datasets/coco8 # dataset root
train: train.txt # a directory, an image, a list e.g. [images/a, images/b], or a *.txt file
val: val.txt
names:
  0: person
(Opcional) colors atribui a cada classe uma cor de exibição como uma string entre aspas "#rrggbb", indexada pelo ID da classe, por exemplo, colors: ["#042aff", "#ff0000"]. Os modelos treinados e exportados mantêm essas cores nas respetivas previsões; as classes sem uma cor atribuída usam a paleta predefinida. Um registo de conjunto de dados NDJSON pode incluir o mesmo campo colors.
As etiquetas deste formato devem ser exportadas para o formato YOLO, com um ficheiro *.txt por imagem. Se não houver objetos numa imagem, não é necessário um ficheiro *.txt. O ficheiro *.txt deve ser formatado com uma linha por objeto no formato class x_center y_center width height. As coordenadas da caixa delimitadora devem estar no formato normalized xywh (de 0 a 1). Se as caixas estiverem em píxeis, deves dividir x_center e width pela largura da imagem, e y_center e height pela altura da imagem. As coordenadas referem-se à imagem tal como é apresentada pelos visualizadores, com a orientação EXIF aplicada, que é a forma como a Ultralytics lê todas as imagens. Os números das classes devem começar em zero.
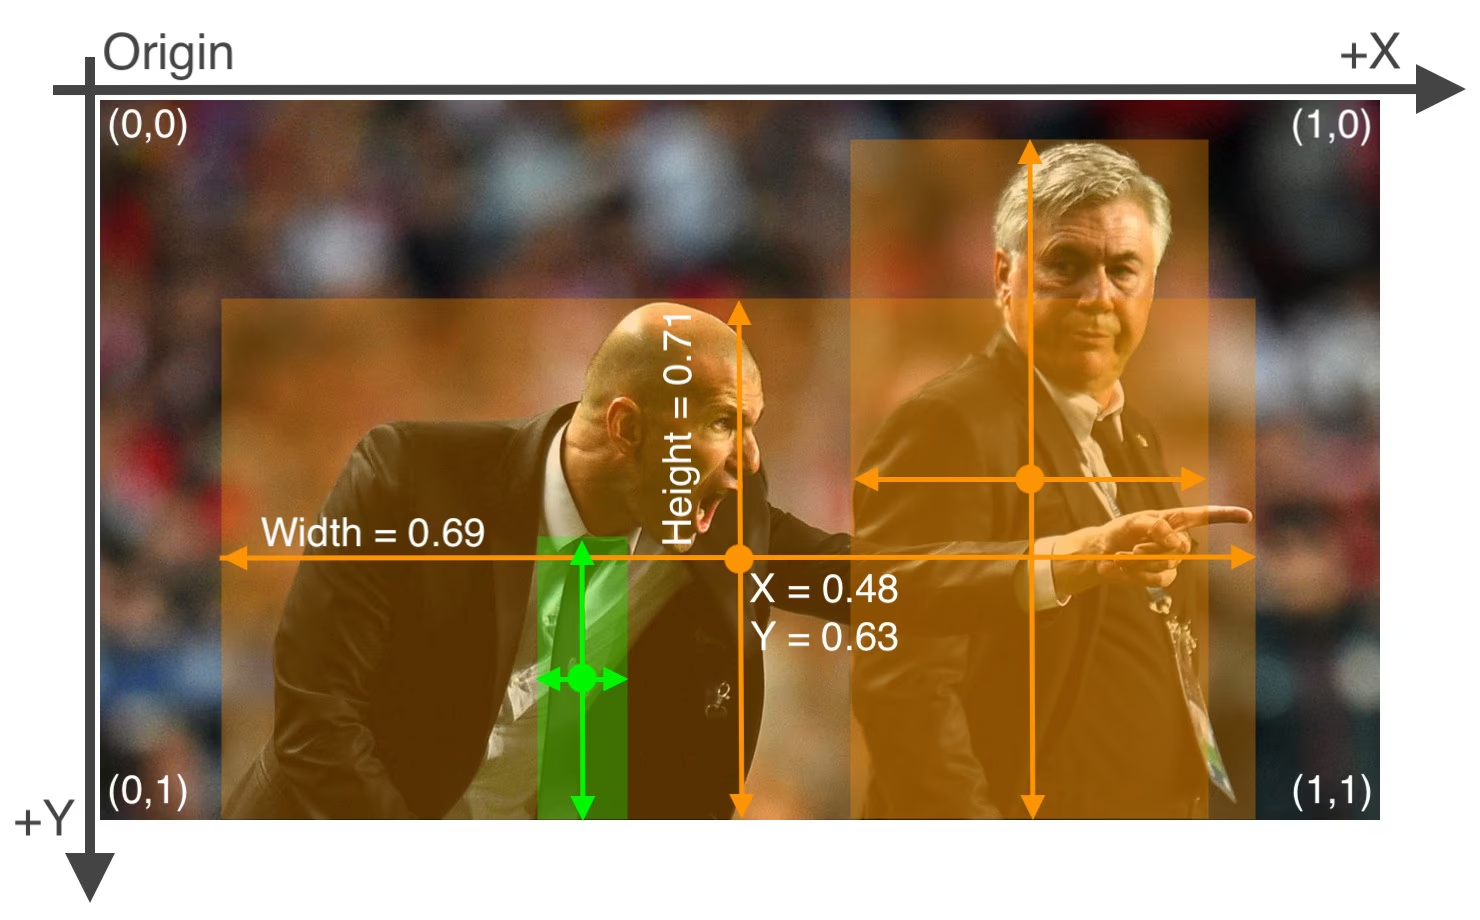
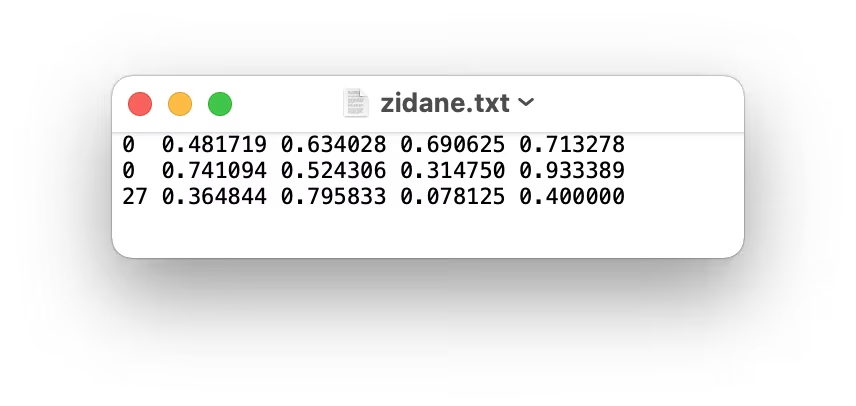
O arquivo de rótulos correspondente à imagem acima contém 2 pessoas (classe 0) e uma gravata (classe 27):
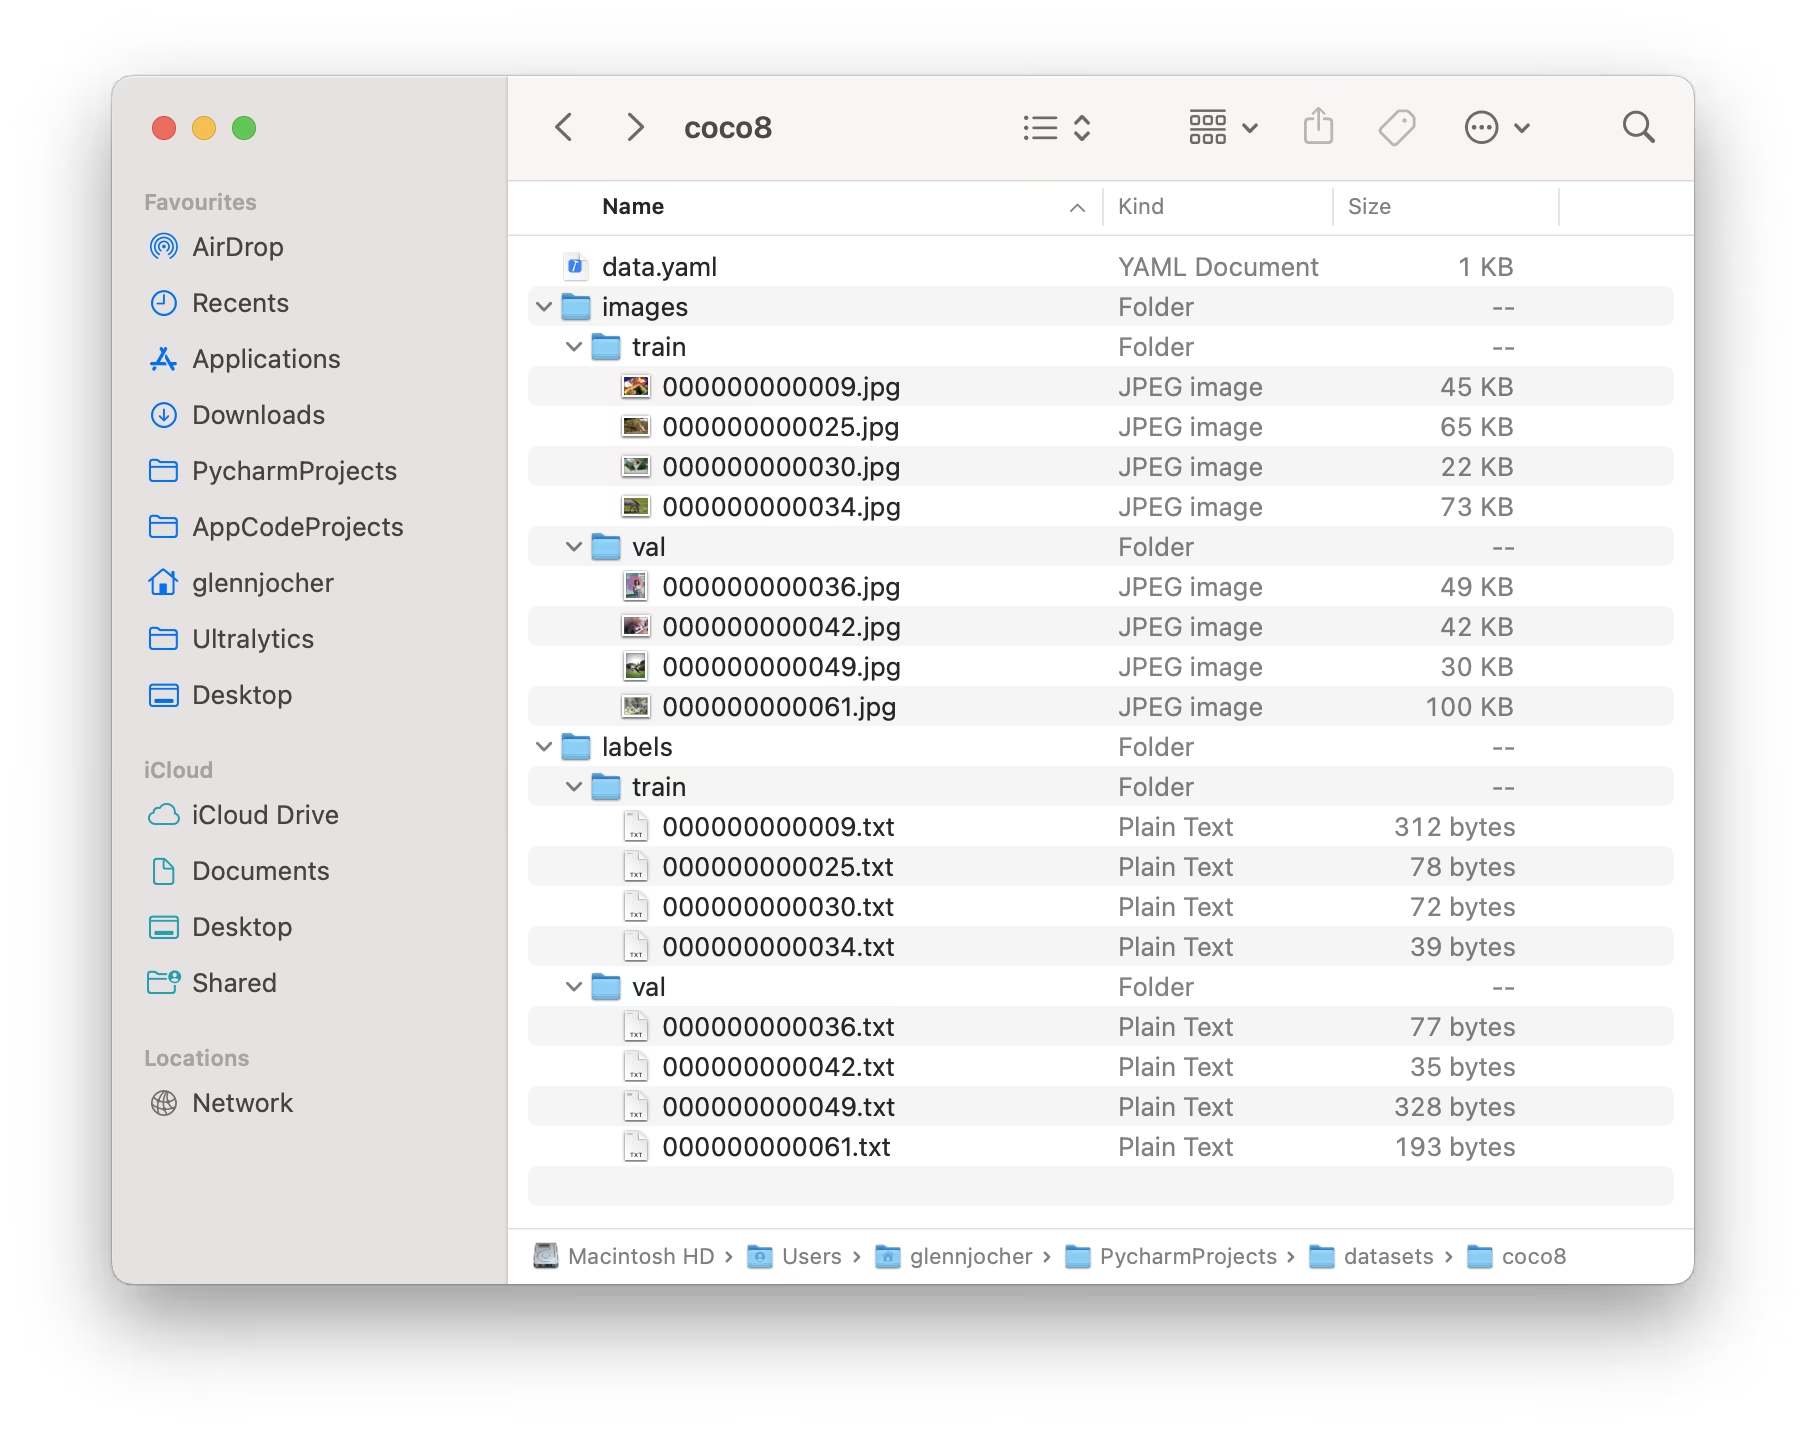
Ao usar o formato Ultralytics YOLO, organiza as imagens e os rótulos de treinamento e validação conforme mostrado no exemplo do conjunto de dados COCO8 abaixo.
Exemplo de uso#
Veja como podes usar conjuntos de dados no formato YOLO para treinar o teu modelo:
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
Formato Ultralytics NDJSON#
O formato NDJSON (JSON delimitado por linhas) oferece uma forma alternativa de definir conjuntos de dados para modelos Ultralytics YOLO. Esse formato armazena metadados e anotações do conjunto de dados em um único arquivo, no qual cada linha contém um objeto JSON separado.
Um arquivo de conjunto de dados NDJSON contém:
- Registro do conjunto de dados (primeira linha): contém metadados do conjunto de dados, incluindo o tipo de tarefa, os nomes das classes e informações gerais.
- Registros de imagens (linhas seguintes): contêm dados de cada imagem, incluindo dimensões, anotações e caminhos de arquivos.
{
    "type": "dataset",
    "task": "detect",
    "name": "Example",
    "description": "COCO NDJSON example dataset",
    "url": "https://platform.ultralytics.com/user/datasets/example",
    "class_names": { "0": "person", "1": "bicycle", "2": "car" },
    "bytes": 426342,
    "version": 0,
    "created_at": "2024-01-01T00:00:00Z",
    "updated_at": "2025-01-01T00:00:00Z"
}
Metadados personalizados de imagens#
Cada registro de imagem pode incluir um objeto JSON metadata para informações específicas da aplicação, como condições de captura, identificadores de equipamentos ou status de revisão. Valores aninhados são aceitos. Quando importados para a Ultralytics Platform, os metadados são armazenados com a imagem e podem ser visualizados ou editados no painel de informações em tela cheia.
{
    "type": "image",
    "file": "airbus-wing.jpg",
    "url": "https://example.com/airbus-wing.jpg",
    "split": "train",
    "metadata": {
        "aircraft": { "family": "A350", "section": "wing" },
        "inspectionStatus": "reviewed"
    }
}
A plataforma limita as chaves de metadados de nível superior a 128 caracteres, o objeto de metadados serializado de cada imagem a 500.000 caracteres e o total de metadados efetivos em uma importação NDJSON a 500.000 caracteres.
Exemplo de uso#
Para usar um conjunto de dados NDJSON com YOLO26, basta especificar o caminho para o arquivo .ndjson:
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")

# Treinar usando um conjunto de dados NDJSON
results = model.train(data="path/to/dataset.ndjson", epochs=100, imgsz=640)
Vantagens do formato NDJSON#
- Arquivo único: todas as informações do conjunto de dados ficam em um único arquivo.
- Processamento em fluxo: permite processar grandes conjuntos de dados linha por linha, sem carregar tudo na memória.
- Integração com a nuvem: oferece suporte a URLs de imagens remotas para treinamento na nuvem.
- Extensível: é fácil adicionar campos de metadados personalizados.
- Controle de versão: o formato de arquivo único funciona bem com git e sistemas de controle de versão.
Conjuntos de dados compatíveis#
Aqui está uma lista dos conjuntos de dados compatíveis e uma breve descrição de cada um. A maioria desses conjuntos de dados também está hospedada na Ultralytics Platform, onde podes explorar imagens e anotações, consultar estatísticas dos conjuntos de dados e cloná-los para treinamento na nuvem.
- African-wildlife: conjunto de dados com imagens da vida selvagem africana, incluindo búfalos, elefantes, rinocerontes e zebras.
- Argoverse: conjunto de dados Argoverse-HD para detecção 2D, com 54.446 imagens urbanas de condução autônoma distribuídas por 8 classes de objetos rodoviários.
- Tumor cerebral: um conjunto de dados para detectar tumores cerebrais em imagens de ressonância magnética cerebral, anotado com caixas delimitadoras de tumores em uma única classe.
- COCO: o COCO (Objetos comuns em contexto) é um conjunto de dados em grande escala para detecção, segmentação e legendagem de objetos, com 80 categorias de objetos.
- COCO8: um subconjunto menor das 8 primeiras imagens do COCO train2017, com 4 imagens para treinamento e 4 para validação, ideal para testes rápidos.
- COCO8-Grayscale: uma versão em escala de cinza do COCO8, criada pela conversão de RGB para escala de cinza e útil para avaliar modelos de canal único.
- COCO8-Multispectral: uma versão multiespectral de 10 canais do COCO8, criada por interpolação dos comprimentos de onda RGB e útil para avaliar modelos com consciência espectral.
- COCO12-Formats: conjunto de dados de teste com 12 imagens que abrangem 12 formatos de imagem compatíveis (AVIF, BMP, DNG, HEIC, JP2, JPEG, JPG, MPO, PNG, TIF, TIFF, WebP), usado para validar pipelines de carregamento de imagens.
- COCO16: subconjunto das 16 primeiras imagens do COCO train2017 (8 de treinamento + 8 de validação), adequado para testes rápidos.
- COCO32: subconjunto das 32 primeiras imagens do COCO train2017 (16 de treinamento + 16 de validação), adequado para testes rápidos.
- COCO64: subconjunto das 64 primeiras imagens do COCO train2017 (32 de treinamento + 32 de validação), adequado para testes rápidos.
- COCO128: um subconjunto menor das 128 primeiras imagens do COCO train2017, ideal para testes.
- Construction-PPE: conjunto de dados com trabalhadores de canteiros de obras e equipamentos de segurança identificados, como capacetes, coletes, luvas, botas e óculos de proteção. Inclui anotações de equipamentos ausentes, como no_helmet e no_goggle, para monitoramento da conformidade em situações reais.
- Global Wheat 2020: um conjunto de dados com imagens de espigas de trigo para o Global Wheat Challenge 2020.
- HomeObjects-3K: conjunto de dados de itens domésticos de interiores, incluindo camas, cadeiras, TVs e muito mais — ideal para aplicações de automação residencial inteligente, robótica, realidade aumentada e análise de layouts de ambientes.
- KITTI: conjunto de dados com cenas reais de condução e dados estéreo, LiDAR e GPS/IMU, usado aqui para tarefas de detecção de objetos 2D, como identificar carros, pedestres e ciclistas em ambientes urbanos, rurais e rodoviários.
- LVIS: um conjunto de dados em grande escala para detecção de objetos e segmentação de instâncias, com 1.203 categorias de objetos.
- Medical-pills: conjunto de dados com imagens de comprimidos, anotadas para aplicações como controle de qualidade farmacêutica, separação de comprimidos e conformidade regulatória.
- Objects365: conjunto de dados de alta qualidade e em grande escala para detecção de objetos, com 365 categorias de objetos e mais de 1,7 milhão de imagens de treinamento.
- OpenImagesV7: um conjunto de dados abrangente do Google, com 1,7 milhão de imagens de treinamento e 42 mil imagens de validação.
- Roboflow 100: Um benchmark diversificado de deteção de objetos com 100 conjuntos de dados que abrangem sete domínios de imagens para uma avaliação abrangente de modelos.
- Signature: um conjunto de dados com imagens de vários documentos que contêm assinaturas anotadas, voltado a pesquisas sobre verificação de documentos e detecção de fraudes.
- SKU-110K: um conjunto de dados com detecção densa de objetos em ambientes de varejo, com mais de 11 mil imagens e 1,7 milhão de caixas delimitadoras.
- TT100K: conjunto de dados de sinais de trânsito Tsinghua-Tencent 100K (TT100K), com 16.817 imagens de ruas distribuídas por 221 categorias de sinais para detecção e classificação.
- Ultralytics Benchmark: Um conjunto de benchmarks próprio, composto por 37 conjuntos de dados de detecção selecionados em domínios médicos, aéreos, industriais, de varejo e outros, com um protocolo fixo para medir a generalização de modelos no mundo real.
- VisDrone: um conjunto de dados com informações de detecção de objetos e rastreamento de múltiplos objetos em imagens capturadas por drones, com mais de 10 mil imagens e sequências de vídeo.
- VOC: O conjunto de dados Pascal Visual Object Classes (VOC) para deteção e segmentação de objetos, com 20 classes de objetos e mais de 11 mil imagens.
- xView: um conjunto de dados para detecção de objetos em imagens aéreas, com 60 categorias de objetos e mais de 1 milhão de objetos anotados.
Adicionar o seu próprio conjunto de dados#
Se tiver o seu próprio conjunto de dados e quiser usá-lo para treinar modelos de deteção no formato Ultralytics YOLO, certifique-se de que ele segue o formato especificado acima em "Formato Ultralytics YOLO". Converta as suas anotações para o formato necessário e especifique os caminhos, o número de classes e os nomes das classes no ficheiro de configuração YAML.
Portar ou converter formatos de rótulos#
Converter o formato do conjunto de dados COCO para o formato YOLO#
Você pode converter rótulos do formato popular do conjunto de dados COCO para o formato YOLO usando o trecho de código a seguir:
from ultralytics.data.converter import convert_coco

convert_coco(labels_dir="path/to/coco/annotations/")
Esta ferramenta de conversão pode ser usada para converter o conjunto de dados COCO ou qualquer conjunto de dados no formato COCO para o formato Ultralytics YOLO. O processo transforma as anotações COCO baseadas em JSON no formato YOLO mais simples, baseado em texto, tornando-as compatíveis com os modelos Ultralytics YOLO. Para ver o fluxo de trabalho completo — incluindo o mapeamento de IDs de classes, a estrutura de diretórios e as anotações de segmentação ou pose — consulte Converter anotações COCO para YOLO.
Lembre-se de verificar se o conjunto de dados que pretende usar é compatível com o seu modelo e segue as convenções de formato necessárias. Conjuntos de dados formatados corretamente são fundamentais para treinar modelos de deteção de objetos bem-sucedidos.
O que fazer a seguir#
Com o seu conjunto de dados formatado, comece a treinar o seu modelo. Não sabe com qual modelo pré-treinado começar? Compare as opções na família de modelos YOLO26.
Perguntas frequentes#
O formato Ultralytics YOLO é uma configuração estruturada para definir conjuntos de dados nos seus projetos de treino. Ele envolve a definição dos caminhos para as imagens de treino, validação e teste, bem como dos rótulos correspondentes. Por exemplo:
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8 dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8
# Example usage: yolo train data=coco8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8.zip
Os rótulos são guardados em ficheiros
*.txt, com um ficheiro por imagem, formatados comoclass x_center y_center width heightcom coordenadas normalizadas. Para ver um guia detalhado, consulte o exemplo do conjunto de dados COCO8.Pode converter um conjunto de dados COCO para o formato YOLO usando as ferramentas de conversão da Ultralytics. Veja um método rápido:
from ultralytics.data.converter import convert_coco

convert_coco(labels_dir="path/to/coco/annotations/")
Este código converte as anotações COCO para o formato YOLO para que possas treinar modelos Ultralytics YOLO com elas.
Ultralytics YOLO é compatível com uma ampla variedade de conjuntos de dados, incluindo:
A página de cada conjunto de dados fornece informações detalhadas sobre a estrutura e o uso, adaptadas para um treino eficiente com YOLO26. Explore a lista completa na secção Conjuntos de dados compatíveis.
Para começar a treinar um modelo YOLO26, certifique-se de que o seu conjunto de dados está formatado corretamente e que os caminhos estão definidos num ficheiro YAML. Use o seguinte script para iniciar o treino:
Exemplofrom ultralytics import YOLO model = YOLO("yolo26n.pt") # Carregar um modelo pré-treinado results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=640)A Ultralytics oferece muitos exemplos e guias práticos para usar YOLO em diversas aplicações. Visite o blog da Ultralytics para consultar estudos de caso, tutoriais detalhados e histórias da comunidade sobre detecção de objetos, segmentação e muito mais. Para exemplos específicos, consulte a página do modo Predict na documentação.


Comentários54
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
zcoolster11
Python Head Bop
 Paula DerrengerUltralytics
@zcoolster11, could you clarify what you mean by “Python Head Bop” and what you’d like to do with Ultralytics YOLO? Feel free to drop your dataset or Python questions here in the discussion so the Ultralytics team can help.
 Murat Raimbekov
hey @orz-serein, short answer: no, you don't need empty label files for background images - just leave the
.txtout.i verified this empirically on the current main branch. setup: 5 images, 2 with real labels, 1 with an empty
.txtfile, 2 without any.txtfile at all. building aYOLODatasetover them gives:Scanning /tmp/bgtest_full/labels... 3 images, 3 backgrounds, 0 corrupt: 100% 5/5all 5 images are kept. the 3 without labels (the empty-
.txtone and the two with no.txtat all) all end up with the same(0, 5)labels array - they are treated identically as background images.so both options work:
- no
.txtfile: counted as "missing" (nm=1), no labels -> background - empty
.txtfile: counted as "empty" (ne=1), no labels -> background
both end up in the same
backgrounds = nm + nebucket inultralytics/data/dataset.py.this is also stated in the detection dataset docs:
If there are no objects in an image, no
*.txtfile is required.how many background images: the yolov5 training tips recommend 0-10% of the dataset as background images to reduce false positives (coco has about 1% background).
hope this helps!
- no
 serein
Hello, I would like to ask a question. During the stage of preparing the training dataset, if some images do not have the target to be detected, do I need to add corresponding empty label files in the label folder?
Fatima-khanjar
Hello, I hope this message finds you well.
I have a question regarding fine-tuning a pre-trained YOLO model (e.g., trained on the COCO dataset) on my custom dataset. My dataset includes both new classes (not present in COCO) and the same existing classes (e.g., toothbrush, car), but with different layouts. Specifically, I would like to add my new classes starting from index 80, while still leveraging the pre-trained weights for the common classes, which are the same but with different layouts.
Is it possible to use the pre-trained weights for the common classes and only train the model on the new classes, while ensuring that the pre-trained knowledge for the common classes is preserved? If so, could you please guide me on how to proceed?
Thank you for your time and assistance. best regards,
bimal-gajera
Hello, I'm working on multiple dataset formats for object detection. For the YOLO dataset format, is there any way I can rename the labels directory and put it in yaml file? Something like this:
path: path_to_root_directory
train: train\images
val: val\images
test: test\images

labels_dir: yolo

nc: 1
names: ['object']
yolo directory has yolo annotations (*.txt files), and it's inside respective train, val and test directory.
 Glenn JocherUltralytics(editado)
@bimal-gajera currently, the
labels_dirkey is not supported in the YAML file. Ultralytics finds label files by replacing the last/images/directory in each image path with/labels/, so each split needs siblingimages/andlabels/directories (for exampletrain/imagesandtrain/labels). For more details, refer to the Object Detection Datasets Overview.1
nitya-pandey-astro
Hello Team, I am using YOLO for detecting trails of slow-moving astronomical objects in my images. While the model detects the trails, the bounding boxes predicted around the objects are not tight enough. The boxes tend to be too loose or not well-shaped to fit the elongated, irregular trails, resulting in inaccurate object localization. I suspect, YOLO's standard rectangular bounding box not being well-suited for the elongated, curving shapes of the trails. Could you provide guidance on how to improve bounding box accuracy for this specific use case?
- Glenn JocherUltralytics(editado)
@astronitya thank you for your question! For detecting elongated or irregular trails, consider using Oriented Bounding Boxes (OBB), which may better fit your objects' shapes compared to standard rectangular boxes. You can format your dataset in the YOLO OBB format and train a YOLO26 OBB model. Please refer to the Oriented Bounding Box (OBB) Datasets Overview for details on dataset formatting and training. Let me know if you need further clarification!
@glenn-jocher Thankyou very much for the prompt response. I am going to work on your suggestions.
Yuxuan1998
Hi team, I am a little bit confused with the dataset folder structure. For most dataset I used, it strunctured in the way that each of
train/andval/folders containsimages/andlabels/folders. However, the COCO8 dataset example shows the opposite way, each ofimages/andlabels/folder containstest/andval/folders. Does the folder structure matter here? Thanks in advance- Glenn JocherUltralytics(editado)
@Yuxuan1998 both layouts work, as long as each image has a sibling
labelsdirectory: Ultralytics finds the label for an image by replacing the last/images/in its path with/labels/(sotrain/images/img.jpgusestrain/labels/img.txt, andimages/train/img.jpguseslabels/train/img.txt). Set the paths in your dataset's YAML file to the image directories. For details, refer to the Object Detection Datasets Overview. Let us know if you need further clarification!1
milanaveed
Hello, can you please fix the broken images on this page? Can't see the label file example.
wgdcxy
Hello, my label and image files are stored according to the requirements, but they are still not recognized, and the following is an error message Thank you in advance
WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1138.41it/s] train: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. train: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1617.94it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train3\labels.jpg...
- Glenn JocherUltralytics
It seems like your dataset labels are not being recognized. Please ensure your label files are in the correct YOLO format and that the directory is writable. For detailed guidance, visit the dataset formatting section at https://docs.ultralytics.com/datasets/detect/.
Hi, but my file path is very accurate, and I checked it N times, so is there any otherreason? Thank you
- Glenn JocherUltralytics
@wgdcxy please ensure your label files are in the correct YOLO format, with one
.txtfile per image containing normalized coordinates. Also, verify that the directory permissions allow writing. For more details, refer to the dataset formatting guide linked earlier. Hello, I'm a student whose English is not particularly good, so some places may not be clear, and secondly, this is not an error but a warning.I don't know why it's the background that reads, not the images. The warnings are as follows: val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%| 30/30 [00:00<00:00, 495.76it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train4\labels.jpg...
Then this warning tells me that the cache file is missing, and I don't know why I can't generate a cache file for the file I created, so I'm here to ask you guys. Below is my own yaml file: # Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..] path: ../cs # dataset root dir train: images/ttb # train images (relative to 'path') 128 images val: images/ttj # val images (relative to 'path') 128 images test: # test images (optional) # Classes names : 0 : wf
Below is my label file: 0 0.6799428104575164 0.5005859375 0.6844771241830065 0.500537109375 0.6845996732026144 0.497265625 0.6802696078431373 0.497119140625 0 0.6803104575163399 0.4935546875 0.6848039215686275 0.493505859375 0.6847630718954248 0.497119140625 0.6802696078431373 0.49697265625 0 0.6802696078431373 0.49013671875 0.6849673202614379 0.490185546875 0.6849264705882353 0.49345703125 0.6803513071895425 0.493359375 0 0.6805555555555556 0.48662109375 0.6850898692810458 0.486767578125 0.6850490196078431 0.490234375 0.6803513071895425 0.490234375 0 0.6808415032679739 0.483447265625 0.6852941176470588 0.48349609375 0.6852124183006536 0.486767578125 0.6806781045751634 0.486669921875 0 0.6806372549019607 0.47998046875 0.6854166666666666 0.47998046875 0.6853349673202613 0.48349609375 0.6808415032679738 0.48359375
Finally, this yolo can be run, but I don't know why the result is 0. Here's how it works: Transferred 381/417 items from pretrained weights 195/200 8.73G 0 0 nan 0 0 2464: 100%|██████████| 8/8 [01:37<00:00, 12.13s/it] Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95): 100%|[00:31<00:00, 7.91s/it] all 30 0 0 0 0 0 0 0 0 0 Finally, thank you for explaining it to me
By the way, the size of my picture is 2448x2048, so the imgsz entered is 2448, and your code changed the size of my picture to 2464, is it related to this. imgsz=[2448] must be multiple of max stride 32, updating to [2464]
I apologize, I found a small mistake of mine. I wrote the file name as "labels" instead of "lables" which I intended to write.Please forgive my carelessness.After all, who doesn't make mistakes. I'll come back to you next time I have a problem. Thank you for your help.
Transferred 417/417 items from pretrained weights Freezing layer 'model.22.dfl.conv.weight' AMP: running Automatic Mixed Precision (AMP) checks with YOLOv8n... AMP: checks passed ✅ WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache... 30 images, 0 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<?, ?it/s] Hello, here I am again, with a new problem, how to solve this problem about image size?Ask for answers, thank you
- Glenn JocherUltralytics
@wgdcxy to address the image size issue, ensure your
imgszis a multiple of 32, as required by the model's architecture. This adjustment helps maintain compatibility with the model's stride. If you have further questions, feel free to ask! WARNING ⚠️ NMS time limit 0.900s exceeded. Hello, my teacher who has never met, what should I do with this warning?
- Glenn JocherUltralytics(editado)
@wgdcxy the "NMS time limit exceeded" warning is not controlled by an
nmsargument. It appears when too many candidate boxes need to be processed within the time limit, which is common early in training when validation uses a low confidence threshold. It usually stops as the model trains, and you can reduce it by raisingconfor loweringmax_detduring validation. If you have further questions, feel free to ask! Hello, I'm here again. The issue this time is still the same warning. I adjusted the max_time_img to 0.1 in ops. py, but I don't feel it's right. So I came to ask for your help because it still shows this warning. I hope you can tell me where to make the adjustment. Thank you again. WARNING ⚠️ NMS time limit 0.900s exceeded
How can these values be improved? We can only continue training or increase the training dataset. Epoch GPU_mem box_loss seg_loss cls_loss dfl_loss Instances Size 11/500 11G nan 6.21 nan nan 132 2464: 100%|██████████| 8/8 [01:56<00:00, 14.59s/it] Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95): 100%|██████████| 4/4 [00:54<00:00, 13.56s/it] all 30 664 0 0 0 0 0 0 0 0
- Glenn JocherUltralytics
To improve your model's performance, consider increasing the dataset size, enhancing data quality, or adjusting hyperparameters. If issues persist, reviewing the dataset for label accuracy and distribution might help.
WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1138.41it/s] train: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. train: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1617.94it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train3\labels.jpg...
这个问题该如何解决?
- Glenn JocherUltralytics
It looks like your dataset labels are missing or not formatted correctly. Please ensure your labels are in the YOLO format and check the directory permissions. For detailed guidance, visit the dataset formatting section at https://docs.ultralytics.com/datasets/detect/.