Exportação para Intel OpenVINO#
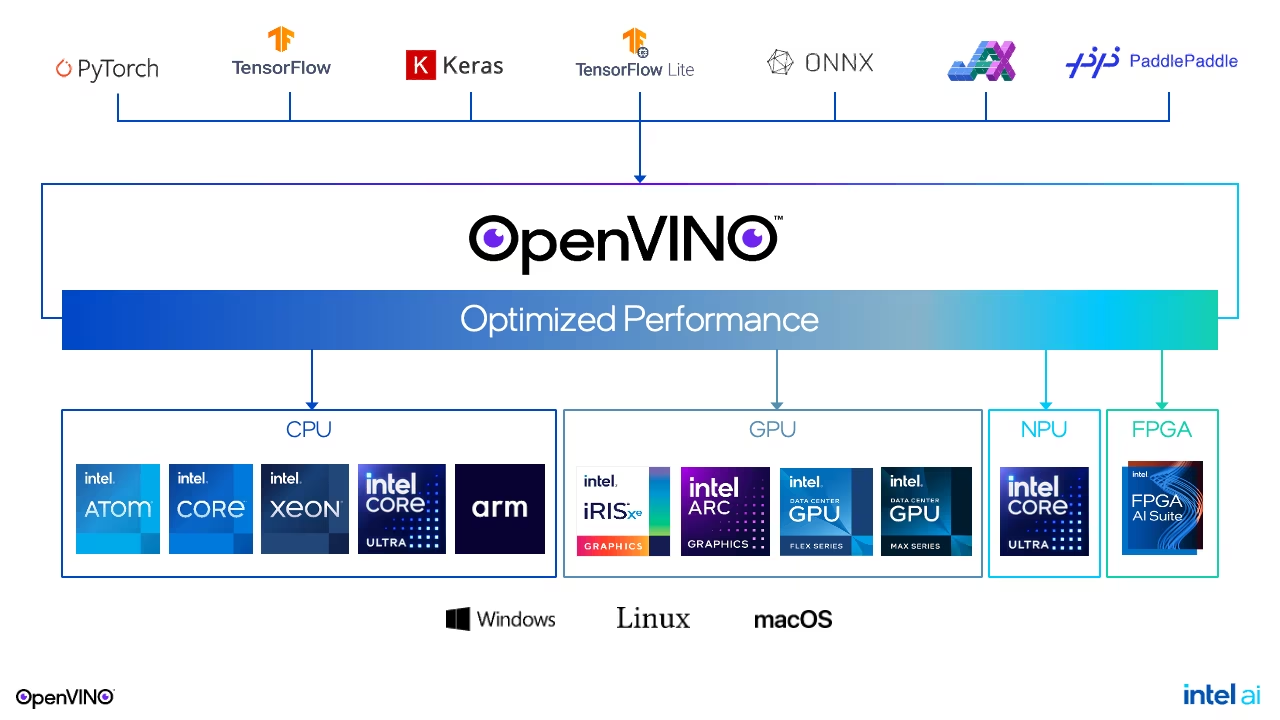
Neste guia, abordamos a exportação de modelos YOLO26 para o formato OpenVINO, que pode proporcionar até 3x mais velocidade em CPU, além de acelerar a inferência YOLO em hardware GPU e NPU da Intel.
OpenVINO, abreviatura de kit de ferramentas de inferência visual aberta e otimização de redes neuronais, é um kit de ferramentas abrangente para otimizar e implementar modelos de inferência de IA. Apesar de o nome incluir «Visual», o OpenVINO também é compatível com várias outras tarefas, incluindo linguagem, áudio, séries temporais, etc.
Assista: Como exportar Ultralytics YOLO26 para o formato Intel OpenVINO para acelerar a inferência 🚀
Tarefas suportadas#
A exportação para OpenVINO é compatível com todas as sete tarefas da Ultralytics. A segmentação semântica e a estimativa de profundidade estão disponíveis apenas no YOLO26, a única família que inclui essas cabeças.
| Tarefa | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detetar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semântica | ❌ | ❌ | ✅ |
| Profundidade | ❌ | ❌ | ✅ |
| Classificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Instalação#
Instala as dependências de exportação do OpenVINO com:
pip install "ultralytics[export-openvino]"Estas dependências também estão incluídas em ultralytics[export] e são instaladas automaticamente quando necessárias para uma exportação.
Exemplos de uso#
O formato OpenVINO é compatível com os modos Exportar, Prever e Validar. Exporta o teu modelo e, em seguida, carrega o modelo exportado para executar a inferência ou validar a respetiva precisão numa CPU, GPU integrada ou dedicada, ou NPU da Intel.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta o modelo para o formato OpenVINO
model.export(format="openvino") # creates 'yolo26n_openvino_model/'from ultralytics import YOLO
# Carrega o modelo OpenVINO exportado
model = YOLO("yolo26n_openvino_model/")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")
# Executa a inferência num dispositivo específico; dispositivos disponíveis: ["intel:gpu", "intel:npu", "intel:cpu"]
results = model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")from ultralytics import YOLO
# Carrega o modelo OpenVINO exportado
model = YOLO("yolo26n_openvino_model/")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'openvino' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
imgsz | int ou tuple | 640 | Tamanho de imagem desejado para a entrada do modelo. Pode ser um inteiro para imagens quadradas ou uma tupla (height, width) para dimensões específicas. |
quantize | int ou str | None | Precisão da quantização: 16 (FP16) ou 8 (INT8/PTQ; requer calibração data/fraction); 32/não definido corresponde a FP32. Substitui as opções obsoletas half/int8. |
dynamic | bool | False | Permite tamanhos de entrada dinâmicos, aumentando a flexibilidade para processar imagens com dimensões variáveis. |
nms | bool, opcional | None | Seleciona a saída bruta (None, padrão), NMS incorporado (True) ou a cabeça sem NMS (False). |
batch | int | 1 | Especifica o tamanho do lote de inferência do modelo exportado ou o número máximo de imagens que o modelo exportado processará em simultâneo no modo predict. |
data | str | None | Caminho para o YAML do conjunto de dados, essencial para a quantização; para classificação, aceita um diretório de conjunto de dados ou o nome de um conjunto de dados integrado. Se for omitido com quantize=8, a Ultralytics seleciona o conjunto de dados de calibração predefinido para a tarefa do modelo. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração como proporção, número de imagens ou proporções/contagens [train, val, test]. Listas de dois itens deixam test completo, enquanto 0 o ignora. |
device | str | None | Especifica o dispositivo para a exportação: CPU (device=cpu), MPS para Apple silicon (device=mps). |
Para mais detalhes sobre o processo de exportação, visita a página da documentação da Ultralytics sobre exportação.
O OpenVINO™ é compatível com a maioria dos processadores Intel®, mas, para garantir um desempenho ideal:
-
Verifica a compatibilidade com o OpenVINO™ Confirma se o teu chip Intel® é oficialmente compatível com o OpenVINO™ através da lista de compatibilidade da Intel.
-
Identifica o teu acelerador Determina se o teu processador inclui uma NPU (Unidade de processamento neural) ou GPU integrada consultando o guia de hardware da Intel.
-
Instala os controladores mais recentes Se o teu chip for compatível com uma NPU ou GPU, mas o OpenVINO™ não a detetar, talvez tenhas de instalar ou atualizar os controladores associados. Segue as instruções de instalação dos controladores para ativar a aceleração completa.
Seguindo estes três passos, podes garantir que o OpenVINO™ funciona de forma ideal no teu hardware Intel®.
Vantagens do OpenVINO#
- Desempenho: o OpenVINO oferece inferência de alto desempenho, aproveitando a capacidade das CPUs, GPUs integradas e dedicadas e FPGAs da Intel.
- Compatibilidade com execução heterogénea: o OpenVINO oferece uma API que permite escrever uma vez e implementar em qualquer hardware Intel compatível (CPU, GPU, FPGA, VPU, etc.).
- Otimizador de modelos: o OpenVINO oferece um Otimizador de modelos que importa, converte e otimiza modelos de frameworks populares de aprendizagem profunda, como PyTorch, TensorFlow, TensorFlow Lite, Keras, ONNX, PaddlePaddle e Caffe.
- Facilidade de utilização: o kit de ferramentas inclui uma vasta coleção de notebooks tutoriais (incluindo a otimização de YOLO26) que ensinam diferentes aspetos do kit.
Estrutura da exportação para OpenVINO#
Quando exportas um modelo para o formato OpenVINO, é criado um diretório que contém:
- Ficheiro XML: descreve a topologia da rede.
- Ficheiro BIN: contém os dados binários dos pesos e dos bias.
- Ficheiro de metadados:
metadata.yamlcontém metadados do modelo, como os nomes das classes, o tamanho da imagem e a tarefa, que a Ultralytics lê ao carregar o modelo.
Podes usar estes ficheiros para executar a inferência com o OpenVINO Runtime.
Utilizar a exportação OpenVINO na implementação#
Depois de exportares o modelo com êxito para o formato OpenVINO, tens duas opções principais para executar a inferência:
-
Usa o pacote
ultralytics, que oferece uma API de alto nível e encapsula o OpenVINO Runtime. -
Usa o pacote nativo
openvinopara ter um controlo mais avançado ou personalizado sobre o comportamento da inferência.
Inferência com a Ultralytics#
O pacote ultralytics permite executar facilmente a inferência com o modelo OpenVINO exportado através do método predict. Também podes especificar o dispositivo de destino (por exemplo, intel:gpu, intel:npu, intel:cpu) usando o argumento device.
from ultralytics import YOLO

# Carrega o modelo OpenVINO exportado
ov_model = YOLO("yolo26n_openvino_model/")  # o caminho do modelo OpenVINO exportado
# Executa a inferência com o modelo exportado
ov_model.predict(device="intel:gpu")  # especifica o dispositivo em que pretendes executar a inferência
Esta abordagem é ideal para prototipagem rápida ou implementação quando não precisas de controlo total sobre o pipeline de inferência.
Inferência com o OpenVINO Runtime#
O OpenVINO Runtime oferece uma API unificada para inferência em todo o hardware Intel compatível. Também oferece funcionalidades avançadas, como balanceamento de carga entre hardware Intel e execução assíncrona. Para mais informações sobre como executar a inferência, consulta os notebooks YOLO26.
Lembra-te de que vais precisar dos ficheiros XML e BIN, bem como de quaisquer definições específicas da aplicação, como o tamanho da entrada, o fator de escala para normalização, etc., para configurar e usar corretamente o modelo com o Runtime.
Na tua aplicação de implementação, normalmente seguirias estes passos:
- Inicializa o OpenVINO criando
core = Core(). - Carrega o modelo com o método
core.read_model(). - Compila o modelo com a função
core.compile_model(). - Prepara a entrada (imagem, texto, áudio, etc.).
- Executa a inferência usando
compiled_model(input_data).
Para obter instruções mais detalhadas e exemplos de código, consulta a documentação do OpenVINO ou o tutorial da API.
Benchmarks do YOLO26 com OpenVINO#
A equipa da Ultralytics realizou benchmarks do YOLO26 em vários formatos de modelo e níveis de precisão, avaliando a velocidade e a precisão em diferentes dispositivos Intel compatíveis com OpenVINO.
-
Os resultados dos benchmarks abaixo são apenas uma referência e podem variar consoante a configuração exata de hardware e software de um sistema, bem como a carga de trabalho atual do sistema no momento da execução dos benchmarks.
-
Todos os benchmarks foram executados com o pacote Python
openvino, versão 2026.2.1. -
Os modelos YOLO26 em NPU só são compatíveis com sistemas Intel® Core™ Ultra™ das séries 2xxV e 3xx ou superiores.
Intel® Core™ Ultra#
A série Intel® Core™ Ultra™ estabelece um novo patamar de computação de alto desempenho, concebida para satisfazer as necessidades em evolução dos utilizadores modernos — desde jogadores e criadores a profissionais que utilizam IA. Esta linha de nova geração é mais do que uma série tradicional de CPUs: combina núcleos de CPU potentes, capacidades de GPU integrada de alto desempenho e uma Unidade de processamento neural (NPU) dedicada num único chip, oferecendo uma solução unificada para diversas cargas de trabalho computacionais intensivas.
No centro da arquitetura Intel® Core Ultra™ está um design híbrido que permite um desempenho excecional em tarefas de processamento tradicionais, cargas de trabalho aceleradas por GPU e operações baseadas em IA. A inclusão da NPU melhora a inferência de IA no dispositivo, permitindo aprendizagem automática e processamento de dados mais rápidos e eficientes numa vasta gama de aplicações.
A família Core Ultra™ inclui vários modelos adaptados a diferentes necessidades de desempenho, com opções que vão desde designs energeticamente eficientes a variantes de alta potência identificadas pela designação «H» — ideais para portáteis e formatos compactos que exigem grande capacidade computacional. Em toda a linha, os utilizadores beneficiam da sinergia da integração de CPU, GPU e NPU, que oferece eficiência, capacidade de resposta e funcionalidades multitarefa notáveis.
Como parte da inovação contínua da Intel, a série Core Ultra™ estabelece um novo padrão para a computação preparada para o futuro. Com vários modelos disponíveis e outros a caminho, esta série reforça o compromisso da Intel em oferecer soluções de ponta para a próxima geração de dispositivos inteligentes melhorados com IA.
Os benchmarks abaixo foram executados em Intel® Core™ Ultra™ X7 358H, Intel® Core™ Ultra™ 7 258V e Intel® Core™ Ultra™ 7 155H, com precisão FP32, FP16 e INT8.
Intel® Core™ Ultra™ X7 358H#
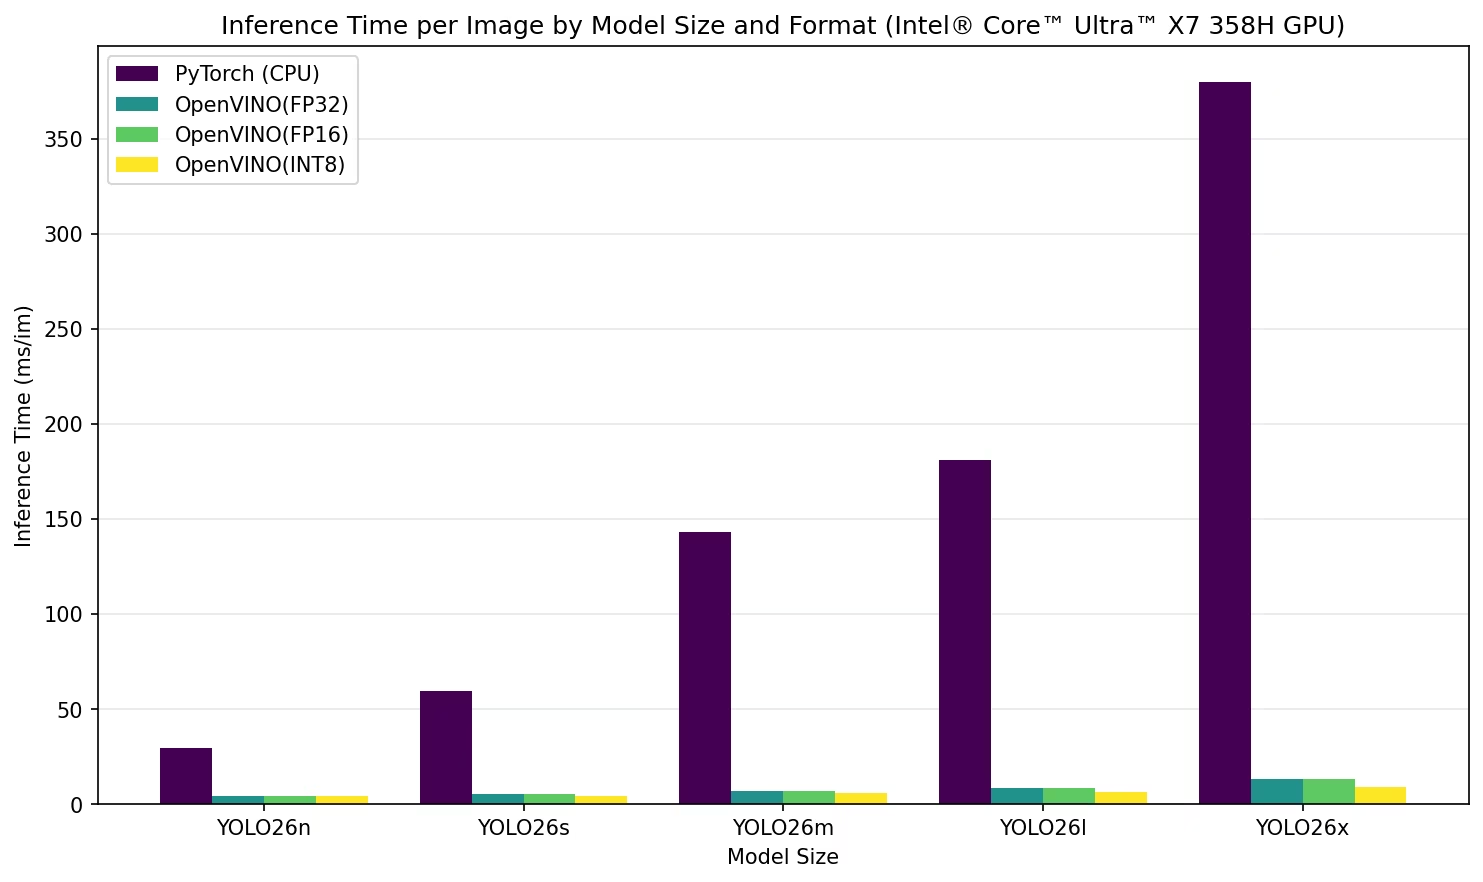
Resultados detalhados dos benchmarks
| Modelo | Formato | Precisão | Status | Tamanho (MB) | metrics/mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 29.28 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.7 | 0.4762 | 4.09 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4762 | 4.03 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 4.24 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 59.32 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 5.08 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.7 | 0.5616 | 5.14 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 4.47 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 143.21 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6166 | 7.1 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6166 | 7.06 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.61 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 181.16 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6205 | 8.45 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6205 | 8.49 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 6.25 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 379.75 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.3 | 0.6568 | 13.03 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 12.98 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 8.74 |
Intel® Core™ Ultra™ 7 258V#
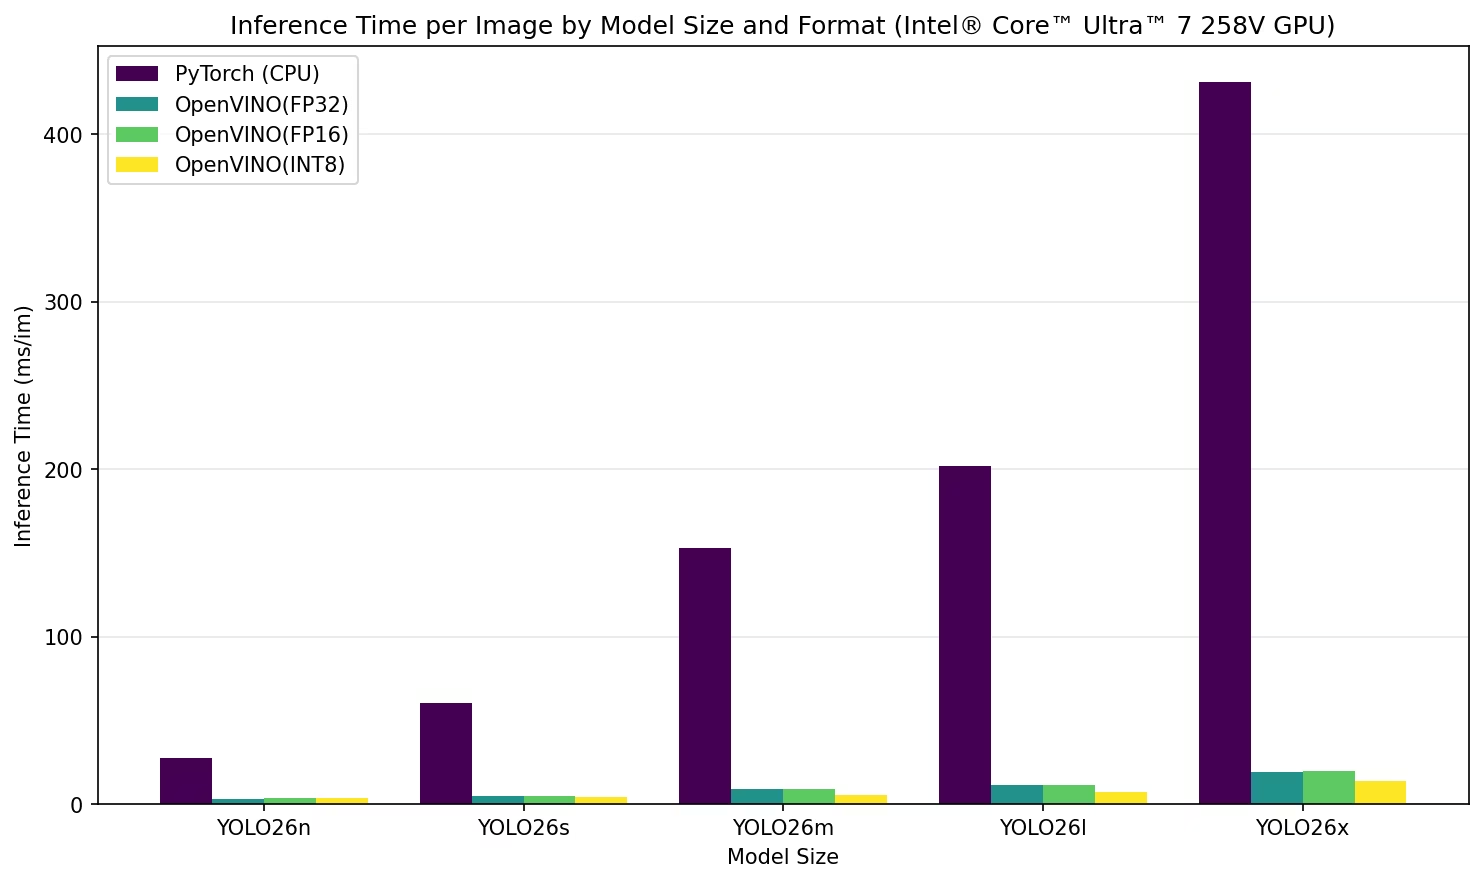
Resultados detalhados dos benchmarks
| Modelo | Formato | Precisão | Status | Tamanho (MB) | metrics/mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 27.33 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4764 | 3.33 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4764 | 3.34 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 3.46 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 60.2 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 4.66 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 4.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 3.99 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 152.87 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6168 | 9.03 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6168 | 8.98 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.7 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 201.57 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6203 | 11.32 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6203 | 11.36 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 7.45 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 431.04 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6568 | 19.08 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 19.63 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 13.69 |
Intel® Core™ Ultra™ 7 155H#
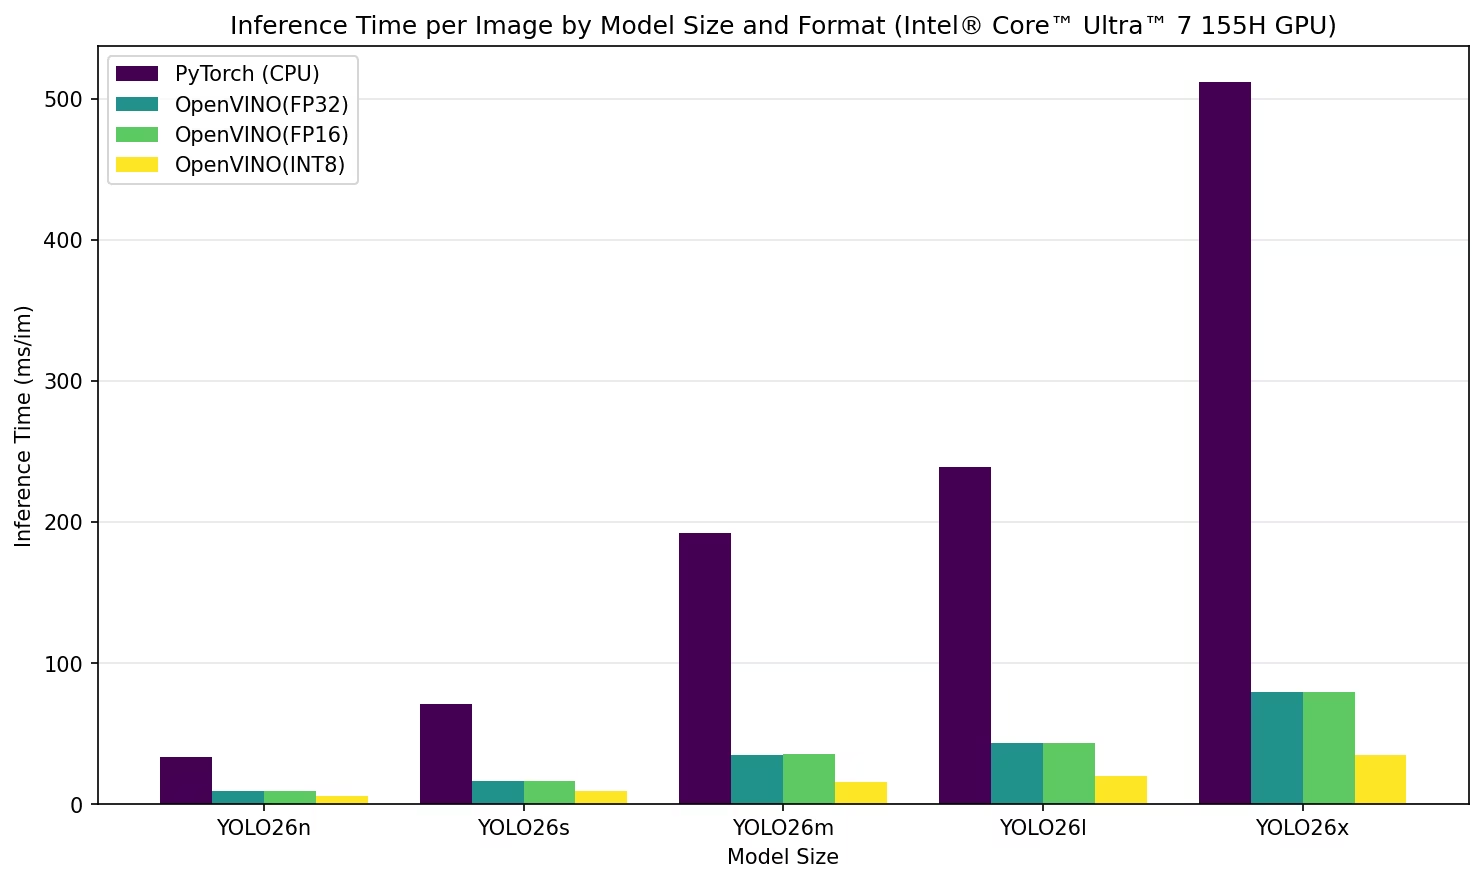
Resultados detalhados dos benchmarks
| Modelo | Formato | Precisão | Status | Tamanho (MB) | metrics/mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 33.19 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4758 | 9.13 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4758 | 9.07 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4573 | 5.79 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 70.92 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 16.37 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 16.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.545 | 9.27 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 192.45 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6167 | 34.47 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6167 | 35.71 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6039 | 15.46 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 239.19 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.621 | 43.24 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.621 | 43.4 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5999 | 19.72 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 511.89 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6552 | 79.49 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6552 | 79.45 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.642 | 34.66 |
Reproduza nossos resultados#
Para reproduzir os benchmarks da Ultralytics acima em todos os formatos de exportação, executa este código:
from ultralytics import YOLO

# Carregar um modelo YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Benchmarke a velocidade e a precisão do YOLO26n no conjunto de dados COCO128 para todos os formatos de exportação
results = model.benchmark(data="coco128.yaml")
Os resultados dos benchmarks podem variar consoante a configuração exata de hardware e software de um sistema, bem como a carga de trabalho atual do sistema no momento da execução dos benchmarks. Para obter resultados mais fiáveis, usa um conjunto de dados com um grande número de imagens, ou seja, data='coco.yaml' (5000 imagens de validação).
Conclusão#
Os resultados dos benchmarks demonstram claramente as vantagens de exportar o modelo YOLO26 para o formato OpenVINO. Em diferentes modelos e plataformas de hardware, o formato OpenVINO supera consistentemente outros formatos em velocidade de inferência, mantendo uma precisão comparável.
Os benchmarks destacam a eficácia do OpenVINO como ferramenta para implementar modelos de deep learning. Ao converter os modelos para o formato OpenVINO, os desenvolvedores podem obter melhorias significativas de desempenho, facilitando a implementação desses modelos em aplicações do mundo real.
Para obter informações e instruções mais detalhadas sobre como usar o OpenVINO, consulta a documentação oficial do OpenVINO.
Perguntas frequentes#
Exportar modelos YOLO26 para o formato OpenVINO pode aumentar significativamente a velocidade na CPU e permitir aceleração por GPU e NPU em hardware Intel. Para exportar, podes usar Python ou CLI, como mostrado abaixo:
Exemplofrom ultralytics import YOLO # Carregar um modelo YOLO26n PyTorch model = YOLO("yolo26n.pt") # Exporta o modelo model.export(format="openvino") # creates 'yolo26n_openvino_model/'Para obter mais informações, consulta a documentação dos formatos de exportação.
Usar o kit de ferramentas OpenVINO da Intel com modelos YOLO26 oferece várias vantagens:
- Desempenho: obtém até 3 vezes mais velocidade na inferência na CPU e aproveita as GPU e NPU da Intel para aceleração.
- Otimizador de modelos: converte, otimiza e executa modelos de frameworks populares como PyTorch, TensorFlow e ONNX.
- Facilidade de uso: está disponível uma grande coleção de notebooks tutoriais para ajudar os utilizadores a começar, incluindo alguns para YOLO26.
- Execução heterogénea: implementa modelos em vários dispositivos Intel com uma API unificada.
Para comparações detalhadas de desempenho, visita a nossa secção de benchmarks.
Depois de exportares um modelo YOLO26n para o formato OpenVINO, podes executar inferência com Python ou CLI:
Exemplofrom ultralytics import YOLO # Carrega o modelo OpenVINO exportado ov_model = YOLO("yolo26n_openvino_model/") # Executar inferência results = ov_model("https://ultralytics.com/images/bus.jpg")Consulta a nossa documentação do modo de previsão para obteres mais detalhes.
Ultralytics YOLO26 está otimizado para a deteção de objetos em tempo real com alta precisão e velocidade. Mais especificamente, quando combinado com OpenVINO, YOLO26 oferece:
- Até 3 vezes mais velocidade em CPUs Intel
- Implementação simples em GPU e NPU Intel
- Precisão consistente e comparável em vários formatos de exportação
Para uma análise de desempenho aprofundada, consulta os nossos benchmarks detalhados de YOLO26 em diferentes hardwares.
Sim, podes comparar o desempenho de modelos YOLO26 em vários formatos, incluindo PyTorch, TorchScript, ONNX e OpenVINO. Usa o seguinte trecho de código para executar benchmarks no conjunto de dados que escolheres:
Exemplofrom ultralytics import YOLO # Carregar um modelo YOLO26n PyTorch model = YOLO("yolo26n.pt") # Compara a velocidade e a precisão de YOLO26n no conjunto de dados COCO8 em todos os formatos de exportação results = model.benchmark(data="coco8.yaml")Para consultar os resultados detalhados dos benchmarks, vê a nossa secção de benchmarks e a documentação dos formatos de exportação.