Exportação de modelos YOLO26 para TorchScript para implantação rápida#
O PyTorch tornou o TorchScript obsoleto e está removendo gradualmente seus recursos. Para novas implantações móveis e de borda, use a integração ExecuTorch, que tem suporte ativo. A Ultralytics mantém a exportação regular para TorchScript para garantir compatibilidade com código C++ legado.
A implantação de modelos de visão computacional em ambientes C++ sem Python exige uma representação serializada portátil. O TorchScript oferece essa compatibilidade para aplicações legadas do LibTorch.
Exporte para TorchScript para serializar seus modelos Ultralytics YOLO26 e obter compatibilidade multiplataforma e uma implantação simplificada. Neste guia, mostraremos como exportar seus modelos YOLO26 para o formato TorchScript, facilitando o uso deles em uma gama mais ampla de aplicações.
Por que exportar para TorchScript?#
Desenvolvido pelos criadores do PyTorch, o TorchScript é uma ferramenta poderosa para otimizar e implantar modelos PyTorch em diversas plataformas. Exportar modelos YOLO26 para TorchScript é fundamental para passar da pesquisa às aplicações do mundo real. O TorchScript, que faz parte do framework PyTorch, facilita essa transição ao permitir o uso de modelos PyTorch em ambientes sem suporte a Python.
O processo envolve duas técnicas: rastreamento e criação de scripts. O rastreamento registra as operações durante a execução do modelo, enquanto a criação de scripts permite definir modelos usando um subconjunto de Python. Essas técnicas garantem que modelos como YOLO26 continuem funcionando mesmo fora do ambiente Python habitual.
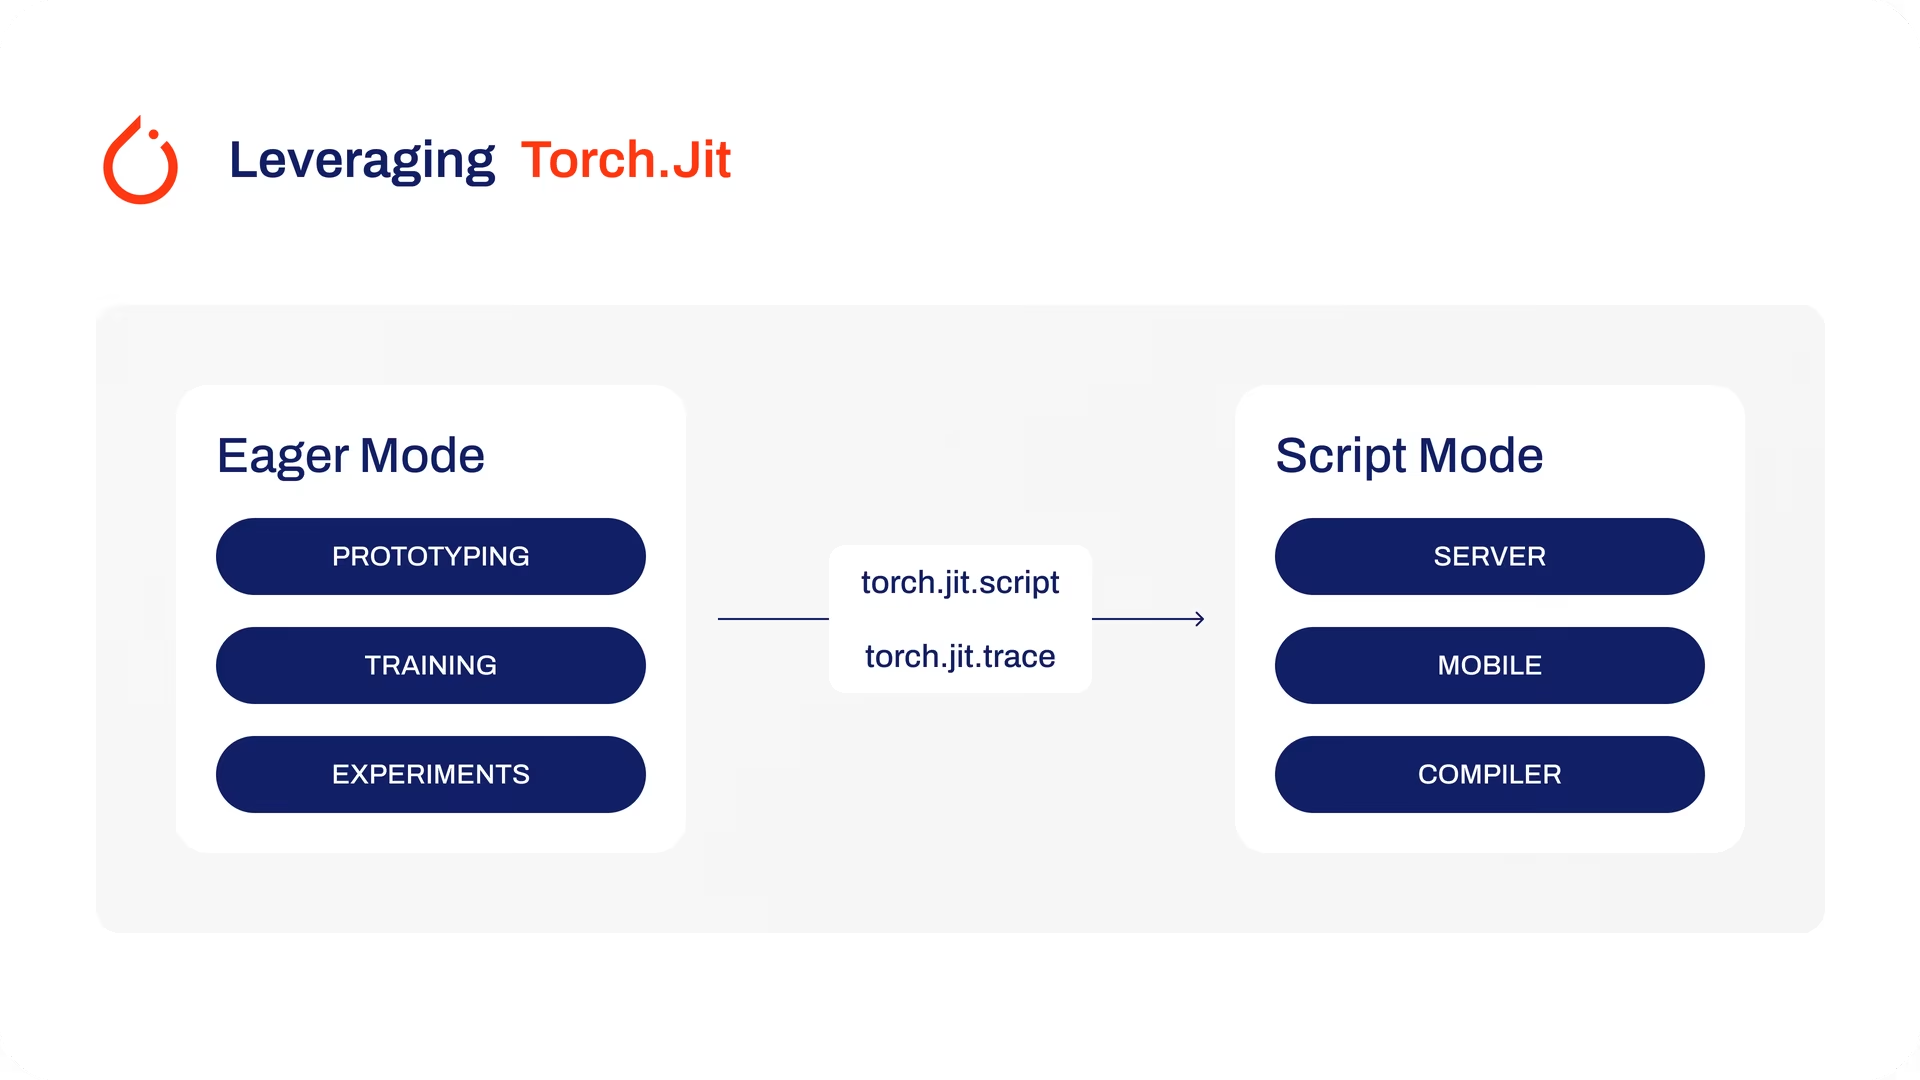
Os modelos TorchScript também podem ser otimizados com técnicas como fusão de operadores e melhorias no uso da memória, garantindo uma execução eficiente. Outra vantagem de exportar para TorchScript é o potencial de acelerar a execução do modelo em diversas plataformas de hardware. O TorchScript cria uma representação autônoma, pronta para produção, do seu modelo PyTorch, que pode ser integrada a ambientes C++.
Principais recursos dos modelos TorchScript#
O TorchScript, parte essencial do ecossistema PyTorch, oferece recursos poderosos para otimizar e implantar modelos de deep learning.
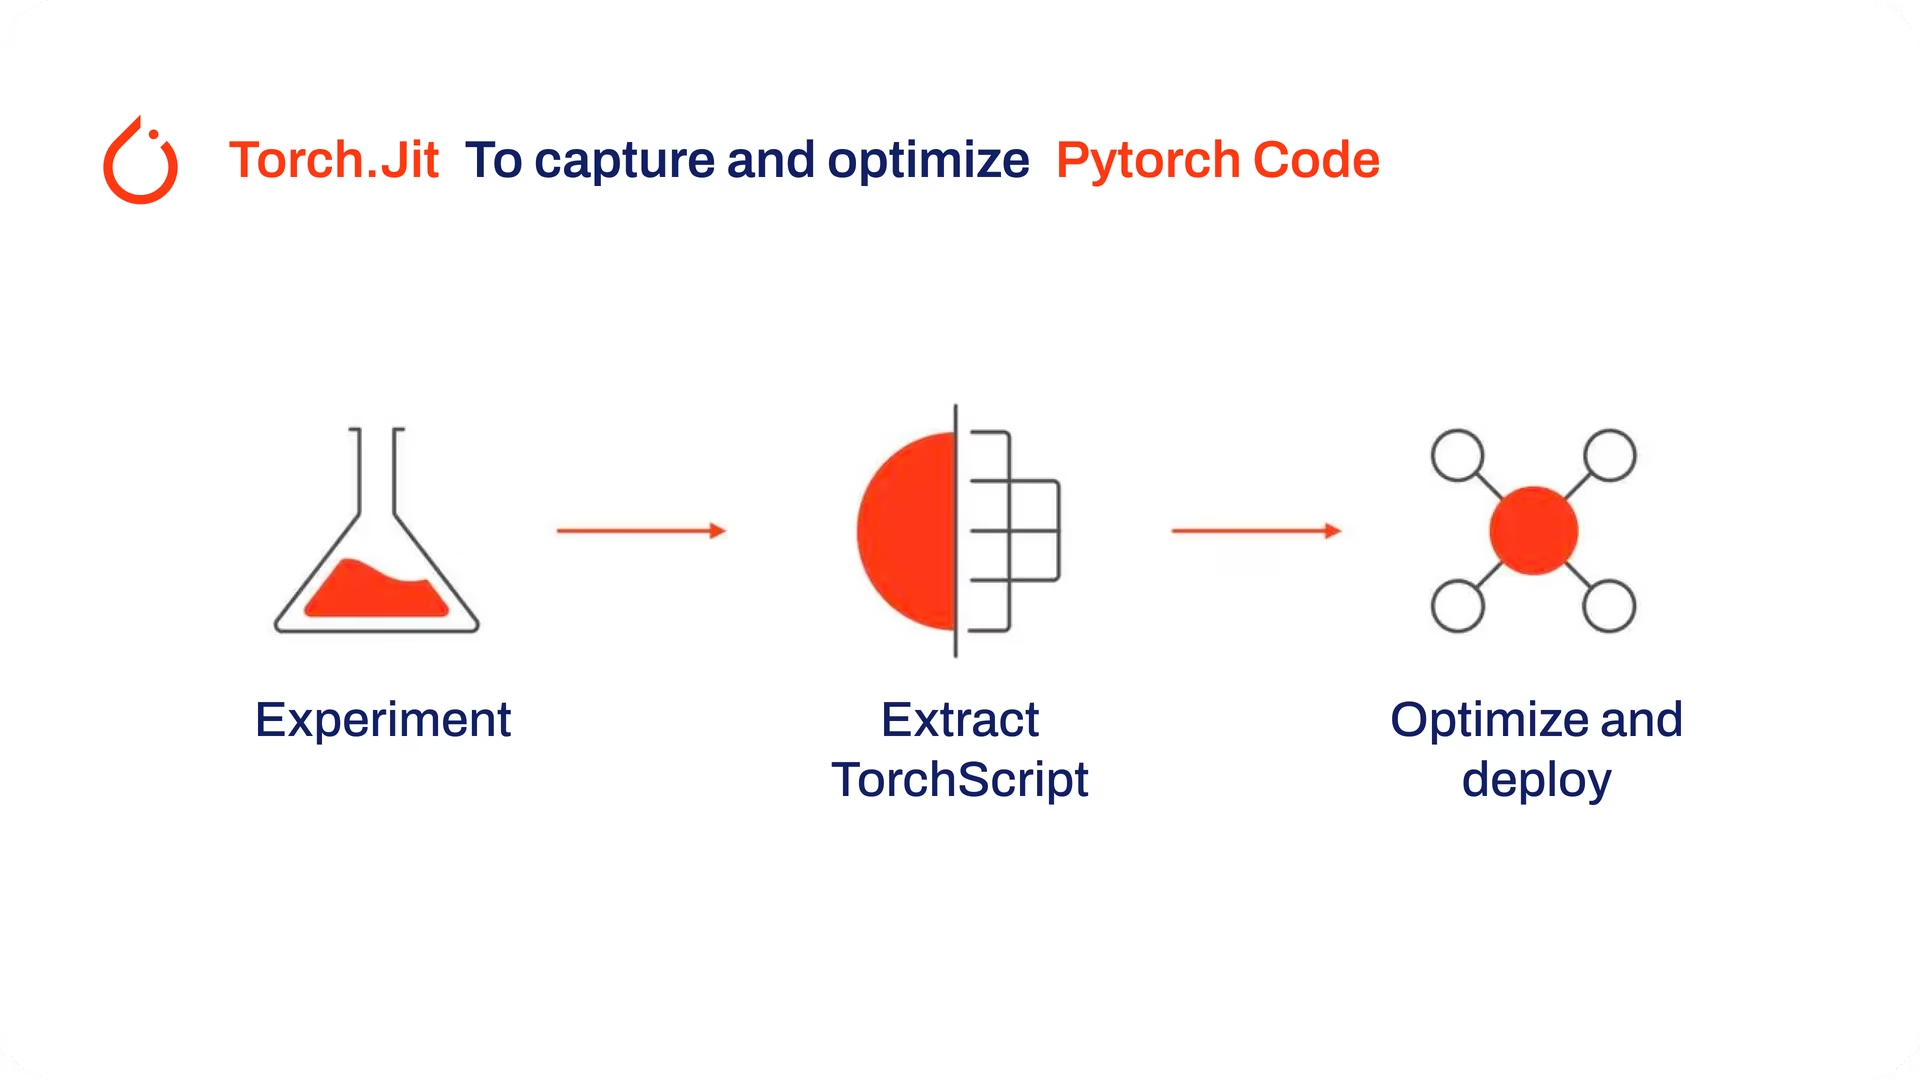
Veja os principais recursos que fazem do TorchScript uma ferramenta valiosa para desenvolvedores:
-
Execução com grafo estático: o TorchScript usa uma representação em grafo estático dos cálculos do modelo, diferente da execução com grafo dinâmico do PyTorch. Na execução com grafo estático, o grafo computacional é definido e compilado uma vez antes da execução propriamente dita, o que melhora o desempenho durante a inferência.
-
Serialização de modelos: o TorchScript permite serializar modelos PyTorch em um formato independente de plataforma. Os modelos serializados podem ser carregados sem o código Python original, permitindo a implantação em diferentes ambientes de execução.
-
Compilação JIT: o TorchScript usa compilação Just-In-Time (JIT) para converter modelos PyTorch em uma representação intermediária otimizada. O JIT compila o grafo computacional do modelo, permitindo uma execução eficiente nos dispositivos de destino.
-
Conversão gradual: o TorchScript oferece uma abordagem de conversão gradual, permitindo converter partes do modelo PyTorch para TorchScript de forma incremental. Essa flexibilidade é especialmente útil ao lidar com modelos complexos ou ao otimizar partes específicas do código.
Opções de implantação no TorchScript#
Antes de vermos o código para exportar modelos YOLO26 para o formato TorchScript, vamos entender onde os modelos TorchScript costumam ser usados.
O TorchScript oferece várias opções para implantar modelos de machine learning, como:
-
API C++: o caso de uso mais comum do TorchScript é sua API LibTorch para C++, que permite carregar e executar modelos TorchScript otimizados diretamente em aplicações C++. Essa opção é ideal para ambientes de produção nos quais Python pode não ser adequado ou estar disponível. A API C++ proporciona execução eficiente de modelos TorchScript com baixa sobrecarga, maximizando o potencial de desempenho.
-
Implantação móvel: para inferência de baixa latência e offline, além de privacidade dos dados em dispositivos móveis, use o ExecuTorch, que substitui o TorchScript Mobile no PyTorch.
-
Implantação na nuvem: os modelos TorchScript podem ser implantados em servidores na nuvem usando soluções como TorchServe. Ele oferece recursos como controle de versões de modelos, processamento em lotes e monitoramento de métricas para uma implantação escalável em ambientes de produção. A implantação do TorchScript na nuvem pode disponibilizar seus modelos por meio de APIs ou outros serviços Web.
Tarefas suportadas#
A exportação para TorchScript é compatível com todas as sete tarefas da Ultralytics. A segmentação semântica e a estimativa de profundidade estão disponíveis apenas com YOLO26, a única família que inclui essas cabeças.
| Tarefa | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detetar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semântica | ❌ | ❌ | ✅ |
| Profundidade | ❌ | ❌ | ✅ |
| Classificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportar para TorchScript: convertendo seu modelo YOLO26#
Exportar modelos YOLO26 para TorchScript facilita o uso deles em diferentes contextos e ajuda a executá-los com mais rapidez e eficiência. Isso é ideal para quem quer usar modelos de deep learning de forma mais eficaz em aplicações do mundo real.
Instalação#
Para instalar o pacote necessário, executa:
# Install the required package for YOLO26
pip install ultralytics
Para obter instruções detalhadas e boas práticas relacionadas ao processo de instalação, consulte nosso guia de instalação da Ultralytics. Se tiver dificuldades ao instalar os pacotes necessários para YOLO26, consulte nosso guia de problemas comuns para ver soluções e dicas.
Uso#
Todos os modelos Ultralytics YOLO26 foram concebidos para suportar a exportação de origem, o que facilita a integração no fluxo de trabalho de implementação que preferires. Podes consultar a lista completa de formatos de exportação suportados e opções de configuração para escolheres a melhor configuração para a tua aplicação.
O formato TorchScript é compatível com os modos Export, Predict e Validate. Exporte o modelo e, em seguida, carregue o modelo exportado para executar inferências ou validar a precisão.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporte o modelo para o formato TorchScript
model.export(format="torchscript") # cria 'yolo26n.torchscript'from ultralytics import YOLO
# Carregue o modelo TorchScript exportado
model = YOLO("yolo26n.torchscript")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carregue o modelo TorchScript exportado
model = YOLO("yolo26n.torchscript")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'torchscript' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
imgsz | int ou tuple | 640 | Tamanho de imagem desejado para a entrada do modelo. Pode ser um inteiro para imagens quadradas ou uma tupla (height, width) para dimensões específicas. |
dynamic | bool | False | Permite tamanhos de entrada dinâmicos, aumentando a flexibilidade para processar imagens com dimensões variáveis. |
quantize | int ou str | None | Precisão da quantização: 16 (FP16) exige exportação com GPU e device=0; 32/não definido corresponde a FP32. Substitui a flag obsoleta half. |
nms | bool, opcional | None | Seleciona a saída bruta (None, padrão), NMS incorporado (True) ou a cabeça sem NMS (False). |
batch | int | 1 | Especifica o tamanho do lote de inferência do modelo exportado ou o número máximo de imagens que o modelo exportado processará em simultâneo no modo predict. |
device | str | None | Especifica o dispositivo para exportação: GPU (device=0), CPU (device=cpu), MPS para Apple Silicon (device=mps). |
Para mais detalhes sobre o processo de exportação, visita a página da documentação da Ultralytics sobre exportação.
Implantar modelos YOLO26 TorchScript exportados#
Depois de exportar com sucesso os modelos Ultralytics YOLO26 para o formato TorchScript, você já pode implantá-los. A primeira etapa recomendada para executar um modelo TorchScript é usar o método YOLO("model.torchscript"), conforme mostrado no trecho de código de uso anterior. Para ver instruções detalhadas sobre como implantar seus modelos TorchScript em outros contextos, consulte os seguintes recursos:
-
Explore a implantação móvel: use o pipeline separado
torch.export()→.ptedo ExecuTorch para as implantações móveis atuais do PyTorch. -
Domine a implantação no servidor: aprenda a implantar modelos no servidor com TorchServe neste tutorial passo a passo sobre como disponibilizar modelos de forma escalável e eficiente.
-
Implemente a implantação em C++: consulte o tutorial sobre como carregar um modelo TorchScript em C++, que facilita a integração dos seus modelos TorchScript em aplicações C++ para obter mais desempenho e versatilidade.
Resumo#
Neste guia, exploramos o processo de exportação de modelos Ultralytics YOLO26 para o formato TorchScript. Seguindo as instruções fornecidas, você pode otimizar o desempenho dos modelos YOLO26 e ganhar flexibilidade para implantá-los em diversas plataformas e ambientes.
Para mais detalhes sobre o uso, acesse a documentação oficial do TorchScript.
Além disso, se quiseres saber mais sobre outras integrações da Ultralytics YOLO26, visita a nossa página do guia de integração. Encontrarás muitos recursos e informações úteis.
Perguntas frequentes#
Exportar um modelo Ultralytics YOLO26 para TorchScript permite uma implantação flexível e multiplataforma. O TorchScript, parte do ecossistema PyTorch, facilita a serialização de modelos, que podem ser executados em ambientes sem suporte a Python. Isso torna o TorchScript útil para implantar modelos em ambientes C++.
Para exportar um modelo YOLO26 para TorchScript, você pode usar o seguinte código de exemplo:
Usofrom ultralytics import YOLO # Carrega um modelo YOLO26 model = YOLO("yolo26n.pt") # Exporte o modelo para o formato TorchScript model.export(format="torchscript") # cria 'yolo26n.torchscript' # Carregue o modelo TorchScript exportado torchscript_model = YOLO("yolo26n.torchscript") # Executar inferência results = torchscript_model("https://ultralytics.com/images/bus.jpg")Para mais detalhes sobre o processo de exportação, consulte a documentação da Ultralytics sobre exportação.
Usar TorchScript para implantar modelos YOLO26 oferece várias vantagens:
- Portabilidade: os modelos exportados podem ser executados em aplicações C++ sem Python.
- Otimização: o TorchScript é compatível com execução com grafo estático e compilação Just-In-Time (JIT), que podem otimizar o desempenho dos modelos.
- Integração entre linguagens: os modelos TorchScript podem ser integrados a outras linguagens de programação, ampliando a flexibilidade e a capacidade de expansão.
- Serialização: os modelos podem ser serializados, permitindo carregamento e inferência independentes de plataforma.
Para saber mais sobre a implementação, visita a Documentação do TorchServe e o Guia de implementação em C++. Para implementação móvel no dispositivo, PyTorch agora recomenda o ExecuTorch, que usa o seu próprio pipeline separado
torch.export()→.pteem vez do TorchScript.Para instalar o pacote necessário para exportar modelos YOLO26, usa o seguinte comando:
Instalação# Install the required package for YOLO26 pip install ultralyticsPara obter instruções detalhadas, visita o guia de instalação da Ultralytics. Se surgir algum problema durante a instalação, consulta o guia de problemas comuns.
Depois de exportares os modelos YOLO26 para o formato TorchScript, podes implementá-los em várias plataformas:
- API C++: usa o LibTorch para ambientes de produção altamente eficientes e com baixa sobrecarga.
- Implementação móvel: usa o ExecuTorch, a substituição compatível com PyTorch, com um pipeline de exportação separado
.pte. - Implementação na nuvem: utiliza serviços como o TorchServe para uma implementação escalável no lado do servidor.
Consulta diretrizes abrangentes para implementar modelos nestes ambientes e tira o máximo partido dos recursos do TorchScript.