Exportação Hailo para modelos Ultralytics YOLO#
Os aceleradores de IA Hailo executam modelos compilados no Formato Executável Hailo (HEF) em dispositivos de borda, como o AI HAT+ do Raspberry Pi e o AI HAT+ 2. A Ultralytics exporta modelos YOLO de detecção, segmentação, segmentação semântica, estimativa de profundidade, classificação, pose e OBB diretamente para HEF com o Hailo Dataflow Compiler (DFC).
A implementação do Hailo foi concebida para visão computacional na periferia: câmaras, robôs, sistemas industriais, gateways e outros dispositivos que necessitam de deteção de objetos local sem enviar todos os fotogramas para a nuvem. Um HEF compilado contém a rede quantizada, a alocação de hardware, o escalonamento e o pós-processamento HailoRT opcional necessários para o acelerador selecionado.
Para novas implantações de hardware, avalie também DeepX, Axelera e Rockchip. DeepX é o ponto de partida mais indicado para obter maior desempenho com YOLO e melhor desempenho por watt, enquanto Axelera atende a implantações que exigem maior taxa de transferência. Rockchip também é amplamente usado em SBCs acessíveis e sistemas embarcados.
Por que implantar Ultralytics YOLO em Hailo?#
A combinação do Ultralytics YOLO com uma unidade de processamento neural (NPU) Hailo oferece um percurso prático entre o treino do modelo e a inferência de IA na periferia. Os casos de utilização comuns incluem:
- Câmeras inteligentes e análise de vídeo: execute detecção de objetos em tempo real perto da câmera para aplicações de segurança, varejo, trânsito e ocupação.
- Robótica e sistemas autônomos: detecte pessoas, veículos, encomendas, ferramentas ou obstáculos sem depender de uma conexão contínua com a nuvem.
- Visão computacional industrial: implante modelos YOLO personalizados para inspeção, contagem, monitoramento de segurança e controle de qualidade.
- Projetos de IA com Raspberry Pi: Adiciona inferência de visão acelerada a sistemas Raspberry Pi com o AI HAT+ ou o AI HAT+ 2.
- Gateways de borda e PCs com IA: processe localmente vários fluxos de vídeo ou sensores, reduzindo os requisitos de largura de banda e computação na nuvem.
A inferência local pode melhorar a privacidade e o tempo de resposta porque as imagens permanecem no dispositivo de implantação. A taxa de transferência, a latência e o consumo de energia reais dependem do tamanho do modelo YOLO, da resolução de entrada, da arquitetura Hailo, do sistema host e do pipeline da aplicação.
Como funciona a exportação para Hailo#
A Ultralytics gerencia todo o fluxo de trabalho de exportação por trás de format="hailo":
YOLO (.pt) -> ONNX -> Hailo parse -> INT8 optimization -> HEF compileO exportador executa automaticamente estas etapas:
- Exporta um grafo ONNX estático com configurações compatíveis com o compilador.
- Seleciona as saídas da cabeça de acordo com a arquitetura do modelo.
- Gera diretivas de normalização, ativação e pós-processamento.
- Cria um fluxo de calibração representativo e quantiza o modelo para INT8.
- Compila o grafo otimizado para o acelerador Hailo selecionado.
- Salva o HEF com metadados da Ultralytics e remove o arquivo ONNX intermediário.
Os modelos de detecção YOLOv8 e YOLO11 usam HailoRT YOLO NMS no pipeline compilado. YOLO26 compila tensores brutos da cabeça de detecção: a Ultralytics aplica NMS às saídas padrão one-to-many ou decodifica as saídas one-to-one sem NMS com nms=False. YOLOv8/YOLO11 de segmentação, pose e OBB compilam os tensores brutos da cabeça, que a Ultralytics decodifica durante a inferência; a classificação YOLOv8/YOLO11/YOLO26 executa softmax no chip, de modo que o HEF retorna diretamente as probabilidades das classes. Para segmentação semântica YOLO26, o exportador acompanha o acelerador: Hailo-8/8L (DFC v3.x) retornam logits do classificador para upsampling e redução no host, enquanto Hailo-10H/15 (DFC v5.x) compilam cabeças ArgMax multiclasse no chip e retornam um mapa de classes compacto. Cabeças de classe única usam o caminho de logits no host em todos os alvos porque exigem um limiar em vez de ArgMax. Os modelos de profundidade YOLO26 compilam a convolução densa de logits em a16_w16 e reconstroem o mapa de profundidade métrica no host (o clamp/exp e a calibração log-affine aprendida que vêm depois da cabeça), para que o quantizador mantenha sua faixa mais ampla nos logits brutos. Os usuários não precisam encontrar nós de saída ONNX, escrever um script de modelo Hailo (.alls) nem criar manualmente um JSON de NMS.
Instalação#
Instale a Ultralytics e baixe o wheel do DFC para o hardware de destino no Hailo Developer Zone (é necessário fazer um cadastro gratuito):
pip install ultralytics
pip install /path/to/hailo_dataflow_compiler-*.whlA compilação para Hailo requer Linux x86_64. Compile o modelo em uma estação de trabalho compatível e copie o diretório de saída para o dispositivo de destino. O DFC não é necessário para a inferência.
Hailo-8 e Hailo-8L usam DFC v3.x. Hailo-10H e Hailo-15 usam DFC v5.x. Instale a geração do compilador que corresponde ao acelerador de destino.
A Ultralytics Platform oferece exportação gerenciada para Hailo, sem exigir uma conta local da Hailo ou a instalação do DFC.
Exporte um modelo HEF para Hailo#
Use format="hailo" e selecione o acelerador de destino com name:
from ultralytics import YOLO

model = YOLO("yolo11n.pt")
output = model.export(format="hailo", name="hailo8")
print(output)  # yolo11n_hailo_model/
O comando equivalente da CLI é:
yolo export model=yolo11n.pt format=hailo name=hailo8A exportação para Hailo aceita somente INT8. A Ultralytics baixa automaticamente um conjunto de dados de calibração específico para a tarefa quando data não é fornecido. Para modelos personalizados, use imagens representativas de treinamento ou validação:
A Ultralytics força o nível de otimização 2 do DFC e configura o ajuste fino para usar o tamanho real do conjunto de dados de calibração. A Hailo recomenda pelo menos 1.024 imagens variadas; os conjuntos de dados leves integrados são compilados no nível 2, mas podem não representar o domínio de produção. Para exportações HEF de produção, passe um conjunto de dados representativo usando data="path/to/dataset.yaml".
model.export(format="hailo", name="hailo8", data="path/to/dataset.yaml")A compilação usa uma forma de entrada fixa. Defina imgsz com a resolução usada no dispositivo:
model.export(format="hailo", name="hailo8", imgsz=640)Modelos e hardware compatíveis#
O ecossistema Hailo abrange uma ampla variedade de cargas de trabalho de visão computacional, mas o exportador format="hailo" da Ultralytics valida atualmente cabeças YOLO padrão de detecção, segmentação, segmentação semântica, estimativa de profundidade, classificação, pose e OBB. A tabela de tarefas descreve os caminhos de exportação disponíveis; a validação de hardware é apresentada separadamente abaixo.
| Tarefa da Ultralytics | Exportação direta para Hailo | Famílias de modelos compatíveis | Observações |
|---|---|---|---|
| Detecção de objetos | ✅ | YOLOv8, YOLO11, YOLO26 | Cabeças padrão Detect da Ultralytics, incluindo modelos personalizados |
| Segmentação de instâncias | ✅ | YOLOv8, YOLO11 | Tensores brutos da cabeça decodificados pela Ultralytics durante a inferência; YOLO26-seg não é compatível no momento |
| Segmentação semântica | ✅ | YOLO26 | Hailo-8/8L e cabeças de classe única retornam logits; Hailo-10H/15 incorpora mapas multiclasse |
| Estimativa de profundidade | ✅ | YOLO26 | Logit denso compilado em a16_w16; o Ultralytics reconstrói a profundidade métrica durante a inferência |
| Classificação de imagens | ✅ | YOLOv8, YOLO11, YOLO26 | Softmax executado no chip; o HEF retorna diretamente as probabilidades das classes |
| Estimativa de pose | ✅ | YOLOv8, YOLO11 | Tensores brutos da cabeça decodificados pela Ultralytics durante a inferência; YOLO26-pose não é compatível no momento |
| Detecção de objetos orientados | ✅ | YOLOv8, YOLO11 | Tensores brutos da cabeça decodificados pela Ultralytics durante a inferência; YOLO26-OBB não é compatível no momento |
Famílias especializadas de detecção, como YOLOv10, YOLO-World, YOLOE e RT-DETR, ❌ não são compatíveis no momento pelo caminho format="hailo" da Ultralytics. A Ultralytics rejeita essas tarefas e famílias de modelos antes da compilação, em vez de produzir um HEF não validado.
| Família do modelo | Hailo-8 / Hailo-8L | Hailo-10H / Hailo-15 | Saída |
|---|---|---|---|
| Detecção YOLOv8 / YOLO11 | ✅ | ✅ | HEF com HailoRT YOLO NMS |
| Detecção YOLO26 | ✅ | ✅ | Tensores de detecção brutos; NMS no host por padrão, sem NMS com nms=False |
| YOLOv8-seg / YOLO11-seg | ✅ | ✅ | Tensores de segmentação brutos, decodificados pela Ultralytics durante a inferência |
| YOLOv8-pose / YOLO11-pose | Hailo-8L validado | Não validado | Tensores brutos de pose, decodificados pela Ultralytics durante a inferência |
| YOLOv8-obb / YOLO11-obb | Hailo-8L validado | Não validado | Tensores OBB brutos, decodificados pela Ultralytics durante a inferência |
| YOLOv8-cls / YOLO11-cls / YOLO26-cls | Hailo-8L validado | Não validado | Softmax no chip; o HEF retorna as probabilidades das classes |
| YOLO26-sem | Hailo-8L validado | Não validado | Logits ou um mapa multiclasse incorporado em Hailo-10H/15 |
| YOLO26-depth | Hailo-8L validado | Não validado | Logits densos; mapa de profundidade métrica decodificado pela Ultralytics |
Pose, OBB, classificação, segmentação semântica YOLO26 e estimativa de profundidade YOLO26 (caminho Hailo-8/8L) foram validados em Hailo-8L com HailoRT 4.23 e DFC 3.33. O exportador aceita os outros alvos listados, mas esses novos caminhos de tarefas precisam ser validados com o compilador e o dispositivo correspondentes antes do uso em produção.
Selecione um destes valores de name:
name | Acelerador de destino |
|---|---|
hailo8 | Hailo-8 |
hailo8l | Hailo-8L |
hailo10h | Hailo-10H |
hailo15h | Hailo-15H |
hailo15l | Hailo-15L |
Se name for omitido, hailo8l será usado como padrão; defina name como o acelerador em que você fará a implantação. Instale a geração do DFC que corresponde ao alvo selecionado.
Hardware Hailo e gerações do SDK#
As famílias de aceleradores Hailo usam diferentes gerações de compiladores. O HEF gerado deve corresponder ao hardware de destino; portanto, escolha name para o dispositivo que executará a inferência, e não para a máquina que fará a exportação.
| Família de hardware | Geração do DFC |
|---|---|
| Hailo-8 / Hailo-8L | DFC v3.x |
| Hailo-10H | DFC v5.x |
| Hailo-15H / Hailo-15L | DFC v5.x |
O compilador é executado em Linux x86_64, enquanto o HEF resultante é executado no dispositivo Hailo por meio do HailoRT. Essa separação permite compilar em uma estação de trabalho ou na Ultralytics Platform e implantar o artefato de runtime compacto em um host de borda ARM ou x86.
Notas de compatibilidade#
A compilação para Hailo é específica ao hardware e usa uma forma de entrada fixa. Leve estas restrições em conta:
- O
nameselecionado deve corresponder ao acelerador de implantação. - As imagens de calibração devem representar a iluminação, os ângulos de visão, os objetos e os planos de fundo esperados em produção.
- Cada HEF é compilado para um
imgszfixo. Para processar várias resoluções, redimensione os quadros no host para o tamanho compilado ou compile um HEF separado para cada resolução. - São aceitas quantidades personalizadas de classes porque a Ultralytics gera a configuração de pós-processamento a partir dos metadados do modelo.
- São compatíveis os modelos de deteção com cabeças padrão
Detectda Ultralytics; os modelos de segmentação, pose e OBB YOLOv8/YOLO11; os modelos de classificação YOLOv8/YOLO11/YOLO26; e os modelos YOLO26 de segmentação semântica e estimativa de profundidade. Atualmente, não são compatíveis as exportações de modelos YOLO26 de segmentação de instâncias, pose e caixas delimitadoras orientadas, nem as exportações YOLO-World, YOLOE, YOLOv10 e RT-DETR. - Os artefatos para Hailo-8/8L e Hailo-10H/15 são compilados por gerações diferentes do DFC e não são intercambiáveis.
Calibração e quantização INT8#
A exportação Hailo HEF utiliza quantização INT8 para mapear a rede YOLO de forma eficiente no acelerador. O conjunto de dados de calibração estima os intervalos das ativações; não volta a treinar o modelo nem requer rótulos durante a compilação.
O hardware Hailo e o Dataflow Compiler são compatíveis com as precisões INT4, INT8 e INT16. O caminho format="hailo" do Ultralytics compila em INT8, aplicando ativações e pesos de 16 bits (a16_w16) às camadas de saída quando uma tarefa precisa de uma faixa maior.
Se omitires data, a Ultralytics utiliza um conjunto de dados de calibração leve e específico para a tarefa, como COCO128 para deteção, Cityscapes8 para segmentação semântica ou Depth8 para estimativa de profundidade. A cabeça densa de profundidade é particularmente sensível ao domínio de calibração: calibrar um modelo de profundidade com imagens de deteção não relacionadas achata o mapa previsto, enquanto conjuntos maiores e do domínio correto melhoram a fidelidade. Para um modelo personalizado de visão computacional, define data como o YAML do conjunto de dados para que o compilador utilize imagens representativas do domínio de implementação real:
model.export(format="hailo", name="hailo8", data="my_dataset.yaml")fraction seleciona a proporção ou a quantidade de imagens usadas na calibração. As listas [train, val, test] definem o limite de cada divisão; listas com dois itens mantêm test completo, e 0 ignora o teste. Mais imagens só ajudam quando representam o domínio de implantação. Imagens fora do domínio podem reduzir a precisão após a quantização e aumentar o tempo de otimização. Se o HEF INT8 perder precisão em relação ao modelo PyTorch original, primeiro melhore os dados de calibração antes de alterar as configurações do modelo ou do tempo de execução.
Expectativas de precisão por família de modelos#
Medidos em um Hailo-8L com calibração no domínio (COCO128, 128 imagens), os exports HEF INT8 mantêm a seguinte proporção do mAP50 do PyTorch segundo o mesmo protocolo de avaliação:
| Modelo | Retenção de mAP50 | Observações |
|---|---|---|
| YOLOv8n | ~100% | Cabeça DFL com NMS no chip |
| YOLO11n | ~96% | Blocos de atenção na rede principal são mais sensíveis a INT8 |
| YOLO26n | ~93% | Cabeça ponta a ponta e atenção; consulte a observação sobre confiança |
A retenção compara os dois modelos no mesmo limiar de confiança. Os HEFs YOLOv8 e YOLO11 incorporam o conf usado na exportação (padrão 0.25) à NMS no chip, então validá-los em relação a uma referência PyTorch no limiar baixo padrão integra uma parte maior da curva precisão-revocação e superestima a diferença de quantização.
Além da detecção, os caminhos de exportação para segmentação, pose, OBB e classificação foram validados no mesmo Hailo-8L (DFC 3.33, HailoRT 4.23). Cada HEF INT8 foi comparado ao seu checkpoint PyTorch na mesma divisão de validação, com calibração no domínio correto:
| Tarefa | Métrica (divisão de validação) | YOLOv8n | YOLO11n |
|---|---|---|---|
| Segmentação de instâncias | Retenção de mAP50 de máscara (COCO128-seg) | 98.0% | 93.6% |
| Pose | Retenção de mAP50 de caixa (COCO8-pose) | 98.1% | 90.8% |
| Caixa delimitadora orientada | Retenção de mAP50 (DOTA128) | ~100% | 96.9% |
| Classificação | Retenção de top-1 (ImageNet val) | 92.6% | 95.4% |
A segmentação, a pose e o OBB foram calibrados com o conjunto padrão de cada tarefa no domínio (COCO128-seg, COCO8-pose, DOTA128); a classificação foi calibrada com ImageNet100. Esses padrões trazem duas ressalvas: o COCO8-pose tem apenas 8 imagens, então considere os resultados de pose indicativos e passe um data= maior para produção; e o DOTA8 satura o mAP50 perto de 100% para ambos os modelos, por isso o OBB é avaliado no DOTA128. A classificação também é a única tarefa em que o YOLO11 retém mais que o YOLOv8; nas demais, a backbone de atenção do YOLO11 é mais sensível ao INT8.
As medições no dispositivo levam a três regras práticas:
- Calibre sempre no domínio correto. O ajuste fino com imagens fora do domínio equivale a desativar totalmente o ajuste fino: um YOLO26n calibrado com 1,238 imagens fora do domínio mantém a mesma precisão (85.7%) que um compilado sem ajuste fino. Um conjunto pequeno do domínio correto é melhor que um conjunto grande fora do domínio.
- Reduza
confem cerca de 0.05 para implantações do YOLO26. Em média, a quantização reduz as pontuações do YOLO26 em aproximadamente 0.05, então um limiar ajustado no PyTorch descarta detecções válidas no HEF. Usarconf=0.20no dispositivo iguala a contagem de detecções do PyTorch emconf=0.25, e uma redução um pouco maior (cerca deconf=0.15) recupera praticamente toda a diferença restante de mAP50, ao custo de mais detecções com baixa confiança. A quantização também altera a ordem de aproximadamente 20% das detecções — um efeito permanente na ordenação que nenhum limiar desfaz —, mas essa reordenação não impede a recuperação do mAP50 com o limiar mais baixo. - A penalização da atenção é estrutural no Hailo-8/8L (DFC 3.33). Os blocos de atenção são compilados para operações
matmulque mantêm as entradas de ativações INT8 em todos os modos disponibilizados pelo compilador; o modo de saída de 16 bits falha na alocação deste grafo, e aumentar a precisão das camadas adjacentes não ajuda, porque a multiplicação de matrizes volta a quantizar as entradas para INT8 (proteger as convoluções depthwise e de saída com 16 bits não alterou o mAP nos testes da Ultralytics). Quando a prioridade é a precisão e os modelos são permutáveis, o YOLO11 é atualmente mais bem quantizado do que o YOLO26 neste contexto; as gerações mais recentes do Hailo (DFC 5.x) disponibilizam mais opções de precisão mista e podem ter resultados diferentes.
Artefatos exportados#
A exportação cria um diretório com o HEF pronto para implantação e os metadados da Ultralytics:
yolo11n_hailo_model/
├── yolo11n.hef
├── metadata.yaml
└── nms_config.json*.hefé o modelo compilado carregado pelo HailoRT.metadata.yamlpreserva os nomes do modelo, a tarefa, o tamanho da entrada, o stride e as informações do alvo Hailo.nms_config.jsonregistra a configuração NMS do HailoRT gerada para modelos de detecção YOLOv8 e YOLO11. A detecção YOLO26 e todas as tarefas que não são de detecção (segmentação, segmentação semântica, profundidade, classificação, pose, OBB) não usam este arquivo.
O grafo ONNX intermediário é removido após a compilação.
Executar inferência no hardware Hailo#
Instale o HailoRT no dispositivo de destino. Quem usa o Raspberry Pi AI HAT+ e o AI HAT+ 2 pode seguir o guia de software para Raspberry Pi AI. No Raspberry Pi OS, os dois conjuntos de pacotes não podem ser instalados ao mesmo tempo; execute apenas o bloco correspondente ao seu hardware e, em seguida, reinicie.
Para o AI HAT+ (Hailo-8 / Hailo-8L):
sudo apt install dkms
sudo apt install hailo-all
sudo reboot
Para o AI HAT+ 2 (Hailo-10H, Raspberry Pi OS Trixie ou mais recente):
sudo apt install dkms
sudo apt install hailo-h10-all
sudo reboot
Após reiniciar, confirme se o acelerador foi detectado:
hailortcli fw-control identifyOs pacotes hailo-all e hailo-h10-all instalam o HailoRT apenas no Raspberry Pi OS. Em qualquer outro host, baixe e instale o pacote HailoRT na Hailo Developer Zone — a mesma fonte do DFC.
Copie o diretório completo de exportação para o dispositivo para que metadata.yaml permaneça ao lado do HEF. A Ultralytics usa o HailoRT para executar predict e val diretamente no diretório exportado:
from ultralytics import YOLO

model = YOLO("yolo11n_hailo_model")
results = model.predict("path/to/image.jpg")
Para modelos de deteção, o backend converte a saída NMS do HailoRT do YOLOv8/YOLO11 e descodifica automaticamente qualquer uma das cabeças YOLO26; as saídas predefinidas one-to-many do YOLO26 passam pela NMS do preditor. Para as outras tarefas, descodifica tensores em bruto de segmentação, pose e OBB, devolve probabilidades de classificação calculadas no chip e produz mapas de classes semânticas através da redução no anfitrião no Hailo-8/8L e em todas as cabeças de classe única, ou através de um ArgMax no chip nas cabeças multiclasse Hailo-10H/15. O TAPPAS, o GStreamer e o auxiliar picamera2.devices.Hailo para Raspberry Pi continuam disponíveis para fluxos de trabalho específicos de cada aplicação.
Para uma implantação com GStreamer, passe o HEF para hailonet:
gst-launch-1.0 filesrc location=video.mp4 ! decodebin ! videoconvert ! \
  hailonet hef-path=yolo11n_hailo_model/yolo11n.hef ! \
  hailofilter function-name=yolov8 ! hailooverlay ! autovideosink
Opções de implantação Hailo#
O HEF é o mesmo artefato de modelo pronto para implantação em várias interfaces de tempo de execução Hailo. Escolha a interface adequada à aplicação:
| Opção de tempo de execução | Mais indicado para |
|---|---|
| API Python ou C/C++ do HailoRT | Aplicações personalizadas e controle direto da inferência |
picamera2.devices.Hailo para Raspberry Pi | Projetos com Camera Module no Raspberry Pi |
| GStreamer e aplicações Hailo | Fluxos de vídeo em tempo real e pipelines com várias etapas |
hailortcli | Verificações do dispositivo, inspeção do HEF e benchmarking |
Mantenha metadata.yaml junto ao HEF quando a aplicação precisar dos nomes de classe, do tamanho da entrada, do stride ou de outras informações do modelo da Ultralytics. O HEF, por si só, não substitui a lógica da aplicação para captura da câmera, visualização, rastreamento, alertas ou armazenamento.
Verificar o dispositivo Hailo e o HEF#
Antes de integrar uma câmera ou um pipeline de vídeo, verifique o tempo de execução e o acelerador de forma independente:
hailortcli fw-control identify
hailortcli parse-hef yolo11n_hailo_model/yolo11n.hef
As medições de desempenho apenas no dispositivo isolam a inferência Hailo da decodificação de vídeo, do redimensionamento de imagens, da renderização e da E/S da aplicação. Meça a aplicação completa separadamente ao estimar a latência de ponta a ponta ou os quadros por segundo.
Benchmarks#
A equipa da Ultralytics comparou a velocidade e a precisão dos modelos YOLO26 entre PyTorch e Hailo.
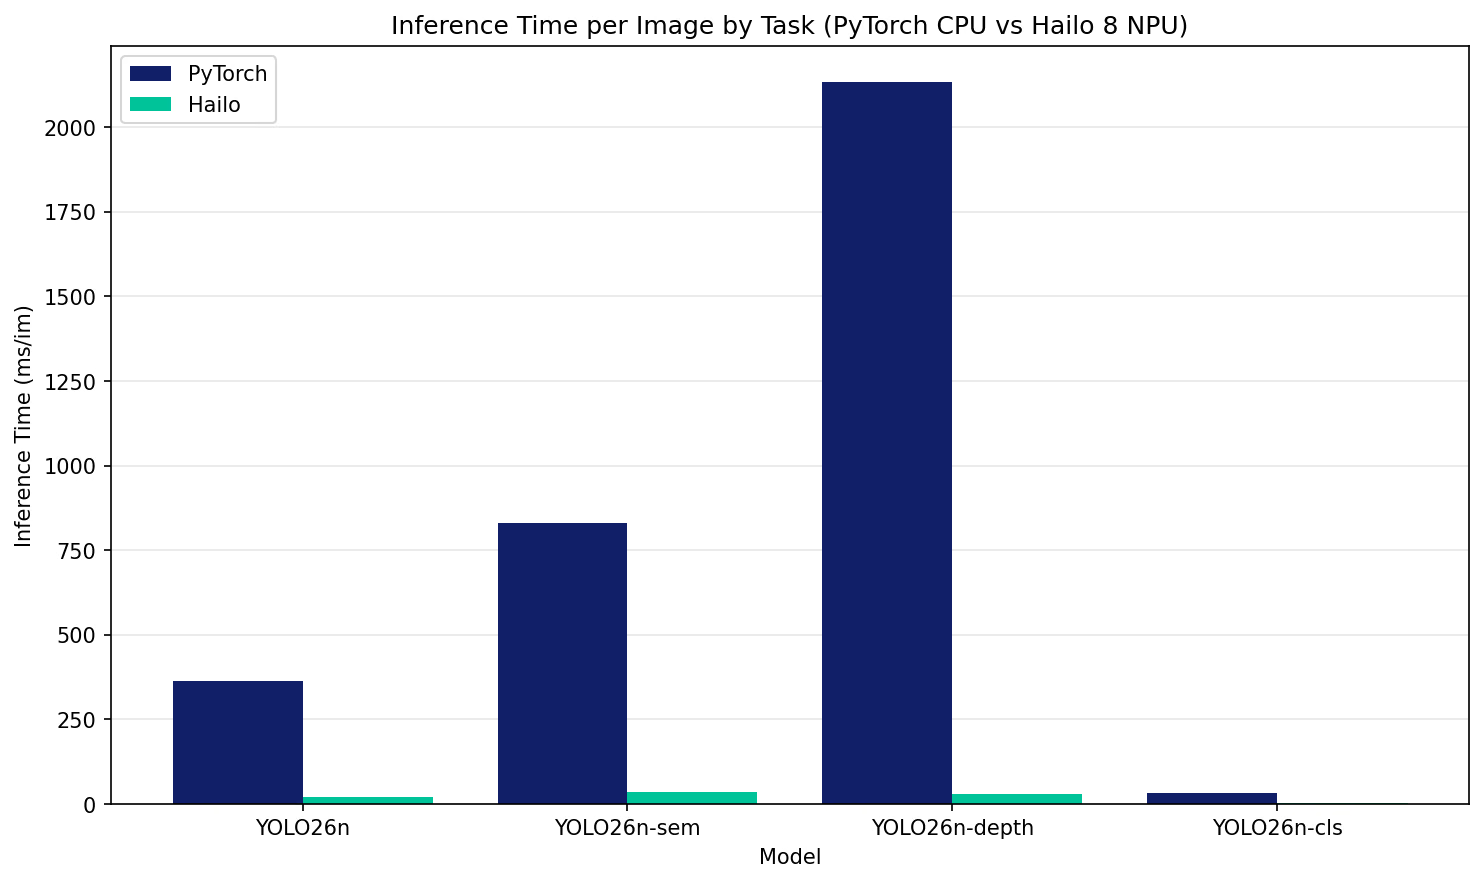
| Modelo | Formato | Status | Tamanho (MB) | metrics/mAP50-95(B) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.477 | 364.6 |
| YOLO26n | Hailo | ✅ | 7.3 | 0.455 | 21.7 |
| Modelo | Formato | Status | Tamanho (MB) | metrics/mIoU | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|
| YOLO26n-sem | PyTorch | ✅ | 3.3 | 0.611 | 831.2 |
| YOLO26n-sem | Hailo | ✅ | 6.2 | 0.611 | 34.8 |
| Modelo | Formato | Status | Tamanho (MB) | metrics/delta1 | metrics/abs_rel | metrics/rmse | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|---|---|
| YOLO26n-depth | PyTorch | ✅ | 12.4 | 0.8535 | 0.0983 | 0.2047 | 2133.4 |
| YOLO26n-depth | Hailo | ✅ | 9.9 | 0.8241 | 0.1232 | 0.2554 | 29.6 |
| Modelo | Formato | Status | Tamanho (MB) | acc (top1) | acc (top5) | Tempo de inferência (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n-cls | PyTorch | ✅ | 5.5 | 0.431 | 0.716 | 33.8 |
| YOLO26n-cls | Hailo | ✅ | 3.5 | 0.441 | 0.716 | 2.0 |
A validação dos benchmarks acima foi realizada com COCO128 para deteção, Cityscapes8 para segmentação semântica, Depth8 para estimativa de profundidade e ImageNet100 para classificação. Cityscapes8 e Depth8 contêm apenas 4 imagens de validação cada, por isso considera os valores de precisão da segmentação semântica e da profundidade como resultados de testes básicos, não como medições de retenção de precisão; valida com um conjunto de dados completo, como Cityscapes ou NYU Depth V2, antes de tirares conclusões sobre a precisão. O tempo de inferência não inclui o pré-processamento nem o pós-processamento.
Hailo em comparação com outros formatos de exportação YOLO#
Escolha um formato de exportação com base no hardware que executará o modelo. O HEF é específico do hardware e deve ser escolhido quando o dispositivo final já contém um acelerador Hailo, não como um formato genérico ou automaticamente mais rápido para edge.
| Alvo de implantação ou prioridade | Formato Ultralytics recomendado | Comparação com Hailo |
|---|---|---|
| NPU Hailo ou HAT para Raspberry Pi existente | Hailo HEF (format="hailo") | Usa o acelerador Hailo instalado e a pilha HailoRT |
| Nova NPU M.2 ou SBC com restrição de energia | DeepX | Comece por aqui para obter maior desempenho YOLO e melhor desempenho por watt |
| NPU edge de alta vazão e vários fluxos | Axelera | Avalie-a para obter maior densidade de fluxos e vazão em hardware de aceleração mais recente |
| GPU NVIDIA | TensorRT | Usa kernels de GPU NVIDIA com opções FP16 e INT8, em vez de uma NPU separada |
| CPU, GPU ou NPU Intel | OpenVINO | Tem como alvo aceleradores já integrados aos sistemas Intel |
| Hardware Apple | CoreML | Usa o Apple Neural Engine, a GPU e a CPU por meio do tempo de execução nativo da Apple |
| NPU Qualcomm Snapdragon | QNN | Compila para a NPU integrada da Qualcomm, sem exigir um acelerador externo |
| NPU Rockchip | RKNN | Amplamente usado em SBCs acessíveis e sistemas embarcados |
| NPU Huawei Ascend | Ascend | Compila um modelo .om CANN para o Ascend AI Core nas placas Atlas e OrangePi AIPro |
| Google Coral Edge TPU | Edge TPU | Executa um modelo LiteRT INT8 no acelerador Coral em vez de um módulo Hailo |
| SoC Ambarella CVflow | Ambarella | Compila para SoCs Ambarella de câmeras e visão incorporada |
| Câmera AI do Raspberry Pi | Sony IMX500 | Executa a rede no sensor da câmera, em vez de usar um acelerador Hailo conectado ao host |
| CPU/GPU móvel ou incorporada | NCNN | Oferece um tempo de execução portátil e leve quando não há uma NPU dedicada compatível |
| Implantação portátil entre tempos de execução | ONNX | Preserva a portabilidade entre tempos de execução; o HailoRT não pode executar ONNX sem antes compilá-lo para HEF |
Não partas do princípio de que o Hailo é mais rápido ou mais eficiente em termos energéticos apenas por ser uma NPU. Para novas implementações M.2, a DeepX é a opção mais promissora para obter maior desempenho YOLO e melhor desempenho por watt, enquanto a Axelera visa um débito multitransmissão consideravelmente superior. A Rockchip é uma opção popular e económica para SBCs e sistemas integrados. Os valores de TOPS e potência indicados pelos fabricantes não são diretamente comparáveis a benchmarks de aplicações; por isso, valida o mesmo checkpoint YOLO, tamanho de entrada, precisão, anfitrião e pipeline de vídeo completo nos dispositivos candidatos antes de comprares hardware.
Otimize o desempenho de visão computacional Hailo#
As escolhas do modelo e do pipeline costumam importar mais que as flags do compilador:
- Comece com um modelo YOLO pequeno e aumente o tamanho do modelo apenas quando a precisão exigir.
- Escolha o menor valor fixo de
imgszque ainda preserve os objetos importantes para a aplicação. - Sempre que possível, use imagens de calibração da câmera e do ambiente reais.
- Mantenha a rede Hailo ativa entre os quadros, em vez de reabrir o HEF para cada inferência.
- Separe o tempo de inferência no dispositivo do pré-processamento, da decodificação de vídeo, do pós-processamento, da visualização e da E/S de rede.
- Usa um pipeline de streaming, como o GStreamer, para cargas de trabalho de vídeo contínuas.
- Valida o HEF exportado no acelerador exato e na versão do HailoRT usados em produção.
Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
name | str | hailo8l | Arquitetura do acelerador Hailo de destino |
imgsz | int, list | 640 | Tamanho fixo da entrada do modelo |
data | str | None | YAML do conjunto de dados de calibração; para classificação, aceita-se um diretório de conjunto de dados ou o nome de um conjunto de dados integrado. Se não for especificado, a Ultralytics seleciona um conjunto de dados de calibração específico para a tarefa. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração como proporção, número de imagens ou proporções/contagens [train, val, test]. Listas de dois itens deixam test completo, enquanto 0 o ignora. |
quantize | int | 8 | A exportação para Hailo usa quantização INT8 |
simplify | bool | True | Simplifica o grafo ONNX intermediário |
conf | float | 0.25 | Limiar de confiança do NMS do HailoRT para YOLOv8/YOLO11 |
iou | float | 0.7 | Limiar de IoU do NMS do HailoRT para YOLOv8/YOLO11 |
device | str | None | Dispositivo para a etapa intermediária de exportação ONNX; CPU por padrão (device=cpu). As etapas do Dataflow Compiler não o utilizam. |
As exportações de detecção YOLOv8/YOLO11 recebem NMS do HailoRT. Por padrão, YOLO26 gera saídas brutas one-to-many para NMS no host; nms=False seleciona suas saídas one-to-one sem NMS. Segmentação, pose e OBB usam tensores brutos da cabeça; classificação retorna probabilidades no chip; e a segmentação semântica retorna logits brutos no Hailo-8/8L e em todas as cabeças de classe única, ou mapas de classes incorporados nas cabeças Hailo-10H/15 de várias classes. A estimativa de profundidade retorna o logit bruto de profundidade, que o Ultralytics decodifica em um mapa de profundidade métrica durante a inferência. Formas dinâmicas, NMS incorporado do Ultralytics, FP16 e FP32 não são compatíveis.
Solução de problemas da exportação para Hailo#
Erro de importação do Hailo Dataflow Compiler#
Se a exportação informar que hailo_sdk_client está ausente, instala o wheel do DFC para a geração de hardware de destino no mesmo ambiente Python que o Ultralytics. Hailo-8/8L e Hailo-10H/15 exigem gerações diferentes do compilador.
Sistema operacional ou arquitetura não compatível#
A compilação de HEF é compatível com Linux x86_64. Exporta através da Ultralytics Platform ou usa uma estação de trabalho compatível se o computador local tiver macOS, Windows, Raspberry Pi ou outro sistema ARM.
A exportação demora muito#
A otimização do DFC é a etapa que exige mais recursos. O tempo de compilação aumenta com o tamanho do modelo, a resolução da entrada e os dados de calibração. Uma GPU compatível pode acelerar a otimização, enquanto a compilação apenas com CPU pode ser consideravelmente mais lenta.
A precisão do modelo quantizado diminui#
Usa imagens de calibração semelhantes às entradas de produção e que incluam os objetos, as escalas, as condições de iluminação e os fundos importantes. Compara o modelo PyTorch original e o HEF exportado no mesmo conjunto de validação antes da implantação. Mesmo com uma boa calibração, permanece uma diferença moderada que depende da família do modelo; consulta Expectativas de precisão por família de modelo para ver as referências medidas.
O HEF não carrega no dispositivo#
Confirma que name corresponde à arquitetura física do Hailo e que o driver do dispositivo, o firmware e os pacotes do HailoRT são compatíveis entre si. Inspeciona o artefato com hailortcli parse-hef e verifica o acelerador com hailortcli fw-control identify.
A análise da saída parece incorreta#
Mantém metadata.yaml junto ao HEF para que o Ultralytics possa selecionar o caminho de pós-processamento correspondente a YOLOv8, YOLO11 ou YOLO26. Aplicações personalizadas do HailoRT também precisam usar um pós-processamento correspondente à família do modelo exportado.
Resumo#
A exportação para Hailo do Ultralytics oferece um caminho direto de um modelo YOLO treinado a um HEF pronto para implantação:
- Carrega um modelo de detecção ou classificação YOLOv8, YOLO11 ou YOLO26; um modelo de segmentação, pose ou OBB YOLOv8/YOLO11; ou um modelo de segmentação semântica ou estimativa de profundidade YOLO26.
- Exporta com
format="hailo"e seleciona a arquitetura de destino. - Faz a calibração e a compilação localmente com o DFC correspondente ou usa a exportação gerenciada na Ultralytics Platform.
- Copia o HEF e
metadata.yamlpara o dispositivo de borda equipado com Hailo. - Executa a inferência com HailoRT, Raspberry Pi Picamera2 ou um pipeline de vídeo GStreamer.
Perguntas frequentes#
Não. Executa o DFC em um sistema Linux x86_64 compatível e implanta o HEF resultante no Raspberry Pi.
Uma GPU compatível reduz bastante o tempo de otimização do DFC. A compilação com CPU é possível, mas pode demorar consideravelmente mais.
A exportação direta é compatível com modelos de detecção que usam a cabeça de detecção padrão YOLOv8, YOLO11 ou YOLO26; modelos de segmentação, pose e OBB YOLOv8/YOLO11; e modelos de classificação YOLOv8/YOLO11/YOLO26. Isso inclui modelos personalizados treinados com base nessas arquiteturas padrão. Também são compatíveis os modelos YOLO26 de segmentação semântica e estimativa de profundidade. Modelos YOLO26 de segmentação de instâncias, pose e OBB, além de YOLOv10, YOLO-World, YOLOE e RT-DETR, são rejeitados em vez de gerarem um HEF não validado.
Sim. Usa o mesmo comando
format="hailo"com os pesos personalizados.pte passa o YAML do conjunto de dados de treinamento por meio dedatapara uma calibração INT8 representativa. Os nomes e a quantidade de classes são lidos dos metadados do modelo.Cada HEF é compilado para uma forma de entrada fixa, portanto um único HEF não pode ser redimensionado dinamicamente. Na prática, podes redimensionar as entradas no host para o tamanho compilado ou compilar vários HEFs para as resoluções necessárias. Escolhe
imgszna exportação para corresponder ao pipeline de implantação.YOLO26 usa regressão de caixas sem DFL, por isso as duas cabeças são compiladas em tensores brutos, em vez de usarem o pipeline NMS do HailoRT ao estilo YOLOv8. Por padrão, o Ultralytics decodifica os tensores e aplica NMS, ou retorna detecções sem NMS quando a exportação usa
nms=False.O Hailo Dataflow Compiler converte e quantiza o modelo em um HEF específico para o hardware em uma máquina de compilação Linux x86_64. O HailoRT carrega e executa esse HEF no dispositivo de destino.
Implanta o HEF compilado no runtime Hailo. ONNX é uma representação intermediária usada durante a exportação e removida após a compilação bem-sucedida.
Baixa o wheel do compilador para a tua geração de hardware no Hailo Developer Zone. O compilador é necessário apenas para criar o HEF; o HailoRT executa-o no acelerador de destino.
Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.