Exportação Qualcomm QNN para modelos Ultralytics YOLO#
A implementação de modelos de visão computacional em dispositivos Qualcomm Snapdragon exige um formato de modelo ajustado ao ambiente de execução Qualcomm AI Engine Direct (QNN). Exportar modelos Ultralytics YOLO para o formato QNN permite executar inferência acelerada no próprio dispositivo, em hardware de CPU Snapdragon, GPU Adreno e NPU Hexagon, presente em milhares de milhões de telemóveis, portáteis, sistemas automóveis e dispositivos IoT. Este guia explica como exportar YOLO para Qualcomm QNN e implementá-lo para obter inferência rápida e de baixo consumo de energia em hardware Snapdragon.
O plugin Flutter oficial da Ultralytics oferece suporte opcional a QNN para inferência em tempo real com a câmara e previsões de imagens individuais nas sete tarefas do YOLO26. Ativa o ambiente de execução QNN e adiciona a dependência ONNX Runtime conforme descrito no README do plugin. Para implementações em iOS, consulta o SDK Ultralytics YOLO para iOS e a integração CoreML.
Exporta modelos de classificação em imgsz=224. Exporta modelos de deteção, segmentação, semântica, profundidade, pose e OBB em imgsz=640. Este padrão 224/640 é partilhado pelos recursos móveis oficiais de QNN, LiteRT e CoreML. Os recursos v73 e v81 prontos a executar para as sete tarefas nano estão disponíveis na versão v0.6.6 do yolo-flutter-app.
O que é Qualcomm QNN?#
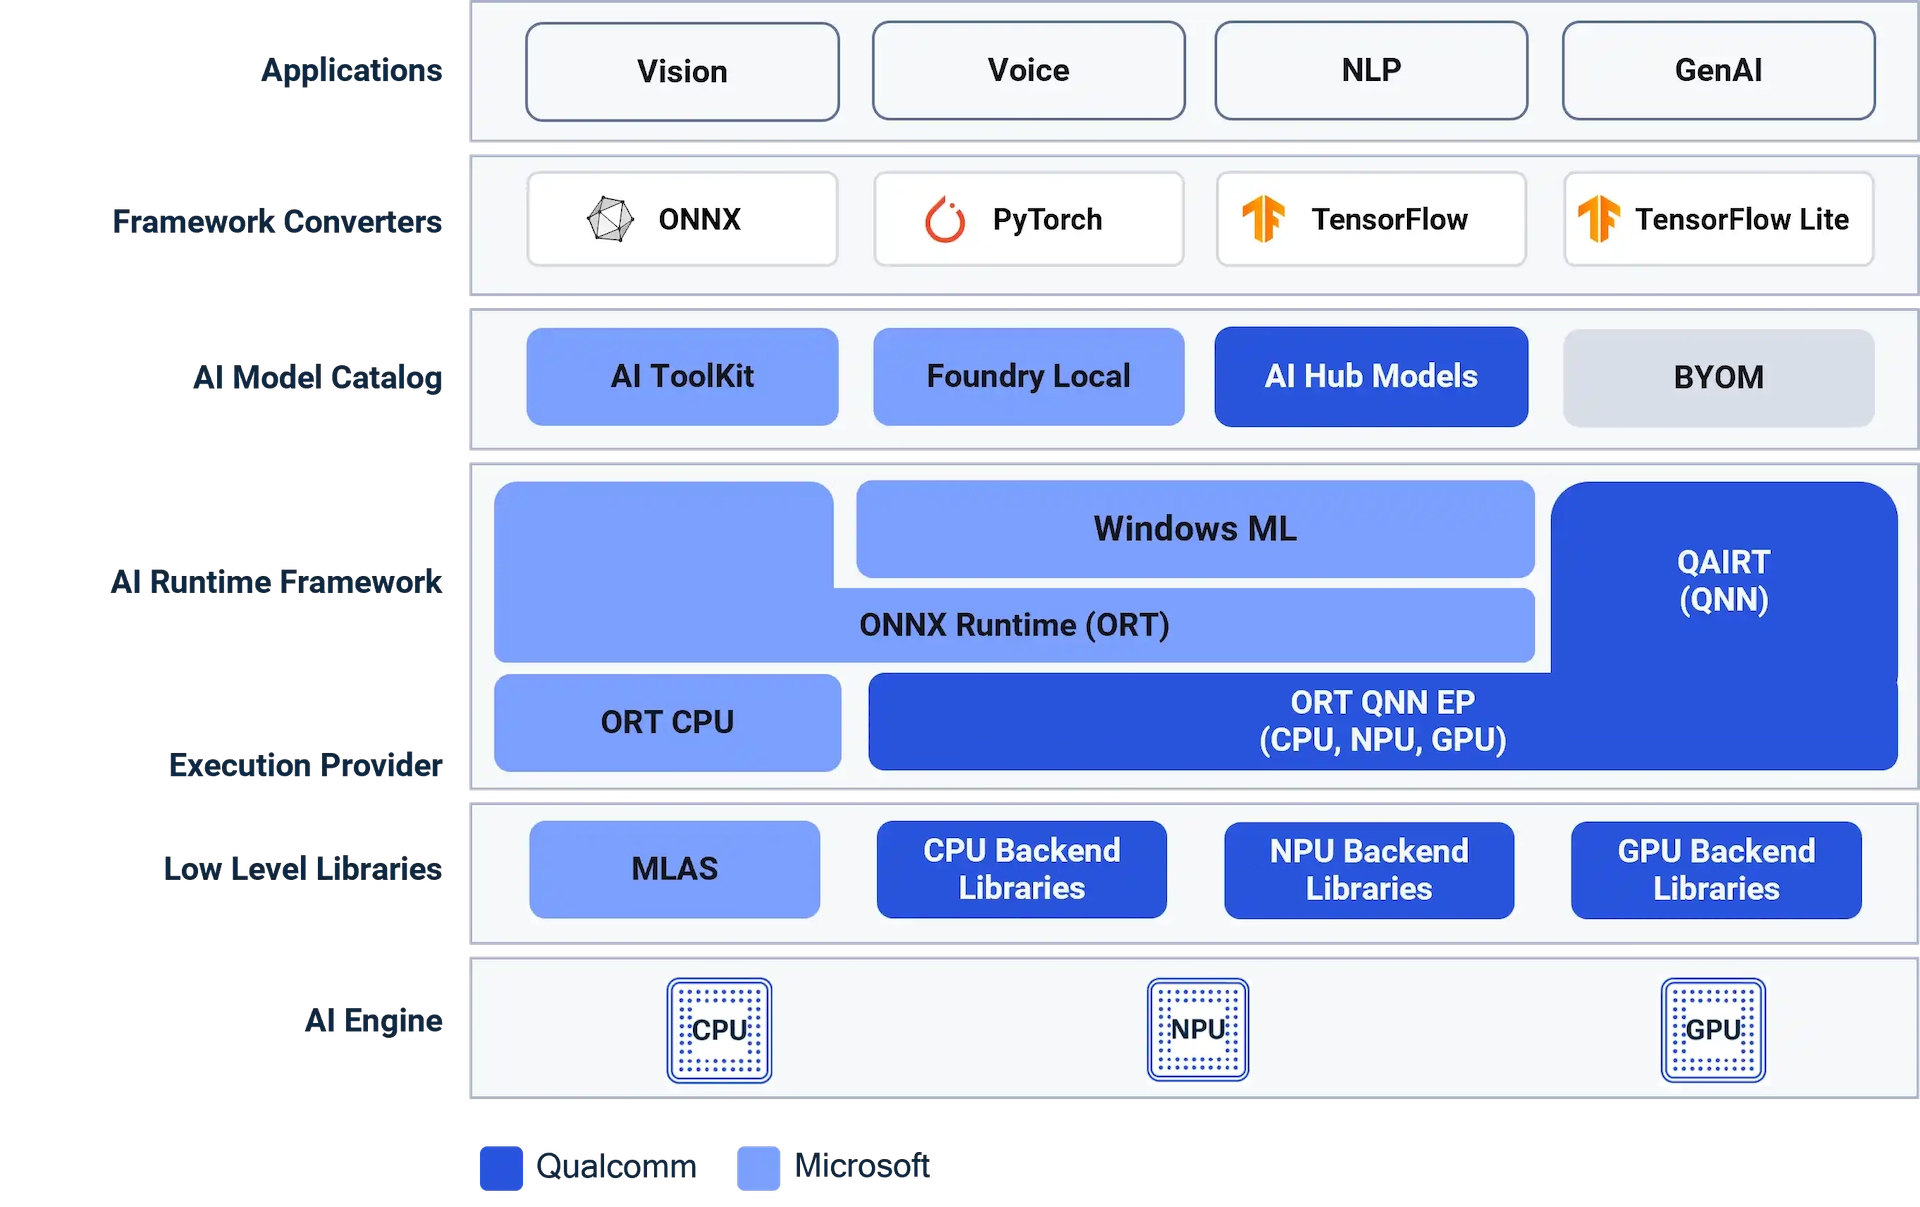
O Qualcomm AI Engine Direct — normalmente designado por QNN e distribuído como parte do SDK Qualcomm AI Runtime (QAIRT) — é a pilha de inferência de baixo nível da Qualcomm para processadores Snapdragon. Fornece uma API unificada com bibliotecas específicas para cada backend, destinadas à CPU Snapdragon, à GPU Adreno e ao processador tensorial Hexagon (HTP), a unidade de processamento de redes neurais (NPU) dedicada existente nos SoCs Snapdragon modernos. O QNN dá aos programadores acesso de pilha completa a estes aceleradores de IA Snapdragon e é o sucessor moderno do antigo SDK Snapdragon Neural Processing Engine (SNPE). Alimenta a IA no dispositivo nas plataformas móveis Snapdragon 8 Gen 2, 8 Gen 3 e 8 Elite, nos portáteis Snapdragon X e em produtos automóveis e XR.
Por que exportar para Qualcomm QNN?#
O Snapdragon é a plataforma de computação móvel mais utilizada no mundo. Exportar Ultralytics YOLO para o formato Qualcomm QNN permite tirar partido do hardware de IA dedicado destes dispositivos:
- Aceleração da NPU Hexagon: Executar YOLO no processador tensorial Hexagon proporciona um rendimento muito superior e um consumo de energia inferior à inferência na CPU — ideal para inferência em tempo real e visão computacional sempre ativa em dispositivos Snapdragon.
- No dispositivo e offline: A inferência QNN é executada inteiramente no dispositivo Snapdragon, sem comunicação de ida e volta com a nuvem; a latência mantém-se baixa e os dados nunca saem do dispositivo.
- Eficiência da quantização: A exportação QNN quantiza YOLO para pesos INT8 com ativações de 16 bits, o equilíbrio entre precisão e desempenho preferido pela NPU Hexagon, reduzindo o tamanho do modelo e maximizando os fotogramas por segundo em hardware alimentado por bateria.
- Um formato, muitos dispositivos: Uma única exportação Qualcomm QNN destina-se à CPU Snapdragon, à GPU Adreno e à NPU Hexagon nas famílias Snapdragon 8 Gen 2, 8 Gen 3 e 8 Elite, e posteriores.
- Pilha de IA Qualcomm pronta para produção: QNN (Qualcomm AI Engine Direct / QAIRT) é o ambiente de execução de IA no dispositivo atual da Qualcomm, mantido ativamente e recomendado como substituto do SNPE.
Formato de exportação QNN#
A Ultralytics compila modelos YOLO para QNN localmente com o ONNX Runtime QNN Execution Provider (o pacote onnxruntime-qnn, instalável com pip, que inclui as bibliotecas QAIRT). O exportador converte o modelo para ONNX, quantiza-o com dados de calibração para obter ativações de 16 bits e pesos INT8 (o equilíbrio recomendado para a NPU Hexagon) e, em seguida, inicializa uma sessão ONNX Runtime com o armazenamento em cache do binário de contexto ativado — esta operação compila o grafo quantizado num binário de contexto QNN incorporado em <model>_qnn.onnx. Não é necessária uma conta Qualcomm, o carregamento de dados para a nuvem nem uma transferência separada do SDK.
Ao contrário do Qualcomm AI Hub, baseado na nuvem, que compila e cria perfis de modelos em dispositivos Snapdragon alojados pela Qualcomm e exige uma conta Qualcomm, a exportação QNN da Ultralytics é executada inteiramente na tua própria máquina com uma única chamada export(format="qnn", imgsz=640) (imgsz=224 para classificação). Obténs o mesmo destino de execução QNN/QAIRT — CPU Snapdragon, GPU Adreno e NPU Hexagon — sem registo, limites de carregamento ou tempos de espera na fila, e a exportação integra-se diretamente no fluxo de trabalho padrão de exportação YOLO.
O ficheiro *_qnn.onnx exportado é autónomo: inclui o binário de contexto QNN e metadados ONNX, como os nomes das classes, o tamanho da imagem e a tarefa.
Principais funcionalidades dos modelos QNN#
- Quantização: O modelo é quantizado para ativações de 16 bits e pesos INT8 com o fluxo QDQ QNN do ONNX Runtime e um conjunto de dados de calibração, o equilíbrio entre precisão e desempenho recomendado para a NPU Hexagon. Sabe mais sobre quantização de modelos.
- Compilação totalmente local: O binário de contexto é gerado inteiramente na tua máquina anfitriã — sem conta Qualcomm, token de API ou carregamento para a nuvem.
- Aceleração completa do Snapdragon: Executa inferência na NPU Hexagon (HTP), na GPU Adreno ou na CPU através de um único ambiente de execução unificado.
- Ampla compatibilidade com dispositivos: Destina-te à vasta gama de plataformas Snapdragon presentes em telemóveis, PCs (Windows on Snapdragon), produtos automóveis, XR e sistemas integrados.
- Binário de contexto pré-compilado: A distribuição de um binário de contexto minimiza a compilação do grafo no dispositivo, reduzindo a latência de carregamento do modelo no destino.
- Saída autónoma: O ficheiro ONNX exportado inclui o binário de contexto QNN pré-compilado e metadados para facilitar a implementação.
Desempenho medido#
Telemóvel Android#
Hardware: Xiaomi 17 com 12 GB de memória LPDDR5X e Android 16 / API 36. O seu Snapdragon 8 Elite Gen 5 de 3 nm (SM8850) tem uma CPU Qualcomm Oryon de 8 núcleos (2 núcleos Prime até 4,6 GHz e 6 núcleos Performance até 3,62 GHz), GPU Adreno e NPU Hexagon (HTP v81).
| Modelo | Tarefa | tamanho (pixels) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Detecção | 640 | 52.2 1.8 / 48.1 / 2.4 | 15.8 2.3 / 8.9 / 4.6 | 10.7 1.8 / 6.7 / 2.2 |
| YOLO26n-seg | Segmentação | 640 | 73.4 1.8 / 65.6 / 6.0 | 33.2 1.8 / 23.8 / 7.6 | 17.4 1.8 / 9.9 / 5.7 |
| YOLO26n-sem | Semântica | 640 | 61.2 1.8 / 51.1 / 8.3 | 34.2 1.8 / 24.0 / 8.3 | 11.5 1.8 / 7.1 / 2.6 |
| YOLO26n-depth | Profundidade | 640 | 124.4 1.9 / 115.1 / 7.4 | 23.0 1.8 / 13.5 / 7.7 | 35.2 1.8 / 26.1 / 7.3 |
| YOLO26n-cls | Classificação | 224 | 4.4 0.4 / 4.0 / 0.0 | 3.1 0.8 / 2.1 / 0.2 | 1.2 0.6 / 0.6 / 0.0 |
| YOLO26n-pose | Pose | 640 | 57.4 1.8 / 53.8 / 1.8 | 16.6 2.7 / 10.1 / 3.9 | 10.9 1.8 / 7.0 / 2.0 |
| YOLO26n-obb | OBB | 640 | 50.3 1.8 / 47.2 / 1.4 | 11.7 1.8 / 7.8 / 2.0 | 8.6 1.8 / 5.7 / 1.1 |
- Os valores de velocidade são latências de rajada para uma única imagem — a média de 15 execuções após 3 execuções de aquecimento em
bus.jpg, medidas com o sistema de referência no dispositivo0.6.10do plugin Flutter e os recursos padronizadosv0.6.6. A ordem dos backends alternou entre tarefas numa única sequência. Os registos nativos confirmaram que todas as linhas da CPU utilizaram LiteRT CPU/XNNPACK, todas as linhas da GPU delegaram o grafo completo ao LiteRT OpenCL (LITERT_CL) e todas as linhas da NPU utilizaram o backend QNN Hexagon HTP. - O registo detalhado da avaliação de desempenho encontra-se no documento de desempenho do Flutter.
- Compara outros dispositivos Android na integração LiteRT e dispositivos Apple na integração CoreML.
Portátil Windows on Snapdragon#
Esta avaliação histórica utilizou binários QNN v73 anteriores à padronização; as tarefas semântica e OBB utilizaram entradas de 1024 px. Foi executada num portátil Lenovo com 32 GB de memória e Windows 11. O seu Snapdragon X Elite (X1E78100) tem uma CPU Qualcomm Oryon de 12 núcleos, GPU Adreno e NPU Hexagon (HTP v73); o modelo exato do Lenovo não foi registado. Esta comparação Windows on Snapdragon avalia a referência de CPU nativa PyTorch FP32, que é o ponto de partida da maioria dos programadores de computadores de secretária, em relação ao percurso ONNX Runtime QNN Hexagon HTP. Cada célula apresenta o tempo total decorrido de model.predict() com os tempos de pré-processamento / inferência / pós-processamento indicados abaixo; o total pode incluir sobrecarga da framework que não esteja incluída nestas três etapas. Os valores da CPU são PyTorch FP32 (torch==2.10.0+cpu) e os valores da NPU são ONNX Runtime QNN (onnxruntime-qnn==2.2.0, pesos INT8 / ativações de 16 bits).
| Modelo | Tarefa | tamanho (pixels) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Detecção | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segmentação | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Semântica | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Classificação | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Pose | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Os valores de Speed são latências de rajada de imagem única — a média de 100 execuções após 10 execuções de aquecimento em
bus.jpg, medidas comtime.perf_counter()em torno da chamada completa demodel.predict()em um dispositivo resfriado (ultralytics==8.4.67, Python 3.12.10). - O NPU Hexagon é aproximadamente 2-4x mais rápido do que a linha de base da CPU PyTorch nas tarefas de 640-1024 px (detecção ~3.4x), chegando a ~1.3x no classificador de 224 px, em que a sobrecarga fixa de pré-processamento predomina sobre a pequena carga de trabalho.
Tarefas suportadas#
A exportação Qualcomm QNN é compatível com todas as sete tarefas da Ultralytics. A segmentação semântica e a estimativa de profundidade estão disponíveis apenas com YOLO26, a única família que inclui essas cabeças.
| Tarefa | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detetar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semântica | ❌ | ❌ | ✅ |
| Profundidade | ❌ | ❌ | ✅ |
| Classificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportação para QNN: convertendo seu modelo YOLO#
Exporte um modelo Ultralytics YOLO para o formato QNN e implante-o em hardware Qualcomm. O binário de contexto é finalizado para uma arquitetura de processador Tensor Hexagon (HTP) ou SoC compatível, que você seleciona com o argumento name — o mesmo argumento usado para escolher um chip na exportação RKNN.
Destinos HTP compatíveis#
Passe a arquitetura de destino ou o SoC por meio de name (por exemplo, name="73" ou name="iq-8275"). O suporte é determinado pelo destino HTP; portanto, as linhas Snapdragon abaixo representam plataformas, não uma lista exaustiva de todos os SoCs. Os dispositivos Dragonwing são listados explicitamente.
| Status | name | HTP Hexagon | Dispositivo ou plataforma de exemplo |
|---|---|---|---|
| ✅ Compatível | 68 | v68 | Snapdragon 888 |
| ✅ Compatível | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ Compatível | 73 | v73 | Snapdragon 8 Gen 2, X Elite (padrão) |
| ✅ Compatível | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ Compatível | 79 | v79 | Snapdragon 8 Elite |
| ✅ Compatível | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ Compatível | iq-8275 ou qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275 (modelo QNN SoC 82) |
| ❌ Não compatível | — | v66 | Dragonwing IQ-615 / QCS615 |
O Dragonwing IQ-615 não pode usar a exportação de binário de contexto QNN da Ultralytics porque o ONNX Runtime não expõe seu DSP v66 como destino HTP offline. Uma exportação ONNX padrão ainda pode ser integrada separadamente com um provedor de execução de CPU ou GPU compatível com o BSP da placa.
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)A exportação QNN usa o pacote onnxruntime-qnn. A versão 2.4.0 e posteriores oferecem wheels pré-compilados para Windows (x64 e ARM64) e Linux (x86-64 e ARM64) no Python 3.11 ou posterior; macOS não é compatível como host QNN. A geração do binário de contexto QNN é executada em um host x64 e não requer um dispositivo Snapdragon durante a etapa de exportação.
Instalação#
Para instalar os pacotes necessários, executa:
# Install the required package for YOLO
pip install ultralytics
O pacote onnxruntime-qnn (que fornece o provedor de execução QNN do ONNX Runtime e inclui as bibliotecas QAIRT) é instalado automaticamente na primeira exportação. Para ver instruções detalhadas e práticas recomendadas para o processo de instalação, consulte nosso guia de instalação da Ultralytics. Se encontrar dificuldades ao instalar os pacotes necessários para YOLO, consulte nosso guia de problemas comuns para ver soluções e dicas.
Uso#
O formato QNN é compatível com os modos Export, Predict e Validate. A inferência e a validação são executadas em hardware Qualcomm Snapdragon por meio do provedor de execução QNN do ONNX Runtime (o mesmo pacote onnxruntime-qnn usado na exportação). Exporte seu modelo e, em seguida, carregue o modelo exportado em um dispositivo Snapdragon para executar a inferência ou validar sua precisão.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exportar para o formato Qualcomm QNN (INT8, ativado automaticamente) para o destino HTP v73 padrão
model.export(format="qnn", name="73", imgsz=640) # usar imgsz=224 para classificaçãofrom ultralytics import YOLO
# Carregar o modelo QNN exportado (em um dispositivo Snapdragon com onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carregar o modelo QNN exportado (em um dispositivo Snapdragon com onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'qnn' | Formato de destino do modelo exportado, que define a compatibilidade com o runtime Qualcomm QNN. |
imgsz | int ou tuple | 640 | Tamanho de imagem pretendido para a entrada do modelo. Pode ser um número inteiro para imagens quadradas ou uma tupla (height, width). |
batch | int | 1 | Especifica o tamanho do lote do modelo exportado, que é incorporado ao binário de contexto QNN gerado. |
name | str | '73' | Arquitetura HTP Hexagon de destino (68, 69, 73, 75, 79 ou 81) ou SoC compatível (iq-8275 ou qcs8275). O binário de contexto é finalizado para esse destino. |
quantize | int ou str | 'w8a16'/auto | Precisão da quantização. A exportação QNN HTP usa pesos INT8 com ativações de 16 bits ('w8a16') e é ativada automaticamente se não for especificada. Substitui as flags obsoletas half/int8. |
simplify | bool | True | Simplifica o grafo ONNX intermediário com onnxslim. |
opset | int | None | Especifica a versão do opset ONNX para o grafo ONNX intermediário. Se não for definida, usa a versão mais recente compatível. |
data | str | None | YAML do conjunto de dados usado para calibração INT8; a classificação aceita, em vez disso, um diretório de conjunto de dados ou um nome de conjunto de dados integrado. Se não for especificado, a Ultralytics selecionará o conjunto de dados de calibração padrão para a tarefa do modelo. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração como proporção, número de imagens ou proporções/contagens [train, val, test]. Listas de dois itens deixam test completo, enquanto 0 o ignora. |
device | str | None | Especifica o dispositivo para a etapa de exportação ONNX: GPU (device=0) ou CPU (device=cpu). |
A exportação QNN quantiza o modelo para ativações de 16 bits e pesos INT8 — o equilíbrio recomendado entre precisão e desempenho para o NPU Hexagon — usando o fluxo de quantização QDQ do ONNX Runtime com imagens de calibração de data. quantize='w8a16' é ativado automaticamente.
Para mais detalhes sobre o processo de exportação, visita a página da documentação da Ultralytics sobre exportação.
Estrutura de saída#
Após uma exportação bem-sucedida, é criado um arquivo ONNX autocontido:
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
O arquivo yolo26n_qnn.onnx incorpora o binário de contexto QNN e é carregado pelo ONNX Runtime com o provedor de execução QNN no dispositivo Snapdragon. Ele também inclui metadados do modelo, como nomes de classe, tamanho da imagem e tarefa, em ONNX metadata_props.
Implantação de modelos YOLO QNN exportados#
Os modelos QNN são executados em hardware Qualcomm compatível, facilitando a implantação de modelos no dispositivo. Em um dispositivo compatível com onnxruntime-qnn instalado, execute o modelo exportado diretamente com a API da Ultralytics (yolo predict/yolo val; consulte Uso acima) — a Ultralytics carrega o binário de contexto HTP por meio do provedor de execução QNN do ONNX Runtime.
Para pipelines personalizados, você também pode carregar o ONNX de binário de contexto diretamente com o ONNX Runtime. onnxruntime-qnn é um provedor de execução de plug-in; portanto, registre-o em tempo de execução:
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# No dispositivo Snapdragon, registre o provedor de execução (EP) do plug-in QNN e selecione seus dispositivos
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
Como o binário de contexto QNN é pré-compilado, a sessão é carregada rapidamente sem recompilar o grafo no dispositivo.
Requisitos do Linux e do BSP Yocto#
A placa de destino deve fornecer um runtime Qualcomm e um BSP mutuamente compatíveis. Para inferência HTP, isso inclui o provedor de execução QNN do ONNX Runtime, libQnnSystem.so, libQnnHtp.so, as bibliotecas stub e skeleton HTP v75 para IQ-8275, suporte FastRPC em espaço de usuário, como libcdsprpc.so, o firmware DSP e os drivers FastRPC/kernel correspondentes. A biblioteca skeleton deve ser localizável pelo caminho de bibliotecas DSP do BSP.
Esses componentes do dispositivo de destino são fornecidos pelo BSP do fabricante da placa, com QAIRT/QNN habilitado; eles não são incorporados ao modelo exportado. Já a execução na GPU requer libQnnGpu.so e a pilha de drivers de espaço de usuário Adreno correspondente. A saída format=qnn da Ultralytics é um binário de contexto específico para HTP; portanto, a implantação em GPU ou CPU deve começar com uma exportação ONNX padrão, e não com o arquivo *_qnn.onnx pré-compilado.
Fluxo de trabalho recomendado#
- Treina o teu modelo com o Modo de Treino da Ultralytics
- Exporte para o formato QNN usando
model.export(format="qnn", name="iq-8275", imgsz=640)em uma plataforma compatível (useimgsz=224para classificação) - Implante o arquivo
*_qnn.onnxexportado no seu dispositivo Qualcomm - Execute a inferência com o ONNX Runtime e o provedor de execução QNN usando o backend HTP
Aplicações no mundo real#
Os modelos YOLO executados em hardware Qualcomm Snapdragon são ideais para uma ampla variedade de aplicações de IA de borda:
- Smartphones: Detecção de objetos em tempo real e compreensão de cenas em aplicativos de câmera e fotos, com aceleração do NPU.
- Windows em Snapdragon: visão computacional no dispositivo em PCs Copilot+ sem transferir o processamento para a nuvem.
- Automotivo: monitoramento do motorista, detecção de ocupantes e recursos de ADAS em plataformas Snapdragon Digital Chassis.
- XR e dispositivos vestíveis: percepção de baixo consumo e baixa latência para headsets AR/VR e óculos inteligentes.
- IoT e robótica: inferência visual eficiente em câmeras, drones e sistemas embarcados com tecnologia Snapdragon.
Resumo#
Neste guia, você aprendeu a exportar localmente modelos Ultralytics YOLO para o formato Qualcomm QNN usando o provedor de execução QNN do ONNX Runtime. O pipeline de exportação converte seu modelo para ONNX e, em seguida, compila-o em um binário de contexto QNN na sua máquina host — sem exigir uma conta Qualcomm nem acesso à nuvem — e gera um arquivo *_qnn.onnx otimizado para hardware CPU Snapdragon, GPU Adreno e NPU Hexagon por meio do runtime QNN/QAIRT.
A combinação de Ultralytics YOLO e da pilha de IA no dispositivo da Qualcomm oferece uma solução eficaz para executar cargas de trabalho avançadas de visão computacional em todo o amplo ecossistema Snapdragon.
Para outros destinos de implantação em dispositivos e dispositivos móveis, consulte os guias de exportação relacionados para ONNX, CoreML, NCNN, LiteRT, ExecuTorch, RKNN, Sony IMX500 e TensorRT. Para comparar formatos antes de fazer a implantação, use o modo Benchmark. Para ver a lista completa de formatos e opções, consulte a documentação do modo Export e a página do guia de integrações.
Perguntas frequentes#
Você pode exportar seu modelo usando
export(format="qnn", imgsz=640)(imgsz=224para classificação) ou os argumentos CLI equivalentes. Primeiro, a exportação cria um modelo ONNX e, em seguida, compila-o localmente em um binário de contexto QNN usando o provedor de execução QNN do ONNX Runtime. O pacoteonnxruntime-qnné instalado automaticamente na primeira exportação.Exemplofrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # usar imgsz=224 para classificaçãoNão. A exportação QNN é executada inteiramente na sua máquina local usando o pacote
onnxruntime-qnn, que inclui as bibliotecas QAIRT. Não é necessária uma conta Qualcomm, um token de API nem acesso à rede.O Qualcomm AI Hub é o serviço de nuvem da Qualcomm para compilar, criar perfis e fazer benchmarking de modelos em dispositivos Snapdragon hospedados, e requer uma conta Qualcomm. A exportação QNN da Ultralytics usa o mesmo runtime QNN/QAIRT (CPU Snapdragon, GPU Adreno e NPU Hexagon), mas compila o binário de contexto localmente com o provedor de execução QNN do ONNX Runtime — sem conta, sem carregamento e sem fila. É a forma mais rápida de transformar um modelo
.ptem uma versão pronta para Snapdragon diretamente no fluxo de trabalho padrão de exportação YOLO.A versão 2.4.0 e posteriores de
onnxruntime-qnnoferecem wheels pré-compilados para Windows (x64 e ARM64) e Linux (x86-64 e ARM64) no Python 3.11 ou posterior; macOS não é compatível como host QNN. A geração do binário de contexto é executada em um host x64 e não requer um dispositivo Snapdragon físico.Exporte com
model.export(format="qnn", imgsz=640)(imgsz=224para classificação), copie o arquivoyolo26n_qnn.onnxresultante para seu dispositivo Snapdragon e executeyolo predict model=yolo26n_qnn.onnx source=image.jpg(ouyolo val). A Ultralytics carrega o binário de contexto por meio do provedor de execução QNN do ONNX Runtime e o executa no NPU Hexagon — consulte Implantação de modelos YOLO QNN exportados.QNN (Mecanismo de IA Qualcomm Direct, parte do SDK QAIRT) é a pilha de inferência atual da Qualcomm e a substituição recomendada para o SDK antigo Snapdragon Neural Processing Engine (SNPE). As novas implantações devem ter como destino QNN.
Sim, em um dispositivo Qualcomm Snapdragon com
onnxruntime-qnninstalado —YOLO("yolo26n_qnn.onnx")carrega o binário de contexto por meio do provedor de execução QNN e executapredict/valcomo em qualquer outro formato. Em um host x86 sem hardware QNN, o modelo não pode ser executado, pois o binário de contexto tem como destino o NPU Snapdragon.A exportação cria um arquivo ONNX autocontido com binário de contexto (por exemplo,
yolo26n_qnn.onnx) e incorpora nomes de classe, tamanho da imagem, tarefa e outros metadados do modelo em ONNXmetadata_props.