Estimativa monocular de profundidade com Ultralytics YOLO#
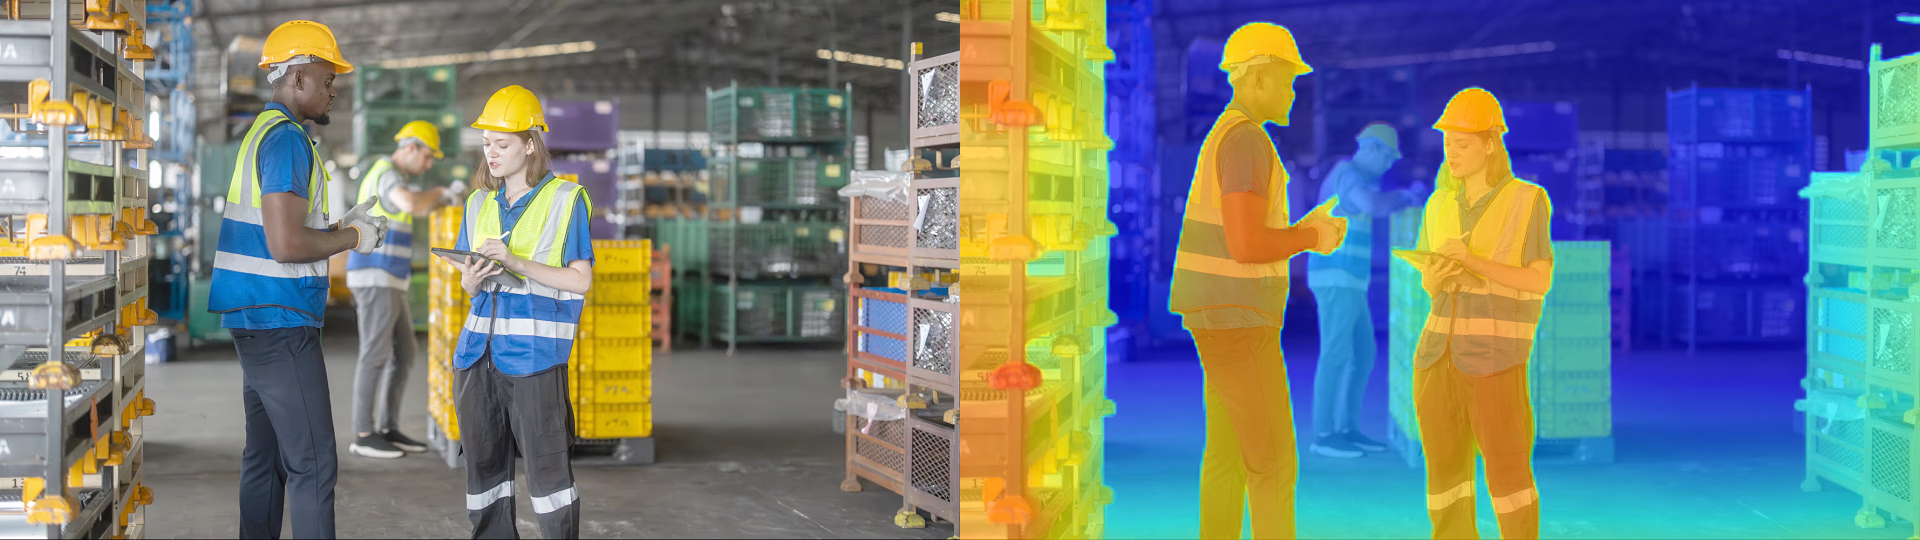
A estimativa monocular de profundidade prevê um mapa de profundidade por pixel a partir de uma única imagem RGB. Cada pixel de saída contém um valor de profundidade em metros que representa a distância estimada entre a câmara e aquele ponto da superfície.
A saída de um modelo de profundidade é um mapa denso de valores float com formato (H, W), alinhado com a imagem de entrada. Esta representação por pixel torna a estimativa monocular de profundidade adequada para reconstrução de cenas 3D, navegação robótica, criação de conteúdo de RA/RV e qualquer aplicação que exija a disposição espacial a partir de uma única câmara.
Assista: Estimativa monocular de profundidade com Ultralytics YOLO26 | Tutorial de Python | Vision AI 🚀
Usa task=depth ou a tarefa CLI yolo depth para estimativa monocular de profundidade. Os ficheiros dos modelos de profundidade YOLO26 usam o sufixo -depth, como yolo26n-depth.pt.
Modelos#
Os modelos de profundidade YOLO26 pré-treinados numa ampla combinação de vários conjuntos de dados (interior + exterior, ~2.19M imagens) são apresentados abaixo. As colunas de métricas mostram os resultados na divisão de teste Eigen do NYU Depth V2.
Os modelos são transferidos automaticamente da versão mais recente do Ultralytics na primeira utilização.
| Modelo | tamanho (pixels) | delta1NYU | abs_relNYU | rmseNYU | Velocidade CPU ONNX (ms) | Velocidade T4 TensorRT10 (ms) | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU é a fração de pixels cuja profundidade prevista está a menos de um fator de 1,25 da profundidade de referência, na divisão de teste Eigen do NYU Depth V2 (654 imagens), com TTA multiescala + inversão horizontal e alinhamento por mínimos quadrados no domínio logarítmico.
- A precisão em escala única, sem TTA, pode ser reproduzida com
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0(substituimodel=por cada tamanho), que usa alinhamento pela mediana (apenas escala) e obtém resultados inferiores: delta1 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel é o erro relativo absoluto médio entre os valores de profundidade previstos e os de referência.
- rmse é a raiz do erro quadrático médio, em metros.
- Velocidade é a latência apenas da inferência (sem pré-processamento nem pós-processamento) em
imgsz=768,batch=1, apresentada como média ± desvio-padrão das execuções cronometradas após o aquecimento. CPU ONNX é o ONNX Runtime fp32 num Intel Xeon de 32 núcleos (Skylake); T4 TensorRT10 é o TensorRT fp16 numa Tesla T4. - params e FLOPs são medidos a 768×768, a resolução de treinamento dos pesos disponibilizados.
Consulta a prévia não lançada do YOLO27 para ver os resultados preliminares no NYU Depth V2.
Velocidade em comparação com Depth Anything V2#
Depth Anything V2 é uma referência aberta amplamente utilizada para estimativa monocular de profundidade. A rede backbone DINOv2 Vision Transformer e o descodificador DPT exigem muito poder computacional; por isso, na mesma Tesla T4 com TensorRT fp16, o menor modelo lançado de Depth Anything V2 é mais lento do que todos os modelos de profundidade YOLO26 — incluindo o YOLO26x-depth, que tem mais do dobro dos parâmetros.
A ~768 px — imgsz=768 para YOLO26, a resolução para a qual os pesos disponibilizados foram treinados, e 770 px para Depth Anything V2, cuja rede backbone DINOv2 exige um múltiplo do tamanho de patch 14:
| Modelo | params (M) | FLOPs (B) | T4 TensorRT10 (ms) | FPS | Aceleração em relação ao V2 Small | Aceleração em relação ao V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
A ~640 px — imgsz=640 e 644 px, respetivamente — a ordenação mantém-se, e YOLO26n-depth é 5.9× mais rápido do que Depth Anything V2 Small:
| Modelo | T4 TensorRT10 (ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- A latência corresponde apenas à inferência,
batch=1, TensorRT fp16 numa Tesla T4 — o mesmo procedimento de teste da tabela de modelos acima, apresentado aqui com duas casas decimais; o FPS é o inverso da latência não arredondada. As colunas de Aceleração dividem as latências de Depth Anything V2 Small (20.99 ms) e Base (55.40 ms) pela latência de YOLO26. - Depth Anything V2 Small e Base são os pontos de verificação ViT-S e ViT-B disponibilizados.
- A comparação abrange apenas a latência — as duas famílias de modelos não são avaliadas aqui com um protocolo de precisão comum.
Intervalo de profundidade e cabeça de profundidade logarítmica#
A cabeça de profundidade prevê exp(logit) — sem limite (~0.02–150 m) — e desacopla a forma da cena da escala absoluta: a rede prevê um campo de profundidade logarítmica relativa, e os metros absolutos são definidos por uma transformação separada de dois parâmetros (exp(a·log d + b)), recuperada durante a avaliação, por calibração leve ou por ajuste fino. A alternativa comum, uma cabeça sigmoid × max_depth limitada, incorpora um teto fixo na arquitetura; por isso, qualquer profundidade acima de max_depth é truncada — o que impede o treinamento e a previsão em cenas de maior alcance.
Comparação A/B controlada — mesmos dados, mesmo cronograma, apenas a cabeça é diferente. Treinar ambas as cabeças do zero com uma combinação idêntica de dados interiores (≤10 m) e exteriores (≤80 m):
| Cabeça | Intervalo de saída | δ1 de validação em intervalos mistos | Comportamento do treinamento |
|---|---|---|---|
sigmoid × max_depth (10 m) | limitada a 0–10 m | 0.221 | estagna na época 1 |
log (sem limite) | 0–~150 m | 0.367 (+66%) | melhora ao longo de todo o treinamento |
A cabeça limitada não consegue representar a maioria dos pixels exteriores (>10 m), por isso deixa de melhorar quase imediatamente; a cabeça log aprende com todo o intervalo.
O problema que resolve — ajuste fino num único conjunto de dados, estratificado por intervalo. O ajuste fino de uma cabeça limitada (10 m) em conjuntos de dados individuais funciona quando os dados cabem no limite e falha quando o ultrapassam:
| Conjunto de dados | Intervalo de profundidade | δ1 da cabeça limitada |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | maioritariamente ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 — a incompatibilidade de escala 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
A falha ocorre exatamente no limite máximo. A cabeça log não tem esse limite.
Modelos disponibilizados — desempenho em vários intervalos. A família distribuída com cabeça log, avaliada em benchmarks que abrangem de 10 m (NYU, iBims-1) a 80 m (KITTI), com δ1 alinhado à escala:
| Benchmark | Intervalo | YOLO26x-depth (log) | versão limitada anterior |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Média | — | 0.819 | 0.799 |
Ambas as colunas correspondem aos valores publicados. As outras linhas são avaliadas com o protocolo TTA e de mínimos quadrados no domínio logarítmico descrito nas páginas dos respetivos conjuntos de dados, que o validador deste repositório não implementa; por isso, a linha KITTI não pode ser medida novamente nas mesmas condições. A página do KITTI apresenta valores medidos na divisão Eigen canónica de 652 fotogramas.
Os maiores ganhos ocorrem nos benchmarks exteriores de maior alcance (KITTI, ETH3D) — precisamente onde um limite fixo de 10 m é mais prejudicial —, mantendo o desempenho em ambientes interiores.
Treinar#
Treina YOLO26n-depth no conjunto de dados Depth8 durante 100 épocas, com tamanho de imagem 640. Consulta a página de Configuração para ver a lista completa de argumentos disponíveis.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-depth.yaml")  # crie um novo modelo a partir de YAML
model = YOLO("yolo26n-depth.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # crie a partir de YAML e transfira os pesos

# Treinar o modelo
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Consulta os detalhes completos do modo train na página Treinar. Também podes treinar modelos de profundidade com o treinamento na nuvem da Ultralytics Platform.
Formato do conjunto de dados#
Os conjuntos de dados para estimativa de profundidade associam cada imagem RGB a um mapa de profundidade PNG uint16 escalado ou a um mapa de profundidade NPY de ponto flutuante, em metros. Por predefinição, os valores PNG usam milímetros; os conjuntos de dados que seguem outra convenção definem depth_scale no respetivo YAML. O carregador deriva o caminho da profundidade substituindo o componente images por depth, dando preferência a .png e recorrendo a .npy como alternativa.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Por exemplo, uma imagem em images/train/scene_001.jpg é associada a um mapa de profundidade em depth/train/scene_001.png. Consulta o Guia de conjuntos de dados para estimativa de profundidade para ver a especificação completa do formato.
Ajuste fino com os teus próprios dados#
Ao adaptar um modelo de profundidade pré-treinado a um conjunto de dados personalizado, reduz a taxa de aprendizagem e usa o otimizador AdamW. As predefinições do otimizador estão ajustadas para o treinamento do zero; quando aplicadas a um modelo de profundidade já convergido, podem apagar o conhecimento pré-treinado e degradar os resultados — sobretudo ao fazer ajuste fino num único domínio.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # comece com pesos pré-treinados

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100x abaixo do padrão de treinamento do zero
    warmup_bias_lr=1e-4,  # mantenha o aquecimento suave também
)
Dicas adicionais:
- A augmentação é controlada pelos argumentos padrão (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v); a deformação geométrica e os espelhamentos são aplicados de forma idêntica ao mapa de profundidade pareado. Para ver a receita exata usada nos pesos YOLO26-Depth disponibilizados, inspecione otrain_argsarmazenado no checkpoint — consulte Inspecionar os argumentos de treinamento do checkpoint YOLO26. mosaic,mixup,cutmixecopy_pastenão estão implementados para profundidade. O carregador do conjunto de dados de profundidade define automaticamente essas probabilidades como 0, portanto, passá-las não tem efeito. Essas augmentações não são compatíveis porque combinam várias imagens, o que produziria mapas de profundidade pareados inválidos.- Qualquer intervalo de profundidade funciona imediatamente. Os modelos com cabeça
logpreveem profundidade sem limites, então se adaptam a dados de curto alcance (macro) ou longo alcance (ambientes externos/condução) sem alterações. Definirmax_depth:no YAML do conjunto de dados (em metros) limita quais pixels GT são considerados nas métricas de validação. - Preserve o desempenho geral. Se você precisa que o modelo continue preciso em cenas além das presentes no conjunto de treinamento, misture uma pequena fração (~5–10%) de imagens variadas e de uso geral aos dados de treinamento; isso reduz significativamente o esquecimento durante o ajuste fino.
- Treine do zero (
model=yolo26s-depth.yaml) somente se seu domínio for muito diferente e você tiver um conjunto de dados grande — nesse caso, o padrãooptimizer=autoé adequado, pois não há pesos pré-treinados a preservar.
Calibrar a escala de profundidade#
A cabeça de profundidade separa forma (estrutura relativa da cena) de escala (metros absolutos). Se um modelo já produz boa profundidade relativa nas suas cenas, mas os valores absolutos estão incorretos para sua câmera, você pode corrigir a escala em segundos com model.calibrate() — um ajuste de forma fechada, somente da escala, da transformação log-afim da cabeça em relação a um pequeno conjunto rotulado, mantido somente quando melhora δ1 em validação cruzada com dados reservados, sem treinamento por gradiente e sem alteração dos pesos da rede, portanto não pode degradar a estrutura relativa.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Ajuste a escala em uma divisão rotulada (~100+ imagens são suficientes) e depois persista-a
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
A calibração precisa da profundidade de referência para fazer o ajuste, por isso é executada em uma divisão rotulada — não pode ser feita durante a inferência sem rótulos. O ajuste e a pontuação usam os mesmos pixels avaliados pelas métricas de validação: valores GT iguais ou superiores a max_depth do YAML do conjunto de dados (100 m por padrão) são excluídos. Use-a quando a profundidade relativa já estiver boa e somente a escala/intervalo estiver incorreta; se a própria estrutura relativa precisar mudar para seu domínio, faça ajuste fino.
O treinamento faz isso automaticamente: após a conclusão de model.train(...), os melhores checkpoints e os últimos são calibrados no conjunto de validação para que produzam profundidade em escala métrica imediatamente.
Os checkpoints yolo26*-depth.pt disponibilizados já incluem essa calibração, ajustada na combinação de validação do pré-treinamento. Trata-se de uma única escala global para todos os domínios; portanto, para obter a profundidade absoluta mais precisa em uma câmera ou tipo de cena específico, execute model.calibrate() em uma pequena divisão rotulada dos seus próprios dados — isso substitui o ajuste incorporado.
Obtendo profundidade de referência sem uma câmera de profundidade#
Se a tua câmera não tiver um sensor de profundidade, ainda assim podes calibrá-la. A calibração ajusta uma única escala global e ignora os pixels com profundidade 0, por isso bastam alguns pontos medidos por imagem.
-
Coleta imagens. Tira de 50 a 150 imagens com a tua câmera na resolução e com as configurações da lente que vais usar na implantação e coloca-as em
dataset/images/val/. A calibração lê a divisãoval. -
Anota a profundidade. Usa um dos dois métodos abaixo. Ambos gravam um mapa de profundidade por imagem em
dataset/depth/val/, no formato do conjunto de dados.
Mede a distância até alguns pontos em cada imagem com um medidor de distância a laser ou uma fita métrica, em superfícies planas e afastadas das bordas dos objetos, e regista a posição em pixels de cada ponto em points.csv:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
Depois, grava os mapas de profundidade, deixando em 0 todos os pixels não medidos. Cada ponto é desenhado como um pequeno círculo para que continue visível após o redimensionamento para imgsz:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Um medidor de distância mede a distância em linha reta até um ponto, enquanto os mapas de profundidade armazenam a distância ao longo do eixo de visão da câmera. Os valores coincidem no centro da imagem e diferem cerca de 3,5% a 15° do centro; por isso, mede pontos próximos do centro ou converte cada leitura com meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) usando os parâmetros intrínsecos da câmera.
-
Escreve o YAML do conjunto de dados como
calib.yaml.depth_scale: 100lê os PNGs em centímetros dos pontos medidos e é ignorado para os mapas NPY:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Calibra e guarda; depois, carrega
yolo26s-depth-calibrated.ptpara fazer previsões ou exportar:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
Nos testes com yolo26s-depth.pt e 150 imagens por câmera, a calibração publicada ficou entre 4% e 46% distante do ajuste de escala com dados de referência completos para NYU, KITTI e uma câmera com lente estreita. A calibração com 5 pontos medidos por imagem ficou a menos de 1% desse ajuste, e a calibração com anotações do DA3METRIC-LARGE ficou a menos de 7%. Mais imagens ajudam mais do que mais pontos por imagem: 150 imagens com 1 ponto cada ficaram a cerca de 3%, enquanto 20 imagens com 5 pontos cada tiveram uma variação de até 9%.
Validar#
Valida a precisão de um modelo YOLO26n-depth treinado num conjunto de dados de estimativa de profundidade. Passa data explicitamente para que a validação use o YAML do conjunto de dados pretendido. Os pesos publicados são treinados em imgsz=768 com imagens esticadas para um quadrado, em vez de ajustadas com preenchimento; por isso, para obter a melhor precisão, valida e faz previsões nesse tamanho. A previsão, a validação e model.calibrate() esticam a entrada da mesma forma.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-depth.pt")  # carrega um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Valida o modelo
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # fração de pixels dentro do limite δ=1.25
metrics.abs_rel  # erro relativo absoluto médio
metrics.rmse  # raiz do erro quadrático médio (metros)
metrics.silog # erro logarítmico invariante à escalaPrever#
Use um modelo YOLO26n-depth treinado para executar previsões em imagens.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-depth.pt")  # carrega um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Faz previsões com o modelo
results = model("https://ultralytics.com/images/bus.jpg")  # faz uma previsão numa imagem

# Acede aos resultados
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, forma (H, W), metros
Consulta os detalhes completos do modo predict na página Previsão.
Saída dos resultados#
A estimativa de profundidade YOLO retorna um objeto Results por imagem. Cada resultado armazena um mapa de profundidade denso de ponto flutuante para a imagem inteira.
| Atributo | Tipo | Formato | Descrição |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Mapa de profundidade denso por pixel. |
result.depth.data | torch.Tensor | (H,W) | Valores de profundidade em metros; chama .cpu().numpy() para NumPy. |
result.boxes | - | - | Sem caixas de instância. |
result.masks | - | - | Sem máscaras de instância. |
Para ver os campos Results específicos de cada tarefa, consulta a secção Resultados da previsão por tarefa.
Profundidade por objeto com segmentação de instâncias#
Combine a segmentação de instâncias com a profundidade para estimar a distância de cada objeto detectado. Execute ambos os modelos na mesma imagem com retina_masks=True para que as máscaras compartilhem a resolução da imagem original do mapa de profundidade e, em seguida, calcule a mediana dos pixels de profundidade válidos dentro de cada máscara.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
A mediana é robusta a pixels de fundo nas bordas da máscara, mas descreve a superfície visível do objeto, e não o centro, e sua precisão depende da escala de profundidade do modelo (consulte Calibrar a escala de profundidade).
Colorir o mapa de profundidade#
O mapa de profundidade bruto é um array de ponto flutuante de canal único, em metros — útil para computação, mas difícil de interpretar diretamente. Para transformá-lo em uma imagem colorida, use o auxiliar colorize_depth em ultralytics.utils.plotting, que mapeia o array de profundidade (H, W) para uma imagem BGR uint8 (H, W, 3) (os pixels inválidos <= 0 são renderizados em preto).
result.plot() já mescla essa colorização à imagem de entrada usando os padrões (cmap="jet", mode="disparity"); chame colorize_depth diretamente quando quiser uma imagem de profundidade colorida independente ou outro mapa de cores ou outra normalização.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Colorir com o próximo em tons quentes e salvar
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Fixar o intervalo em 0–20 m para que a mesma cor represente a mesma distância entre quadros
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Sobreposição mesclada diretamente do objeto Results (usa cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Todos os mapas de cores vão de tons frios/escuros → quentes/brilhantes. O mode determina qual extremidade representa o que está próximo, e vmin/vmax fixam o intervalo entre quadros para que uma cor sempre represente a mesma distância.
| Argumento | Valor | Descrição |
|---|---|---|
cmap | jet (padrão) | Alto contraste, azul → verde → vermelho; a paleta usada por result.plot(). |
cmap | inferno | Preto → roxo → laranja → amarelo. Uniforme em termos perceptuais, acessível para pessoas daltônicas e legível em escala de cinza. |
cmap | spectral | Vermelho → amarelo → verde → azul (Spectral_r do matplotlib). |
mode | disparity (padrão) | Normaliza a profundidade inversa (1/d) entre os percentis 2 e 98; tons quentes indicam o que está próximo e os valores atípicos distantes são absorvidos. |
mode | metric | Normaliza a profundidade em metros linearmente entre vmin e vmax; tons quentes indicam o que está distante, para que as cores correspondam à distância real. |
Exportar#
Exporte um modelo YOLO26n-depth para outro formato, como ONNX, CoreML etc.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-depth.pt")  # carrega um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Exporta o modelo
model.export(format="onnx")
Os formatos de exportação disponíveis para estimativa de profundidade YOLO26 estão na tabela abaixo. Você pode exportar para qualquer formato usando o argumento format, por exemplo, format='onnx' ou format='engine'. Você pode fazer previsões ou validar diretamente em modelos exportados, por exemplo, yolo predict model=yolo26n-depth.onnx. Exemplos de uso do seu modelo são exibidos após a conclusão da exportação.
| Formato | Argumento format | Modelo | Metadados | Argumentos |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None usa por predefinição saídas brutas para NMS externo. Define nms=False para selecionar uma cabeça sem NMS disponível; os formatos não suportados recorrem ao respetivo caminho de saída nativo. As entradas nms acima identificam os formatos que podem incorporar NMS com nms=True.
Consulte os detalhes completos de export na página Exportação.
Perguntas frequentes#
Prepare imagens RGB pareadas e mapas de profundidade PNG de 16 bits ou NPY de ponto flutuante em metros; em seguida, crie um YAML de conjunto de dados que aponte para o diretório
images/. O carregador encontra automaticamente os arquivos de profundidade substituindoimagespordepthno caminho, dando preferência a.pnge usando.npycomo alternativa.Comece com pesos pré-treinados e use uma taxa de aprendizado baixa com AdamW para que o ajuste fino preserve o que o modelo já sabe (veja Ajuste fino com seus próprios dados para entender o motivo):
Exemplofrom ultralytics import YOLO # Carregar um modelo YOLO26 de profundidade pré-treinado model = YOLO("yolo26s-depth.pt") # Ajustar fino em um conjunto de dados de profundidade personalizado results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Consulta a página de Configuração para ver mais argumentos disponíveis.
A validação da estimativa de profundidade informa o conjunto de métricas usado pelo Depth Anything e por trabalhos relacionados de profundidade monocular:
- delta1 / delta2 / delta3 — fração de pixels em que a razão entre a profundidade prevista e a profundidade de referência (ou o inverso) é inferior a 1.25, 1.25² e 1.25³, respectivamente. Quanto maior, melhor.
- abs_rel — erro relativo absoluto médio. Quanto menor, melhor.
- rmse — raiz do erro quadrático médio em metros. Quanto menor, melhor.
- silog — erro logarítmico invariante à escala. Quanto menor, melhor.
Cada previsão é alinhada pela mediana à sua referência por imagem, cada métrica é finalizada nessa imagem e os resultados por imagem são calculados pela média no conjunto de validação; assim, todas as imagens têm o mesmo peso, independentemente da quantidade de pixels de profundidade válidos. Imagens com menos de 10 pixels de referência válidos são ignoradas e não entram nessa média, pois alinhar a mediana de um punhado de pixels não faz sentido; previsões não finitas recebem, em vez disso, a pontuação dos limites de profundidade. Isso corresponde à média por amostra e ao limite mínimo de 10 pixels usados pelo Depth Anything V2.
O mapa de profundidade é armazenado como um
torch.Tensorcom formato(H, W), em que cada valor é a profundidade prevista em metros (useresult.depth.data.cpu().numpy()para obter um arrayfloat32do NumPy). Acesse-o por meio deresult.depth.datadepois de executar a previsão. O mapa está alinhado à resolução da imagem de entrada.O Ultralytics YOLO26 oferece configurações YAML de conjuntos de dados integradas para vários conjuntos de dados de estimativa de profundidade, incluindo NYU Depth V2, KITTI, Hypersim, SUN RGB-D e ARKitScenes. Consulte o Guia de conjuntos de dados de estimativa de profundidade para ver a lista completa e os detalhes de formato.
Valide um modelo YOLO26 de profundidade pré-treinado fornecendo o YAML do conjunto de dados usado na avaliação:
Exemplofrom ultralytics import YOLO # Carregar um modelo pré-treinado model = YOLO("yolo26n-depth.pt") # Valida o modelo metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Exporte um modelo YOLO26 de profundidade para ONNX usando Python ou CLI:
Exemplofrom ultralytics import YOLO # Carregar um modelo pré-treinado model = YOLO("yolo26n-depth.pt") # Exporta o modelo para o formato ONNX model.export(format="onnx")Para mais detalhes sobre a exportação para vários formatos, consulta a página Exportação.