Segmentação semântica com Ultralytics YOLO#
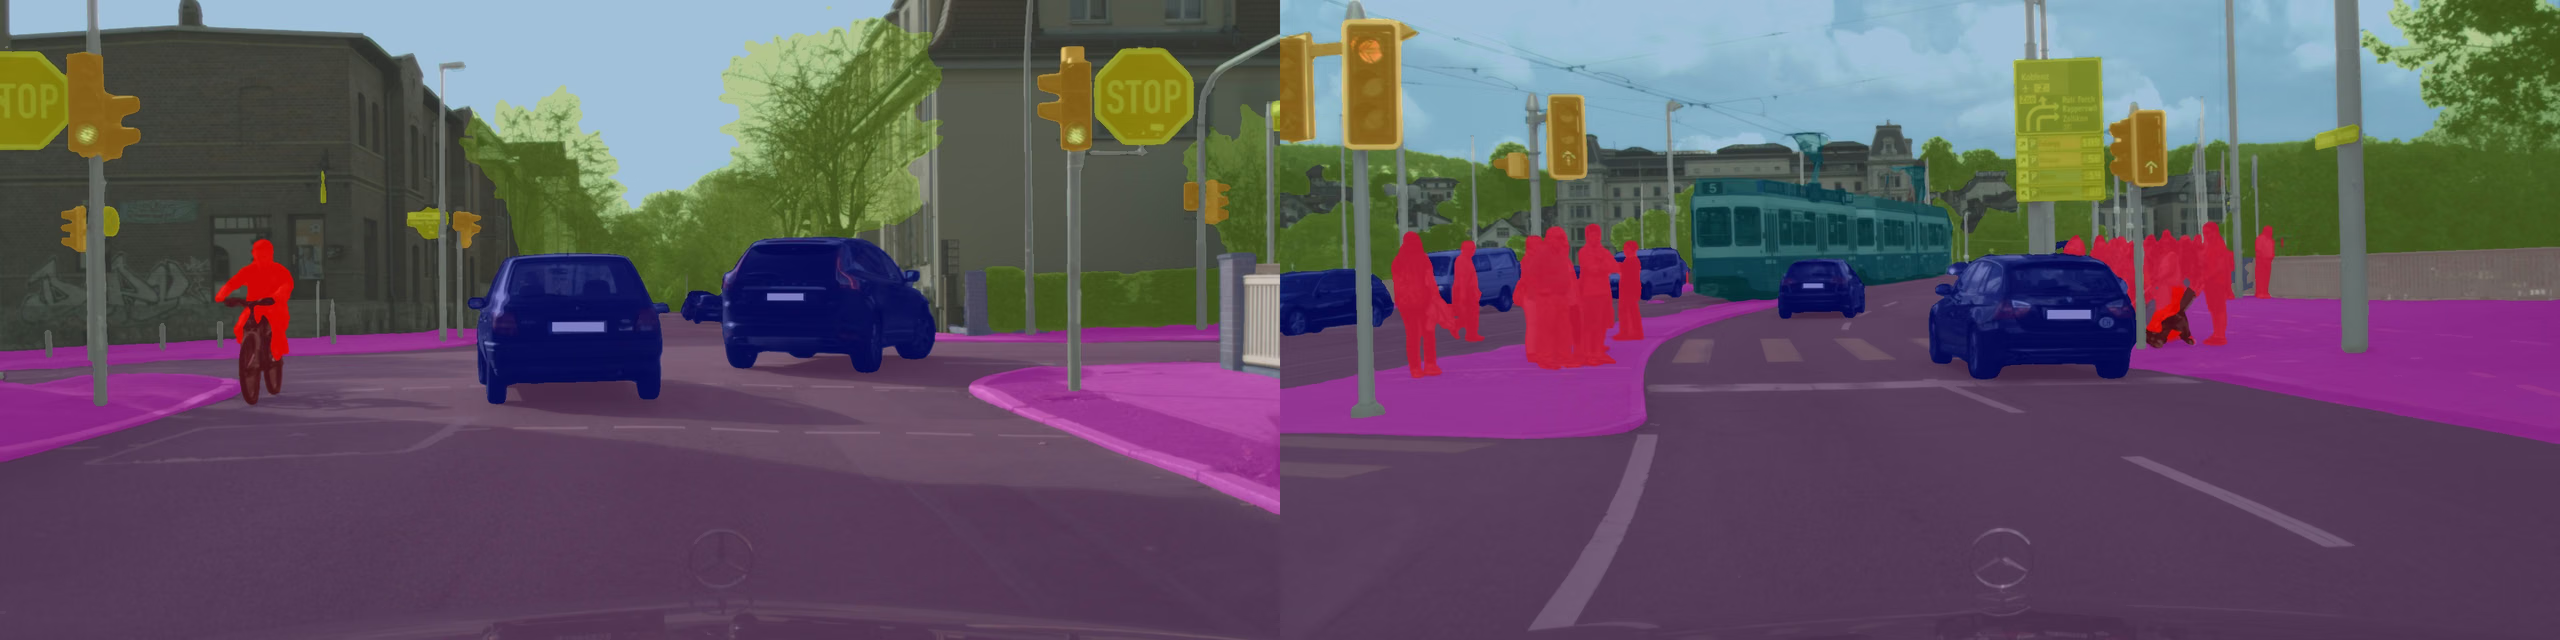
A segmentação semântica atribui um rótulo de classe a cada píxel de uma imagem, produzindo um mapa de classes denso que cobre toda a cena. Ao contrário da segmentação de instâncias, que separa objetos individuais, a segmentação semântica agrupa todos os píxeis da mesma classe, independentemente do número de objetos distintos presentes.
Assista: Segmentação semântica com Ultralytics YOLO26 | Tutorial de início rápido
O resultado de um modelo de segmentação semântica é um único mapa de classes com altura e largura, em que cada valor de píxel corresponde a um ID de classe previsto. Isto torna a segmentação semântica ideal para tarefas de interpretação de cenas, como condução autónoma, imagiologia médica e mapeamento da cobertura do solo.
Usa task=semantic ou a tarefa CLI yolo semantic para segmentação semântica. Os ficheiros dos modelos de segmentação semântica YOLO26 usam o sufixo -sem, como yolo26n-sem.pt.
Modelos#
Os modelos YOLO26 Semantic pré-treinados no conjunto de dados Cityscapes são apresentados abaixo.
Os modelos são transferidos automaticamente da versão mais recente do Ultralytics na primeira utilização.
| Modelo | tamanho (pixels) | mIoUval | Velocidade RTX3090 PyTorch (ms) | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- Os valores mIoUval correspondem a um único modelo e escala no conjunto de validação Cityscapes.
Reproduz comyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - As métricas de Velocidade são calculadas como a média das imagens de validação do Cityscapes, usando uma instância RTX3090.
Reproduz comyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - Os valores de Parâmetros e FLOPs correspondem ao modelo fundido após
model.fuse(), que combina as camadas Conv e BatchNorm. Os checkpoints pré-treinados mantêm a arquitetura de treino completa e podem apresentar contagens superiores.
Os modelos YOLO26 Semantic pré-treinados no conjunto de dados ADE20K são apresentados abaixo.
| Modelo | tamanho (pixels) | mIoUval | Velocidade RTX3090 PyTorch (ms) | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- Os valores mIoUval correspondem a um único modelo e escala no conjunto de validação ADE20K.
Reproduz comyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640, substituindoyolo26n-sem-ade20k.ptpelo checkpointyolo26*-sem-ade20k.ptpretendido. - As métricas de Velocidade são calculadas como a média das imagens de validação do ADE20K, usando uma instância RTX3090.
Reproduz comyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640, substituindoyolo26n-sem-ade20k.ptpelo checkpointyolo26*-sem-ade20k.ptpretendido. - Os valores de Parâmetros e FLOPs correspondem ao modelo fundido após
model.fuse(), que combina as camadas Conv e BatchNorm. Os checkpoints pré-treinados mantêm a arquitetura de treino completa e podem apresentar contagens superiores.
Consulta a prévia não lançada do YOLO27 para ver resultados preliminares de mIoU no Cityscapes.
Treinar#
Treina YOLO26n-sem no conjunto de dados Cityscapes8 durante 100 épocas, com um tamanho de imagem de 1024. Para ver a lista completa de argumentos disponíveis, consulta a página de Configuração.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-sem.yaml")  # crie um novo modelo a partir de YAML
model = YOLO("yolo26n-sem.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # crie a partir de YAML e transfira os pesos

# Treinar o modelo
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Consulta a página Treino para ver todos os detalhes do modo train. Também podes treinar modelos de segmentação semântica com o treino na nuvem da Ultralytics Platform.
Formato do conjunto de dados#
Os conjuntos de dados de segmentação semântica usam imagens de máscara de canal único, normalmente em PNG, nas quais cada valor de píxel representa um ID de classe. Os píxeis com o valor 255 são tratados como «ignorar» e excluídos do cálculo da perda. O YAML do conjunto de dados deve especificar os caminhos para as imagens e para os diretórios das máscaras correspondentes. Os conjuntos de dados com rótulos de polígonos YOLO são treinados diretamente, com conversão para máscaras em tempo real (consulta abaixo Posso usar dados de segmentação de instâncias). Consulta o Guia de conjuntos de dados de segmentação semântica para ver os detalhes do formato. Os conjuntos de dados suportados incluem Cityscapes e ADE20K. Podes gerir e rotular conjuntos de dados semânticos com a anotação da Ultralytics Platform.
Validar#
Valida a precisão do modelo YOLO26n-sem treinado num conjunto de dados de segmentação semântica. Passa data explicitamente para que a validação use o YAML do conjunto de dados pretendido.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-sem.pt")  # carrega um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Valida o modelo
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # interseção sobre união média
metrics.pixel_accuracy # precisão geral por píxelPrever#
Usa um modelo YOLO26n-sem treinado para fazer predições em imagens.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-sem.pt")  # carrega um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Faz previsões com o modelo
results = model("https://ultralytics.com/images/bus.jpg")  # faz uma previsão numa imagem

# Acede aos resultados
for result in results:
    semantic_mask = result.semantic_mask.data  # mapa de classes, forma (H,W), tipo de dados inteiro selecionado conforme o número de classes
Consulta os detalhes completos do modo predict na página Previsão.
Saída dos resultados#
A segmentação semântica do YOLO devolve um objeto Results por imagem. Cada resultado armazena um único mapa de classes denso para a imagem completa, em vez de uma lista de máscaras de objetos. Os píxeis com a mesma classe prevista partilham o mesmo ID de classe, mesmo quando pertencem a objetos separados.
| Atributo | Tipo | Formato | Descrição |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Mapa de classes denso. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | IDs de classe; o tipo de dado é escolhido de acordo com o número de classes. |
result.masks | - | - | Sem máscaras de instância. |
result.boxes | - | - | Sem caixas/confianças de instância. |
Para ver os campos Results específicos de cada tarefa, consulta a secção Resultados da previsão por tarefa.
A segmentação semântica prevê um mapa de classes denso e, em seguida, redimensiona-o para as dimensões originais da imagem, para visualização e utilização posterior. Por isso, estruturas muito finas, como marcas de faixa, linhas de campo, postes ou fios, podem parecer em escada quando a inferência é executada com um imgsz muito inferior à resolução original da imagem. Se os limites parecerem irregulares, volta primeiro a testar o modelo PyTorch nativo .pt com um imgsz maior, como 1024, 1280 ou o valor prático mais próximo do tamanho da imagem de origem. Usa modelos exportados apenas depois de confirmares que o resultado .pt é aceitável, pois entradas de resolução inferior não conseguem recuperar detalhes finos que não estavam presentes no mapa de classes previsto.
Segmentação de instâncias vs. segmentação semântica#
| Aspeto | Segmentação de instâncias (task="segment") | Segmentação semântica (task="semantic") |
|---|---|---|
| Objetivo da predição | Segmentar cada objeto detetado separadamente | Atribuir um ID de classe a cada píxel |
| Campo de saída | result.masks | result.semantic_mask |
| Dados principais | result.masks.data | result.semantic_mask.data |
| Formato | (N,H,W) | (H,W) |
| Valores dos píxeis | Valores de máscara binária: 0 ou 1 | IDs de classe: 0, 1, 2, ... |
| Tipo de dados | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Objetos da mesma classe | Mantidos como instâncias separadas | Fundidos na mesma região de classe |
| Polígonos | Sim, através de result.masks.xy e result.masks.xyn | Sem saída de polígonos por predefinição |
| Caixas e confiança | Sim, através de result.boxes | Sem caixas ou pontuações de confiança por instância |
| Utilização típica | Contagem, rastreamento, recorte, medição ao nível do objeto | Rotulagem densa de cenas, áreas transitáveis, cobertura do solo, regiões médicas |
Exportar#
Exporta um modelo YOLO26n-sem para outro formato, como ONNX, CoreML, etc.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-sem.pt")  # carrega um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Exporta o modelo
model.export(format="onnx")
Os formatos de exportação disponíveis para segmentação semântica YOLO26 estão na tabela abaixo. Podes exportar para qualquer formato usando o argumento format, por exemplo, format='onnx' ou format='engine'. Podes fazer predições ou validações diretamente nos modelos exportados, por exemplo, yolo predict model=yolo26n-sem.onnx. Os exemplos de utilização do teu modelo são apresentados após a conclusão da exportação.
| Formato | Argumento format | Modelo | Metadados | Argumentos |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-sem_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None usa por predefinição saídas brutas para NMS externo. Define nms=False para selecionar uma cabeça sem NMS disponível; os formatos não suportados recorrem ao respetivo caminho de saída nativo. As entradas nms acima identificam os formatos que podem incorporar NMS com nms=True.
Consulte os detalhes completos de export na página Exportação.
Perguntas frequentes#
Para treinar um modelo YOLO26 de segmentação semântica em um conjunto de dados personalizado, prepara imagens de máscara PNG em que o valor de cada pixel representa um ID de classe (0, 1, 2, ...) e os pixels com valor 255 são ignorados durante o treinamento. Cria um arquivo YAML do conjunto de dados que aponte para os diretórios de imagens e máscaras e, em seguida, treina o modelo:
Exemplofrom ultralytics import YOLO # Carrega um modelo YOLO26 de segmentação semântica pré-treinado model = YOLO("yolo26n-sem.pt") # Treinar o modelo results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=1024)Consulta a página de Configuração para ver mais argumentos disponíveis.
A segmentação de instâncias e a segmentação semântica são tarefas no nível dos pixels, mas diferem num aspeto fundamental:
- A segmentação semântica atribui um rótulo de classe a cada pixel, mas não distingue objetos individuais da mesma classe. Por exemplo, todos os carros de uma cena partilham o mesmo rótulo de classe.
- A segmentação de instâncias identifica cada objeto individualmente, produzindo máscaras distintas para cada objeto, mesmo quando pertencem à mesma classe.
A segmentação semântica é mais adequada para tarefas de compreensão de cenas, como condução autónoma e mapeamento da cobertura do solo, enquanto a segmentação de instâncias é preferível quando é importante contar ou acompanhar objetos individuais.
Sim. Se o teu conjunto de dados usar rótulos de polígonos Ultralytics YOLO (um
.txtpor imagem), omitemasks_dirdo YAML do conjunto de dados e certifica-te de que não existe uma pastamasks/junto às tuas imagens na raiz do conjunto de dados (só a presença dessa pasta já ativa o modo de máscara PNG, mesmo semmasks_dirdefinido). Em seguida, o carregador converte os polígonos em máscaras semânticas por imagem durante a execução. Para conjuntos de dados com várias classes (N > 1), uma classe extrabackgroundé acrescentada automaticamente anames. Para conjuntos de dados de classe única (N == 1), o treinamento mantém-se em 1 classe — a classe declarada passa a ser1na máscara e os pixels não cobertos passam a ser0. Consulta o Guia de conjuntos de dados para segmentação semântica para saber mais.O Ultralytics YOLO26 inclui configurações integradas para vários conjuntos de dados de segmentação semântica:
- Cityscapes: cenas urbanas de ruas com 19 classes, amplamente utilizado na investigação sobre condução autónoma.
- ADE20K: um conjunto de dados de grande escala para análise de cenas, com 150 classes.
Também podes usar qualquer conjunto de dados personalizado que forneça anotações de máscaras PNG, em que os valores dos pixels correspondam aos IDs das classes.
Valida um modelo YOLO26 de segmentação semântica pré-treinado com o YAML do conjunto de dados usado na avaliação:
Exemplofrom ultralytics import YOLO # Carregar um modelo pré-treinado model = YOLO("yolo26n-sem.pt") # Valida o modelo metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Estas etapas fornecem métricas de validação, como a interseção média sobre a união (mIoU) e a precisão por pixel, que são medidas padrão para avaliar o desempenho da segmentação semântica.
Exporta um modelo YOLO26 de segmentação semântica para o formato ONNX com comandos Python ou CLI:
Exemplofrom ultralytics import YOLO # Carregar um modelo pré-treinado model = YOLO("yolo26n-sem.pt") # Exporta o modelo para o formato ONNX model.export(format="onnx")Para mais detalhes sobre a exportação para vários formatos, consulta a página Exportação.