Exportação de modelos TFLite para implantação (descontinuado)#
A partir do Ultralytics 8.4.83, o formato de exportação independente tflite foi removido e substituído pelo formato unificado Google LiteRT. LiteRT (Lite Runtime) é a próxima geração e o novo nome do TensorFlow Lite, e exporta o mesmo modelo .tflite — agora abrangendo a implantação em dispositivos móveis, sistemas embarcados, edge e navegadores em um único formato.
format="tflite" ainda funciona, mas emite um aviso de descontinuação e exporta um modelo LiteRT. Usa format="litert" daqui em diante; para ver as instruções e opções de exportação atuais, consulta o guia de exportação do LiteRT.
A implantação de modelos de visão computacional em dispositivos edge ou embarcados exige um formato que garanta um desempenho consistente.
O antigo formato de exportação TensorFlow Lite ou TFLite otimizava modelos Ultralytics YOLO26 para tarefas como deteção de objetos e classificação de imagens em aplicações edge. Este guia preserva o contexto de implantação legado do TFLite; usa o LiteRT para novas exportações.
Por que se usava TFLite para exportação?#
Lançado pela Google em maio de 2017 como parte da framework TensorFlow, o TensorFlow Lite, ou TFLite, para abreviar, era uma framework de aprendizagem profunda de código aberto concebida para inferência no dispositivo, também conhecida como computação edge. Oferecia aos programadores ferramentas para executar modelos treinados em dispositivos móveis, embarcados e IoT, bem como em computadores convencionais.
O TensorFlow Lite era compatível com uma ampla gama de plataformas, incluindo Linux embarcado, Android, iOS e microcontroladores (MCUs). As exportações TFLite permitiam que as aplicações executassem modelos localmente e offline.
Principais funcionalidades dos modelos TFLite#
Os modelos TFLite oferecem várias funcionalidades importantes que permitem a aprendizagem automática no dispositivo, ajudando os programadores a executar os modelos em dispositivos móveis, embarcados e edge:
-
Otimização no dispositivo: o TFLite otimiza a aprendizagem automática no dispositivo, reduzindo a latência ao processar os dados localmente, reforçando a privacidade ao não transmitir dados pessoais e minimizando o tamanho do modelo para poupar espaço.
-
Compatibilidade com várias plataformas: o TFLite oferece ampla compatibilidade com plataformas, incluindo Android, iOS, Linux embarcado e microcontroladores.
-
Compatibilidade com diversas linguagens: o TFLite é compatível com várias linguagens de programação, incluindo Java, Swift, Objective-C, C++ e Python.
-
Alto desempenho: alcança um desempenho superior por meio da aceleração por hardware e da otimização do modelo.
Desempenho medido (histórico)#
Estes resultados foram registados com o plugin Flutter da Ultralytics 0.6.8 e o LiteRT 2.1.5 no Android 16/API 36 num Xiaomi 17 com 12 GB de memória LPDDR5X. O Snapdragon 8 Elite Gen 5 de 3 nm (SM8850) inclui uma CPU Qualcomm Oryon de 8 núcleos (2 núcleos Prime até 4,6 GHz e 6 núcleos Performance até 3,62 GHz), uma GPU Adreno e uma NPU Hexagon. Estas tabelas comparam os recursos TFLite INT8 legados do onnx2tf com as exportações litert-torch candidatas avaliadas durante a migração. Os recursos da versão foram posteriormente substituídos pelas exportações padronizadas, pelo que estes números não descrevem os bytes atuais do recurso v0.6.6. Consulta as tabelas de desempenho do LiteRT para ver as medições atuais.
Ambos os formatos foram executados na mesma sequência de testes de GPU, com os tamanhos de entrada indicados. Cada célula mostra o tempo total (pré-processamento + inferência + pós-processamento), com a divisão por etapa abaixo; os registos nativos confirmaram que ambos os formatos delegaram o grafo completo ao LiteRT OpenCL (LITERT_CL) na GPU Adreno.
| Modelo | Tarefa | tamanho (pixels) | Legado TFLite INT8 do onnx2tf (ms) | Candidato LiteRT w8a32 (ms) |
|---|---|---|---|---|
| YOLO26n | Detecção | 640 | 14.0 1.8 / 8.1 / 4.2 | 13.5 1.9 / 8.1 / 3.5 |
| YOLO26n-seg | Segmentação | 640 | 30.1 1.9 / 20.3 / 8.0 | 28.6 1.8 / 20.1 / 6.7 |
| YOLO26n-sem | Semântica | 640 | 26.4 1.9 / 16.4 / 8.1 | 32.9 1.8 / 23.0 / 8.2 |
| YOLO26n-cls | Classificação | 224 | 3.5 0.9 / 2.2 / 0.4 | 3.2 1.0 / 2.2 / 0.1 |
| YOLO26n-pose | Pose | 640 | 17.4 2.4 / 9.9 / 5.1 | 14.0 1.9 / 9.3 / 2.8 |
| YOLO26n-obb | OBB | 640 | 13.9 3.0 / 8.3 / 2.7 | 13.0 2.9 / 7.9 / 2.3 |
A mesma execução de migração também comparou formatos de quantização para deteção YOLO26n. A inferência é a métrica comparável, dependente do formato:
| Formato Android | Inferência na GPU (ms) | Compilação na GPU |
|---|---|---|
| onnx2tf INT8 (TFLite legado) | 8.6 | sim |
| LiteRT w8a32 (candidato) | 8.4 | sim |
LiteRT INT8 (quantize=8) | 11.0 | sim |
| LiteRT FP32 | 8.8 | sim |
LiteRT w8a16 (quantize="w8a16") | Alternativa de CPU | não |
Nesta execução, o w8a16 recorreu à CPU, com cerca de 660 ms no total, em comparação com cerca de 17 ms para os formatos de GPU. Estes resultados motivaram a distribuição de w8a32, mas a compatibilidade com delegados e o desempenho dependem do dispositivo e da versão do runtime. Testa o dispositivo de destino e confirma, nos registos do runtime, onde o acelerador está a ser usado.
Opções de implantação no TFLite#
Antes de vermos o exemplo de exportação que substitui o LiteRT, vamos entender como os modelos TFLite são normalmente utilizados.
O TFLite oferece várias opções de implantação de modelos de aprendizagem automática no dispositivo, incluindo:
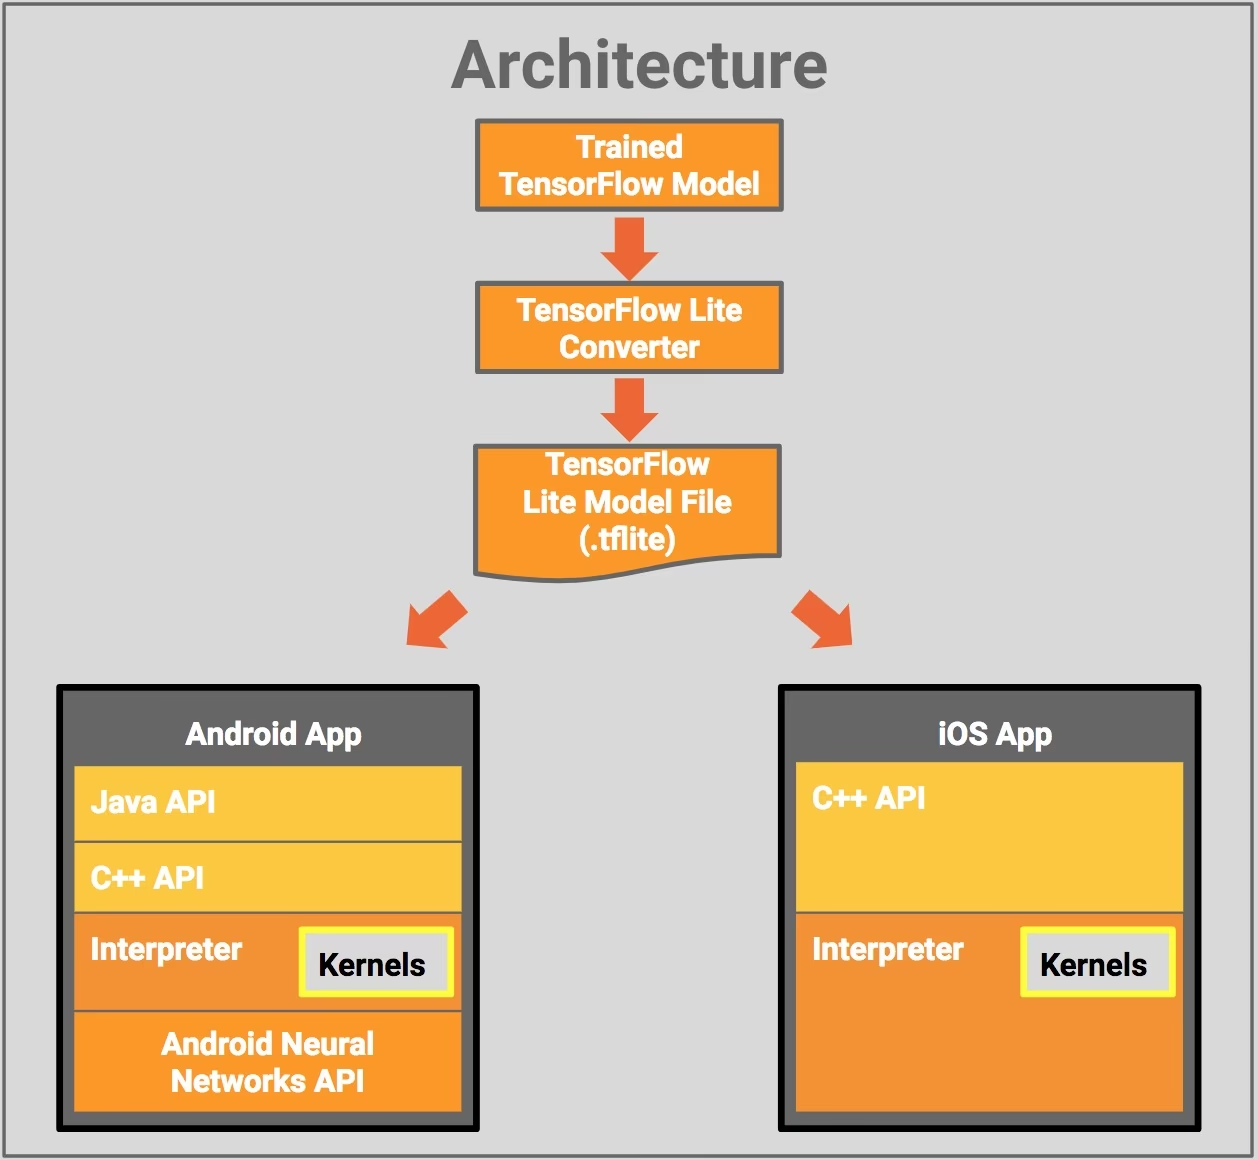
- Implantação com Android e iOS: as aplicações Android e iOS com TFLite podem analisar imagens de câmaras e dados de sensores captados em dispositivos edge para detetar e identificar objetos. O TFLite também oferece bibliotecas nativas para iOS escritas em Swift e Objective-C. O diagrama de arquitetura abaixo mostra o processo de implantação de um modelo treinado nas plataformas Android e iOS com o TensorFlow Lite.
-
Implementação com Linux embarcado: se a execução de inferências numa Raspberry Pi com o guia da Ultralytics não cumprir os requisitos de velocidade do teu caso de uso, podes usar um modelo TFLite exportado para acelerar a inferência. Também é possível melhorar ainda mais o desempenho usando um dispositivo Coral Edge TPU.
-
Implantação em microcontroladores: os modelos TFLite também podem ser implantados em microcontroladores e noutros dispositivos com apenas alguns quilobytes de memória. O runtime principal ocupa apenas 16 KB num Arm Cortex M3 e consegue executar muitos modelos básicos. Não requer suporte de sistema operativo, bibliotecas C ou C++ padrão nem alocação dinâmica de memória.
Substituir a exportação TFLite por LiteRT#
Para novas exportações, converte o teu modelo para LiteRT. O modelo resultante mantém a extensão de ficheiro .tflite.
Instalação#
Para instalar os pacotes necessários, executa:
# Install the required package for YOLO26
pip install ultralytics
Para obter instruções detalhadas e boas práticas relacionadas ao processo de instalação, consulte nosso guia de instalação da Ultralytics. Se tiver dificuldades ao instalar os pacotes necessários para YOLO26, consulte nosso guia de problemas comuns para ver soluções e dicas.
Uso#
Todos os modelos Ultralytics YOLO26 foram concebidos para suportar a exportação de origem, o que facilita a integração no fluxo de trabalho de implementação que preferires. Podes consultar a lista completa de formatos de exportação suportados e opções de configuração para escolheres a melhor configuração para a tua aplicação.
O formato LiteRT substituto é compatível com os modos Exportar, Prever e Validar. Exporta o teu modelo e, em seguida, carrega o modelo .tflite exportado para executar inferências ou validar a sua precisão.
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporte o modelo para o formato LiteRT
model.export(format="litert", imgsz=640) # usar imgsz=224 para classificaçãofrom ultralytics import YOLO
# Carregar o modelo TFLite exportado
model = YOLO("yolo26n.tflite")
# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carregar o modelo TFLite exportado
model = YOLO("yolo26n.tflite")
# Validar a precisão no conjunto de dados COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportação#
| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
format | str | 'litert' | Formato de destino do modelo exportado, que define a compatibilidade com vários ambientes de implantação. |
imgsz | int ou tuple | 640 | Tamanho de imagem desejado para a entrada do modelo. Pode ser um inteiro para imagens quadradas ou uma tupla (height, width) para dimensões específicas. |
quantize | int ou str | None | Precisão da quantização: 8 (INT8 estático, pesos int8 + ativações int8; requer calibração data/fraction), 'w8a16' (estático, pesos int8 + ativações int16; requer calibração data/fraction), 'w8a32' (INT8 dinâmico, pesos int8 + ativações FP32; não requer calibração) ou 32/não definido (FP32). FP16 não é exportado separadamente — um modelo FP32 é executado automaticamente em FP16 em delegados de GPU. Substitui as flags obsoletas half/int8. |
batch | int | 1 | Especifica o tamanho do lote de inferência do modelo exportado ou o número máximo de imagens que o modelo exportado processará em simultâneo no modo predict. |
data | str | None | Caminho para o YAML do conjunto de dados, essencial para a quantização; para classificação, use um diretório de conjunto de dados ou o nome de um conjunto de dados integrado. Se omitido com quantize=8 ou 'w8a16', Ultralytics seleciona o conjunto de dados de calibração padrão para a tarefa do modelo. |
fraction | float, int ou list | 1.0 | Subconjunto de calibração como proporção, número de imagens ou proporções/contagens [train, val, test]. Listas de dois itens deixam test completo, enquanto 0 o ignora. |
device | str | None | Especifica o dispositivo para a exportação: CPU (device=cpu), MPS para Apple silicon (device=mps). |
Para mais detalhes sobre o processo de exportação, visita a página da documentação da Ultralytics sobre exportação.
Implantar modelos YOLO26 TFLite exportados#
Depois de exportares o teu modelo Ultralytics YOLO26 para o formato LiteRT, podes implantar o modelo .tflite resultante. O primeiro passo recomendado para executar um modelo TFLite é usar o método YOLO("model.tflite"), conforme descrito no excerto de código de utilização anterior. No entanto, para instruções detalhadas sobre a implantação dos modelos TFLite noutros contextos, consulta os seguintes recursos:
-
Android: um guia de início rápido para integrar o TensorFlow Lite em aplicações Android, com instruções fáceis de seguir para configurar e executar modelos de aprendizagem automática.
-
iOS: consulta este guia detalhado para programadores sobre a integração e implantação de modelos TensorFlow Lite em aplicações iOS, com instruções passo a passo e recursos.
-
Exemplos de ponta a ponta: esta página apresenta vários exemplos de TensorFlow Lite, com aplicações práticas e tutoriais que ajudam os programadores a implementar o TensorFlow Lite em projetos de aprendizagem automática para dispositivos móveis e edge.
Resumo#
Este guia preserva o fluxo de trabalho legado de implantação do TFLite. Para novas exportações, usa o LiteRT para criar modelos .tflite destinados a ambientes de computação edge.
Para mais detalhes sobre a utilização, consulta a documentação oficial do TFLite.
Além disso, se quiseres conhecer outras integrações da Ultralytics YOLO26, consulta a nossa página do guia de integrações. Vais encontrar lá muitas informações e dicas úteis.
Perguntas frequentes#
Para uma nova exportação, usa o formato LiteRT. Primeiro, instala o pacote necessário com:
pip install ultralyticsEm seguida, usa o seguinte excerto de código para exportar o teu modelo:
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporte o modelo para o formato LiteRT
model.export(format="litert", imgsz=640)  # usar imgsz=224 para classificação
Se usas a CLI, podes fazer isso com:
yolo export model=yolo26n.pt format=litert imgsz=640 # use imgsz=224 for classificationPara mais detalhes, consulta o guia de exportação da Ultralytics.
O TensorFlow Lite (TFLite) é um framework de código aberto de aprendizado profundo projetado para inferência no dispositivo, o que o torna ideal para implantar modelos YOLO26 em dispositivos móveis, embarcados e IoT. As principais vantagens incluem:
- Otimização no dispositivo: reduz a latência e reforça a privacidade ao processar os dados localmente.
- Compatibilidade com plataformas: compatível com Android, iOS, Linux embarcado e MCU.
- Desempenho: utiliza aceleração por hardware para otimizar a velocidade e a eficiência do modelo.
Para saber mais, consulta o guia do TFLite.
Sim, podes executar modelos YOLO26 TFLite numa Raspberry Pi para aumentar a velocidade de inferência. Primeiro, exporta o teu modelo para o formato LiteRT, conforme explicado acima. Em seguida, usa uma ferramenta como o TensorFlow Lite Interpreter para executar o modelo na tua Raspberry Pi.
Para otimizar ainda mais, podes considerar usar o Coral Edge TPU. Para instruções detalhadas, consulta o nosso guia de implantação na Raspberry Pi e o guia de integração do Edge TPU.
O TFLite permite a implantação em microcontroladores com recursos limitados: o runtime principal requer apenas 16 KB de memória num Arm Cortex M3 e consegue executar muitos modelos básicos. No entanto, os modelos YOLO26 são geralmente demasiado grandes para a memória disponível nos microcontroladores típicos, pelo que computadores de placa única, dispositivos móveis ou aceleradores dedicados são opções mais adequadas para YOLO26.
Para começar, consulta o guia do TFLite Micro para microcontroladores.
O TensorFlow Lite oferece ampla compatibilidade com plataformas, permitindo implantar modelos YOLO26 em vários dispositivos, incluindo:
- Android e iOS: suporte nativo por meio das bibliotecas TFLite para Android e iOS.
- Linux embarcado: ideal para computadores de placa única, como a Raspberry Pi.
- Microcontroladores: adequado para MCUs com recursos limitados.
Para mais informações sobre as opções de implantação, consulta o nosso guia detalhado de implantação.
Se encontrares erros ao exportar modelos YOLO26 para LiteRT, algumas soluções comuns incluem:
- Verifica a compatibilidade dos pacotes: confirma que estás a usar versões compatíveis de Ultralytics,
litert-torcheai-edge-litert. Consulta o nosso guia de instalação. - Compatibilidade do modelo: confirma se o modelo YOLO26 específico é compatível com a exportação para LiteRT, consultando a página da documentação de exportação da Ultralytics.
- Problemas de quantização: ao usar quantização INT8, verifica se o caminho do conjunto de dados está especificado corretamente no parâmetro
data.
Para mais dicas de solução de problemas, consulta nosso guia de problemas comuns.
- Verifica a compatibilidade dos pacotes: confirma que estás a usar versões compatíveis de Ultralytics,