Набор данных Caltech-101#
Набор данных Caltech-101 — классический эталонный набор для классификации изображений, состоящий из 9 144 изображений 101 категории объектов и одного класса фона. В каждой категории около 40–800 изображений реальных объектов — животных, транспортных средств, предметов быта и людей. Это компактный, но сложный эталонный набор для моделей распознавания объектов.
Открой Caltech-101 на платформе Ultralytics, чтобы просмотреть примеры, изучить статистику набора данных и скопировать его для обучения.
Смотри: Как обучить модель классификации изображений на датасете Caltech-101 с помощью платформы Ultralytics
В Caltech-101 нет заранее заданного разделения на обучающую и валидационную выборки. Приведённые ниже команды обучения автоматически разделят данные: 80% для обучения и 20% для валидации, поэтому вручную подготавливать их не нужно.
Основные особенности#
- В Caltech-101 содержится 9 144 цветных изображения из 101 категории объектов и одного класса
BACKGROUND_Google(всего 102 каталога классов). - Категории охватывают множество реальных объектов, в том числе животных, транспортные средства, предметы быта и людей.
- В каждой категории около 40–800 изображений, поэтому размеры классов несбалансированы.
- Размеры изображений различаются; большинство имеют размер примерно 300x200 пикселей (среднее разрешение).
- Caltech-101 широко используется для оценки алгоритмов классификации изображений и распознавания объектов.
Структура набора данных#
Caltech-101 распространяется в виде 102 папок — по одной на класс: 101 категория объектов и класс BACKGROUND_Google. Заранее заданного разделения на обучающую и валидационную выборки нет. При запуске обучения Ultralytics автоматически разделяет изображения, поэтому модели обучаются на всех 102 классах без ручной настройки:
- Классы: 102 (101 категория объектов + 1 класс фона)
- Всего изображений: 9 144
- Разделение на обучающую и валидационную выборки: автоматически, 80% / 20% (≈7 280 для обучения, ≈1 864 для валидации)
- Изображений на класс: примерно от 40 до 800 (дисбаланс классов)
Применение#
Caltech-101 широко используется для обучения и оценки моделей классификации изображений и распознавания объектов, включая сверточные нейронные сети (CNNs) и метод опорных векторов (SVMs). Широкий охват категорий и качественные размеченные изображения делают этот датасет популярным бенчмарком для исследований и создания прототипов в области машинного обучения и компьютерного зрения.
Использование#
Обучи модель YOLO на Caltech-101 в течение 100 эпох с размером изображения 416. Полный список доступных аргументов смотри на странице обучения и в руководстве по задаче классификации изображений.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-cls.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="caltech101", epochs=100, imgsz=416)
Примеры изображений и аннотаций#
Датасет Caltech-101 содержит высококачественные цветные изображения различных объектов и имеет хорошо организованную структуру для задач классификации изображений. Вот несколько примеров изображений из датасета:
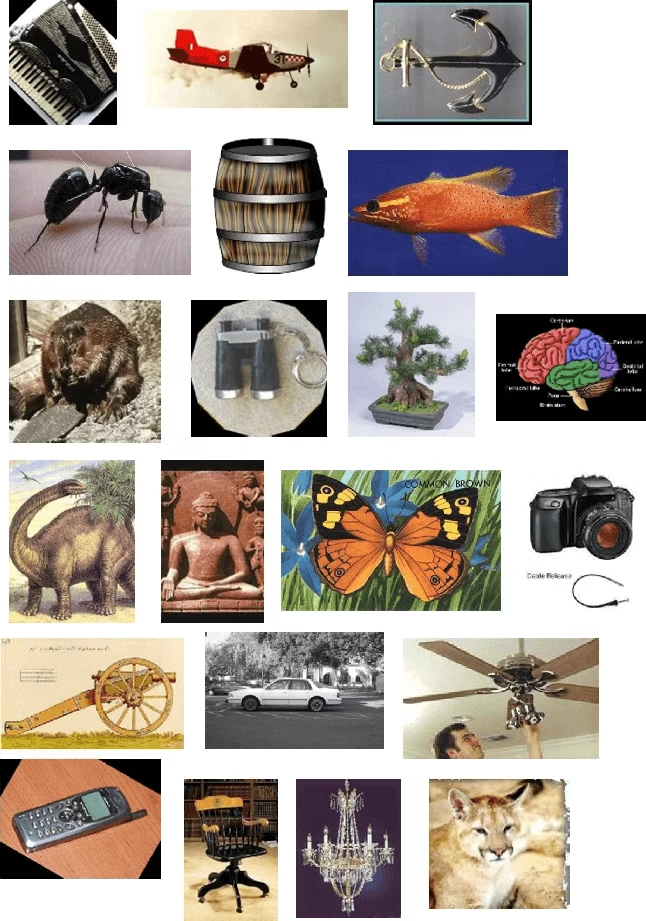
Примеры демонстрируют разнообразие категорий и характерное для Caltech-101 естественное кадрирование с объектом по центру, благодаря чему датасет отлично подходит для начала обучения устойчивых моделей распознавания объектов.
Цитирование и благодарности#
Если ты используешь датасет Caltech-101 в исследованиях или разработке, укажи в цитировании следующую статью:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
Мы хотели бы поблагодарить Li Fei-Fei, Rob Fergus и Pietro Perona за создание и поддержку датасета Caltech-101 — ценного ресурса для сообщества исследователей в области машинного обучения и компьютерного зрения. Подробнее о датасете Caltech-101 и его создателях можно узнать на сайте датасета Caltech-101.
Часто задаваемые вопросы#
Датасет Caltech-101 широко используется для обучения и сравнения моделей классификации изображений и распознавания объектов. Он содержит 9 144 изображения из 101 категории объектов и класс фона, что делает его сложным бенчмарком для оценки таких алгоритмов, как сверточные нейронные сети (CNNs) и метод опорных векторов (SVMs).
Чтобы обучить модель Ultralytics YOLO на Caltech-101, воспользуйся приведенными ниже фрагментами кода. При первом использовании датасет загружается автоматически. Полный список аргументов смотри на странице обучения модели.
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n-cls.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="caltech101", epochs=100, imgsz=416)Caltech-101 содержит 101 категорию объектов и один класс
BACKGROUND_Google, всего 102 папки классов и 9 144 изображения. При обучении с Ultralytics модель учится распознавать все 102 класса. Размеры категорий несбалансированы: в каждой примерно от 40 до 800 изображений.В Caltech-101 нет заранее заданного разделения. При первом запуске обучения Ultralytics автоматически делит датасет на 80% обучающих и 20% валидационных данных — примерно 7 280 обучающих и 1 864 валидационных изображения, — поэтому вручную создавать разделения не нужно. Чтобы задать разделение самостоятельно, перед обучением разложи изображения по папкам
train/иval/.Да. Ultralytics Platform позволяет управлять датасетами, обучать модели классификации изображений и развертывать их без написания большого объема кода. Это удобный способ проводить эксперименты с Caltech-101 в облаке. Другие варианты ты найдешь в нашем обзоре датасетов для классификации.