Датасет CIFAR-10#
Датасет CIFAR-10 (Канадский институт перспективных исследований) — это классический бенчмарк для классификации изображений, содержащий 60 000 цветных изображений размером 32x32, равномерно распределённых по 10 классам: самолёт, автомобиль, птица, кошка, олень, собака, лягушка, лошадь, корабль и грузовик. Он включает заранее заданное разбиение на 50 000 обучающих и 10 000 тестовых изображений (по 6 000 на класс), что делает его компактной и хорошо сбалансированной отправной точкой для обучения и оценки моделей классификации. Для более детализированной задачи см. связанный датасет CIFAR-100.
Открой CIFAR-10 на платформе Ultralytics, чтобы просмотреть примеры, изучить статистику датасета и клонировать его для обучения.
Ключевые особенности#
- CIFAR-10 содержит 60 000 цветных изображений размером 32x32 пикселя, равномерно разделённых на 10 классов.
- Каждый класс содержит ровно 6 000 изображений — 5 000 для обучения и 1 000 для тестирования, поэтому датасет идеально сбалансирован.
- 10 классов: самолёт, автомобиль, птица, кошка, олень, собака, лягушка, лошадь, корабль и грузовик.
- Датасет включает заранее заданное разбиение на обучающую и тестовую выборки, поэтому ручное или автоматическое разбиение не требуется.
- CIFAR-10 — стандартный бенчмарк для исследований в области классификации изображений и распознавания объектов.
Структура датасета#
CIFAR-10 включает официальное заранее заданное разбиение, поэтому автоматическое или ручное разделение не требуется:
- Классы: 10 (самолёт, автомобиль, птица, кошка, олень, собака, лягушка, лошадь, корабль, грузовик)
- Всего изображений: 60 000 (цветные, 32x32)
- Обучающая выборка: 50 000 изображений (по 5 000 на класс)
- Тестовая выборка: 10 000 изображений (по 1 000 на класс)
В CIFAR-10 нет отдельной папки для валидации, поэтому во время обучения Ultralytics по умолчанию использует тестовую выборку из 10 000 изображений как валидационную.
Применения#
CIFAR-10 широко используется для обучения и оценки моделей классификации изображений — от классических свёрточных нейронных сетей (CNNs) и методов опорных векторов (SVMs) до современных глубоких архитектур. Небольшой размер изображений и сбалансированные классы делают его идеальным для быстрых экспериментов, тестирования новых алгоритмов и изучения основ компьютерного зрения.
Использование#
Обучи модель YOLO на CIFAR-10 в течение 100 эпох с размером изображения 32. Полный список доступных аргументов см. на странице Обучение и в руководстве по задаче классификации изображений.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar10", epochs=100, imgsz=32)
Примеры изображений и аннотаций#
Датасет CIFAR-10 содержит цветные изображения различных объектов и представляет собой хорошо структурированный набор данных для задач классификации изображений. Ниже приведены некоторые примеры изображений из датасета:
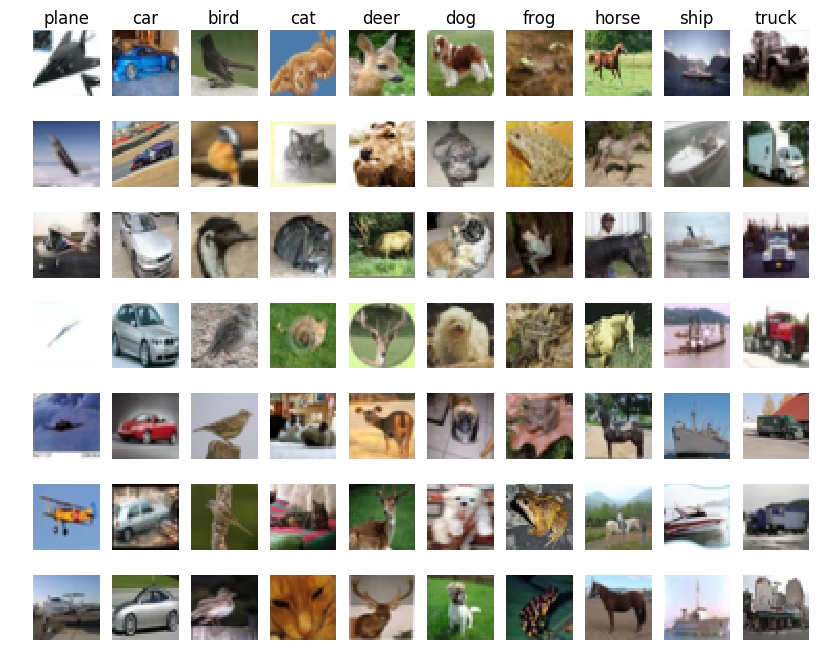
Примеры демонстрируют разнообразие объектов в датасете CIFAR-10 и подчёркивают ценность разнообразного датасета для обучения устойчивых моделей классификации изображений.
Цитирование и благодарности#
Если ты используешь датасет CIFAR-10 в исследовательской или разработческой работе, пожалуйста, процитируй следующую статью:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Мы хотели бы выразить благодарность Алексу Крижевскому за создание и поддержку датасета CIFAR-10 как ценного ресурса для сообщества исследователей в области машинного обучения и компьютерного зрения. Дополнительную информацию о датасете CIFAR-10 и его создателе см. на сайте датасета CIFAR-10.
Часто задаваемые вопросы#
Датасет CIFAR-10 широко используется для обучения и тестирования моделей классификации изображений и распознавания объектов. Он содержит 60 000 цветных изображений размером 32x32, равномерно распределённых по 10 классам, а его небольшой размер и сбалансированные классы делают его быстрым и надёжным бенчмарком для таких алгоритмов, как свёрточные нейронные сети (CNNs) и методы опорных векторов (SVMs).
Чтобы обучить модель Ultralytics YOLO на CIFAR-10, используй приведённые ниже фрагменты кода. При первом использовании датасет скачивается автоматически. Полный список аргументов см. на странице Обучение модели.
Пример обученияfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar10", epochs=100, imgsz=32)CIFAR-10 содержит 10 классов — самолёт, автомобиль, птица, кошка, олень, собака, лягушка, лошадь, корабль и грузовик — ровно по 6 000 изображений в каждом, то есть всего 60 000 изображений. Классы взаимоисключающие и идеально сбалансированные, между категориями нет пересечений.
CIFAR-10 включает заранее заданное разбиение на 50 000 обучающих и 10 000 тестовых изображений, ровно по 5 000 обучающих и 1 000 тестовых изображений на класс. В отличие от классификационных датасетов на основе папок, которые Ultralytics разделяет автоматически, официальное разбиение CIFAR-10 используется без изменений, а тестовая выборка по умолчанию служит валидационной во время обучения.
Да. Платформа Ultralytics позволяет управлять датасетами, обучать модели классификации изображений и развёртывать их без значительного объёма кода. Это удобный способ проводить эксперименты с CIFAR-10 в облаке, а дополнительные возможности можно изучить в нашем обзоре датасетов для классификации.