Датасет CIFAR-100
Датасет CIFAR-100 (Канадский институт перспективных исследований) — бенчмарк для классификации изображений, содержащий 60 000 цветных изображений размером 32x32, равномерно распределенных по 100 детализированным классам (по 600 изображений в каждом), которые, в свою очередь, объединены в 20 укрупненных суперклассов. Датасет, созданный Alex Krizhevsky, содержит заранее заданные 50 000 обучающих и 10 000 тестовых изображений и является более сложным и детализированным аналогом CIFAR-10.
Открой CIFAR-100 на Ultralytics Platform, чтобы просмотреть примеры, изучить статистику датасета и создать его копию для обучения.
Смотри: Как обучить модель классификации изображений на CIFAR-100 с помощью Ultralytics YOLO
Основные особенности#
- CIFAR-100 содержит 60 000 цветных изображений размером 32x32 пикселя, равномерно распределенных по 100 классам.
- В каждом классе ровно 600 изображений — 500 для обучения и 100 для тестирования, поэтому датасет идеально сбалансирован.
- 100 детализированных классов сгруппированы в 20 укрупненных суперклассов для классификации на более высоком уровне.
- Датасет содержит заранее заданное разделение на обучающую и тестовую выборки, поэтому вручную или автоматически делить данные не нужно.
- CIFAR-100 — стандартный ориентир для исследований в области тонкой классификации изображений и распознавания объектов.
Структура набора данных#
В CIFAR-100 задано официальное разделение на выборки, поэтому автоматически или вручную делить данные не нужно:
- Классы: 100 детализированных классов, сгруппированных в 20 укрупненных суперклассов
- Всего изображений: 60 000 (цветные, размером 32x32)
- Обучающая выборка: 50 000 изображений (по 500 на класс)
- Тестовая выборка: 10 000 изображений (по 100 на класс)
В CIFAR-100 нет отдельной папки для валидации, поэтому по умолчанию Ultralytics использует тестовую выборку из 10 000 изображений для валидации во время обучения. Обучение с data="cifar100" позволяет модели распознавать 100 детализированных классов.
Применение#
CIFAR-100 широко используют для обучения и оценки моделей классификации изображений: от классических сверточных нейронных сетей (CNNs) и метода опорных векторов (SVMs) до современных глубоких архитектур. Сто тонких классов и небольшой размер изображений делают его сложным ориентиром для исследований в области машинного обучения, сравнения алгоритмов и экспериментов с компьютерным зрением.
Использование#
Обучи модель YOLO26n-cls на наборе данных CIFAR-100 в течение 100 эпох с размером изображения 32.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-cls.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="cifar100", epochs=100, imgsz=32)
Примеры изображений и аннотаций#
Примеры изображений из датасета CIFAR-100:
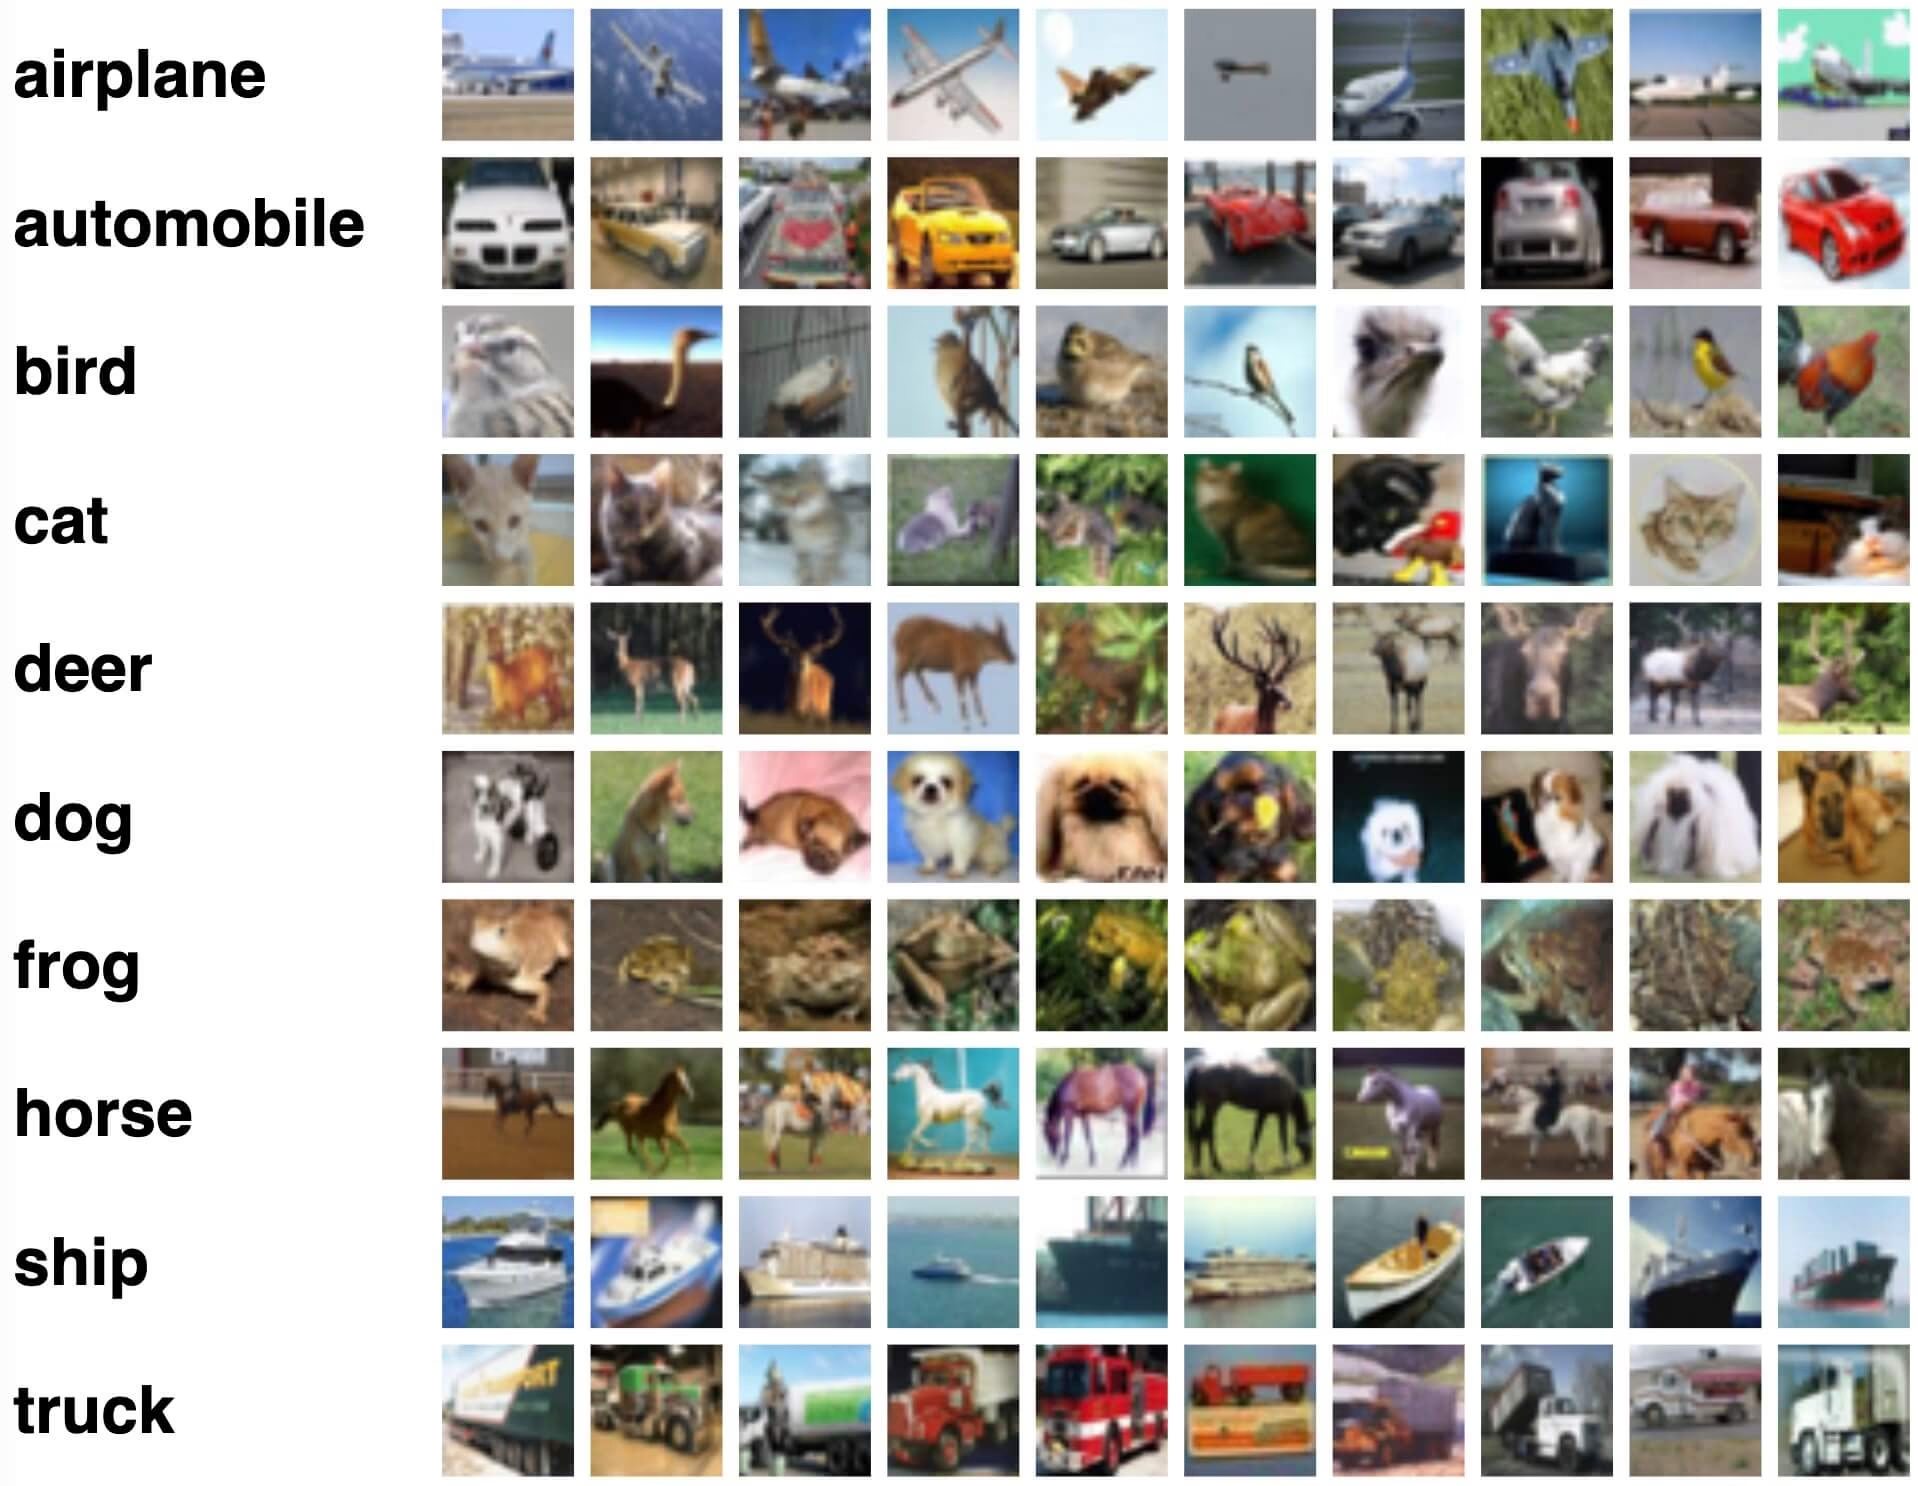
Примеры демонстрируют разнообразие объектов в датасете CIFAR-100 и показывают, насколько разнообразный датасет важен для обучения надежных моделей классификации изображений.
Цитирование и благодарности#
Если ты используешь датасет CIFAR-100 в исследованиях или разработке, укажи в цитировании следующую статью:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Мы хотели бы поблагодарить Алекса Крижевского за создание и поддержку набора данных CIFAR-100, ценного ресурса для сообщества исследователей машинного обучения и компьютерного зрения.
Часто задаваемые вопросы#
Датасет CIFAR-100 широко используют для обучения и оценки моделей тонкой классификации изображений и распознавания объектов. Он содержит 60 000 цветных изображений размером 32x32, распределённых по 100 классам и объединённых в 20 суперклассов. Это более сложный ориентир, чем CIFAR-10, для алгоритмов вроде сверточных нейронных сетей (CNNs) и метода опорных векторов (SVMs), а также для оценки моделей глубокого обучения, созданных с помощью Ultralytics YOLO.
Чтобы обучить модель Ultralytics YOLO на CIFAR-100, используй приведенные ниже фрагменты кода. При первом использовании датасет загружается автоматически. Полный список аргументов смотри на странице обучения модели.
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n-cls.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="cifar100", epochs=100, imgsz=32)В CIFAR-100 100 детализированных классов — например, яблоко, дельфин, клен, мотоцикл и ракета, — в каждом ровно по 600 изображений, всего 60 000 изображений. Эти 100 классов также сгруппированы в 20 укрупненных суперклассов (например, суперкласс деревьев включает клен, дуб, пальму, сосну и иву). При обучении с помощью
data="cifar100"используются 100 детализированных классов.CIFAR-100 поставляется с заранее заданным разделением на 50 000 обучающих и 10 000 тестовых изображений: на каждый класс приходится ровно 500 обучающих и 100 тестовых изображений. В отличие от классификационных датасетов, организованных по папкам и автоматически разделяемых Ultralytics, официальное разбиение CIFAR-100 используется без изменений, а тестовая выборка по умолчанию служит валидационной при обучении.
Да. Ultralytics Platform позволяет управлять датасетами, обучать модели классификации изображений и развертывать их без сложного программирования. Это удобный способ запускать эксперименты с CIFAR-100 в облаке; больше вариантов ты найдешь в нашем обзоре датасетов для классификации.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.