Обзор датасетов для обнаружения объектов
Для обучения надежной и точной модели обнаружения объектов нужен полноценный датасет. В этом руководстве описаны различные форматы датасетов, совместимые с моделью Ultralytics YOLO, а также их структура, использование и преобразование между форматами.
Поддерживаемые форматы датасетов#
Формат Ultralytics YOLO#
Формат Ultralytics YOLO — это формат конфигурации датасета, который позволяет указать корневой каталог датасета, относительные пути к каталогам с изображениями для обучения, валидации и тестирования либо к файлам *.txt со списками путей к изображениям, а также словарь имен классов. Пример:
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8 dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8
# Example usage: yolo train data=coco8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8.zip
Каждый из объектов train, val и test принимает каталог, файл изображения, список каталогов или файлов изображений либо файл *.txt в кодировке UTF-8, в котором указан путь к одному изображению на каждой строке (пути, начинающиеся с ./, считаются относительно файла *.txt). Файл *.txt пригодится, чтобы обучаться на подмножестве изображений из каталога, пропускать изображения без разметки или объединять изображения из нескольких источников в одно разделение.
path: datasets/coco8 # dataset root
train: train.txt # a directory, an image, a list e.g. [images/a, images/b], or a *.txt file
val: val.txt
names:
  0: person
(Необязательно) colors задаёт каждому классу цвет отображения в виде заключённой в кавычки строки "#rrggbb", индексируемой по идентификатору класса, например, colors: ["#042aff", "#ff0000"]. Обученные и экспортированные модели сохраняют эти цвета для своих предсказаний; для классов без такого цвета используется стандартная палитра. Запись набора данных NDJSON может содержать такое же поле colors.
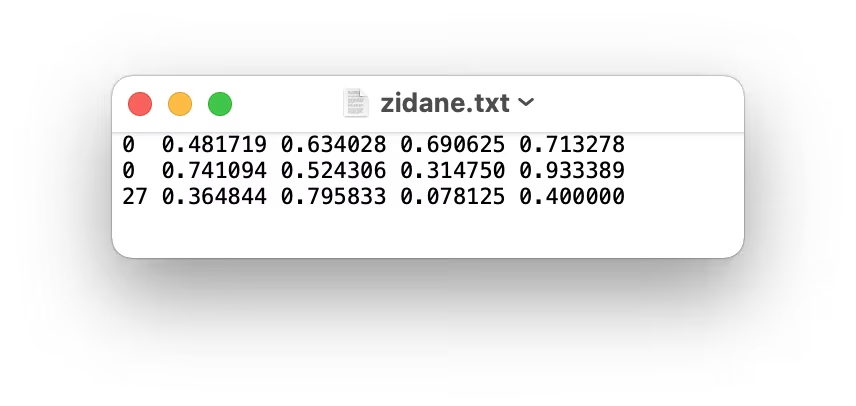
Метки в этом формате нужно экспортировать в формат YOLO: для каждого изображения создаётся один файл *.txt. Если на изображении нет объектов, файл *.txt не требуется. Файл *.txt должен содержать по одной строке на объект в формате class x_center y_center width height. Координаты ограничивающей рамки должны быть в нормализованном формате xywh (от 0 до 1). Если координаты рамок указаны в пикселях, раздели x_center и width на ширину изображения, а y_center и height — на его высоту. Координаты относятся к изображению в том виде, в котором его показывают средства просмотра, с учётом ориентации EXIF; именно так Ultralytics считывает все изображения. Номера классов должны начинаться с нуля.
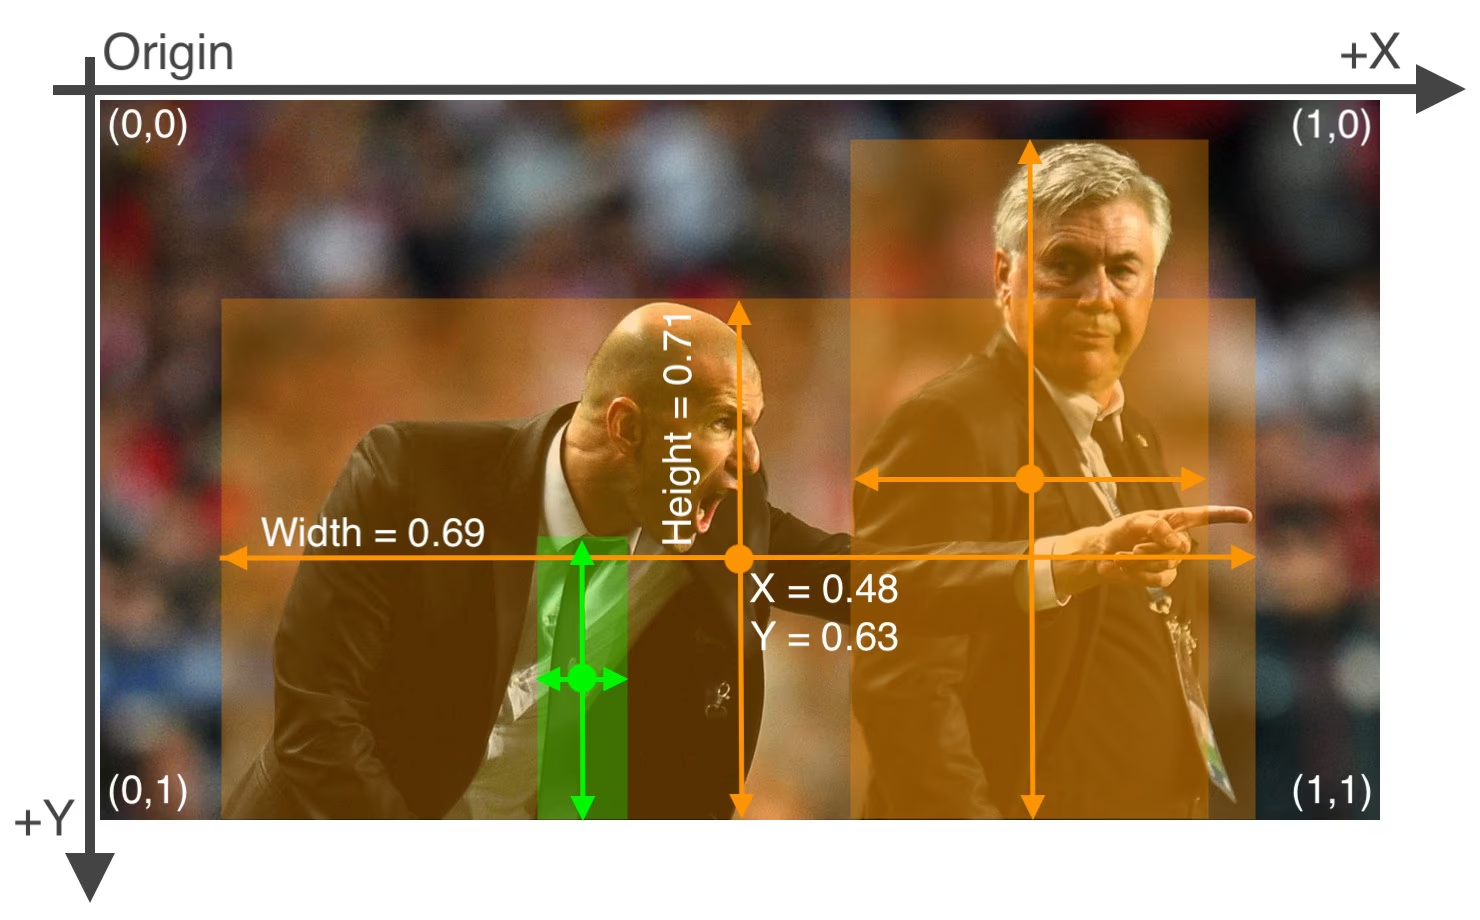
Файл разметки для изображения выше содержит 2 человек (класс 0) и галстук (класс 27):
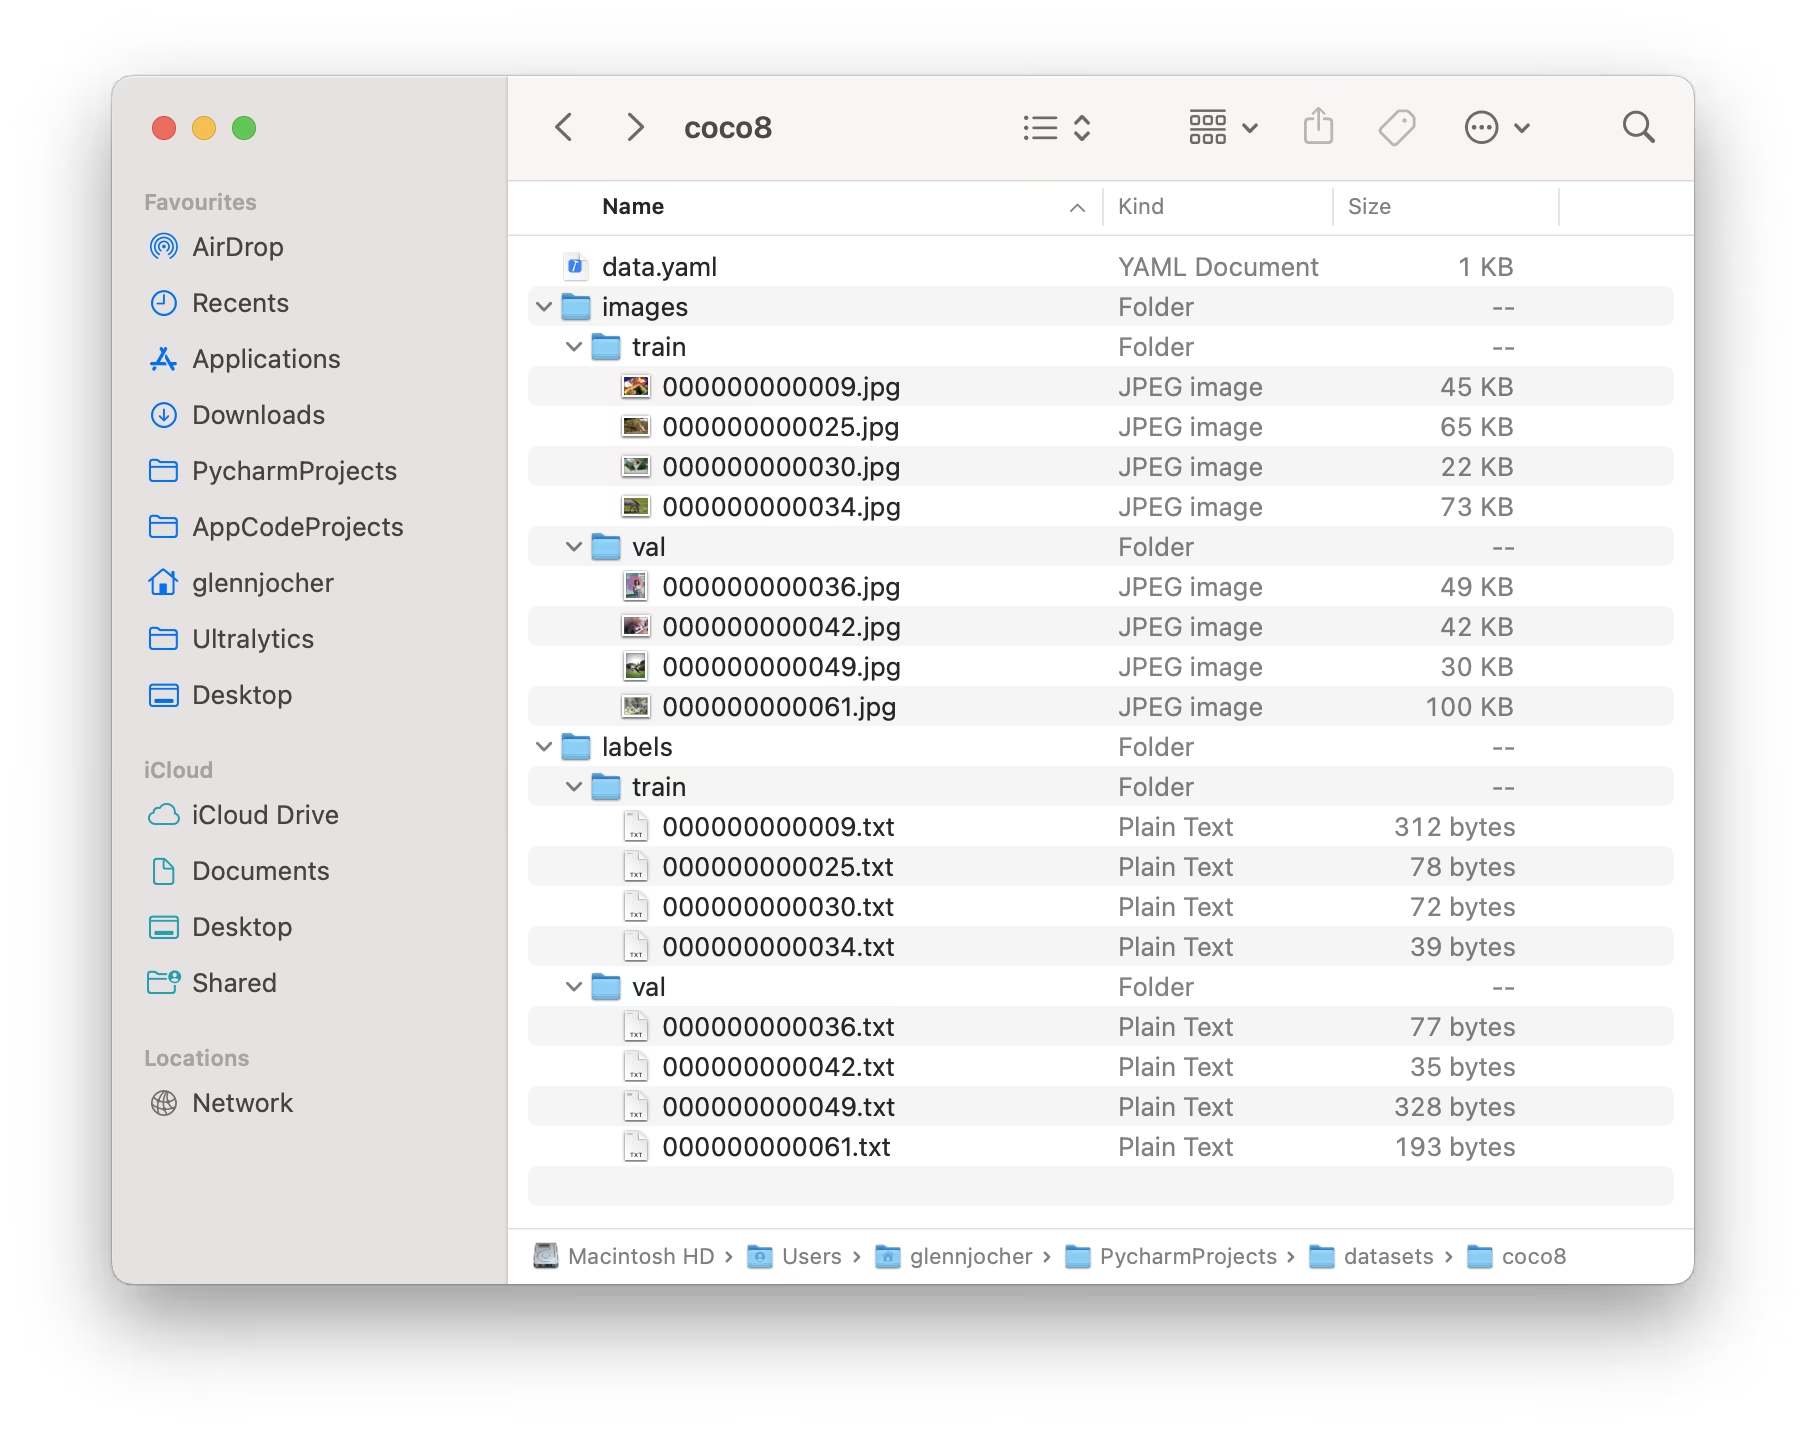
При использовании формата Ultralytics YOLO организуй изображения и разметку для обучения и валидации, как показано ниже на примере датасета COCO8.
Пример использования#
Вот как использовать датасеты в формате YOLO для обучения модели:
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
Формат Ultralytics NDJSON#
Формат NDJSON (JSON с разделителями в виде символов новой строки) — это альтернативный способ описания датасетов для моделей Ultralytics YOLO. В этом формате метаданные датасета и разметка хранятся в одном файле, где каждая строка содержит отдельный объект JSON.
Файл датасета NDJSON содержит:
- Запись датасета (первая строка): Метаданные датасета, включая тип задачи, имена классов и общую информацию
- Записи изображений (следующие строки): Данные отдельных изображений, в том числе размеры, разметка и пути к файлам
{
    "type": "dataset",
    "task": "detect",
    "name": "Example",
    "description": "COCO NDJSON example dataset",
    "url": "https://platform.ultralytics.com/user/datasets/example",
    "class_names": { "0": "person", "1": "bicycle", "2": "car" },
    "bytes": 426342,
    "version": 0,
    "created_at": "2024-01-01T00:00:00Z",
    "updated_at": "2025-01-01T00:00:00Z"
}
Пользовательские метаданные изображения#
В каждой записи изображения может содержаться JSON-объект metadata с контекстной информацией для конкретного приложения, например об условиях съемки, идентификаторах оборудования или статусе проверки. Поддерживаются вложенные значения. При импорте в Ultralytics Platform метаданные сохраняются вместе с изображением; их можно просматривать и редактировать на полноэкранной панели информации.
{
    "type": "image",
    "file": "airbus-wing.jpg",
    "url": "https://example.com/airbus-wing.jpg",
    "split": "train",
    "metadata": {
        "aircraft": { "family": "A350", "section": "wing" },
        "inspectionStatus": "reviewed"
    }
}
Платформа ограничивает длину ключей метаданных верхнего уровня 128 символами, длину сериализованного объекта метаданных каждого изображения — 500 000 символами, а общий объем эффективных метаданных в одном импорте NDJSON — 500 000 символами.
Пример использования#
Чтобы использовать датасет NDJSON с YOLO26, укажи путь к файлу .ndjson:
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")

# Обучение на датасете NDJSON
results = model.train(data="path/to/dataset.ndjson", epochs=100, imgsz=640)
Преимущества формата NDJSON#
- Один файл: Вся информация о датасете хранится в одном файле
- Потоковая обработка: Большие датасеты можно обрабатывать построчно, не загружая их целиком в память
- Интеграция с облаком: Поддерживаются удаленные URL изображений для обучения в облаке
- Расширяемость: Пользовательские поля метаданных легко добавлять
- Контроль версий: Формат с одним файлом хорошо сочетается с git и системами контроля версий
Поддерживаемые датасеты#
Ниже приведен список поддерживаемых датасетов с кратким описанием каждого. Большинство из них также размещено на Ultralytics Platform, где можно просматривать изображения и разметку, изучать статистику датасетов и клонировать датасеты для обучения в облаке.
- African-wildlife: набор данных с изображениями африканских диких животных, включая буйволов, слонов, носорогов и зебр.
- Argoverse: Датасет Argoverse-HD для 2D-обнаружения объектов: 54 446 городских изображений для автономного вождения с 8 классами дорожных объектов.
- Опухоль мозга: набор данных для обнаружения опухолей на МРТ-снимках головного мозга с разметкой ограничивающими рамками опухолей одного класса.
- COCO: COCO (Common Objects in Context) — крупномасштабный набор данных для обнаружения и сегментации объектов, а также создания подписей к изображениям; содержит 80 категорий объектов.
- COCO8: небольшой набор из первых 8 изображений COCO train2017: 4 для обучения и 4 для валидации; подходит для быстрых проверок.
- COCO8-Grayscale: версия COCO8 в градациях серого, созданная путем преобразования RGB-изображений; подходит для оценки моделей с одним каналом.
- COCO8-Multispectral: 10-канальная мультиспектральная версия COCO8, созданная интерполяцией длин волн RGB; подходит для оценки моделей, учитывающих спектральные характеристики.
- COCO12-Formats: Тестовый датасет из 12 изображений в 12 поддерживаемых форматах (AVIF, BMP, DNG, HEIC, JP2, JPEG, JPG, MPO, PNG, TIF, TIFF, WebP) для проверки конвейеров загрузки изображений.
- COCO16: Подмножество из первых 16 изображений COCO train2017 (8 для обучения и 8 для валидации), подходящее для быстрых тестов.
- COCO32: Подмножество из первых 32 изображений COCO train2017 (16 для обучения и 16 для валидации), подходящее для быстрых тестов.
- COCO64: Подмножество из первых 64 изображений COCO train2017 (32 для обучения и 32 для валидации), подходящее для быстрых тестов.
- COCO128: небольшой набор из первых 128 изображений COCO train2017, подходящий для тестирования.
- Construction-PPE: Датасет с изображениями работников на строительных площадках и разметкой средств индивидуальной защиты: касок, жилетов, перчаток, ботинок и очков. Также отмечено отсутствие средств защиты, например no_helmet и no_goggle, для контроля соблюдения требований в реальных условиях.
- Global Wheat 2020: набор изображений колосьев пшеницы для конкурса Global Wheat Challenge 2020.
- HomeObjects-3K: Датасет с изображениями предметов домашнего обихода, в том числе кроватей, стульев и телевизоров. Подходит для автоматизации умного дома, робототехники, дополненной реальности и анализа планировки помещений.
- KITTI: Датасет с реальными дорожными сценами и данными стереокамер, LiDAR и GPS/IMU. Здесь он используется для задач 2D-обнаружения объектов, например автомобилей, пешеходов и велосипедистов в городской, сельской местности и на шоссе.
- LVIS: крупномасштабный набор данных для обнаружения объектов и сегментации экземпляров, включающий 1 203 категории объектов.
- Medical-pills: набор данных с изображениями медицинских таблеток, размеченными для таких задач, как контроль качества фармацевтической продукции, сортировка таблеток и соблюдение нормативных требований.
- Objects365: Качественный крупномасштабный датасет для обнаружения объектов с 365 категориями и более чем 1,7 млн изображений для обучения.
- OpenImagesV7: обширный набор данных Google с 1,7 млн изображений для обучения и 42 тыс. изображений для валидации.
- Roboflow 100: разнообразный бенчмарк для обнаружения объектов, включающий 100 наборов данных из семи областей изображения для комплексной оценки моделей.
- Signature: набор изображений различных документов с разметкой подписей для исследований в области проверки документов и обнаружения мошенничества.
- SKU-110K: набор для обнаружения большого количества объектов в розничной торговле; содержит более 11 тыс. изображений и 1,7 млн ограничивающих рамок.
- TT100K: набор данных дорожных знаков Tsinghua-Tencent 100K (TT100K), включающий 16 817 изображений улиц из режима обзора на уровне дороги и 221 категорию знаков для обнаружения и классификации.
- Бенчмарк Ultralytics: собственный набор тестов на 37 тщательно отобранных наборах данных для детекции из медицинской, аэрокосмической, промышленной, розничной и других областей. Для оценки способности моделей к обобщению в реальных условиях используется единый протокол.
- VisDrone: набор данных для обнаружения и отслеживания нескольких объектов на изображениях и видеозаписях с дронов; содержит более 10 тыс. изображений и видеопоследовательностей.
- VOC: набор данных Pascal Visual Object Classes (VOC) для обнаружения и сегментации объектов, включающий 20 классов объектов и более 11 тыс. изображений.
- xView: набор для обнаружения объектов на аэрофотоснимках; содержит 60 категорий и более 1 млн размеченных объектов.
Добавление собственного набора данных#
Если у тебя есть собственный набор данных и ты хочешь использовать его для обучения моделей обнаружения в формате Ultralytics YOLO, убедись, что он соответствует формату, описанному выше в разделе «Формат Ultralytics YOLO». Преобразуй аннотации в требуемый формат и укажи пути, количество классов и названия классов в файле конфигурации YAML.
Перенос или преобразование форматов разметки#
Преобразование формата набора данных COCO в формат YOLO#
Ты можешь преобразовать метки из популярного формата набора данных COCO в формат YOLO с помощью следующего фрагмента кода:
from ultralytics.data.converter import convert_coco

convert_coco(labels_dir="path/to/coco/annotations/")
Этот инструмент преобразования можно использовать для преобразования набора данных COCO или любого набора данных в формате COCO в формат Ultralytics YOLO. В процессе аннотации COCO в формате JSON преобразуются в более простой текстовый формат YOLO, совместимый с моделями Ultralytics YOLO. Полное описание рабочего процесса — включая сопоставление идентификаторов классов, структуру каталогов и аннотации сегментации или позы — см. в разделе «Преобразование аннотаций COCO в формат YOLO».
Не забудь еще раз проверить, совместим ли нужный тебе набор данных с моделью и соответствует ли он необходимым соглашениям о формате. Правильное форматирование наборов данных крайне важно для успешного обучения моделей обнаружения объектов.
Что дальше#
После форматирования набора данных приступай к обучению модели. Не знаешь, с какой предварительно обученной модели начать? Сравни варианты в семействе моделей YOLO26.
Часто задаваемые вопросы#
Формат Ultralytics YOLO — это структурированная конфигурация для определения наборов данных в проектах обучения. В ней задаются пути к изображениям для обучения, валидации и тестирования, а также к соответствующим меткам. Например:
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8 dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8
# Example usage: yolo train data=coco8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8.zip
Метки сохраняются в файлах
*.txt, по одному файлу на изображение. Формат данных —class x_center y_center width heightс нормализованными координатами. Подробное руководство см. в примере набора данных COCO8.Ты можешь преобразовать набор данных COCO в формат YOLO с помощью инструментов преобразования Ultralytics. Вот быстрый способ:
from ultralytics.data.converter import convert_coco

convert_coco(labels_dir="path/to/coco/annotations/")
Этот код преобразует аннотации COCO в формат YOLO, чтобы ты мог обучать на них модели Ultralytics YOLO.
Ultralytics YOLO поддерживает широкий спектр наборов данных, в том числе:
На странице каждого набора данных приведена подробная информация о его структуре и использовании для эффективного обучения YOLO26. Полный список см. в разделе «Поддерживаемые наборы данных».
Чтобы начать обучение модели YOLO26, убедись, что набор данных правильно отформатирован, а пути указаны в файле YAML. Используй следующий скрипт, чтобы начать обучение:
Примерfrom ultralytics import YOLO model = YOLO("yolo26n.pt") # Загрузи предварительно обученную модель results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=640)Ultralytics предлагает множество примеров и практических руководств по использованию YOLO в разных областях. Посети блог Ultralytics, чтобы ознакомиться с кейсами, подробными руководствами и историями сообщества об обнаружении объектов, сегментации и других задачах. Примеры для конкретных задач см. на странице режима Predict в документации.


Комментарии54
Задай вопрос, поделись результатами или помоги кому-нибудь.
zcoolster11
Python Head Bop
 Paula DerrengerUltralytics
@zcoolster11, could you clarify what you mean by “Python Head Bop” and what you’d like to do with Ultralytics YOLO? Feel free to drop your dataset or Python questions here in the discussion so the Ultralytics team can help.
 Murat Raimbekov
hey @orz-serein, short answer: no, you don't need empty label files for background images - just leave the
.txtout.i verified this empirically on the current main branch. setup: 5 images, 2 with real labels, 1 with an empty
.txtfile, 2 without any.txtfile at all. building aYOLODatasetover them gives:Scanning /tmp/bgtest_full/labels... 3 images, 3 backgrounds, 0 corrupt: 100% 5/5all 5 images are kept. the 3 without labels (the empty-
.txtone and the two with no.txtat all) all end up with the same(0, 5)labels array - they are treated identically as background images.so both options work:
- no
.txtfile: counted as "missing" (nm=1), no labels -> background - empty
.txtfile: counted as "empty" (ne=1), no labels -> background
both end up in the same
backgrounds = nm + nebucket inultralytics/data/dataset.py.this is also stated in the detection dataset docs:
If there are no objects in an image, no
*.txtfile is required.how many background images: the yolov5 training tips recommend 0-10% of the dataset as background images to reduce false positives (coco has about 1% background).
hope this helps!
- no
 serein
Hello, I would like to ask a question. During the stage of preparing the training dataset, if some images do not have the target to be detected, do I need to add corresponding empty label files in the label folder?
Fatima-khanjar
Hello, I hope this message finds you well.
I have a question regarding fine-tuning a pre-trained YOLO model (e.g., trained on the COCO dataset) on my custom dataset. My dataset includes both new classes (not present in COCO) and the same existing classes (e.g., toothbrush, car), but with different layouts. Specifically, I would like to add my new classes starting from index 80, while still leveraging the pre-trained weights for the common classes, which are the same but with different layouts.
Is it possible to use the pre-trained weights for the common classes and only train the model on the new classes, while ensuring that the pre-trained knowledge for the common classes is preserved? If so, could you please guide me on how to proceed?
Thank you for your time and assistance. best regards,
bimal-gajera
Hello, I'm working on multiple dataset formats for object detection. For the YOLO dataset format, is there any way I can rename the labels directory and put it in yaml file? Something like this:
path: path_to_root_directory
train: train\images
val: val\images
test: test\images

labels_dir: yolo

nc: 1
names: ['object']
yolo directory has yolo annotations (*.txt files), and it's inside respective train, val and test directory.
 Glenn JocherUltralytics(изменено)
@bimal-gajera currently, the
labels_dirkey is not supported in the YAML file. Ultralytics finds label files by replacing the last/images/directory in each image path with/labels/, so each split needs siblingimages/andlabels/directories (for exampletrain/imagesandtrain/labels). For more details, refer to the Object Detection Datasets Overview.1
nitya-pandey-astro
Hello Team, I am using YOLO for detecting trails of slow-moving astronomical objects in my images. While the model detects the trails, the bounding boxes predicted around the objects are not tight enough. The boxes tend to be too loose or not well-shaped to fit the elongated, irregular trails, resulting in inaccurate object localization. I suspect, YOLO's standard rectangular bounding box not being well-suited for the elongated, curving shapes of the trails. Could you provide guidance on how to improve bounding box accuracy for this specific use case?
- Glenn JocherUltralytics(изменено)
@astronitya thank you for your question! For detecting elongated or irregular trails, consider using Oriented Bounding Boxes (OBB), which may better fit your objects' shapes compared to standard rectangular boxes. You can format your dataset in the YOLO OBB format and train a YOLO26 OBB model. Please refer to the Oriented Bounding Box (OBB) Datasets Overview for details on dataset formatting and training. Let me know if you need further clarification!
@glenn-jocher Thankyou very much for the prompt response. I am going to work on your suggestions.
Yuxuan1998
Hi team, I am a little bit confused with the dataset folder structure. For most dataset I used, it strunctured in the way that each of
train/andval/folders containsimages/andlabels/folders. However, the COCO8 dataset example shows the opposite way, each ofimages/andlabels/folder containstest/andval/folders. Does the folder structure matter here? Thanks in advance- Glenn JocherUltralytics(изменено)
@Yuxuan1998 both layouts work, as long as each image has a sibling
labelsdirectory: Ultralytics finds the label for an image by replacing the last/images/in its path with/labels/(sotrain/images/img.jpgusestrain/labels/img.txt, andimages/train/img.jpguseslabels/train/img.txt). Set the paths in your dataset's YAML file to the image directories. For details, refer to the Object Detection Datasets Overview. Let us know if you need further clarification!1
milanaveed
Hello, can you please fix the broken images on this page? Can't see the label file example.
wgdcxy
Hello, my label and image files are stored according to the requirements, but they are still not recognized, and the following is an error message Thank you in advance
WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1138.41it/s] train: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. train: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1617.94it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train3\labels.jpg...
- Glenn JocherUltralytics
It seems like your dataset labels are not being recognized. Please ensure your label files are in the correct YOLO format and that the directory is writable. For detailed guidance, visit the dataset formatting section at https://docs.ultralytics.com/datasets/detect/.
Hi, but my file path is very accurate, and I checked it N times, so is there any otherreason? Thank you
- Glenn JocherUltralytics
@wgdcxy please ensure your label files are in the correct YOLO format, with one
.txtfile per image containing normalized coordinates. Also, verify that the directory permissions allow writing. For more details, refer to the dataset formatting guide linked earlier. Hello, I'm a student whose English is not particularly good, so some places may not be clear, and secondly, this is not an error but a warning.I don't know why it's the background that reads, not the images. The warnings are as follows: val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%| 30/30 [00:00<00:00, 495.76it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train4\labels.jpg...
Then this warning tells me that the cache file is missing, and I don't know why I can't generate a cache file for the file I created, so I'm here to ask you guys. Below is my own yaml file: # Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..] path: ../cs # dataset root dir train: images/ttb # train images (relative to 'path') 128 images val: images/ttj # val images (relative to 'path') 128 images test: # test images (optional) # Classes names : 0 : wf
Below is my label file: 0 0.6799428104575164 0.5005859375 0.6844771241830065 0.500537109375 0.6845996732026144 0.497265625 0.6802696078431373 0.497119140625 0 0.6803104575163399 0.4935546875 0.6848039215686275 0.493505859375 0.6847630718954248 0.497119140625 0.6802696078431373 0.49697265625 0 0.6802696078431373 0.49013671875 0.6849673202614379 0.490185546875 0.6849264705882353 0.49345703125 0.6803513071895425 0.493359375 0 0.6805555555555556 0.48662109375 0.6850898692810458 0.486767578125 0.6850490196078431 0.490234375 0.6803513071895425 0.490234375 0 0.6808415032679739 0.483447265625 0.6852941176470588 0.48349609375 0.6852124183006536 0.486767578125 0.6806781045751634 0.486669921875 0 0.6806372549019607 0.47998046875 0.6854166666666666 0.47998046875 0.6853349673202613 0.48349609375 0.6808415032679738 0.48359375
Finally, this yolo can be run, but I don't know why the result is 0. Here's how it works: Transferred 381/417 items from pretrained weights 195/200 8.73G 0 0 nan 0 0 2464: 100%|██████████| 8/8 [01:37<00:00, 12.13s/it] Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95): 100%|[00:31<00:00, 7.91s/it] all 30 0 0 0 0 0 0 0 0 0 Finally, thank you for explaining it to me
By the way, the size of my picture is 2448x2048, so the imgsz entered is 2448, and your code changed the size of my picture to 2464, is it related to this. imgsz=[2448] must be multiple of max stride 32, updating to [2464]
I apologize, I found a small mistake of mine. I wrote the file name as "labels" instead of "lables" which I intended to write.Please forgive my carelessness.After all, who doesn't make mistakes. I'll come back to you next time I have a problem. Thank you for your help.
Transferred 417/417 items from pretrained weights Freezing layer 'model.22.dfl.conv.weight' AMP: running Automatic Mixed Precision (AMP) checks with YOLOv8n... AMP: checks passed ✅ WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache... 30 images, 0 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<?, ?it/s] Hello, here I am again, with a new problem, how to solve this problem about image size?Ask for answers, thank you
- Glenn JocherUltralytics
@wgdcxy to address the image size issue, ensure your
imgszis a multiple of 32, as required by the model's architecture. This adjustment helps maintain compatibility with the model's stride. If you have further questions, feel free to ask! WARNING ⚠️ NMS time limit 0.900s exceeded. Hello, my teacher who has never met, what should I do with this warning?
- Glenn JocherUltralytics(изменено)
@wgdcxy the "NMS time limit exceeded" warning is not controlled by an
nmsargument. It appears when too many candidate boxes need to be processed within the time limit, which is common early in training when validation uses a low confidence threshold. It usually stops as the model trains, and you can reduce it by raisingconfor loweringmax_detduring validation. If you have further questions, feel free to ask! Hello, I'm here again. The issue this time is still the same warning. I adjusted the max_time_img to 0.1 in ops. py, but I don't feel it's right. So I came to ask for your help because it still shows this warning. I hope you can tell me where to make the adjustment. Thank you again. WARNING ⚠️ NMS time limit 0.900s exceeded
How can these values be improved? We can only continue training or increase the training dataset. Epoch GPU_mem box_loss seg_loss cls_loss dfl_loss Instances Size 11/500 11G nan 6.21 nan nan 132 2464: 100%|██████████| 8/8 [01:56<00:00, 14.59s/it] Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95): 100%|██████████| 4/4 [00:54<00:00, 13.56s/it] all 30 664 0 0 0 0 0 0 0 0
- Glenn JocherUltralytics
To improve your model's performance, consider increasing the dataset size, enhancing data quality, or adjusting hyperparameters. If issues persist, reviewing the dataset for label accuracy and distribution might help.
WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1138.41it/s] train: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. train: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1617.94it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train3\labels.jpg...
这个问题该如何解决?
- Glenn JocherUltralytics
It looks like your dataset labels are missing or not formatted correctly. Please ensure your labels are in the YOLO format and check the directory permissions. For detailed guidance, visit the dataset formatting section at https://docs.ultralytics.com/datasets/detect/.