Датасет опухолей головного мозга
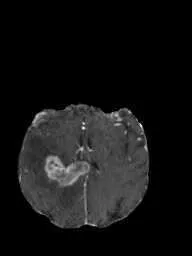
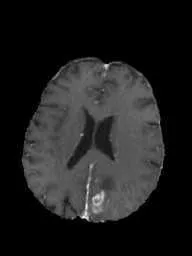
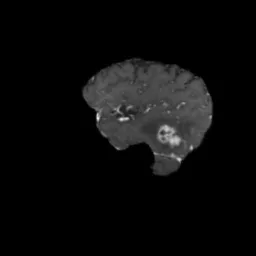
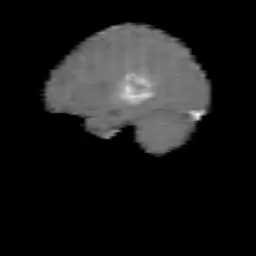

Набор данных Ultralytics Brain Tumor — это набор данных для обнаружения объектов, включающий 1 115 МРТ-снимков головного мозга (994 для обучения и 121 для валидации) и 1 180 ограничивающих рамок одного класса tumor. На каждом изображении от 1 до 3 рамок опухолей. В выборку валидации входят изображения 25 пациентов, которых удалось идентифицировать; ни один идентифицированный пациент не встречается в обеих выборках. Размер набора — 4,06 МБ. Это компактный набор данных для обучения и создания прототипов моделей компьютерного зрения для медицины, но он не является клинически подтверждённым диагностическим ресурсом.
Смотри: Обнаружение опухоли мозга с помощью платформы Ultralytics и Ultralytics YOLO26 | Обнаружение объектов 🚀
Структура набора данных#
Набор данных Ultralytics Brain Tumor содержит 1 115 МРТ-снимков головного мозга и 1 180 ограничивающих рамок в двух выборках, определённых конфигурацией brain-tumor.yaml:
| Подвыборка | Изображения | Ограничивающие рамки | Пациенты |
|---|---|---|---|
| Обучение | 994 | 1,057 | 95 пациентов с ID, а также 541 изображение без ID пациента |
| Валидация | 121 | 123 | 25 |
| Всего | 1,115 | 1,180 |
На каждом изображении от 1 до 3 ограничивающих рамок единственного класса tumor, а размер изображений варьируется от 192x256 до 512x512 пикселей. В конфигурации нет отдельной тестовой выборки.
Выборка валидации сформирована по пациентам. Имена некоторых файлов начинаются с пятизначного ID пациента: например, 00097_77.jpg относится к пациенту 00097. Изображения с ID 25 таких пациентов составляют выборку валидации, а изображения остальных 95 идентифицированных пациентов входят в обучающую выборку, поэтому ни один идентифицированный пациент не встречается в обеих выборках. Оставшиеся 541 изображение не содержат ID пациента в имени файла и целиком входят в обучающую выборку.
При первом запуске обучения набор данных автоматически загружается из ресурсов Ultralytics на GitHub (4,06 МБ), поэтому скачивать и подготавливать его вручную не нужно.
В ноябре 2026 года набор данных обновили: теперь в нём один класс tumor. Если в локальной папке brain-tumor/images/train находится 893 изображения вместо 994, удали папку brain-tumor из каталога с наборами данных (см. datasets_dir в yolo settings) и обнови пакет командой pip install -U ultralytics. При следующем запуске обучения автоматически загрузится текущая версия.
Открой датасет Brain Tumor на Ultralytics Platform, чтобы просмотреть изображения с наложенной разметкой, изучить распределение классов и тепловые карты ограничивающих рамок на вкладке Charts, а также создать его копию для обучения собственной модели в облаке.
Применение#
Модели обнаружения опухолей мозга находят опухоли на МРТ-снимках головного мозга. Набор данных Ultralytics Brain Tumor включает 1 115 изображений и занимает 4,06 МБ. Он подойдёт для:
- Изучения рабочего процесса: выполнения полного цикла обучения, валидации и предсказания на медицинских изображениях с небольшим набором данных.
- Создания прототипов: разработки и тестирования конвейера локализации опухолей перед переходом к более крупному клиническому набору данных.
- Оценки на идентифицированных пациентах: измерения качества обнаружения на данных 25 пациентов из валидационной выборки. Поскольку у 541 обучающего изображения нет ID пациентов, исключить их совпадение с этими пациентами нельзя.
- Исследований и обучения: сравнения моделей обнаружения и изучения анализа медицинских изображений и ИИ в радиологии.
Модели, обученные на этом наборе данных, предназначены для исследований и обучения и не подтверждены для клинической диагностики.
Файл YAML набора данных#
Конфигурация brain-tumor.yaml задаёт путь к набору данных, папки с изображениями для обучения и валидации, единственный класс tumor и URL для загрузки. Для разметки используется формат Ultralytics YOLO.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Brain-tumor dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor
# Example usage: yolo train data=brain-tumor.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── brain-tumor ← downloads here (4.06 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: brain-tumor # dataset root dir
train: images/train # train images (relative to 'path') 994 images
val: images/val # val images (relative to 'path') 121 images

# Classes
names:
  0: tumor

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipИспользование#
Чтобы обучить модель YOLO26n на датасете опухолей головного мозга в течение 100 эпох с размером изображения 640, используй приведённые ниже фрагменты кода.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Загрузить модель
model = YOLO("path/to/best.pt") # загрузить дообученную модель на brain-tumor
# Инференс с использованием модели
results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Примеры изображений и аннотаций#
Ниже показаны примеры изображений из набора данных Ultralytics Brain Tumor с их аннотациями:
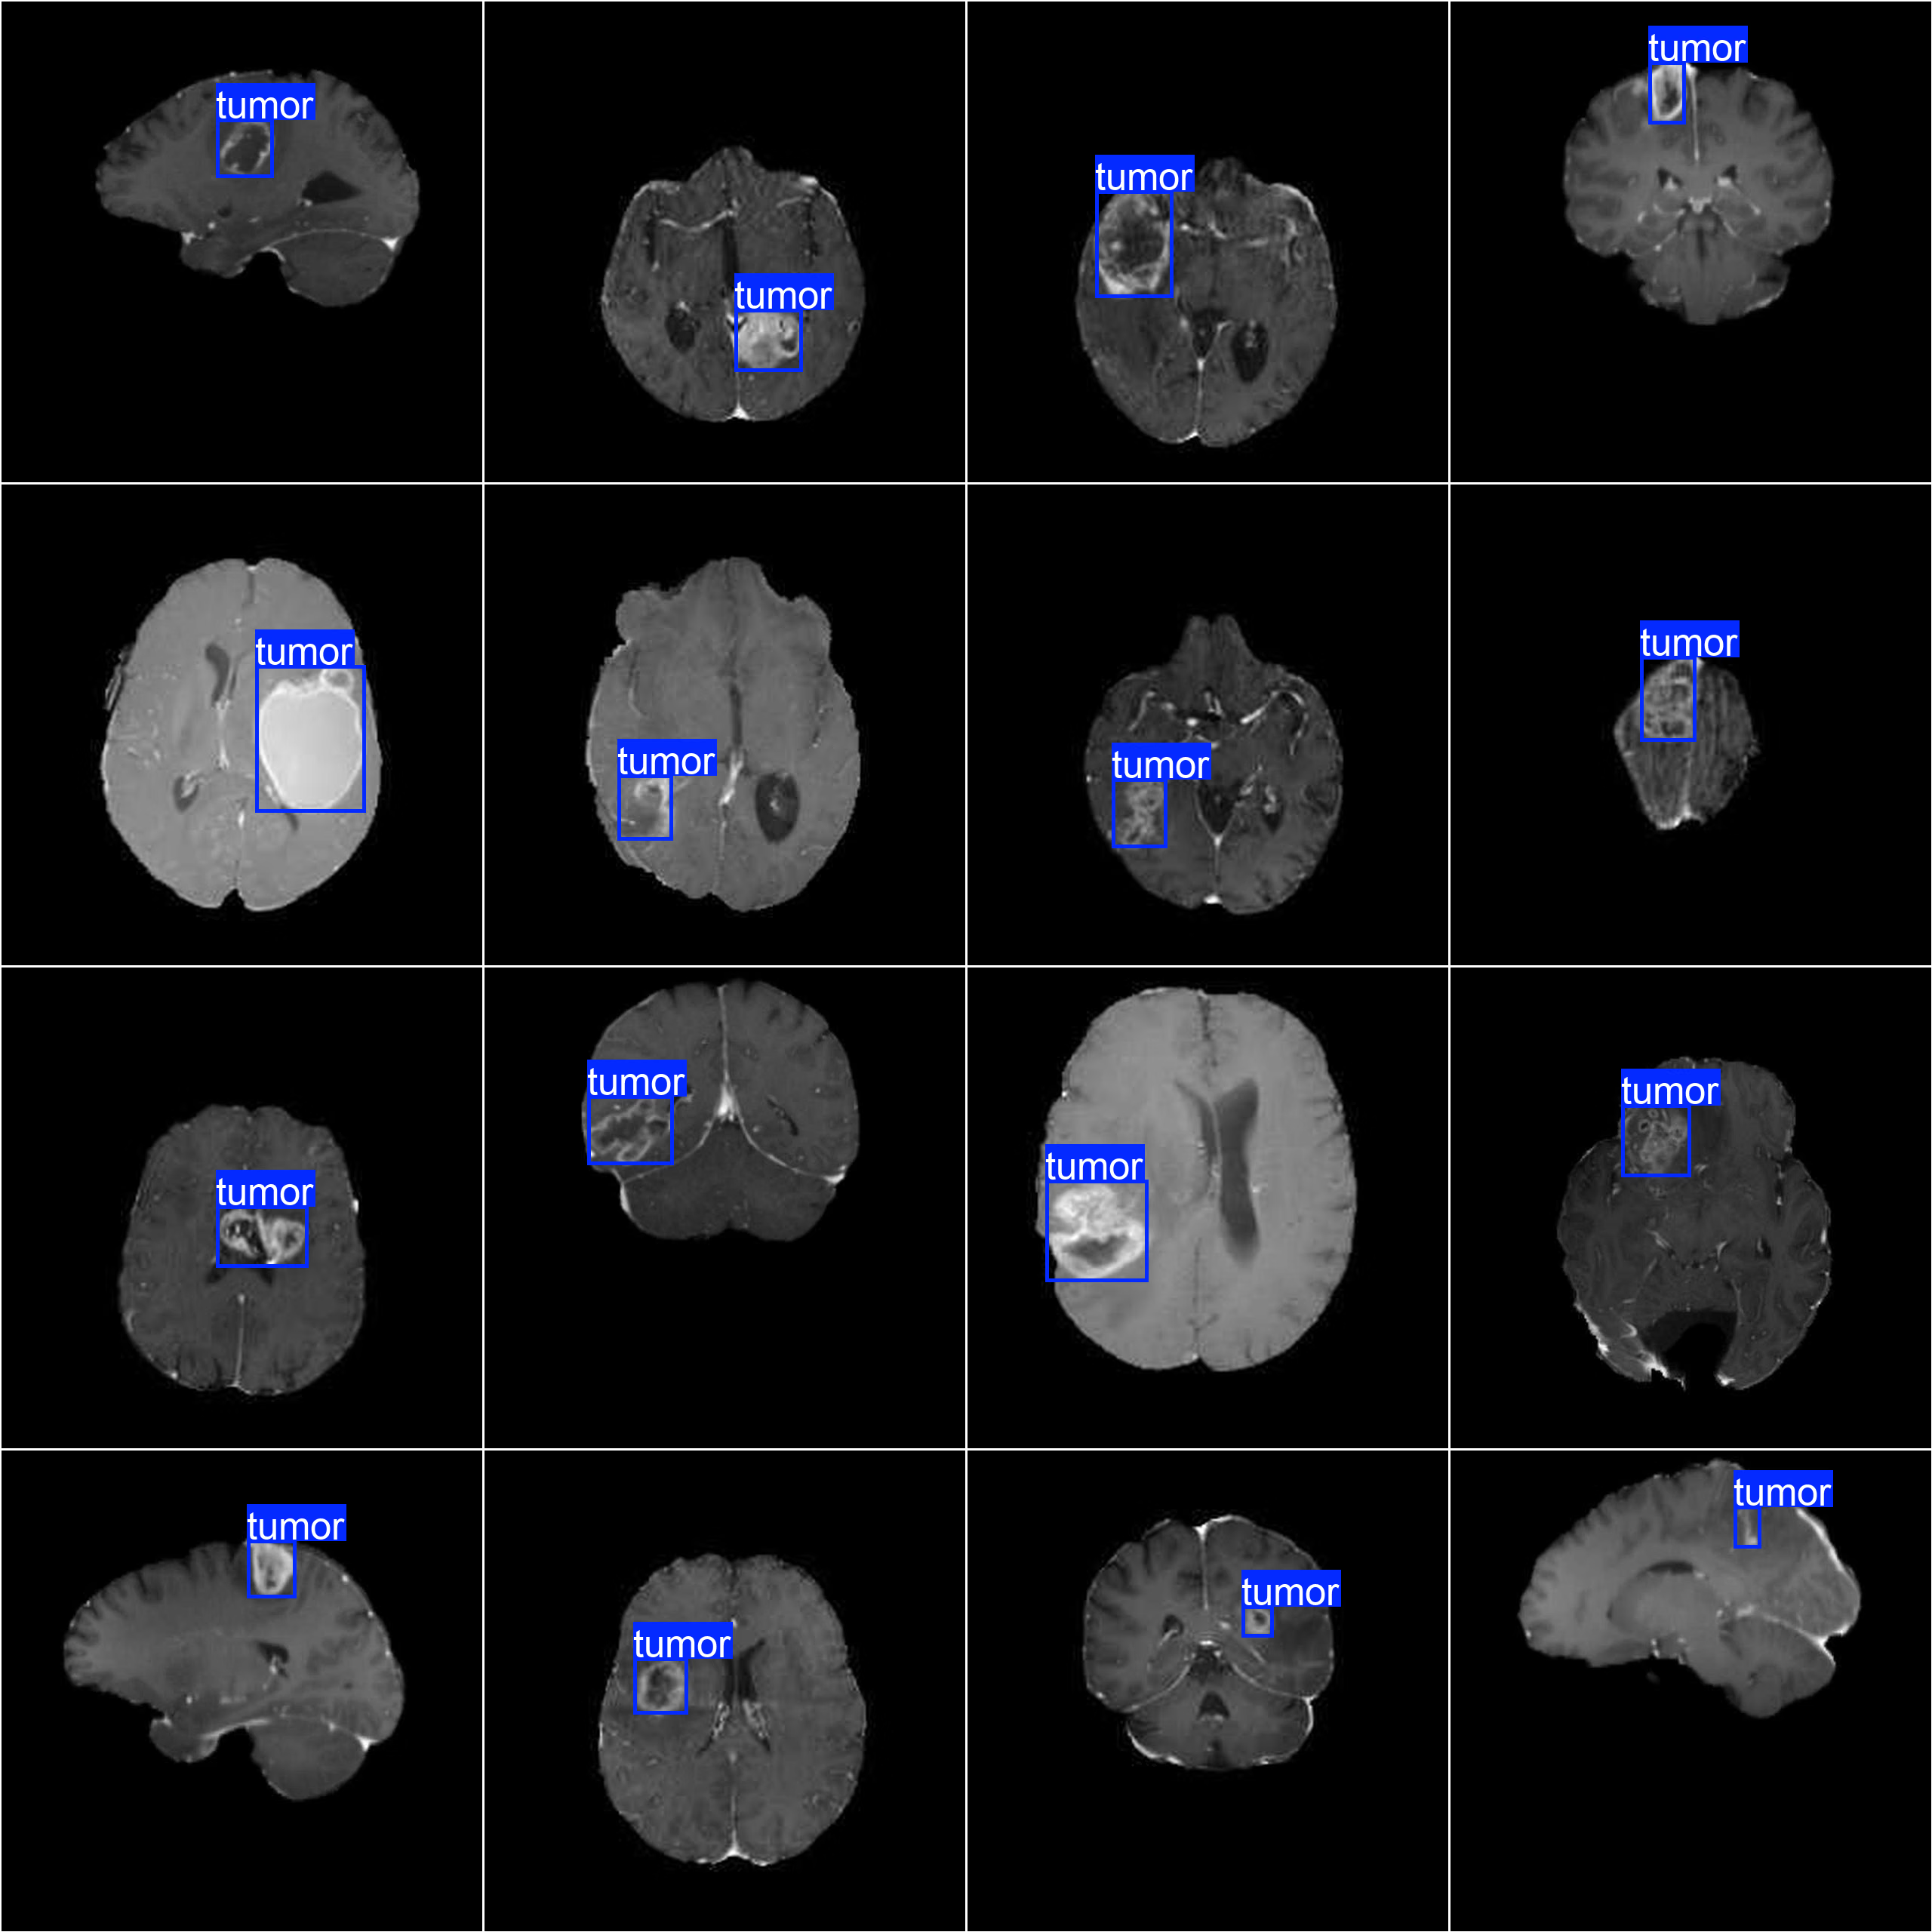
- Изображения с аннотациями: на сетке показано 16 обучающих изображений, на каждом из которых поражённая область обведена ограничивающей рамкой
tumor. Размеры, формы и расположение опухолей в наборе данных различаются, что помогает модели обнаружения лучше обобщать.
Цитирование и благодарности#
Датасет доступен по лицензии AGPL-3.0.
Если ты используешь набор данных об опухолях мозга в исследованиях или разработке, укажи его в списке источников:
@dataset{Ultralytics_Brain_Tumor_Dataset_2023,
    author = {Ultralytics},
    title = {Brain Tumor Detection Dataset},
    year = {2023},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/brain-tumor}
}
Часто задаваемые вопросы#
Набор данных Ultralytics Brain Tumor содержит 1 115 МРТ-снимков головного мозга и 1 класс
tumor: 994 обучающих изображения с 1 057 ограничивающими рамками и 121 валидационное изображение со 123 рамками. На каждом изображении от 1 до 3 рамок, отдельной тестовой выборки нет. Подробнее о разделении данных см. в разделе Структура набора данных.Набор данных Ultralytics Brain Tumor содержит МРТ-снимки головного мозга, но не КТ-снимки. Размер изображений варьируется от 192x256 до 512x512 пикселей; на каждом изображении размечено от 1 до 3 ограничивающих рамок класса
tumorв формате Ultralytics YOLO.Нет, в наборе данных Ultralytics Brain Tumor нет изображений без опухолей и отрицательного класса. На всех 1 115 изображениях есть от 1 до 3 ограничивающих рамок класса
tumor, поэтому обученная на них модель учится находить опухоль, а не определять, здоров ли пациент. Модели, обученные на этом наборе данных, предназначены для исследований и обучения, а не для клинической диагностики.Набор данных Ultralytics Brain Tumor разделён по пациентам: ID 25 пациентов указаны на 121 валидационном изображении, и ни один идентифицированный пациент не встречается в обеих выборках. Пациенты определяются по пятизначному префиксу имени файла, например
00097_77.jpg. Обучающая выборка включает остальных 95 идентифицированных пациентов и 541 изображение, в именах файлов которых нет ID пациента.Набор данных Ultralytics Brain Tumor (4,06 МБ) автоматически загружается из ресурсов Ultralytics на GitHub при первом запуске обучения с
data="brain-tumor.yaml", поэтому скачивать его вручную не нужно. Если на диске уже есть старая копия с 893 обучающими изображениями, удали папкуbrain-tumorи сначала обнови пакетultralytics, чтобы загрузить текущую версию с одним классом. Другой небольшой набор данных для медицинской визуализации — набор данных для обнаружения медицинских таблеток.Чтобы обучить YOLO26 на наборе данных Ultralytics Brain Tumor, передай
data="brain-tumor.yaml"команде обучения — набор данных загрузится автоматически. В примерах ниже YOLO26n обучается 100 эпох с размером изображения 640:Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)Полный список доступных аргументов смотри на странице обучения.
Чтобы запустить инференс с моделью YOLO26, дообученной на наборе данных Ultralytics Brain Tumor, загрузи веса
best.ptи вызови predict для МРТ-снимка головного мозга. Каждый результат содержит ограничивающие рамкиtumorс оценками уверенности:Пример инференсаfrom ultralytics import YOLO # Загрузить модель model = YOLO("path/to/best.pt") # загрузить дообученную модель на brain-tumor # Инференс с использованием модели results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Набор данных Ultralytics Brain Tumor создан компанией Ultralytics и распространяется по лицензии AGPL-3.0.


Комментарии11
Задай вопрос, поделись результатами или помоги кому-нибудь.
ZoltinZyc
how can i download this datasett??
1 Paula DerrengerUltralytics(изменено)
Hey there! 😊 The easiest way is to train with
data=brain-tumor.yaml, which downloads the dataset automatically the first time. To download it manually, use:wget https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zip unzip brain-tumor.zip -d path/to/destinationReplace
path/to/destinationwith the directory where you'd like the dataset stored. Once you have the dataset, you're all set to start training or inferencing with YOLO models on brain tumor images!Should you need further guidance, feel free to ask. Happy coding! 🚀
G-qingqian
Thank you for your reply. I noticed that in the original dataset, the images in the train folder do have ID prefixes, but the images in the val folder are all prefixed with val1_, making it impossible to distinguish which patient the data belongs to. Therefore, I cannot redivide the dataset. Could you please provide data with complete identifiers? ---- Replied Message ---- FromGlenn @.>Date1/18/2026 @.>@.>, @.>SubjectRe: [ultralytics/ultralytics] zh/datasets/detect/brain-tumor/ (Discussion #9988) The packaged brain-tumor dataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to *.txt image lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.
my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
— Reply to this email directly, view it on GitHub, or unsubscribe. You are receiving this because you commented.Message ID: @.***>
 Glenn JocherUltralytics
The packaged
brain-tumorzip only includes image-level labels with anonymized filenames (no patient IDs/metadata), so we can’t provide “complete identifiers” or guarantee a patient-disjoint re-split; for patient-wise splitting you’ll need to rebuild from a source that includes patient IDs (e.g., your DICOM/NIfTI originals) and then generatetrain.txt/val.txt, and if you just need stronger evaluation without IDs you can use our K-Fold Cross Validation guide—please keep follow-ups here in the GitHub discussion (we can’t provide support over email/DM).
Can your dataset ensure that the data are independently and identically distributed by patient? That is, there will be no data from the same patient in both the training set and the validation set.
- Glenn JocherUltralytics
The packaged
brain-tumordataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to*.txtimage lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.# my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
pizzas17
How could I download this dataset on COCO format or how could I convert it? (Since I wish to have an EDA on it
xySun17
How can i train the yoloV8 using this dataset without loading the pre-trained weights?
- Paula DerrengerUltralytics(изменено)
@xySun17 hello!
To train YOLO26 without loading the pre-trained weights, you can initialize the model from scratch by specifying the model architecture file (e.g.,
yolo26n.yaml) instead of the pre-trained weights file. Here’s how you can do it:Python
from ultralytics import YOLO

# Load a model architecture without pre-trained weights
model = YOLO("yolo26n.yaml")  # build a new model from YAML

# Train the model
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)
CLI
# Train from scratch using the model architecture file
yolo detect train data=brain-tumor.yaml model=yolo26n.yaml epochs=100 imgsz=640
This approach ensures that the model starts training with random weights rather than pre-trained ones. If you encounter any issues, please ensure you are using the latest version of the Ultralytics package and provide a minimum reproducible example if the problem persists. You can find more details on creating a reproducible example here.
Feel free to reach out if you have any further questions. Happy training! 🚀
1 Thank you!! However, there is another problem, that is, why it says the path of dataset is not found? I already downloaded the dataset files and changed the path in "brain-tumor.yaml" file.
The threw error was follows: "Dataset 'brain-tumor.yaml' images not found ⚠️, missing path '/valid/images' Note dataset download directory is '/home/ros/datasets'. You can update this in '/home/ros/.config/Ultralytics/settings.yaml'"
- Paula DerrengerUltralytics(изменено)
Hello @xySun17,
Thank you for reaching out! It looks like the issue might be related to the dataset path configuration in your
brain-tumor.yamlfile. Here are a few steps to troubleshoot and resolve this:-
Verify Dataset Path: Ensure that the paths specified in your
brain-tumor.yamlfile correctly point to the locations of your dataset images. For example:path: /home/ros/datasets/brain-tumor train: images/train val: images/val -
Check Directory Structure: Confirm that the directory structure matches what is specified in the YAML file. The
images/trainandimages/valdirectories should exist within/home/ros/datasets/brain-tumor. -
Update Configuration: If the dataset is located in a different directory, update the
pathin the YAML file accordingly. For instance, if your dataset is in/home/ros/my-datasets/brain-tumor, update thepathto:path: /home/ros/my-datasets/brain-tumor -
Reproducible Example: If the issue persists, providing a minimum reproducible example can greatly help in diagnosing the problem. You can find guidance on creating a reproducible example here.
-
Latest Version: Ensure you are using the latest version of the Ultralytics package. You can update it using:
pip install --upgrade ultralytics
Here’s an example of how your
brain-tumor.yamlshould look:# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license # Brain-tumor dataset by Ultralytics # Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor/ # Example usage: yolo train data=brain-tumor.yaml path: /home/ros/datasets/brain-tumor # dataset root dir train: images/train # train images (relative to 'path') val: images/val # val images (relative to 'path') # Classes names: 0: negative 1: positive # Download script/URL (optional) download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipIf you follow these steps and still encounter issues, please share more details or any error messages you receive. This will help us assist you better.
Best regards and happy coding! 🚀
-