Датасет TT100K#
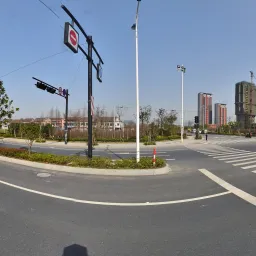
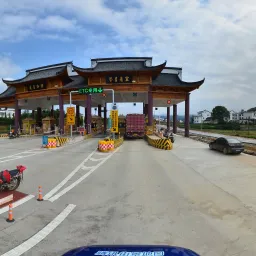
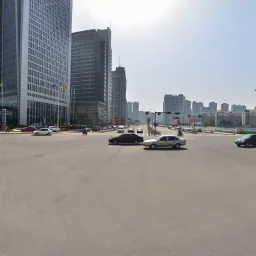
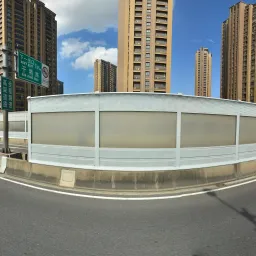
Датасет Tsinghua-Tencent 100K (TT100K) — это бенчмарк по обнаружению дорожных знаков для обнаружения объектов, созданный Zhu и соавторами для статьи CVPR 2016 года Traffic-Sign Detection and Classification in the Wild. Конфигурация Ultralytics для TT100K содержит 16 817 изображений (6 105 для обучения / 7 641 для валидации / 3 071 для тестирования) в 221 категории дорожных знаков; в исходном бенчмарке сообщается более чем о 30 000 экземпляров знаков. «100K» в названии относится примерно к 100 000 изображениям Tencent Street View, из которых был создан бенчмарк, — а не к числу изображений, которые ты скачиваешь и используешь для обучения. Поскольку в исходной статье сохраняются только категории как минимум со 100 экземплярами в обучающей выборке, существует часто используемая подвыборка из 45 классов, но конфигурация Ultralytics сохраняет все 221 размеченную категорию, многие из которых представлены редко.
Изображения панорамной съёмки улиц в высоком разрешении демонстрируют значительные различия в освещении, погоде, угле обзора и расстоянии, что делает TT100K сложным бенчмарком для обнаружения малых объектов в реальных дорожных сценах.
Ключевые особенности#
- Мультиклассовое обнаружение: 221 категория дорожных знаков, включая китайские знаки ограничения скорости, запрета, предупреждения, ограничения высоты/ширины и информационные знаки.
- Высокое разрешение: изображения размером 2048×2048 пикселей, поэтому знаки варьируются от крупных объектов крупным планом до крошечных удалённых указателей, создавая нагрузку на детекторы тонких различий.
- Реальные условия: значительные различия в погоде, освещении, угле обзора и степени遮遮ения.
- Аннотации ограничивающих рамок: каждый знак после автоматического преобразования размечен классом и ограничивающей рамкой в формате YOLO.
- Предопределённые разбиения: фиксированные разбиения на обучающую / валидационную / тестовую выборки (6 105 / 7 641 / 3 071 изображение) для единообразной оценки.
Структура датасета#
Конфигурация Ultralytics для TT100K разделена на три подвыборки, использующие одни и те же 221 категорию:
| Выборка | Изображения | Описание |
|---|---|---|
| Обучение | 6,105 | Размеченные изображения дорожных сцен, используемые для обучения детектора |
| Валидация | 7,641 | Исходная часть датасета «other», используемая для оценки |
| Тестовая | 3,071 | Отложенные изображения для финальной оценки обученной модели |
221 категория объединена в несколько основных групп:
- Знаки ограничения скорости — запрещающие ограничения
pl*(например, pl5–pl120) и минимальные скоростиpm*(например, pm5–pm55). - Запрещающие знаки — общие запреты
p1–p29, знаки въезда/остановкиpn/pneи ограниченияpr*(pr10–pr100). - Предупреждающие знаки —
w1–w67, обозначающие опасности на дороге, такие как пешеходные переходы, крутые повороты, скользкая дорога и дорожные работы. - Знаки ограничения высоты/ширины — ограничения высоты
ph*(например, ph2–ph5.5) и ограничения шириныpb/pw*. - Информационные знаки — общая информация
i1–i15, информация об ограничении скоростиil*(il50–il110), прочая информацияioи информационные табличкиip.
Применения#
TT100K широко используется для создания и оценки систем распознавания дорожных знаков в реальных условиях. Типичные области применения:
- Системы восприятия для автономного вождения
- Системы помощи водителю (ADAS)
- Мониторинг дорожного движения и анализ дорожной инфраструктуры
- Городское планирование и исследования транспортных потоков
- Исследования в области компьютерного зрения для малых объектов на изображениях высокого разрешения
YAML датасета#
Файл TT100K.yaml определяет конфигурацию датасета — пути к датасету, имена классов и скрипт автоматической загрузки и преобразования. Он поддерживается в репозитории Ultralytics по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)Использование#
TT100K автоматически загружается при первом запуске обучения и требует около 18 ГБ свободного места на диске. При первом использовании скрипт загрузки получает исходные данные и преобразует аннотации в формат YOLO, что может занять несколько минут.
Чтобы обучить модель YOLO26n на датасете TT100K в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода. Полный список доступных аргументов смотри на странице обучения модели.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model - dataset will auto-download on first run
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Чтобы размечать дополнительные изображения дорожных знаков и управлять запусками обучения TT100K в браузере, используй Ultralytics Platform.
Примеры данных и аннотаций#
Изображения TT100K — это уличные сцены размером 2048×2048, в которых дорожные знаки часто занимают лишь небольшую часть кадра. На одном изображении может быть несколько знаков разного масштаба и на разном расстоянии; некоторые из них частично закрыты транспортными средствами, растительностью или строениями и сняты днём или ночью, в ясную или дождливую погоду. Именно сочетание малых объектов и сложных условий делает этот датасет серьёзным испытанием устойчивости детектора.
Цитирование и благодарности#
Если ты используешь датасет TT100K в исследовательской или разработческой работе, пожалуйста, процитируй следующую статью:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Мы хотели бы поблагодарить Tsinghua University и Tencent за сотрудничество в создании и поддержке этого ценного ресурса для сообществ компьютерного зрения и автономного вождения. Дополнительную информацию о датасете TT100K можно найти на официальном сайте датасета.
Часто задаваемые вопросы#
Датасет Tsinghua-Tencent 100K (TT100K) используется для обнаружения и классификации дорожных знаков в реальных условиях. Его 221 категория и изображения улиц в высоком разрешении делают его распространённым бенчмарком для исследований восприятия в системах автономного вождения, системах помощи водителю (ADAS) и обнаружения малых объектов.
Конфигурация Ultralytics для TT100K содержит 16 817 изображений: 6 105 для обучения, 7 641 для валидации (исходная часть датасета «other») и 3 071 для тестирования. Полную структуру смотри в разделе Структура датасета.
«100K» относится примерно к 100 000 изображениям Tencent Street View, из которых был создан исходный бенчмарк. Конфигурация Ultralytics для обнаружения предоставляет 16 817 из этих изображений с метками в формате YOLO; название отражает исходную коллекцию, а не размер обучающей выборки.
TT100K определяет 221 категорию, охватывающую знаки ограничения скорости, запрещающие, предупреждающие, ограничения высоты/ширины и информационные знаки. В исходной статье сохраняются только 45 категорий как минимум со 100 экземплярами в обучающей выборке, но конфигурация Ultralytics сохраняет все 221. Разбиение по группам смотри в разделе Структура датасета.
TT100K занимает около 18 ГБ и автоматически загружается при первом запуске обучения с
data="TT100K.yaml"— вручную скачивать его не требуется. При первом запуске скрипт также преобразует исходные аннотации в формат YOLO.Обучи модель YOLO26n на TT100K в течение 100 эпох с размером изображения 640:
Пример обученияfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Подробные конфигурации смотри на странице обучения и в разделе советов по обучению моделей.
Начни с
imgsz=640для первых экспериментов, а затем увеличь значение доimgsz=1280(с меньшимbatch), если у тебя достаточно памяти GPU, поскольку более высокое разрешение помогает обнаруживать маленькие удалённые знаки:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # higher resolution for small signsТы также можешь настроить аугментацию данных и рассмотреть стратегии разбиения изображений на фрагменты для очень малых объектов. Подробнее смотри в разделе Советы по обучению моделей.