Набор данных PASCAL VOC (визуальные классы объектов) — классический бенчмарк для обнаружения объектов с 20 категориями повседневных объектов. Конфигурация Ultralytics VOC.yaml объединяет части trainval VOC2007 и VOC2012 в обучающую выборку из 16 551 изображения, использует 4 952 общедоступных тестовых изображения VOC2007 для валидации и автоматически загружает все необходимые данные (2,8 ГБ) при первом использовании.
Смотри: Как обучить Ultralytics YOLO на датасете Pascal VOC | Обнаружение объектов | Компьютерное зрение 🚀
Соревнования PASCAL VOC проходили с 2005 по 2012 год и повлияли на методы оценки моделей обнаружения объектов: бенчмарк охватывает классификацию изображений, обнаружение и сегментацию и сделал среднюю точность по всем классам (mAP) стандартной метрикой обнаружения. Конфигурация Ultralytics VOC.yaml использует разметку для обнаружения и при загрузке преобразует исходные ограничивающие рамки из XML в формат YOLO.
20 категорий повседневных объектов: человек; шесть животных (птица, кошка, корова, собака, лошадь, овца); семь транспортных средств (самолёт, велосипед, лодка, автобус, автомобиль, мотоцикл, поезд); и шесть предметов интерьера (бутылка, стул, обеденный стол, растение в горшке, диван, телевизор).
Объединены две версии соревнования: обучающая выборка объединяет trainval VOC2007 (5 011 изображений) и trainval VOC2012 (11 540 изображений).
Стандартизированная оценка: опубликованные за десятилетия базовые результаты VOC дают удобную точку отсчёта для сравнения моделей обнаружения.
Готовность к YOLO: скрипт загрузки скачивает архивы и автоматически преобразует разметку — вручную подготавливать данные не нужно.
Тестовая выборка VOC2007, используемая для оценки во время обучения
Тестовая
4,952
Те же тестовые изображения VOC2007 — в конфигурации не задана отдельная отложенная выборка
Разметка тестовой выборки VOC2007 была опубликована после соревнования того года, поэтому эту часть можно использовать как размеченную выборку для валидации. Разметка тестовой выборки VOC2012 остаётся закрытой: оценить результаты на ней можно только через официальный сервер оценки PASCAL, поэтому эта часть не входит в конфигурацию.
Сложные объекты исключены
Автоматический конвертер пропускает объекты, помеченные difficult в исходной XML-разметке VOC, поэтому количество экземпляров каждого класса немного отличается от официальной статистики VOC.
Открой VOC на Ultralytics Platform, чтобы просматривать изображения с наложенной разметкой, изучать распределение классов и тепловые карты ограничивающих рамок на вкладке Charts, а также клонировать набор данных и обучать собственную модель в облаке.
В годы до появления более крупного набора данных COCO PASCAL VOC был основным бенчмарком исследований в области обнаружения объектов: такие детекторы, как Faster R-CNN и SSD, впервые представили результаты на нём, а модели Ultralytics YOLO можно обучать на нём без дополнительной настройки. Сегодня этот набор по-прежнему популярен для:
Сравнения новых архитектур обнаружения с множеством опубликованных ранее базовых результатов
Быстрых экспериментов и учебных проектов: на 16 551 обучающем изображении обучение проходит гораздо быстрее, чем на COCO
Исследований переноса обучения на компактном и хорошо изученном наборе повседневных классов
VOC загружается автоматически при первом запуске обучения — три архива общим размером 2,8 ГБ; для распаковки и преобразования потребуется около 6 ГБ свободного места на диске.
Чтобы обучить модель YOLO26n на датасете VOC в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода.
Пример обучения
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучи модель — при первом запуске датасет скачается автоматически
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
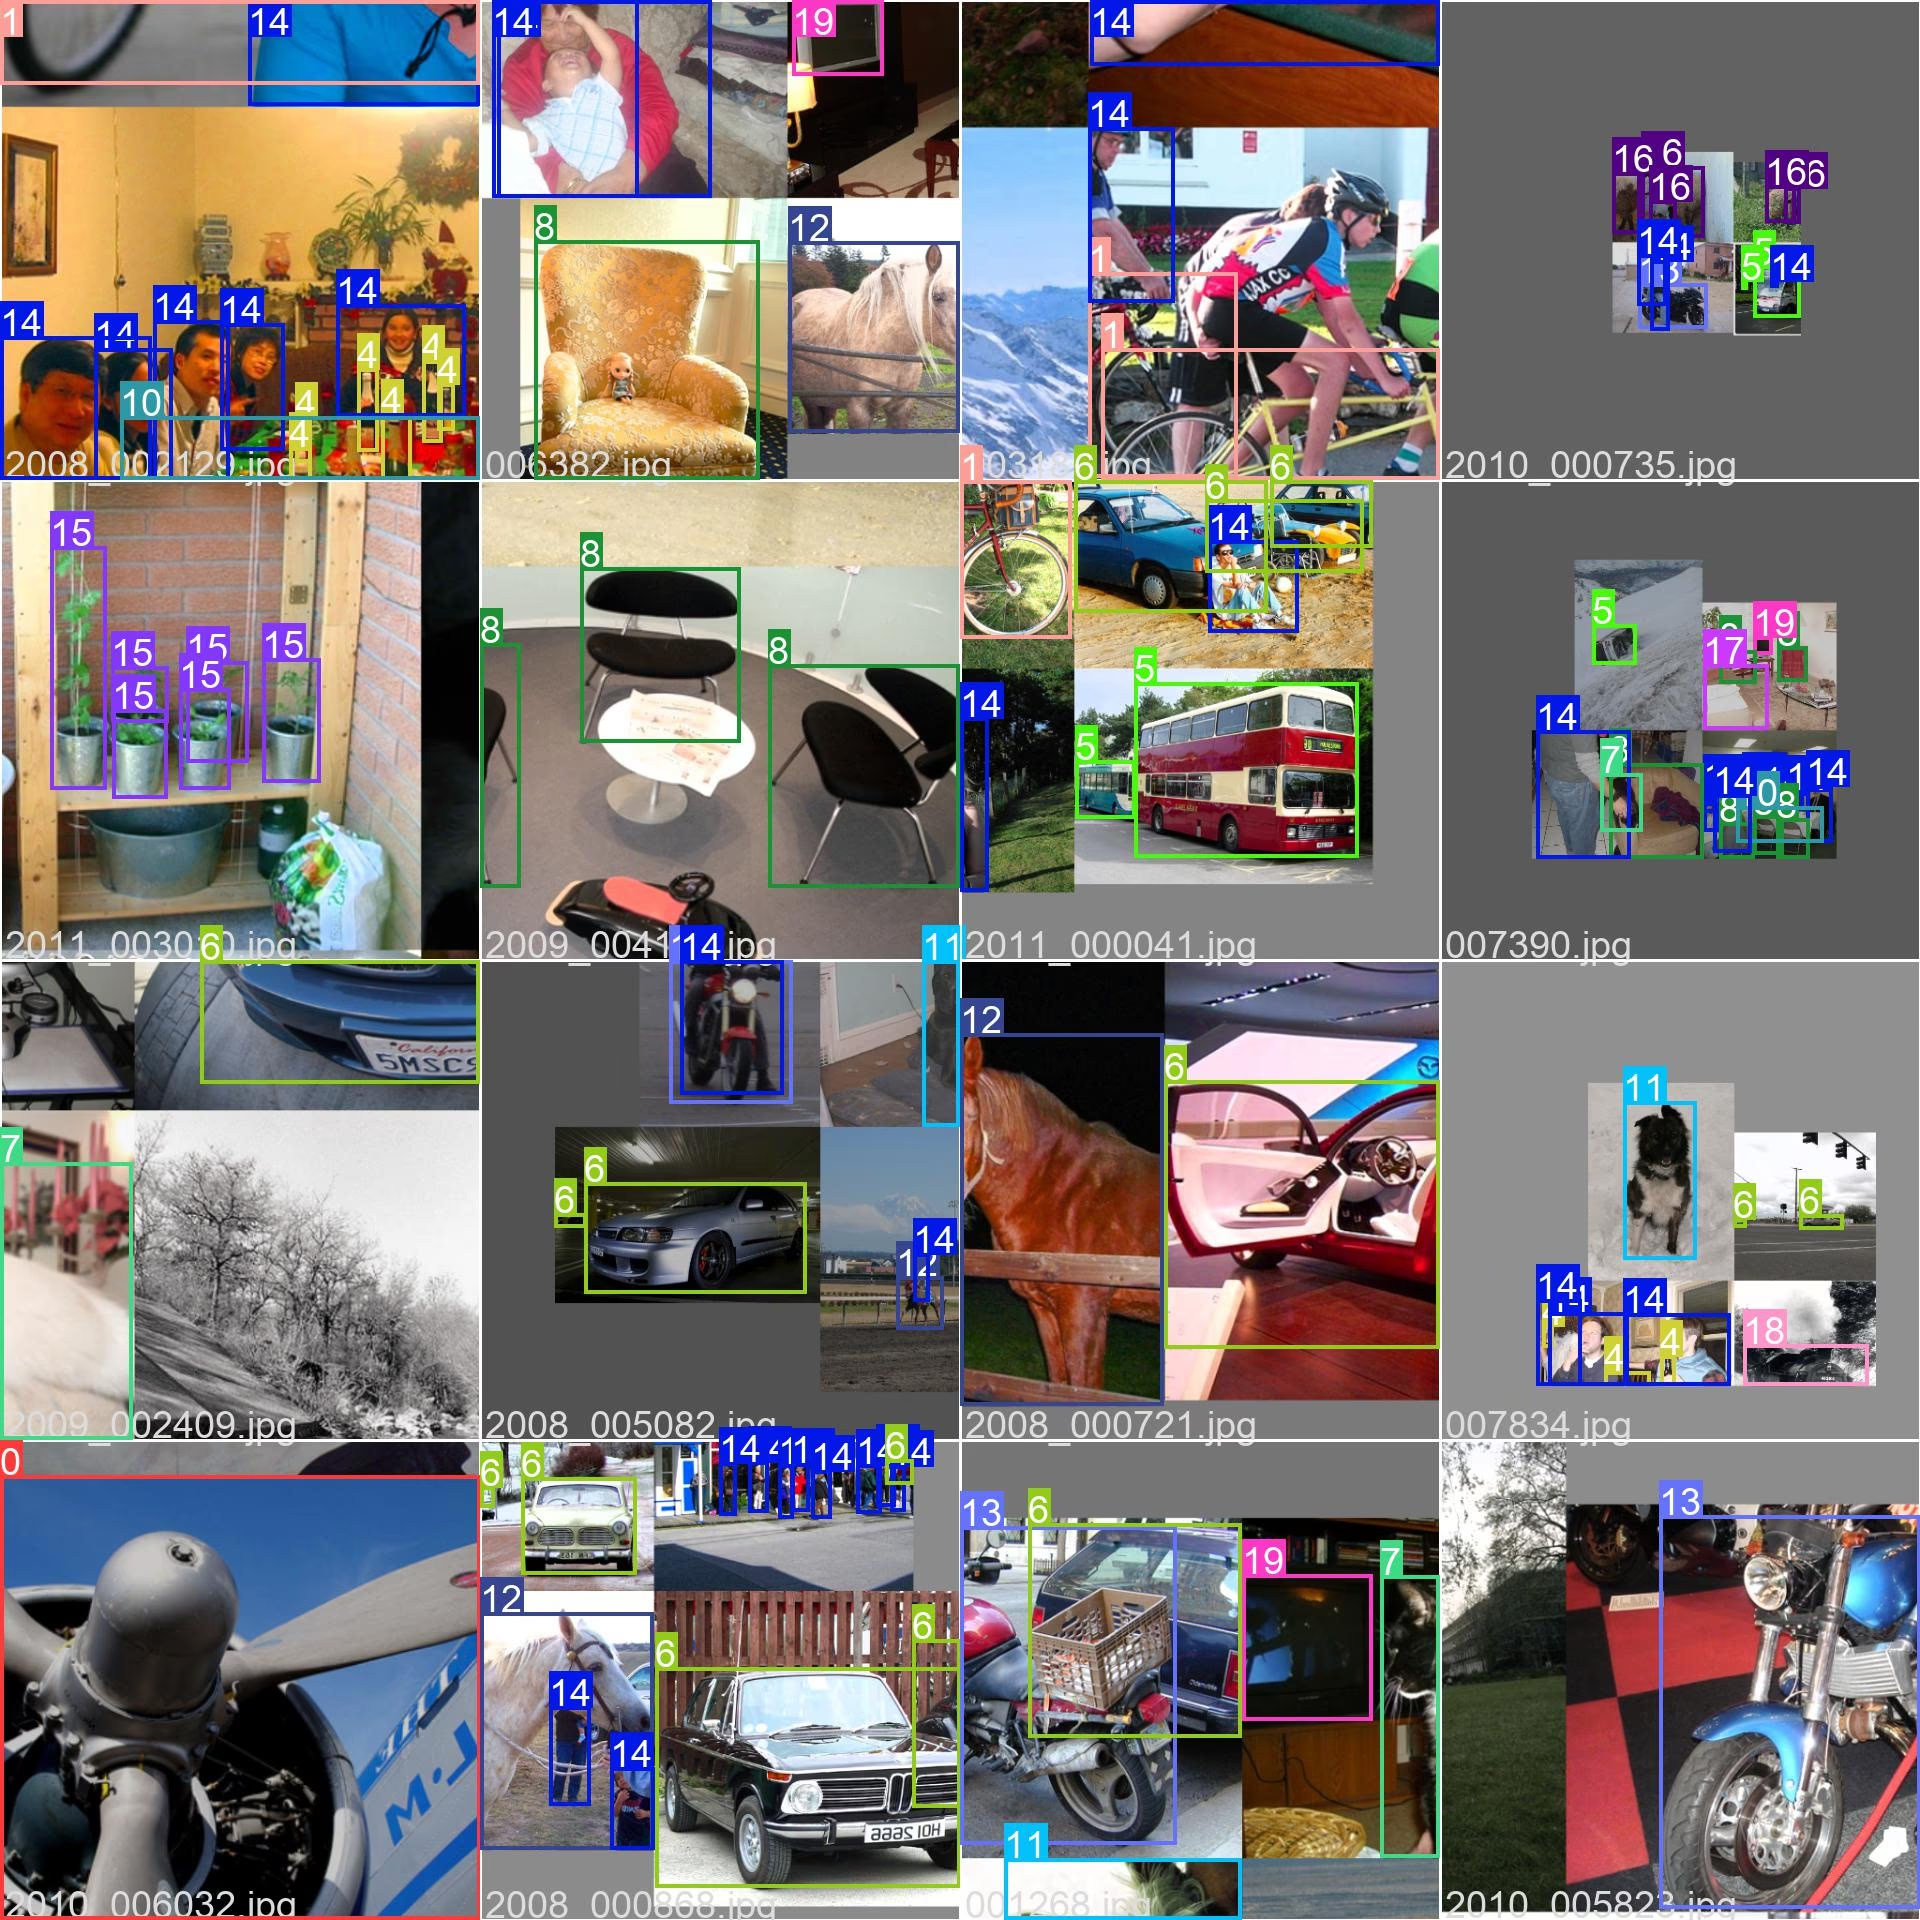
На изображении ниже показан обучающий батч с мозаичной аугментацией из набора данных VOC. Мозаичная аугментация объединяет несколько изображений в один обучающий пример, увеличивая разнообразие объектов, масштабов и контекстов сцен, которые модель видит в каждом батче. Подробнее см. в руководстве по аугментации данных YOLO.
Если ты используешь набор данных VOC в исследовательской или разработческой работе, укажи в цитировании следующую статью:
Цитирование
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
Мы хотели бы поблагодарить консорциум PASCAL VOC за создание и поддержку этого ценного ресурса для сообщества компьютерного зрения. Дополнительную информацию о наборе данных VOC и его создателях см. на сайте набора данных PASCAL VOC.
PASCAL VOC используют для обучения моделей обнаружения объектов и сравнения их качества на 20 классах повседневных объектов, например людей, автомобилей, собак и стульев. Этот компактный набор полностью размечен, а для него опубликованы базовые результаты за многие годы, поэтому его часто используют для проверки новых архитектур, учебных экспериментов и быстрых исследований переноса обучения.
Конфигурация Ultralytics для VOC содержит 21 503 изображения: 16 551 для обучения (VOC2007 trainval + VOC2012 trainval) и 4 952 для валидации (тестовый набор VOC2007). Во всех разделах представлены одни и те же 20 классов. Полную разбивку см. в разделе Структура набора данных.
VOC загружается автоматически при первом запуске обучения с data="VOC.yaml" — вручную ничего делать не нужно. Скрипт скачивает три архива (2,8 ГБ) из ресурсов релиза Ultralytics на GitHub и преобразует XML-аннотации в формат YOLO.
Обучи модель YOLO26n на VOC в течение 100 эпох с размером изображения 640:
Пример обучения
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
В обоих испытаниях используются одни и те же 20 классов, но изображения в них разные. VOC2007 содержит 5 011 изображений trainval и тестовый набор из 4 952 изображений с открытыми аннотациями; VOC2012 содержит 11 540 изображений trainval, а его тестовые аннотации закрыты и оцениваются только официальным сервером. Конфигурация Ultralytics VOC.yaml объединяет оба набора trainval для обучения и проводит валидацию на тестовом наборе VOC2007.
VOC меньше и проще: 20 классов и 21 503 изображения против 80 классов и 330 тыс. изображений в COCO. Для VOC традиционно указывают mAP при 0,5 IoU, а в COCO усредняют mAP по порогам IoU от 0,5 до 0,95. Обучение на VOC проходит гораздо быстрее, поэтому он подходит для коротких экспериментов; набор данных COCO — стандарт для тестирования моделей в производственном масштабе.
Нет: VOC.yaml — конфигурация только для обнаружения объектов. Конвертер извлекает ограничивающие рамки из аннотаций VOC в формате XML, но маски сегментации из исходного теста не преобразует. Чтобы обучить модель сегментации экземпляров, используй набор данных с полигональной разметкой, например COCO-Seg, и модель YOLO26n-seg.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
Файлы cookie помогают нам понять, какие документы, модели и функции полезны для тебя, чтобы мы могли и дальше их улучшать. Выбери, чем поделиться, в разделе , или ознакомься с нашей Политика конфиденциальности.


mengdxiran
 Glenn JocherUltralytics
YustasDev