Датасет COCO8-Seg
Введение#
Ultralytics COCO8-Seg — небольшой набор данных для сегментации экземпляров, состоящий из первых 8 изображений обучающей выборки COCO train 2017: 4 для обучения и 4 для валидации. Этот набор данных подходит для тестирования и отладки моделей сегментации, а также для экспериментов с новыми подходами к сегментации. Всего 8 изображений — такой набор легко обрабатывать, но он достаточно разнообразен, чтобы выявлять ошибки в конвейерах обучения и проверять их работоспособность перед обучением на более крупных наборах данных.
Структура набора данных#
- Изображения: всего 8 (4 train / 4 val).
- Классы: 80 категорий COCO.
- Метки: полигоны в формате YOLO хранятся в
labels/{train,val}; каждому файлу изображения соответствует файл меток. - Размер загрузки: ~1 МБ.
Открой COCO8-Seg на платформе Ultralytics, чтобы просмотреть все изображения и соответствующие им полигональные маски, изучить распределение классов и тепловые карты аннотаций на вкладке Charts, а также клонировать датасет для обучения собственной модели в облаке.
Файл YAML набора данных#
Для описания конфигурации датасета используется YAML-файл. В нём указаны пути к данным, классы и другая необходимая информация. Для датасета COCO8-Seg файл coco8-seg.yaml размещён по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco8-seg.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8-seg dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/coco8-seg
# Example usage: yolo train data=coco8-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8-seg ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8-seg # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8-seg.zipИспользование#
Чтобы обучить модель YOLO26n-seg на датасете COCO8-Seg в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-seg.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="coco8-seg.yaml", epochs=100, imgsz=640)
Примеры изображений и аннотаций#
Ниже приведены примеры изображений из датасета COCO8-Seg и соответствующие им аннотации:
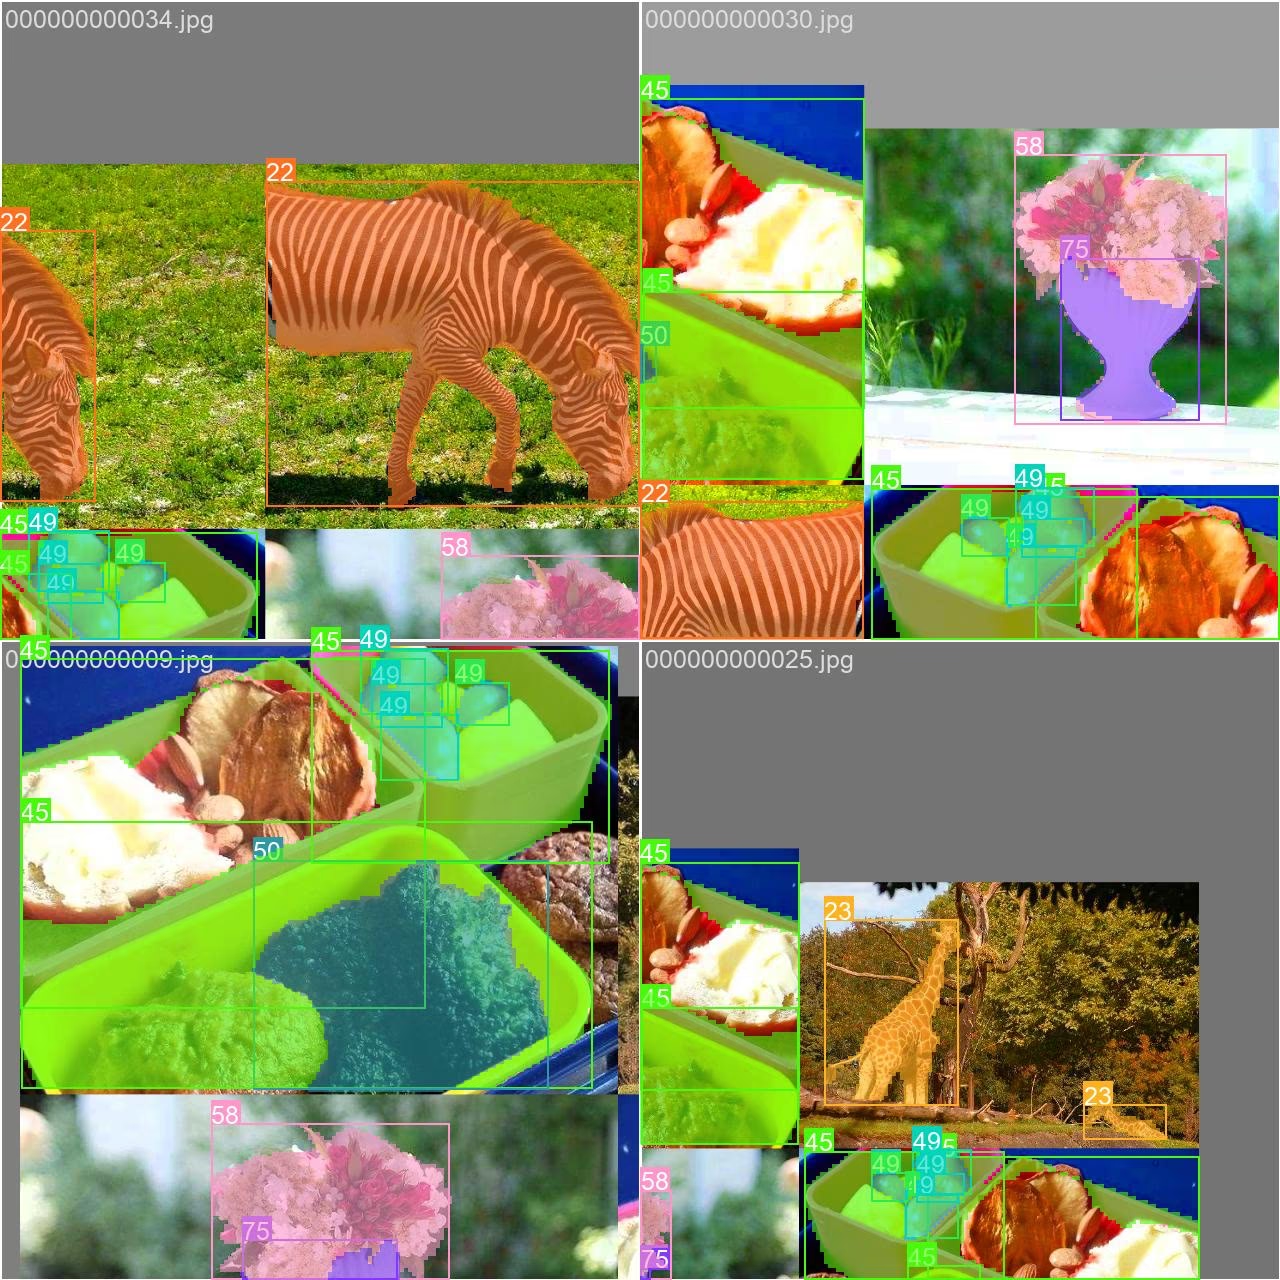
- Мозаичное изображение: на изображении показан обучающий батч, составленный из мозаично объединённых изображений датасета. Мозаичное объединение — это метод, применяемый во время обучения: несколько изображений объединяются в одно, чтобы увеличить разнообразие объектов и сцен в каждом обучающем батче. Это помогает модели лучше обобщать данные для объектов разных размеров, с разными соотношениями сторон и в разных контекстах.
Цитирование и благодарности#
Если ты используешь датасет COCO в исследовательской или разработческой работе, укажи в ссылках следующую статью:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Мы благодарим консорциум COCO за создание и поддержку этого ценного ресурса для сообщества компьютерного зрения. Подробнее о датасете COCO и его создателях можно узнать на сайте датасета COCO.
Часто задаваемые вопросы#
Набор данных COCO8-Seg — компактный набор данных Ultralytics для сегментации экземпляров, состоящий из первых 8 изображений обучающей выборки COCO train 2017 (4 для обучения и 4 для валидации). Он предназначен для тестирования и отладки моделей сегментации, а также для экспериментов с новыми методами сегментации. Он особенно полезен с Ultralytics YOLO26 для быстрой итеративной разработки и проверки конвейера на ошибки перед масштабированием на более крупные наборы данных.
Чтобы обучить модель YOLO26n-seg на датасете COCO8-Seg в течение 100 эпох с размером изображения 640, используй Python или команды CLI. Вот краткий пример:
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n-seg.pt") # Загрузи предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="coco8-seg.yaml", epochs=100, imgsz=640)Подробное описание доступных аргументов и параметров конфигурации смотри в документации по обучению.
Загрузка и цикл обучения/валидации на COCO8-Seg намного короче, чем на полном COCO, поэтому можно выполнить проход обучения и валидации, чтобы выявить ошибки конвейера — например, неисправный загрузчик данных, неверную настройку функции потерь или неудачную аугментацию — до перехода к более крупному датасету. Подробнее о поддерживаемых форматах датасетов читай в руководстве Ultralytics по датасетам для сегментации.
YAML-файл конфигурации датасета COCO8-Seg доступен в репозитории Ultralytics. Открой файл напрямую по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco8-seg.yaml. YAML-файл содержит важные сведения о путях к данным, классах и параметрах конфигурации, необходимых для обучения и валидации модели.
По размеру COCO8-Seg (8 изображений) меньше, чем COCO128-Seg (128 изображений) и полный датасет COCO-Seg (118 287 обучающих изображений):
- COCO8-Seg: 8 изображений (4 train, 4 val) — самый быстрый способ выполнить базовую проверку; идеально подходит для CI и быстрой отладки.
- COCO128-Seg: 128 изображений — компромисс между размером и разнообразием; выборки train и val используют одну и ту же директорию.
- Полный COCO-Seg: 118 287 обучающих изображений — полный охват, но высокие требования к ресурсам: при первой загрузке потребуется ~20 ГБ.
Для максимально быстрой проверки конвейера используй COCO8-Seg, а затем, когда уверенность возрастёт, переходи на COCO128-Seg или полный датасет COCO-Seg.


Комментарии6
Задай вопрос, поделись результатами или помоги кому-нибудь.
kh-diab
Hello I am struggling because I followed the same coco format in the yaml file but still get this error
Epoch GPU_mem box_loss seg_loss cls_loss dfl_loss Instances Size0%| | 0/2 [00:00<?, ?it/s] Traceback (most recent call last): File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/utils/loss.py", line 289, in call targets = torch.cat((batch_idx, batch["cls"].view(-1, 1), batch["bboxes"]), 1) RuntimeError: Sizes of tensors must match except in dimension 1. Expected size 66 but got size 0 for tensor number 1 in the list.
The above exception was the direct cause of the following exception:
Traceback (most recent call last): File "/home/kdiab/Documents/OST/workspace/dataset/coding/Train_Model/train segment model V6.0.py", line 33, in results =model.train( File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/engine/model.py", line 652, in train self.trainer.train() File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/engine/trainer.py", line 204, in train self._do_train(world_size) File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/engine/trainer.py", line 381, in _do_train self.loss, self.loss_items = self.model(batch) File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/torch/nn/modules/module.py", line 1532, in _wrapped_call_impl return self._call_impl(*args, **kwargs) File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/torch/nn/modules/module.py", line 1541, in _call_impl return forward_call(*args, **kwargs) File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/nn/tasks.py", line 101, in forward return self.loss(x, *args, **kwargs) File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/nn/tasks.py", line 283, in loss return self.criterion(preds, batch) File "/home/kdiab/.conda/envs/yolov8/lib/python3.10/site-packages/ultralytics/utils/loss.py", line 294, in call raise TypeError( TypeError: ERROR ❌ segment dataset incorrectly formatted or not a segment dataset. This error can occur when incorrectly training a 'segment' model on a 'detect' dataset, i.e. 'yolo train model=yolov8n-seg.pt data=coco8.yaml'. Verify your dataset is a correctly formatted 'segment' dataset using 'data=coco8-seg.yaml' as an example.
and this is my yaml file
Ultralytics YOLO , AGPL-3.0 license
COCO8-seg dataset (first 8 images from COCO train2017) by Ultralytics
Documentation: https://docs.ultralytics.com/datasets/segment/coco8-seg/
Example usage: yolo train data=coco8-seg.yaml
parent
├── ultralytics
└── datasets
└── coco8-seg ← downloads here (1 MB)
Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: /home/kdiab/Documents/OST/workspace/dataset/model_train/Group-C-tiny-Segment # dataset root dir train: /home/kdiab/Documents/OST/workspace/dataset/model_train/Group-C-tiny-Segment/images/train # train images (relative to 'path') 4 images val: /home/kdiab/Documents/OST/workspace/dataset/model_train/Group-C-tiny-Segment/images/val # val images (relative to 'path') 4 images test: # test images (optional)
Classes
names: 0: weed 1: rumex
and I am using model model = YOLO('yolov8x-seg.pt')
my labeled files is as follows
0 0.094970703125 0.46401098901098903 0.09033203125 0.160989010989011 0 0.07861328125 0.46153846153846156 0.0556640625 0.03296703296703297 0 0.116943359375 0.43763736263736264 0.02783203125 0.036813186813186814
can you please advise what is the error
 Glenn JocherUltralytics
@kh-diab it looks like the error you're encountering is due to a mismatch in the dataset format. Ensure that your dataset is correctly formatted for segmentation. Verify that your label files contain segmentation masks and not just bounding boxes. Also, make sure you are using the latest version of the Ultralytics package. If the issue persists, please check the dataset structure against the COCO8-Seg example provided in the documentation: https://docs.ultralytics.com/datasets/segment/coco8-seg/. This should help resolve the formatting issue.
Mauricio566
I really love their material. I have a question please help me. If the annotations of an image for a detection problem look like this... 1 0.5302913188934326 0.5031314492225647 0.2403690367937088 0.34829962253570557 So what does the annotation of a segmented image look like? because in the dataset I did not understand the annotation and you could help me understand this process. thank you
- Glenn JocherUltralytics
@Mauricio566 hello! Thanks for your kind words and for reaching out with your question. 🌟
For instance segmentation, unlike detection annotations which typically include class labels and bounding box coordinates (x_center, y_center, width, height), segmentation annotations are more complex. They include polygonal annotations or masks that precisely outline the object within an image.
In datasets like COCO, each segmented object in an image will have a corresponding mask defined by a set of polygon points. These points outline the exact shape of the object rather than just a bounding rectangle. This allows for a more accurate and detailed representation, especially useful for applications requiring precise object localization and shape delineation.
If you're working with the COCO8-Seg dataset, the annotations will include these detailed masks for each object in the images. You can view these annotations in the JSON format provided with the dataset, where each object's mask is represented as a series of coordinates outlining the object.
I hope this helps clarify the difference! If you have any more questions or need further assistance, feel free to ask. Happy coding! 😊
1 jotar25
this is actually not clear, should i separate masked color to multiple images? what is it the processs to generate labels from multi mask image?
- Glenn JocherUltralytics
Hi @jotar25,
Thank you for your question! 😊 Let's clarify the process for generating labels from multi-mask images for instance segmentation.
In instance segmentation, each object in an image is annotated with a mask that precisely outlines its shape. These masks are typically represented as polygons or binary masks. Here's a step-by-step overview of the process:
-
Separate Masks for Each Object: Each object in the image should have its own mask. If you have a multi-mask image where different objects are represented by different colors, you will need to separate these into individual masks.
-
Polygon Annotations: For datasets like COCO, the masks are often stored as polygons. Each polygon is a list of coordinates that outline the object. These coordinates are stored in the dataset's annotation file (e.g., a JSON file for COCO).
-
Binary Masks: Alternatively, masks can be stored as binary images where the pixels belonging to an object are set to 1, and all other pixels are set to 0. Each object will have a separate binary mask.
-
Annotation Format: In the COCO format, each annotation includes:
segmentation: A list of polygons for the object.bbox: The bounding box of the object.category_id: The class of the object.image_id: The ID of the image.
Here's an example of how a COCO annotation might look:
{
  "segmentation": [[x1, y1, x2, y2, ..., xn, yn]],
  "bbox": [x, y, width, height],
  "category_id": 1,
  "image_id": 123
}
Example Code for Generating Binary Masks
If you have a multi-mask image and need to generate individual binary masks, you can use the following Python code snippet:
import cv2
import numpy as np

# Load the multi-mask image
multi_mask_image = cv2.imread('multi_mask_image.png')

# Assume each object is represented by a unique color
unique_colors = np.unique(multi_mask_image.reshape(-1, multi_mask_image.shape[2]), axis=0)

# Create binary masks for each unique color
binary_masks = []
for color in unique_colors:
    mask = cv2.inRange(multi_mask_image, color, color)
    binary_masks.append(mask)

# Save or process the binary masks
for i, mask in enumerate(binary_masks):
    cv2.imwrite(f'binary_mask_{i}.png', mask)
For more detailed information on the COCO8-Seg dataset and how to work with it, please refer to the COCO8-Seg Dataset Documentation.
I hope this helps! If you have any more questions or need further assistance, feel free to ask. Happy coding! 🚀
-