Оптимизация инференса YOLO с помощью OpenVINO#
Введение#
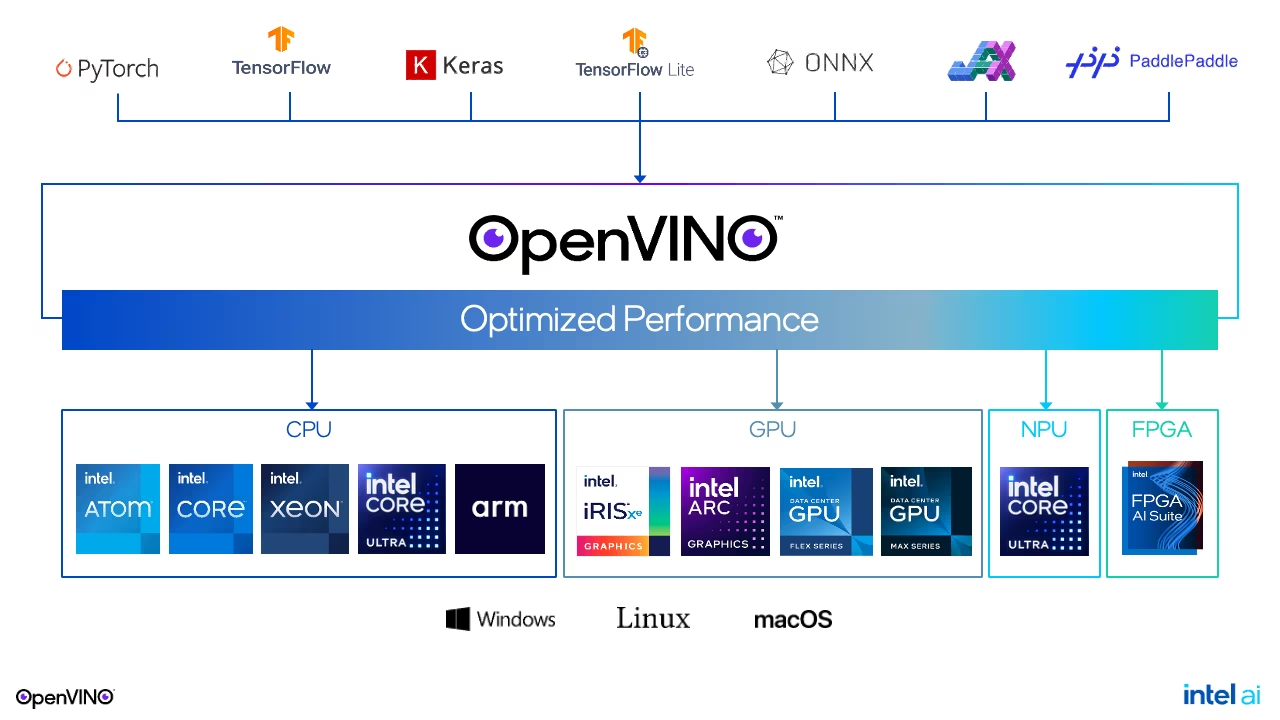
При развёртывании моделей глубокого обучения, особенно моделей обнаружения объектов, таких как модели Ultralytics YOLO, обычно оптимизируют инференс либо по задержке (быстрый ответ на отдельный запрос), либо по пропускной способности (одновременная обработка множества запросов). В этом руководстве объясняется, как использовать инструментарий OpenVINO от Intel для каждой из этих целей — от приложений для потребительских устройств до масштабных развёртываний.
Оптимизация задержки#
Оптимизация задержки важна для приложений, которым нужен немедленный ответ одной модели на один входной запрос, что типично для потребительских сценариев. Цель — свести к минимуму задержку между подачей входных данных и получением результата инференса. Однако для достижения низкой задержки требуется тщательно всё продумать, особенно при параллельном выполнении инференса или работе с несколькими моделями.
Основные стратегии оптимизации задержки#
- Один инференс на устройство: самый простой способ добиться низкой задержки — ограничить устройство одним инференсом за раз. Дополнительный параллелизм часто увеличивает задержку.
- Использование подустройств: устройства вроде CPU с несколькими сокетами или GPU с несколькими вычислительными блоками могут выполнять несколько запросов с минимальным увеличением задержки, задействуя внутренние подустройства.
- Подсказки производительности OpenVINO: использование
ov::LATENCYот OpenVINO для свойстваov::performance_modeпри компиляции модели упрощает настройку производительности и обеспечивает независимый от устройства и актуальный в будущем подход.
Управление задержкой при первом инференсе#
- Кэширование моделей: чтобы уменьшить влияние загрузки и компиляции модели на задержку, по возможности используй кэширование моделей. Если кэширование невозможно, CPU обычно обеспечивают самую быструю загрузку моделей.
- Сопоставление модели с памятью и чтение: чтобы сократить время загрузки, OpenVINO заменил чтение модели сопоставлением с памятью. Однако если модель находится на съемном или сетевом диске, используй
ov::enable_mmap(false), чтобы вернуться к чтению. - Выбор устройства AUTO: инференс начинается на CPU, а после готовности ускорителя переключается на него, что снижает задержку первого инференса.
Оптимизация пропускной способности#
Оптимизация пропускной способности крайне важна в сценариях одновременного обслуживания множества запросов на инференс: она позволяет максимально использовать ресурсы, не снижая существенно производительность обработки отдельных запросов.
Способы оптимизации пропускной способности#
-
Подсказки производительности OpenVINO: высокоуровневый и перспективный способ повысить пропускную способность на разных устройствах с помощью подсказок производительности.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Явная пакетная обработка и потоки: более детальная настройка производительности с использованием явной пакетной обработки и потоков.
Проектирование приложений с высокой пропускной способностью#
Чтобы максимально повысить пропускную способность, приложения должны:
- Обрабатывать входные данные параллельно, полностью используя возможности устройства.
- Разбивать поток данных на параллельные запросы на инференс, запланированные для одновременного выполнения.
- Используй асинхронный API с обратными вызовами, чтобы поддерживать эффективность и не допускать простоя устройства.
Выполнение на нескольких устройствах#
Многопользовательский режим OpenVINO упрощает масштабирование пропускной способности: он автоматически распределяет запросы на инференс между устройствами, избавляя от необходимости управлять устройствами на уровне приложения.
Прирост производительности в реальных условиях#
Применение оптимизаций OpenVINO к моделям Ultralytics YOLO может существенно повысить производительность. Как показывают результаты тестов производительности, на CPU Intel инференс может выполняться до 3 раз быстрее; ускорение может быть ещё выше на разных устройствах Intel, включая интегрированные GPU, дискретные GPU и NPU.
Например, при запуске моделей YOLO26 на CPU Intel Xeon версии, оптимизированные с помощью OpenVINO, неизменно превосходят аналоги на PyTorch по времени инференса на изображение без ущерба для точности.
Практическая реализация#
Чтобы экспортировать модель Ultralytics YOLO и оптимизировать её для OpenVINO, воспользуйся функцией экспорта:
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")

# Экспортировать модель в формат OpenVINO
model.export(format="openvino", quantize=16)  # Экспортировать с точностью FP16
После экспорта можно запустить инференс с оптимизированной моделью:
# Загрузить модель OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")

# Запустить инференс (Ultralytics компилирует модели OpenVINO с подсказкой производительности LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Заключение#
Оптимизация моделей Ultralytics YOLO с помощью OpenVINO для снижения задержки или увеличения пропускной способности может значительно повысить производительность приложения. Выбор между оптимизацией задержки и пропускной способности зависит от потребностей приложения и особенностей среды развёртывания.
Оптимизируешь ли ты приложение для ответов в реальном времени или максимальной пропускной способности при масштабной обработке — отталкивайся от требований приложения, выбери соответствующую подсказку производительности и измерь её на целевом оборудовании.
Часто задаваемые вопросы#
Для оптимизации моделей Ultralytics YOLO и снижения задержки можно применить несколько ключевых стратегий:
- Один инференс на устройство: выполняй не более одного инференса за раз на каждом устройстве, чтобы свести задержки к минимуму.
- Использование подустройств: применяй такие устройства, как многоядерные CPU или многокристальные GPU, способные обрабатывать несколько запросов с минимальным увеличением задержки.
- Подсказки производительности OpenVINO: используй
ov::LATENCYот OpenVINO при компиляции модели для простой настройки, не зависящей от устройства.
Больше практических советов по оптимизации задержки смотри в разделе «Оптимизация задержки» нашего руководства.
OpenVINO повышает пропускную способность моделей Ultralytics YOLO, максимально используя ресурсы устройства без потери производительности. Ключевые преимущества:
- Подсказки производительности: простая высокоуровневая настройка производительности на разных устройствах.
- Явная пакетная обработка и потоки: точная настройка для повышения производительности.
- Выполнение на нескольких устройствах: автоматическая балансировка нагрузки инференса, упрощающая управление на уровне приложения.
Пример конфигурации:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Подробнее об оптимизации пропускной способности читай в разделе «Оптимизация пропускной способности» нашего подробного руководства.
Чтобы снизить задержку при первом инференсе, воспользуйся следующими рекомендациями:
- Кэширование моделей: используй кэширование моделей, чтобы сократить время загрузки и компиляции.
- Сопоставление модели с памятью и чтение: по умолчанию используй сопоставление с памятью (
ov::enable_mmap(true)), но переключайся на чтение (ov::enable_mmap(false)), если модель находится на съемном или сетевом диске. - Выбор устройства AUTO: используй режим AUTO, чтобы начать инференс на CPU и переключиться на ускоритель, когда он будет готов.
Подробные стратегии управления задержкой при первом инференсе смотри в разделе «Управление задержкой при первом инференсе».
Чтобы сбалансировать оптимизацию задержки и пропускной способности, нужно учитывать потребности приложения:
- Оптимизация задержки: подходит для приложений, которым нужен немедленный отклик в реальном времени (например, потребительских приложений).
- Оптимизация пропускной способности: подходит для сценариев с большим количеством одновременных инференсов, где важно максимально использовать ресурсы (например, для масштабных развертываний).
Высокоуровневые подсказки производительности OpenVINO и режимы работы с несколькими устройствами помогут найти нужный баланс. Выбирай подходящие подсказки производительности OpenVINO с учетом своих требований.
Да, модели Ultralytics YOLO можно экспортировать во множество других сред выполнения. Доступны следующие варианты:
- TensorRT: для оптимизации под GPU NVIDIA следуй руководству по интеграции TensorRT.
- CoreML: инструкции для устройств Apple смотри в нашем руководстве по экспорту в CoreML.
- LiteRT.js: для веб-приложений и приложений Node.js смотри руководство по интеграции LiteRT и веб-среду выполнения LiteRT.js.
Другие интеграции смотри на странице «Интеграции Ultralytics».