YOLO12: обнаружение объектов с акцентом на механизмы внимания#
Обзор#
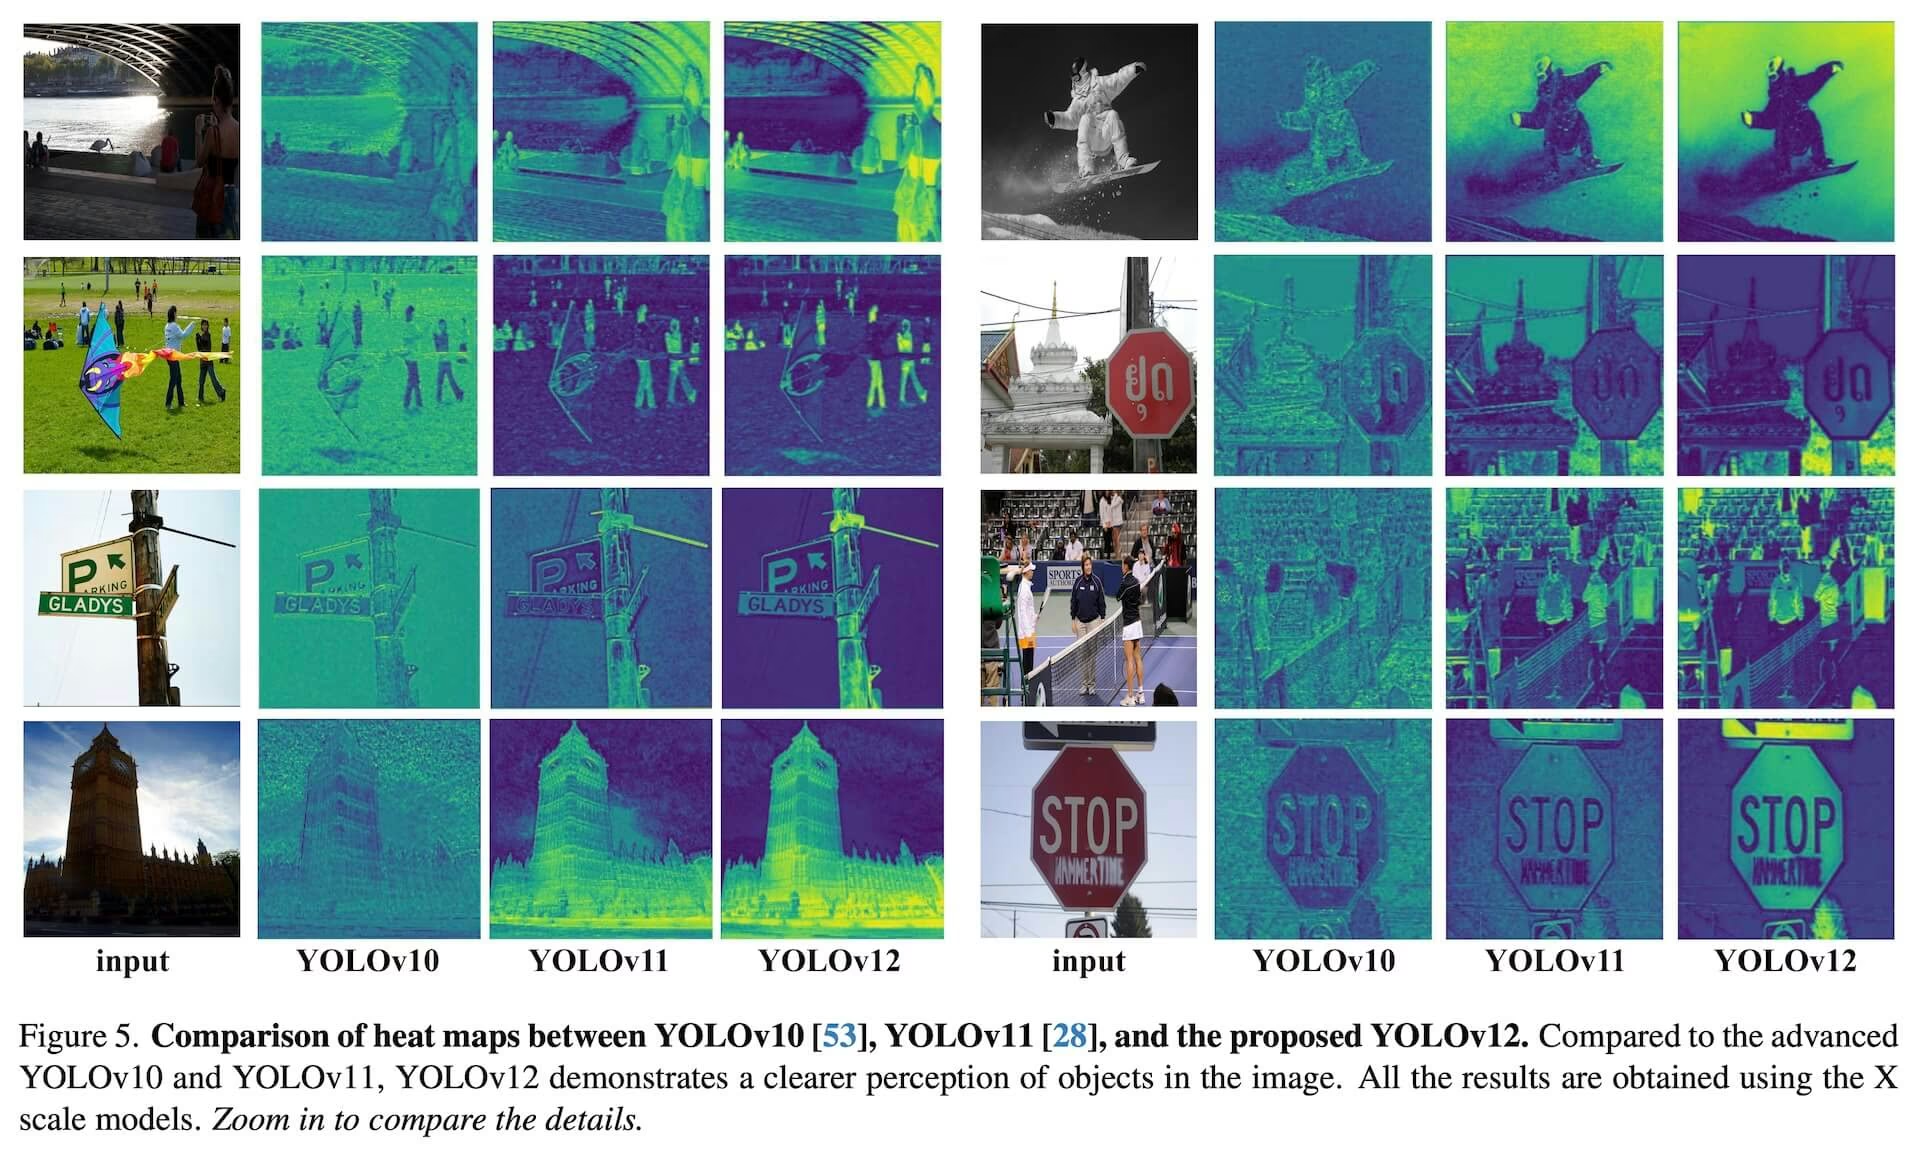
Выпущенная в начале 2025 года YOLO12 представляет архитектуру с акцентом на механизмы внимания, отличающуюся от традиционных подходов на основе CNN, использовавшихся в предыдущих моделях YOLO, но при этом сохраняющую скорость инференса в реальном времени, необходимую для многих приложений. Благодаря новым методам работы с механизмами внимания и общей архитектурой сети эта модель обеспечивает высокую точность обнаружения объектов, сохраняя производительность в реальном времени. Несмотря на эти преимущества, YOLO12 остается проектом сообщества и может демонстрировать нестабильность обучения, повышенное потребление памяти и более низкую пропускную способность на CPU из-за тяжелых блоков внимания, поэтому для большинства производственных нагрузок Ultralytics рекомендует YOLO11 или YOLO26.
Смотри: Как использовать YOLO12 для обнаружения объектов с пакетом Ultralytics | YOLO12 работает быстро или медленно? 🚀
Основные особенности#
- Механизм внимания по областям: новый подход к самовниманию, который эффективно обрабатывает большие рецептивные поля. Он делит карты признаков на l областей одинакового размера (по умолчанию 4) по горизонтали или вертикали, избегая сложных операций и сохраняя большое эффективное рецептивное поле. Это значительно снижает вычислительные затраты по сравнению со стандартным самовниманием.
- Сети агрегации признаков с остаточными связями (R-ELAN): усовершенствованный модуль агрегации признаков на основе ELAN, предназначенный для решения проблем оптимизации, особенно в более крупных моделях с акцентом на механизмы внимания. R-ELAN включает:
- Остаточные связи на уровне блоков с масштабированием (подобно масштабированию слоев).
- Переработанный метод агрегации признаков, формирующий структуру, похожую на узкое место.
- Оптимизированная архитектура внимания: YOLO12 упрощает стандартный механизм внимания для повышения эффективности и совместимости с фреймворком YOLO. В частности:
- Использование FlashAttention для минимизации накладных расходов на доступ к памяти.
- Отказ от позиционного кодирования для упрощения и ускорения модели.
- Изменение коэффициента MLP (с типичного значения 4 на 1.2 или 2) для лучшего баланса вычислений между слоями внимания и прямого распространения.
- Уменьшение глубины стека блоков для улучшения оптимизации.
- Использование свёрточных операций (где это уместно) благодаря их вычислительной эффективности.
- Добавление в механизм внимания разделимой свёртки 7x7 («позиционного перцептрона») для неявного кодирования позиционной информации.
- Комплексная поддержка задач: YOLO12 поддерживает ряд основных задач компьютерного зрения: обнаружение объектов, сегментацию экземпляров, классификацию изображений, оценку позы и обнаружение объектов с произвольной ориентацией (OBB).
- Повышенная эффективность: модель обеспечивает более высокую точность при меньшем количестве параметров по сравнению со многими предыдущими моделями, демонстрируя улучшенный баланс скорости и точности.
- Гибкое развертывание: модель разработана для развертывания на различных платформах — от периферийных устройств до облачной инфраструктуры.
Поддерживаемые задачи и режимы#
YOLO12 поддерживает различные задачи компьютерного зрения. В таблице ниже указаны поддерживаемые задачи и доступные для каждой из них режимы работы (инференс, валидация, обучение и экспорт):
На ultralytics/assets опубликованы только веса для обнаружения объектов (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt). Архитектуры сегментации, классификации, оценки позы и OBB определены в ultralytics/cfg/models/12/, поэтому эти варианты можно обучать с нуля с конфигурацией .yaml, но готовых предобученных файлов .pt для них пока нет. Для предобученных контрольных точек сегментации, оценки позы, классификации или OBB Ultralytics рекомендует YOLO11 или YOLO26.
| Тип модели | Задача | Предобученные веса | Обучение | Валидация | Инференс | Экспорт |
|---|---|---|---|---|---|---|
| YOLO12 | Обнаружение | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Сегментация | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Классификация | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Оценка позы | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
После получения обученной контрольной точки все архитектуры YOLO12 поддерживают каждый режим. В столбце Pretrained Weights указано только, публикует ли Ultralytics официальную предобученную .pt на ultralytics/assets: для сегментации, оценки позы, классификации и OBB перед запуском инференса, валидации или экспорта нужно обучить собственную контрольную точку на основе соответствующей конфигурации .yaml.
Метрики производительности#
YOLO12 демонстрирует значительное улучшение точности моделей всех масштабов, но уступает некоторым самым быстрым предыдущим моделям YOLO по скорости. Ниже приведены количественные результаты для обнаружения объектов на валидационном наборе данных COCO:
Эффективность обнаружения (COCO val2017)#
| Модель | размер (пиксели) | mAPval 50-95 | Скорость CPU ONNX (мс) | Скорость T4 TensorRT (мс) | параметры (M) | FLOPs (B) | Сравнение (mAP/скорость) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2.1%/-9% (по сравнению с YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0.1%/+42% (по сравнению с RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1.0%/-3% (по сравнению с YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0.4%/-8% (по сравнению с YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0.6%/-4% (по сравнению с YOLO11x) |
- Скорость инференса измерена на GPU NVIDIA T4 с точностью TensorRT FP16 precision.
- В сравнениях показано относительное улучшение mAP и процентное изменение скорости (положительное значение означает ускорение, отрицательное — замедление). Сравнение проводится с опубликованными результатами YOLOv10, YOLO11 и RT-DETR, если они доступны.
Примеры использования#
В этом разделе приведены примеры обучения и инференса с YOLO12. Более подробную документацию по этим и другим режимам, включая валидацию и экспорт, смотри на специальных страницах предсказания и обучения.
Примеры ниже посвящены моделям YOLO12 для обнаружения объектов. Информацию о других поддерживаемых задачах (сегментации, классификации, оценке позы и обнаружении объектов с произвольной ориентацией) смотри в соответствующей документации: Segment, Classify, Pose и OBB.
Предобученные модели *.pt (на основе PyTorch) и файлы конфигурации *.yaml можно передать классу YOLO(), чтобы создать экземпляр модели в Python:
from ultralytics import YOLO

# Загрузи предобученную на COCO модель YOLO12n
model = YOLO("yolo12n.pt")

# Обучить модель на демонстрационном наборе данных COCO8 в течение 100 эпох
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Запусти инференс с моделью YOLO12n на изображении 'bus.jpg'
results = model("path/to/bus.jpg")
Основные улучшения#
-
Улучшенное извлечение признаков:
- Внимание по областям: эффективно обрабатывает большие рецептивные поля, снижая вычислительные затраты.
- Оптимальный баланс: улучшен баланс вычислений в слоях внимания и прямого распространения.
- R-ELAN: улучшает агрегацию признаков с помощью архитектуры R-ELAN.
-
Инновации в оптимизации:
- Остаточные связи: добавлены остаточные связи с масштабированием, чтобы стабилизировать обучение, особенно в крупных моделях.
- Усовершенствованная интеграция признаков: реализован улучшенный метод интеграции признаков в R-ELAN.
- FlashAttention: интегрирован FlashAttention для снижения накладных расходов на доступ к памяти.
-
Эффективность архитектуры:
- Сокращение числа параметров: по сравнению со многими предыдущими моделями число параметров снижено при сохранении или повышении точности.
- Упрощенный механизм внимания: используется упрощенная реализация механизма внимания без позиционного кодирования.
- Оптимизированные коэффициенты MLP: коэффициенты MLP скорректированы для более эффективного распределения вычислительных ресурсов.
Требования#
По умолчанию реализация Ultralytics YOLO12 не требует FlashAttention. Однако FlashAttention можно дополнительно скомпилировать и использовать с YOLO12. Для компиляции FlashAttention требуется одна из следующих моделей GPU NVIDIA:
- GPU Turing (например, T4, серия Quadro RTX)
- GPU Ampere (например, серия RTX30, A30/40/100)
- GPU Ada Lovelace (например, серия RTX40)
- Графические процессоры Hopper (например, H100/H200)
Цитирование и благодарности#
Если ты используешь YOLO12 в своих исследованиях, пожалуйста, процитируй оригинальную работу Университета в Буффало и Университета Китайской академии наук:
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
Статья о YOLO12 опубликована в трудах NeurIPS 2025, а её предварительная версия доступна на arXiv.
Часто задаваемые вопросы#
В YOLO12 реализовано несколько важных нововведений, обеспечивающих баланс между скоростью и точностью. Механизм внимания по областям эффективно обрабатывает большие рецептивные поля, снижая вычислительные затраты по сравнению со стандартным самовниманием. Сети эффективной агрегации остаточных слоёв (R-ELAN) улучшают агрегацию признаков и решают проблемы оптимизации более крупных моделей, ориентированных на внимание. Оптимизированная архитектура внимания, включая применение FlashAttention и отказ от позиционного кодирования, дополнительно повышает эффективность. Эти особенности позволяют YOLO12 достигать передовой точности, сохраняя скорость инференса в реальном времени, необходимую для многих приложений.
YOLO12 — универсальная модель, поддерживающая широкий спектр основных задач компьютерного зрения. Она отлично справляется с обнаружением объектов, сегментацией экземпляров, классификацией изображений, оценкой позы и обнаружением объектов с ориентированными рамками (OBB) (подробнее). Благодаря широкому набору поддерживаемых задач YOLO12 становится мощным инструментом для различных областей применения — от робототехники и автономного вождения до медицинской визуализации и промышленного контроля. Обрати внимание: предварительно обученные веса
.ptсейчас опубликованы только для обнаружения объектов; архитектуры сегментации, оценки позы, классификации и OBB доступны в виде конфигураций.yamlдля обучения с нуля.YOLO12 демонстрирует заметное повышение точности на всех масштабах моделей по сравнению с предыдущими моделями YOLO, такими как YOLOv10 и YOLO11, хотя скорость несколько уступает самым быстрым моделям предыдущих поколений. Например, YOLO12n повышает mAP на +2,1% относительно YOLOv10n и на +1,2% относительно YOLO11n на наборе данных COCO val2017. По сравнению с такими моделями, как RT-DETR, YOLO12s повышает mAP на +1,5% и скорость на внушительные +42%. Эти показатели демонстрируют, насколько удачно YOLO12 сочетает точность и эффективность. Подробные сравнения см. в разделе показателей производительности.
По умолчанию для реализации YOLO12 в Ultralytics FlashAttention не требуется. Однако FlashAttention можно при желании скомпилировать и использовать с YOLO12, чтобы свести к минимуму накладные расходы на доступ к памяти. Для компиляции FlashAttention потребуется один из следующих графических процессоров NVIDIA: графические процессоры Turing (например, T4, серии Quadro RTX), Ampere (например, серии RTX30, A30/40/100), Ada Lovelace (например, серии RTX40) или Hopper (например, H100/H200). Такая гибкость позволяет использовать преимущества FlashAttention при наличии подходящих аппаратных ресурсов.
На этой странице приведены основные примеры использования для обучения и инференса. Полную документацию по этим и другим режимам, включая валидацию и экспорт, см. на отдельных страницах Predict и Train. Информацию по отдельным задачам — сегментации, классификации, оценке позы и обнаружению объектов с ориентированными рамками — см. в соответствующей документации: Segment, Classify, Pose и OBB. В этих материалах приведены подробные рекомендации по эффективному применению YOLO12 в различных сценариях.