YOLO26 Modelleri için ONNX Dışa Aktarımı
ONNX (Open Neural Network Exchange), çoğu çıkarım çalışma zamanının yükleyebildiği açık bir model biçimidir. Bir Ultralytics YOLO26 modelini format="onnx" ile dışa aktarmak, ONNX Runtime ile CPU'larda, NVIDIA ve AMD GPU'larında, Apple silicon'da ve Windows cihazlarında çalışabilen tek bir .onnx dosyası oluşturur.
Genel Bakış#
| Özellik | Ayrıntılar |
|---|---|
format bağımsız değişkeni | onnx |
| Çıktı | yolo26n.onnx, sınıf adlarını, görevi ve görüntü boyutunu meta veri olarak saklayan tek dosya; kalibre edilmiş bir quantize=8 dışa aktarımı için yolo26n_int8.onnx |
| Çalıştığı ortamlar | CPU'lar, NVIDIA GPU'ları (CUDA), AMD GPU'ları (MIGraphX), Apple silicon (Core ML yürütme sağlayıcısı) ve Windows ML cihazları |
| Çalışma zamanı | ONNX Runtime veya dnn=True ile OpenCV DNN |
| Kesinlik | FP32, FP16, INT8. YOLO26n, FP32'de 9.9 MB, FP16'da 5.0 MB ve INT8'de 3.1 MB'tır |
| Dışa aktarma ana makinesi | GPU olsun ya da olmasın Linux, macOS veya Windows |
Ultralytics Platform, eğitilmiş bir modeli senin için ONNX biçimine aktarabilir; böylece yerel bir dışa aktarma ortamına ihtiyacın olmaz.
Hızlı Başlangıç#
Ultralytics paketini yükle. İlk dışa aktarma, eksik olmaları durumunda onnx, onnxslim ve onnxruntime paketlerini yükler (NVIDIA GPU'sunda device=0 ile dışa aktarırken onnxruntime-gpu de yüklenir).
pip install ultralyticsDiğer yükleme yöntemleri için yükleme kılavuzuna bak. Ardından modelini dışa aktar ve çıkarım yapmak veya doğruluğunu değerlendirmek için dışa aktarılan dosyayı yükle.
from ultralytics import YOLO

# YOLO26 modelini yükle
model = YOLO("yolo26n.pt")

# Modeli ONNX biçimine aktar
model.export(format="onnx")  # 'yolo26n.onnx' oluşturur

# Kalibrasyon verileriyle INT8 nicemlemeli ONNX modeli dışa aktar
model.export(format="onnx", quantize=8, data="coco8.yaml") # 'yolo26n_int8.onnx' dosyasını oluştururfrom ultralytics import YOLO
# Dışa aktarılan ONNX modelini yükle
model = YOLO("yolo26n.onnx")
# Çıkarımı çalıştır
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Dışa aktarılan ONNX modelini yükle
model = YOLO("yolo26n.onnx")
# COCO8 veri kümesinde doğruluğu doğrula
metrics = model.val(data="coco8.yaml")Desteklenen Görevler#
ONNX dışa aktarma, YOLOv8, YOLO11 ve YOLO26 modelleriyle yedi Ultralytics görevinin tümünü destekler: nesne tespiti, segmentasyon, anlamsal segmentasyon, derinlik tahmini, sınıflandırma, poz tahmini ve OBB. Anlamsal segmentasyon ve derinlik tahmini yalnızca bu başlıkları içeren tek model ailesi olan YOLO26'da kullanılabilir.
Dışa Aktarma Bağımsız Değişkenleri#
| Bağımsız değişken | Tür | Varsayılan | Açıklama |
|---|---|---|---|
format | str | 'onnx' | Dışa aktarılan modelin hedef biçimi; çeşitli dağıtım ortamlarıyla uyumluluğu tanımlar. |
imgsz | int veya tuple | 640 | Model girdisinin görüntü boyutu: kare görüntüler için bir tam sayı veya (height, width) demeti. Belirtilmezse dışa aktarma, kontrol noktasının eğitildiği boyutu kullanır. Resmî YOLO26 kontrol noktalarında tespit, segmentasyon, poz ve ADE20K üzerinde önceden eğitilmiş anlamsal modeller için 640, OBB ve Cityscapes üzerinde önceden eğitilmiş anlamsal modeller için 1024, derinlik için 768 ve sınıflandırma için 224 kullanılır. |
quantize | int veya str | None | Nicemleme hassasiyeti: 16 (FP16; CPU'da dışa aktarma girdileri ve çıktıları FP32 tutar, GPU'da dışa aktarma bunları da FP16 yapar) veya 8 (data konumundaki kalibrasyon görüntülerini kullanarak ONNX Runtime ile statik INT8 nicemleme yapar ve bir _int8.onnx modeli oluşturur); 32/belirtilmemiş olması FP32 anlamına gelir. quantize=8 ile eğitilmiş bir kontrol noktası, quantize belirtilmediğinde veya 8 olduğunda INT8 olarak dışa aktarılır (diğer değerler hata verir); taşıdığı aralıklardan Q/DQ düğümleri oluşturur, kalibrasyon yapmaz ve yalın .onnx adını kullanır. Kullanımdan kaldırılmış half/int8 bayraklarının yerini alır. |
data | str | None | INT8 kalibrasyonu için kullanılan veri kümesi YAML dosyası; sınıflandırmada ise bir veri kümesi dizini veya yerleşik veri kümesi adı kullanılır. quantize=8 belirtilmediğinde Ultralytics, model görevi için varsayılan kalibrasyon veri kümesini seçer; quantize=8 ile eğitilmiş bir kontrol noktası için buna gerek yoktur. |
fraction | float, int veya list | 1.0 | Oran, görüntü sayısı veya [train, val, test] oranları/sayıları olarak kalibrasyon alt kümesi. İki öğeli listelerde test tam kalır; 0 ise onu atlar. |
dynamic | bool | False | Girdinin toplu iş, yükseklik ve genişlik boyutlarını dinamik eksenlere dönüştürür; böylece tek bir dosya farklı toplu iş boyutlarını (dışa aktarma batch değerine kadar, nms=True ile) ve görüntü boyutlarını kabul eder. Dinamik dışa aktarma bölümüne bak. |
simplify | bool | True | Model grafiğini onnxslim ile basitleştirir. |
opset | int | None | Farklı ONNX ayrıştırıcıları ve çalışma zamanlarıyla uyumluluk için ONNX opset sürümünü belirtir. Ayarlanmazsa, yüklü onnx sürümüyle sınırlandırılmış 18 opset'ini kullanır (PyTorch < 2.4 için daha düşük). En düşük opset bölümüne bak. |
nms | bool, isteğe bağlı | None | Ham çıktıyı (None, varsayılan), gömülü NMS'yi (True) veya NMS'siz başlığı (False) seçer. Çıktı biçimi bölümüne bak. |
batch | int | 1 | Dışa aktarılan modelin toplu iş boyutu. Statik dışa aktarmada bu toplu iş boyutu giriş şeklinde sabitlenir. dynamic=True ve nms=True kullanırken, çalıştırmayı planladığın en büyük toplu iş boyutuna ayarla. |
device | str | None | Dışa aktarma aygıtı: cpu (varsayılan, GPU'lu bir makinede de kullanılır), CUDA GPU'su için 0 veya Apple silicon için mps. Sonucu yalnızca quantize=16 için değiştirir; FP16 girdileri bölümüne bak. |
Tüm biçimlerde ortak olan bağımsız değişkenler için Dışa aktarma modu belgelerine bak.
INT8 Kuantizasyonu#
Kuantizasyona duyarlı eğitim ile eğitilmemiş kontrol noktaları için quantize=8, ONNX Runtime statik kuantizasyonunu yalnızca Conv, Gemm ve MatMul düğümlerine uygular. output0 öğesini oluşturan işlemler de dahil olmak üzere diğer tüm düğümler kayan noktalı kalır: kutu koordinatları (piksel) ve sınıf skorları (0 ile 1 arası) aynı tensörü paylaşır; dolayısıyla bu tensör için tek bir INT8 ölçeği kullanmak tüm sınıf skorlarını sıfıra yuvarlar. Ağırlıklar, opset 13 ve sonraki sürümlerde kanal başına kuantize edilir. Dışa aktarılmış bir FP32 modeli üzerinde quantize_static işlemini kendin çalıştırıyorsan aynı düğümleri hariç tut ve per_channel=True ayarını yap:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
Burada calibration_reader, modelin toplu iş boyutuyla {"images": array} üreten bir onnxruntime.quantization.CalibrationDataReader öğesidir ve çıkarım için ön işlenmiştir: dışa aktarma boyutuna göre letterbox uygulanmış (sınıflandırma için yeniden boyutlandırılmış ve merkezden kırpılmış), RGB, NCHW ve 0-1 aralığında float32.
INT8 model, FP32 modelin girdi ve çıktı türlerini korur; bu nedenle FP32 modeli için yazılmış çıkarım kodu değişiklik yapılmadan çalışır. INT8, dosyayı FP32'ye göre üç ila dört kat küçültür; ancak karşılaştırmalardaki ONNX Runtime testlerinde hem GPU'da hem CPU'da FP32'den daha yavaş çalıştı. Hassasiyet seçmeden önce hedef donanımındaki gecikmeyi ölç.
Çıktı Biçimi#
Dışa aktarılan model, images adlı, (batch, 3, height, width) şeklinde, RGB ve 0-1 aralığına ölçeklenmiş tek bir girdi alır. quantize=16 ile yapılan GPU dışa aktarımları dışındaki durumlarda girdi float32 türündedir; bu dışa aktarımlar float16 alır. nms bağımsız değişkeni output0 düzenini belirler. Aşağıdaki şekiller, imgsz=640 ile dışa aktarılmış, 80 sınıflı YOLO26n nesne tespiti modeli içindir:
nms | output0 şekli | İçindekiler |
|---|---|---|
None (varsayılan) | (1, 84, 8400) | 8400 bağlantı noktasının her biri için: kutu merkezi x, merkez y, genişlik ve yükseklik (girdi pikselleri cinsinden), ardından 80 sınıf puanı. NMS'yi kendin uygula. |
True | (1, 300, 6) | NMS modelin içinde çalışır. Her satır x1, y1, x2, y2, score, class şeklindedir; son tespitten sonraki satırlar sıfırdır. |
False | (1, 300, 6) | NMS'siz başlık. Her satır x1, y1, x2, y2, score, class şeklindedir ve NMS adımı yoktur. Satırları puanlarına göre kendin filtrele. |
Diğer görevlerde aynı girdi ve şu çıktılar kullanılır. Şekiller, Cityscapes kontrol noktasının anlamsal segmentasyon için yolo26n-sem.pt olduğu, varsayılan dışa aktarma boyutlarında dışa aktarılmış resmî YOLO26n kontrol noktalarına aittir:
| Görev | Varsayılan imgsz | nms=None ile çıktı | nms=False veya nms=True ile çıktı |
|---|---|---|---|
| Detect | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segment | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Anlamsal | 1024 | output0 (1, 1024, 1024), her piksel için sınıf indeksi uint8 | nms=None ile aynı |
| Derinlik | 768 | output0 (1, 1, 768, 768), derinlik haritası | nms=None ile aynı |
| Sınıflandırma | 224 | output0 (1, 1000), softmax sonrası sınıf olasılıkları | nms=False için nms=None ile aynı; nms=True hata verir |
| Poz | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 kutu değeri, ardından 17 anahtar nokta x 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (radyan) |
Segmentasyon satırlarında kutu değerlerinden sonra 32 maske katsayısı bulunur ve output1 maske prototiplerini içerir. FP32 ve INT8 modellerinde anlamsal sınıf haritası dışındaki tüm çıktılar float32 türündedir.
nms=True ile güven eşiği conf (varsayılan 0.25), IoU eşiği iou (varsayılan 0.5), agnostic_nms ve max_det (varsayılan 300) dışa aktarma sırasında grafikte sabitlenir. Tahmin sırasında daha düşük bir conf değeri, grafiğin zaten kaldırdığı tespitleri geri getiremez; bu değerleri değiştirmek için modeli yeniden dışa aktar. max_det ve agnostic_nms, nms=False için de geçerlidir: max_det=100, (1, 100, 6) şeklinde output0 üretir.
YOLO("yolo26n.onnx"), düzeni dosya meta verilerinden okur; bu nedenle şekillere yalnızca modeli kendi kodunda çalıştırırken ihtiyacın olur. Meta veriler, kodun tarafından şu dizeler olarak da kullanılabilir: names, task, imgsz, stride, batch, end2end ve args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Dağıt#
YOLO("yolo26n.onnx"), modeli ONNX Runtime ile çalıştırır ve yürütme sağlayıcısını device bağımsız değişkeninden seçer. CUDA GPU'su olan bir makinede device ayarlanmamışsa GPU kullanılır.
device | Yürütme sağlayıcısı |
|---|---|
cpu | CPUExecutionProvider |
NVIDIA GPU'sunda 0 | İlk kullanımda yüklenen onnxruntime-gpu paketinden gelen CUDAExecutionProvider |
AMD ROCm GPU'sunda 0 | MIGraphXExecutionProvider, MIGraphX ile AMD GPU Çıkarımı bölümüne bak |
Apple silicon'da mps | Statik şekilli düğümler için CoreMLExecutionProvider; dinamik şekilli düğümler CPUExecutionProvider üzerinde çalışır |
Using ONNX Runtime 1.31.1 with CUDAExecutionProvider günlük satırı, hangi sağlayıcının etkin olduğunu gösterir. Çıkarım sırasındaki davranış, modelin nasıl dışa aktarıldığına bağlıdır:
- Statik dışa aktarma (varsayılan): model her zaman dışa aktarma sırasında belirlenen
imgszvebatchdeğerleriyle çalışır; Ultralytics bu değerleri dosya meta verilerinden okur.predictöğesine geçirilenimgszyok sayılır. Daha büyük toplu işler dışa aktarma toplu iş boyutundaki parçalara bölünür, daha küçük toplu işler ise doldurulur; böylece herhangi sayıda görüntü çalıştırılabilir. - Dinamik dışa aktarma (
dynamic=True):predict, model adımının katı olan herimgszdeğerini kabul eder. Toplu iş boyutu değişebilir; ancaknms=Trueile dışa aktarma sırasında kullanılanbatchdeğeriyle sınırlıdır. Bu nedenle bu değeri çalıştırmayı planladığın en büyük toplu iş boyutuna ayarla. - GPU belleği:
CUDAExecutionProviderile statik bir model, girdi ve çıktı tensörlerini GPU'da tutan ONNX Runtime IO binding'i kullanır. Dinamik bir model ise her çağrıda bunları CPU belleğinden kopyalar. - CPU iş parçacıkları: Ultralytics, ONNX Runtime'ı 8 işlem içi iş parçacığıyla veya işlem için kullanılabilir fiziksel CPU çekirdeği sayısı bundan düşükse bu sayıyla sınırlar. Farklı bir sayı kullanmak için
ORT_INTRA_OP_NUM_THREADSortam değişkenini ayarla.
ONNX Runtime yerine OpenCV DNN ile modeli CPU'da çalıştırmak için dnn=True öğesini predict veya val öğesine geçir. OpenCV DNN daha az dışa aktarma seçeneğini destekler; Sınırlamalar ve Sorun Giderme bölümüne bak.
Modeli Ultralytics paketi dışında çalıştırmak için şu kaynaklara bak:
- ONNX Runtime Python API'si: Python'da bir ONNX modelini yükle ve çalıştır.
- ONNX Runtime yürütme sağlayıcıları: CUDA, TensorRT, OpenVINO, Core ML ve DirectML gibi donanım arka uçları.
- Ultralytics örnekleri: Python, C++ ve Rust ile ONNX Runtime çıkarımı ve Python ile OpenCV DNN çıkarımı.
- Triton Inference Server: NVIDIA Triton ile ONNX modelini HTTP veya gRPC üzerinden sun.
- Uç cihazlara dağıtım: IoT ve uç donanımlar için ONNX Runtime öğreticileri.
Windows ML Çıkarımı#
Windows 11 24H2 (build 26100) veya daha yeni bir sürümde Python 3.10+ ile, donanımın için Windows ML yürütme sağlayıcılarını seçebilsin diye onnxruntime-windowsml paketini ayrı bir ortama yükleyebilirsin. Diğer ONNX Runtime derlemeleri yerine bunu yükle, ardından aynı dışa aktarılmış .onnx modelini YOLO("model.onnx") ile kullan. Arka uç, PyTorch iş parçacığı sayısını ve açıkça belirtilmiş bir sağlayıcı politikası da dâhil olmak üzere, sağlanan oturum seçeneklerini korur. Bir politika sağlanmadığında Windows ML, PyTorch aygıtı cpu olsa bile en yüksek performansı elde etmek için donanımı seçer. Bu çalışma zamanını seçmeden önce aygıtındaki tahmin gecikmesini ölç; bu çalışma zamanı isteğe bağlıdır ve varsayılan olarak yüklenmez.
CPU ile gücü paylaşan tümleşik GPU'larda, ön işleme ve son işlemedeki boşta kalan PyTorch iş parçacıkları Windows ML çıkarımını yavaşlatabilir. Bunu azaltmak için tahmin yapmadan önce torch.set_num_threads(1) işlevini çağır. Bu ayar sürecin tamamına uygulanır; dolayısıyla aynı süreçteki diğer PyTorch modelleri de tek iş parçacığında çalışır.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # isteğe bağlı, kendi aygıtında ölç
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
MIGraphX ile AMD GPU Çıkarımı#
Ultralytics, dışa aktarılan ONNX modellerini AMD GPU'larında ONNX Runtime'ın MIGraphX yürütme sağlayıcısı üzerinden çalıştırır. x86-64 mimarisinde Python 3.11 veya üzeri sürümün bulunduğu ROCm (HIP) sisteminde ONNX arka ucu ilk kullanımda onnxruntime-ep-migraphx eklentisini yükler ve kod değişikliği gerektirmeden MIGraphXExecutionProvider öğesini otomatik seçer; YOLO26 görevlerinin tümü desteklenir. Ön koşullar, kurulum, kullanım, karşılaştırmalar ve derlenmiş program önbelleği için AMD GPU çıkarım kılavuzuna bak.
Sınırlamalar ve Sorun Giderme#
- En düşük opset:
opsetmodel için çok düşük olduğunda dışa aktarmaONNX export requires opset>=Nhatasıyla başarısız olur. En düşük değer sınıflandırma için7, nesne tespiti, segmentasyon, anlamsal segmentasyon, poz ve OBB için9, derinlik tahmini ilenms=Truekullanılarak dışa aktarılan nesne tespiti, segmentasyon, poz ve OBB modelleri için11, RT-DETR için16değeridir. - FP16 girdileri: GPU'da dışa aktarılan bir FP16 model (
quantize=16 device=0), kendi kodunda FP16 girdi tensörleri bekler. CPU'da dışa aktarılan bir FP16 model, FP32 girdileri ve çıktıları korur ve grafiğin içinde dönüştürme yapar.YOLO(), hem GPU'da hem CPU'da her iki modele de doğru girdi türünü verir. - INT8 dosya adı:
quantize=8,yolo26n_int8.onnxdosyasını yazar ve ara FP32 dosyasını kaldırır; bu nedenle çıkarım için_int8dosyasını yükle.quantize=8ile eğitilmiş bir kontrol noktası istisnadır: dışa aktarma,yolo26n.onnxdosyasına Q/DQ düğümleri yazar ve kalibrasyonu atlar. - INT8 kalibrasyon boyutu:
quantize=8ile eğitilmemiş bir kontrol noktası için kalibrasyon bölümü 300 görüntüden az olduğunda dışa aktarma uyarı verir. Kalibrasyonda varsayılan olarakvalbölümü kullanılır;coco8.yamlyalnızca 4 doğrulama görüntüsü içerdiğinden, dağıtmayı planladığın model için kendi veri kümeni kullan. - Gömülü NMS:
nms=True, PyTorch 1.13 veya üzerini gerektirir. Sınıflandırma için'nms=True' is not valid for classification modelshatası verir; anlamsal segmentasyon, derinlik tahmini ve RT-DETR modellerinde ise uyarı vererek yok sayılır. - NMS'siz başlık:
nms=False, YOLO26 veya YOLOv10 gibi NMS'siz başlığı olan bir model gerektirir. Örneğin YOLO11 gibi diğer modellerde dışa aktarmaThis model has no one-to-one head; using one-to-many outputsuyarısı verir ve ham(1, 84, 8400)çıktısını yazar. - GPU kullanılmıyor: günlükte
CUDA requested but CUDAExecutionProvider not available. Using CPU...görünüyorsa yüklü ONNX Runtime derlemesinde çalışan bir CUDA sağlayıcısı yoktur.onnxruntimeyerineonnxruntime-gpuyükle ve CUDA ile cuDNN sürümlerinin sisteminle eşleştiğini kontrol et. - OpenCV DNN: OpenCV 4.14.0 ile
dnn=True, varsayılan,nms=False, INT8 ve GPU'da dışa aktarılmış FP16 modelleri çalıştırır.nms=Trueile veya CPU'dadynamic=Trueya daquantize=16ile dışa aktarılmış modelleri yükleyemez. - NMS ile dinamik şekiller:
dynamic=Trueöğesininms=Trueile birlikte kullanırkenbatchdeğerini de çalıştırmayı planladığın en büyük toplu iş boyutuna ayarla.batch,1olarak bırakılırsa dışa aktarma uyarı verir. - Grafik sadeleştirme:
onnxslimbaşarısız olursa dışa aktarma bir uyarı kaydeder ve modeli sadeleştirmeden kaydeder. - IR sürümü: dışa aktarıcı, eski ONNX Runtime sürümlerinin dosyayı yükleyebilmesi için ONNX IR sürümünü 10 ile sınırlar. Opset 18 ile varsayılan dışa aktarmanın IR sürümü 8'dir.
Diğer hatalar için Yaygın Sorunlar kılavuzuna bak.
Kıyaslamalar#
YOLO26n, ONNX Runtime ile CPU'da (Intel Xeon CPU @ 2.00 GHz) YOLO11n'den %43'e kadar daha hızlı çalışır. YOLO26 model sayfasında, anlamsal segmentasyon dışındaki tüm görevlerde her modelin CPU ONNX hızı listelenir.
İzle: Ultralytics YOLO26 ve Ultralytics YOLO11 ONNX çıkarım testi | YOLO26 ile yaklaşık %43 daha hızlı çıkarım 🚀
ONNX Runtime ile FP32, FP16 ve INT8#
Aşağıdaki tablolar, ONNX Runtime CUDAExecutionProvider ile çalıştırılan tüm YOLO26 nesne tespiti modellerinin PyTorch, FP32, FP16 ve INT8 ONNX sürümlerini karşılaştırır. GPU değerlerinin tümü tek bir NVIDIA RTX PRO 6000 Blackwell Server Edition GPU'sunda ölçülmüştür.
Görüntü başına milisaniye; düşük değer daha iyidir. Her model için en hızlı biçim kalın yazılmıştır.
| Model | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
CPU'da YOLO26n (AMD EPYC 9655, PyTorch ve ONNX Runtime'ın her biri 8 iş parçacığında; YOLO26 model tablolarında kullanılandan farklı bir CPU):
| Ölçüt | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Gecikme (ms/görüntü) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16, dosya boyutunu yarıya indirdi; doğruluk FP32'den 0.1 mAP'ten az farklıydı. GPU'da FP32'den 1.4 kata kadar hızlı çalıştı, ancak CPU'da hız artışı sağlamadı.
- INT8 en küçük dosyayı sağladı, ancak doğruluk 2.2 ila 3.0 mAP düştü ve hem GPU'da hem de CPU'da FP32'den daha yavaş çalıştı.
13 Kasım 2026'da batch=1 konumunda ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 ve CUDA 13.2 ile ölçülmüştür. Gecikme, val tarafından raporlanan çıkarım aşamasını ifade eder; ön işleme veya son işlemeyi içermez.
ONNX Hakkında#
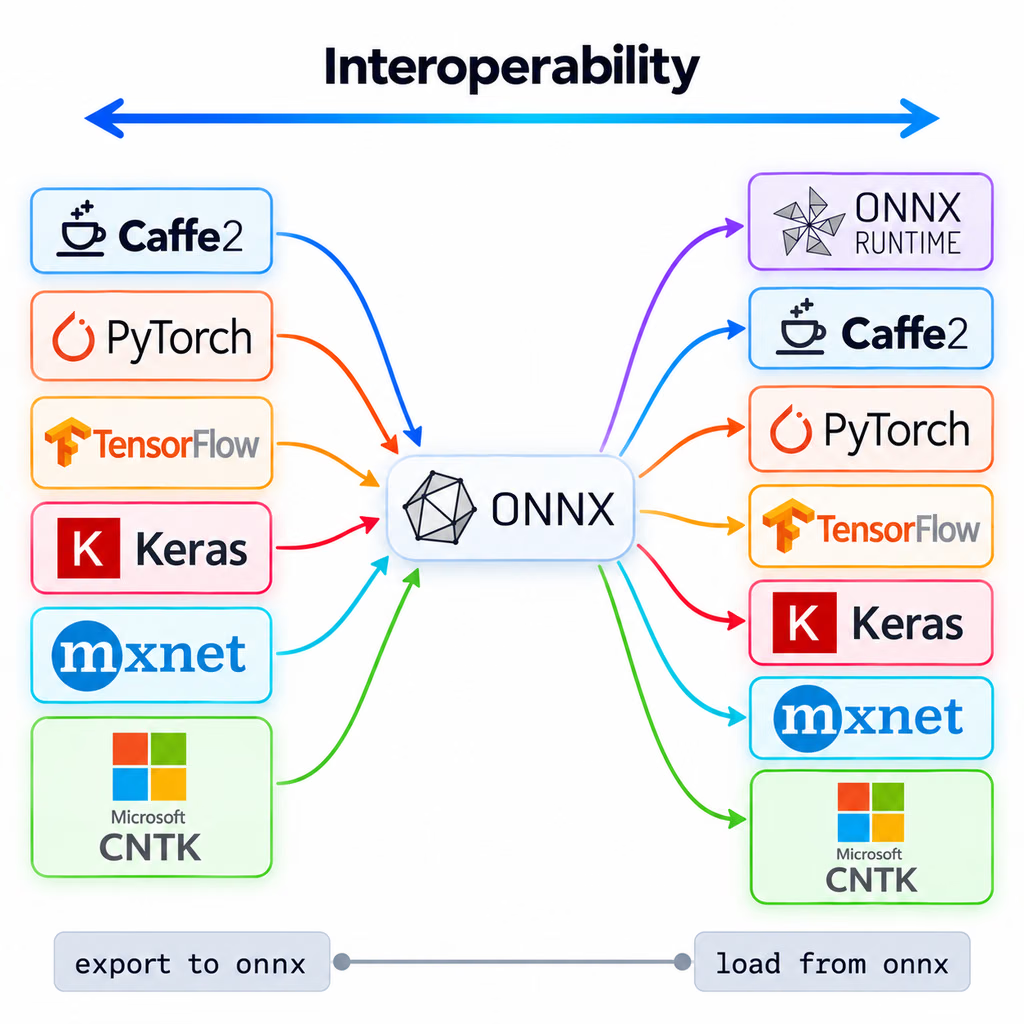
ONNX, Facebook ve Microsoft'un başlattığı, günümüzde IBM, Amazon ve Google gibi kuruluşlarla geliştirilen bir topluluk projesidir. Makine öğrenimi modelleri için ortak bir operatör kümesi ve dosya biçimi tanımlar; böylece PyTorch gibi bir çerçevede eğitilen model, birçok çalışma ortamında ve donanım platformunda çalışabilir.
ONNX Runtime, ONNX modelleri için platformlar arası bir çıkarım motorudur. Yürütme sağlayıcıları, modeli CPU'larda, GPU'larda ve özel hızlandırıcılarda çalıştırmak için donanıma özgü kütüphaneleri kullanır.
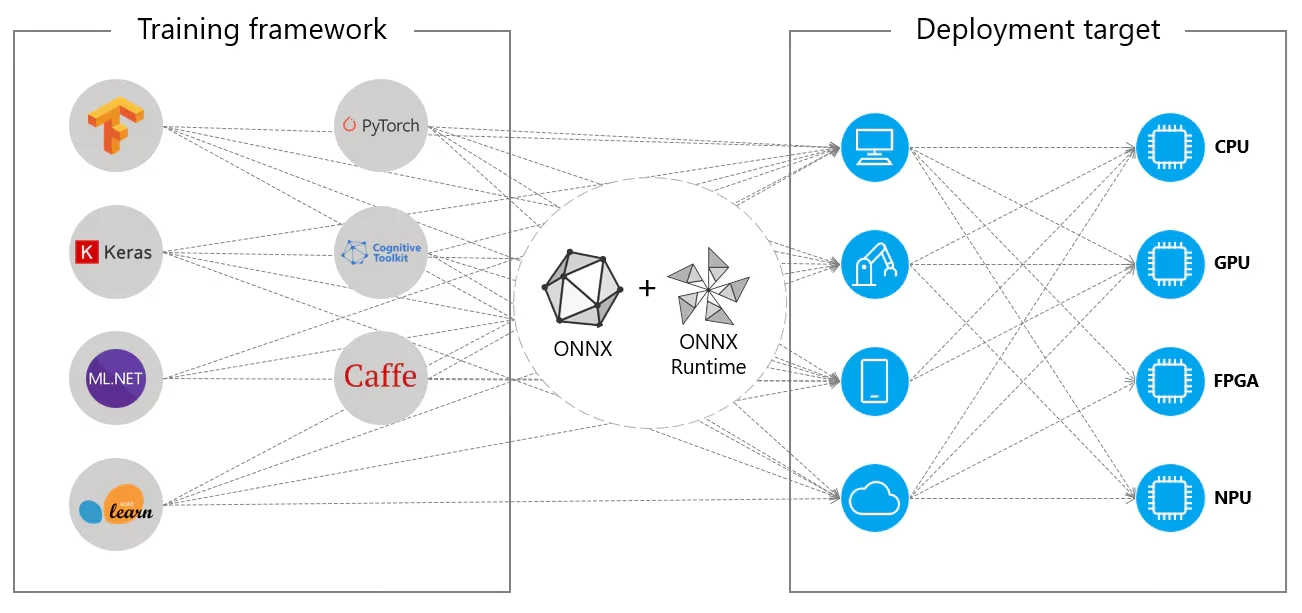
ONNX ayrıca TensorRT dahil diğer Ultralytics dışa aktarma biçimleri için ara adımdır ve Huawei Ascend, Qualcomm QNN ve Rockchip RKNN gibi üreticilerin NPU araç zincirlerine girdi sağlar. Belirtim için ONNX belgelerine bak.
Sık Sorulan Sorular#
Çalışma ortamın belirli bir sürüm gerektirmediği sürece
opsetdeğerini ayarlama. Dışa aktarıcı, PyTorch 2.4 ve üzeri sürümlerde opset18, PyTorch 1.13 ile 2.3 arasında opset17, daha eski PyTorch sürümlerinde daha düşük bir opset kullanır ve yüklüonnxpaketinin desteklediğinden daha yüksek bir opset kullanmaz. ONNX Runtime CUDA sağlayıcısı,Resizegibi opset 19 ve üzeri bazı operatörleri CPU'da çalıştırdığından varsayılan değer 18'de kalır. Eski bir çalışma ortamı veya dönüştürücü varsayılanı reddediyorsa daha düşük bir değer (örneğinopset=12) ayarla. Değer, modelin minimum opset değerinden düşük olamaz.Bu, dışa aktarırken kullandığın
nmsbağımsız değişkenine bağlıdır. Varsayılan dışa aktarma, güven eşiği uygulaması ve NMS gerektiren ham tahminler döndürür.nms=Falseveyanms=Trueile yapılan dışa aktarma, her görüntü için giriş görüntüsünün piksel koordinatlarındax1, y1, x2, y2, score, classolarak en fazlamax_det(varsayılan 300) nihai tespit döndürür; bu nedenle yalnızca puana göre filtreleme yapıp kutuları özgün görüntüye göre ölçeklendirmen yeterlidir. OBB satırları, köşeler yerinecenter x, center y, width, heightile birlikte açıyı içerir. Boyutlar için Çıktı Biçimi bölümüne bak.ONNX Runtime ile NMS içermeyen çıktıyı oku# Önce dışa aktar: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # nms=False ile dışa aktarıldı image = np.zeros((1, 3, 640, 640), dtype=np.float32) # ön işlenmiş görüntün detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # güven eşiğinin üzerindeki satırları tutdynamic=Truedeğerini ayarla.imagesgirdisi, dinamik toplu iş, yükseklik ve genişlikle(batch, 3, height, width)şeklini alır; varsayılan (nms=None) tespitoutput0ise(batch, 84, anchors)şeklindedir. Böylece çıkarım sırasında aynı dosya farklı toplu iş ve görüntü boyutlarını kabul eder.nms=Trueile toplu iş boyutu, dışa aktarımda kullanılanbatchdeğeriyle sınırlıdır. Yükseklik ve genişlik, sınıflandırma dışındaki resmî YOLO26 kontrol noktalarında 32 olan model stride değerinin katları olmalıdır. Dinamik bir model CUDA'da IO binding kullanmaz ve OpenCV DNN ile yüklenmez; bu nedenle giriş boyutu sabitse varsayılan statik dışa aktarma ayarını kullan.Dinamik dışa aktarmafrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Tek bir dosyanın farklı donanımlarda çalışması gerekiyorsa veya dağıtım makinesi dışa aktarma yaptığın makineden farklıysa ONNX kullan. Belirli bir NVIDIA GPU'da en düşük gecikme için TensorRT kullan: TensorRT motoru tek bir GPU mimarisi ve TensorRT sürümü için oluşturulur ve taşınabilir değildir. Diğer hedefler için model dağıtım seçenekleri kılavuzuna bak.


Yorumlar77
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(düzenlendi)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(düzenlendi)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(düzenlendi)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
