Bộ dữ liệu Caltech-256#
Bộ dữ liệu Caltech-256 là một benchmark phân loại ảnh kinh điển gồm 30.607 ảnh thuộc 256 danh mục đối tượng cùng một lớp nền. Mỗi danh mục có ít nhất 80 ảnh về các đối tượng trong đời thực — động vật, phương tiện, đồ gia dụng và con người — khiến đây trở thành phiên bản kế nhiệm lớn hơn, thách thức hơn của Caltech-101 dành cho các model nhận dạng đối tượng.
Khám phá Caltech-256 trên Ultralytics Platform để xem trước các mẫu, kiểm tra số liệu thống kê của bộ dữ liệu và sao chép bộ dữ liệu để huấn luyện.
Caltech-256 không có phân chia sẵn giữa tập huấn luyện và validation. Các lệnh huấn luyện bên dưới sẽ tự động chia bộ dữ liệu theo tỷ lệ 80% huấn luyện / 20% validation, không cần chuẩn bị thủ công.
Tính năng chính#
- Caltech-256 chứa 30.607 ảnh màu thuộc 256 danh mục đối tượng cùng một lớp nền
257.clutter(tổng cộng 257 thư mục lớp). - Các danh mục bao gồm nhiều loại đối tượng trong thế giới thực, như động vật, phương tiện, đồ gia dụng và con người.
- Mỗi danh mục có ít nhất 80 ảnh, trong đó danh mục lớn nhất có khoảng 800 ảnh, nên số lượng ảnh giữa các lớp không cân bằng.
- Kích thước và độ phân giải ảnh không đồng nhất.
- Caltech-256 được sử dụng rộng rãi để đánh giá chuẩn các thuật toán phân loại ảnh và nhận dạng đối tượng.
Cấu trúc dataset#
Caltech-256 được phân phối dưới dạng 257 thư mục — mỗi lớp một thư mục, bao gồm 256 danh mục đối tượng cùng một lớp nền 257.clutter — và không có phân chia sẵn giữa tập huấn luyện và validation. Khi bắt đầu huấn luyện, Ultralytics tự động phân chia ảnh để model được huấn luyện trên cả 257 lớp mà không cần thiết lập thủ công:
- Số lớp: 257 (256 danh mục đối tượng + 1 lớp nền)
- Tổng số ảnh: 30.607
- Phân chia huấn luyện/validation: tự động 80% / 20% (≈24.385 ảnh huấn luyện, ≈6.222 ảnh validation)
- Số ảnh mỗi lớp: ít nhất 80 (không cân bằng, tối đa khoảng 800)
Ứng dụng#
Bộ dữ liệu Caltech-256 được sử dụng rộng rãi để huấn luyện và đánh giá các model phân loại ảnh và nhận dạng đối tượng, bao gồm Mạng nơ-ron tích chập (CNNs) và Máy vector hỗ trợ (SVMs). Số lượng danh mục lớn và ảnh chất lượng cao khiến bộ dữ liệu này trở thành benchmark phổ biến cho nghiên cứu và tạo mẫu machine learning và thị giác máy tính.
Cách sử dụng#
Huấn luyện model YOLO trên Caltech-256 trong 100 epoch với kích thước ảnh là 416. Để xem danh sách đầy đủ các tham số hiện có, hãy tham khảo trang Huấn luyện và hướng dẫn tác vụ phân loại ảnh.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-cls.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model
results = model.train(data="caltech256", epochs=100, imgsz=416)
Hình ảnh mẫu và annotation#
Bộ dữ liệu Caltech-256 chứa các ảnh màu chất lượng cao về nhiều đối tượng khác nhau, tạo nên bộ dữ liệu có cấu trúc tốt cho các tác vụ phân loại ảnh. Dưới đây là một số ảnh ví dụ từ bộ dữ liệu (nguồn ảnh):
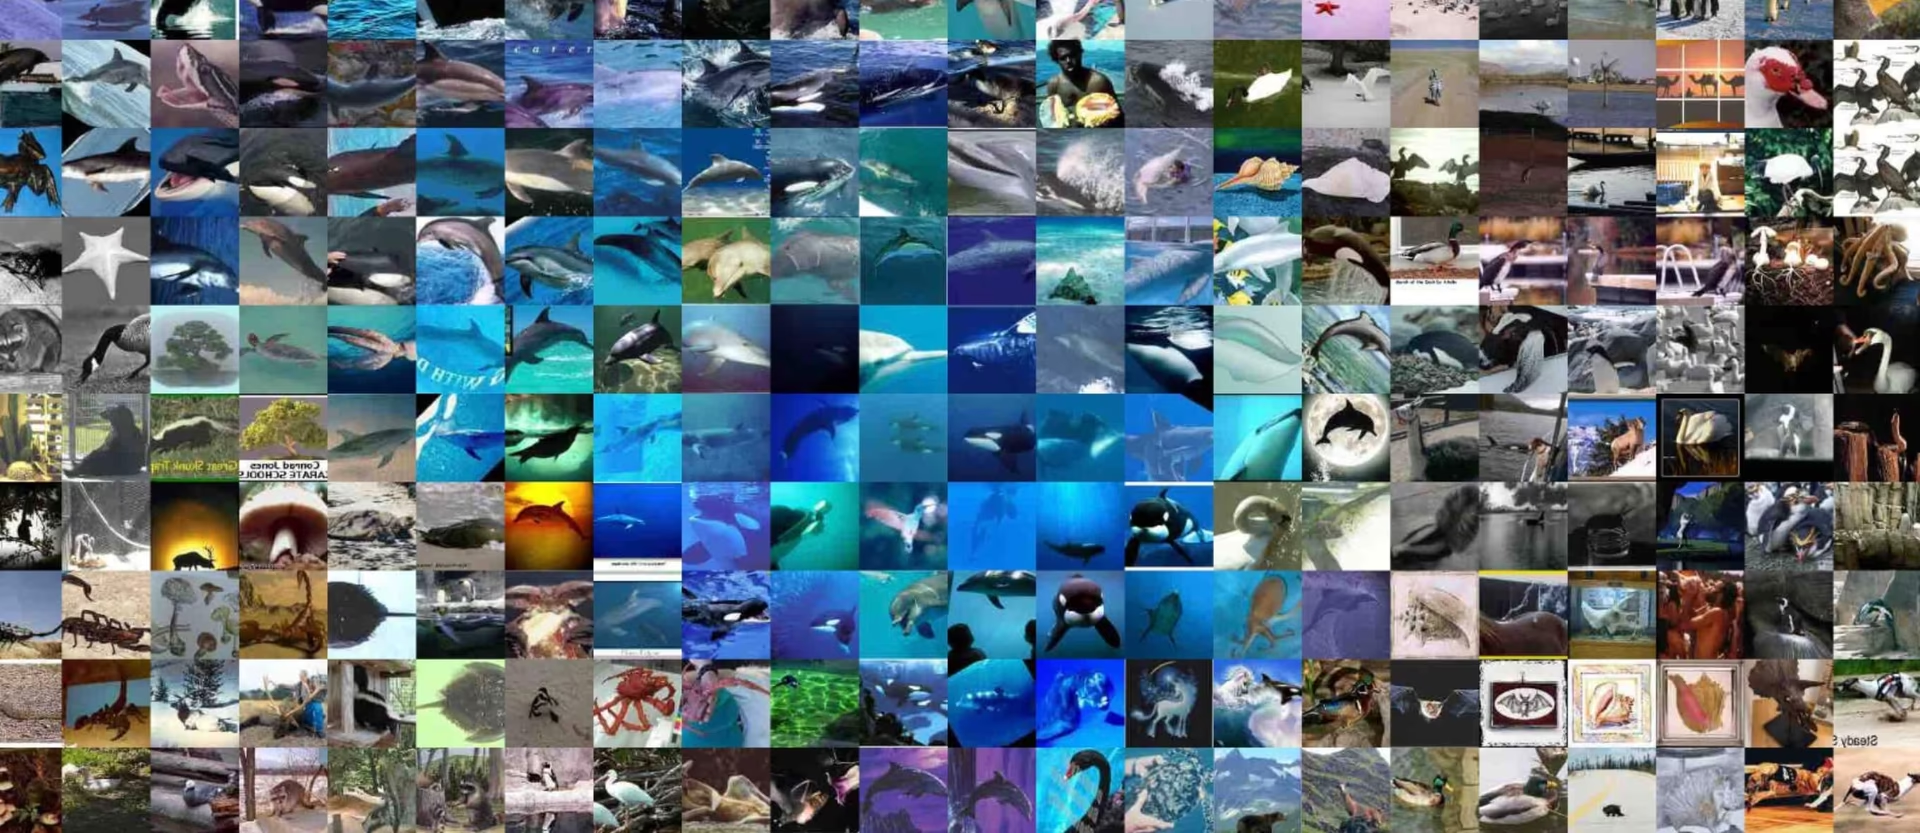
Các mẫu cho thấy sự đa dạng và phức tạp của các đối tượng trong bộ dữ liệu Caltech-256, nhấn mạnh giá trị của một bộ dữ liệu đa dạng trong việc huấn luyện các model nhận dạng đối tượng mạnh mẽ.
Trích dẫn và lời cảm ơn#
Nếu sử dụng bộ dữ liệu Caltech-256 trong nghiên cứu hoặc công việc phát triển, vui lòng trích dẫn bài báo sau:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Chúng tôi xin ghi nhận công lao của Gregory Griffin, Alex Holub và Pietro Perona trong việc tạo và duy trì bộ dữ liệu Caltech-256 như một tài nguyên quý giá cho cộng đồng nghiên cứu machine learning và thị giác máy tính. Để biết thêm thông tin về bộ dữ liệu Caltech-256 và những người tạo ra bộ dữ liệu, hãy truy cập trang web bộ dữ liệu Caltech-256.
Câu hỏi thường gặp#
Bộ dữ liệu Caltech-256 được sử dụng rộng rãi để huấn luyện và đánh giá chuẩn các model phân loại ảnh và nhận dạng đối tượng. Bộ dữ liệu này chứa 30.607 ảnh thuộc 256 danh mục đối tượng cùng một lớp nền, tạo nên benchmark lớn hơn và thách thức hơn Caltech-101 để đánh giá các thuật toán như Mạng nơ-ron tích chập (CNNs) và Máy vector hỗ trợ (SVMs).
Để huấn luyện model Ultralytics YOLO trên Caltech-256, hãy sử dụng các đoạn mã bên dưới. Bộ dữ liệu sẽ tự động tải xuống trong lần sử dụng đầu tiên. Để xem danh sách đầy đủ các tham số, hãy tham khảo trang Huấn luyện của model.
Ví dụ huấn luyệnfrom ultralytics import YOLO # Tải model model = YOLO("yolo26n-cls.pt") # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện) # Huấn luyện model results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 có 256 danh mục đối tượng cùng một lớp nền
257.clutter, tổng cộng 257 thư mục lớp và 30.607 ảnh. Khi huấn luyện bằng Ultralytics, model sẽ học cả 257 lớp. Mỗi danh mục có ít nhất 80 ảnh, nhưng số lượng ảnh giữa các lớp không cân bằng; danh mục lớn nhất có khoảng 800 ảnh.Caltech-256 không có phân chia sẵn. Trong lần huấn luyện đầu tiên, Ultralytics tự động chia bộ dữ liệu thành 80% huấn luyện / 20% validation — khoảng 24.385 ảnh huấn luyện và 6.222 ảnh validation — nên bạn không cần tự tạo các tập dữ liệu. Để tự kiểm soát việc phân chia, hãy sắp xếp ảnh vào các thư mục
train/vàval/trước khi huấn luyện.Có. Ultralytics Platform cho phép bạn quản lý bộ dữ liệu, huấn luyện model phân loại ảnh và triển khai model mà không cần viết nhiều mã. Đây là cách thuận tiện để chạy thử nghiệm với Caltech-256 trên cloud; bạn cũng có thể tìm hiểu thêm các tùy chọn trong tổng quan về bộ dữ liệu phân loại của chúng tôi.