Bộ dữ liệu CIFAR-10#
Bộ dữ liệu CIFAR-10 (Viện Nghiên cứu Tiên tiến Canada) là một benchmark kinh điển cho phân loại ảnh, gồm 60.000 ảnh màu 32x32 được chia đều thành 10 lớp — máy bay, ô tô, chim, mèo, hươu, chó, ếch, ngựa, tàu thủy và xe tải. Bộ dữ liệu đi kèm với phân chia được định nghĩa sẵn gồm 50.000 ảnh huấn luyện và 10.000 ảnh kiểm tra (6.000 ảnh cho mỗi lớp), là điểm khởi đầu gọn nhẹ, cân bằng tốt để huấn luyện và benchmark các model phân loại. Để có thử thách chi tiết hơn, hãy xem bộ dữ liệu CIFAR-100 liên quan.
Khám phá CIFAR-10 trên Ultralytics Platform để xem trước các mẫu, kiểm tra thống kê bộ dữ liệu và clone bộ dữ liệu để huấn luyện.
Tính năng chính#
- CIFAR-10 chứa 60.000 ảnh màu có kích thước 32x32 pixel, được chia đều thành 10 lớp.
- Mỗi lớp chứa chính xác 6.000 ảnh — 5.000 ảnh dùng để huấn luyện và 1.000 ảnh dùng để kiểm tra — vì vậy bộ dữ liệu hoàn toàn cân bằng.
- 10 lớp gồm máy bay, ô tô, chim, mèo, hươu, chó, ếch, ngựa, tàu thủy và xe tải.
- Bộ dữ liệu đi kèm với phân chia train/test được định nghĩa sẵn, nên không cần phân chia thủ công hoặc tự động.
- CIFAR-10 là benchmark tiêu chuẩn cho nghiên cứu phân loại ảnh và nhận dạng đối tượng.
Cấu trúc bộ dữ liệu#
CIFAR-10 đi kèm với phân chia chính thức được định nghĩa sẵn, nên không cần phân vùng tự động hoặc thủ công:
- Các lớp: 10 (máy bay, ô tô, chim, mèo, hươu, chó, ếch, ngựa, tàu thủy, xe tải)
- Tổng số ảnh: 60.000 (màu 32x32)
- Tập huấn luyện: 50.000 ảnh (5.000 ảnh cho mỗi lớp)
- Tập kiểm tra: 10.000 ảnh (1.000 ảnh cho mỗi lớp)
CIFAR-10 không có thư mục validation riêng, vì vậy Ultralytics mặc định sử dụng tập kiểm tra gồm 10.000 ảnh làm tập validation trong quá trình huấn luyện.
Ứng dụng#
CIFAR-10 được sử dụng rộng rãi để huấn luyện và đánh giá các model phân loại ảnh, từ Mạng nơ-ron tích chập (CNNs) và Máy vector hỗ trợ (SVMs) kinh điển đến các kiến trúc deep learning hiện đại. Kích thước ảnh nhỏ và các lớp cân bằng khiến bộ dữ liệu này trở nên lý tưởng cho thử nghiệm nhanh, benchmark các thuật toán mới và giảng dạy các nền tảng về thị giác máy tính.
Cách sử dụng#
Huấn luyện một model YOLO trên CIFAR-10 trong 100 epoch với kích thước ảnh là 32. Để xem danh sách đầy đủ các argument khả dụng, hãy xem trang Huấn luyện và hướng dẫn tác vụ phân loại ảnh.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar10", epochs=100, imgsz=32)
Hình ảnh mẫu và annotation#
Bộ dữ liệu CIFAR-10 chứa các ảnh màu của nhiều đối tượng khác nhau, cung cấp một bộ dữ liệu có cấu trúc tốt cho các tác vụ phân loại ảnh. Dưới đây là một số ví dụ về ảnh trong bộ dữ liệu:
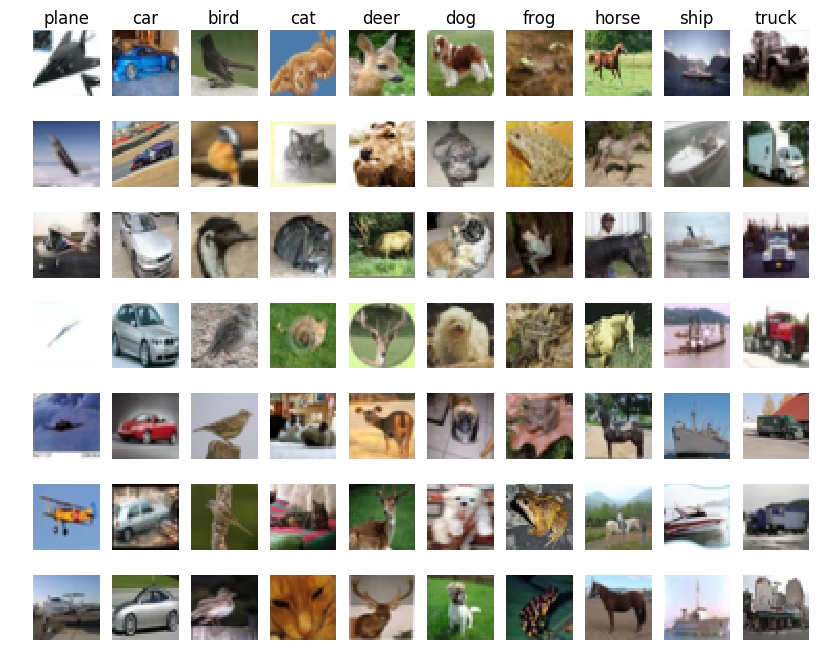
Các mẫu cho thấy sự đa dạng của các đối tượng trong bộ dữ liệu CIFAR-10, nhấn mạnh giá trị của một bộ dữ liệu đa dạng trong việc huấn luyện các model phân loại ảnh có độ tin cậy cao.
Trích dẫn và ghi nhận đóng góp#
Nếu sử dụng bộ dữ liệu CIFAR-10 trong công trình nghiên cứu hoặc phát triển, vui lòng trích dẫn bài báo sau:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Chúng tôi xin ghi nhận công lao của Alex Krizhevsky trong việc tạo và duy trì bộ dữ liệu CIFAR-10 như một tài nguyên có giá trị cho cộng đồng nghiên cứu machine learning và thị giác máy tính. Để biết thêm thông tin về bộ dữ liệu CIFAR-10 và người tạo ra nó, hãy truy cập website bộ dữ liệu CIFAR-10.
FAQ#
Bộ dữ liệu CIFAR-10 được sử dụng rộng rãi để huấn luyện và benchmark các model phân loại ảnh và nhận dạng đối tượng. Bộ dữ liệu chứa 60.000 ảnh màu 32x32 được phân bổ đều trên 10 lớp, và kích thước nhỏ cùng các lớp cân bằng khiến đây trở thành benchmark nhanh, đáng tin cậy cho các thuật toán như mạng nơ-ron tích chập (CNNs) và Máy vector hỗ trợ (SVMs).
Để huấn luyện model Ultralytics YOLO trên CIFAR-10, hãy sử dụng các đoạn code bên dưới. Bộ dữ liệu sẽ tự động được tải xuống trong lần sử dụng đầu tiên. Để xem danh sách đầy đủ các argument, hãy xem trang Huấn luyện của model.
Ví dụ huấn luyệnfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar10", epochs=100, imgsz=32)CIFAR-10 có 10 lớp — máy bay, ô tô, chim, mèo, hươu, chó, ếch, ngựa, tàu thủy và xe tải — với chính xác 6.000 ảnh cho mỗi lớp, tổng cộng 60.000 ảnh. Các lớp loại trừ lẫn nhau và hoàn toàn cân bằng, không có sự chồng lấn giữa các danh mục.
CIFAR-10 đi kèm với phân chia được định nghĩa sẵn gồm 50.000 ảnh huấn luyện và 10.000 ảnh kiểm tra, với chính xác 5.000 ảnh huấn luyện và 1.000 ảnh kiểm tra cho mỗi lớp. Không giống các bộ dữ liệu phân loại dựa trên thư mục được Ultralytics tự động chia, phân vùng chính thức của CIFAR-10 được sử dụng nguyên trạng, và tập kiểm tra mặc định đóng vai trò là tập validation trong quá trình huấn luyện.
Có. Ultralytics Platform cho phép bạn quản lý bộ dữ liệu, huấn luyện các model phân loại ảnh và triển khai chúng mà không cần viết nhiều code. Đây là một cách thuận tiện để chạy các thử nghiệm CIFAR-10 trên cloud, và bạn có thể khám phá thêm các tùy chọn trong tổng quan về các bộ dữ liệu phân loại của chúng tôi.