Tập dữ liệu TT100K#
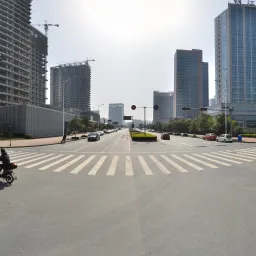
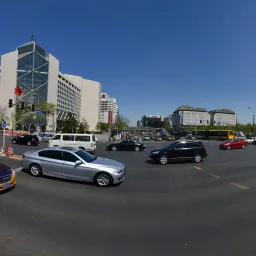
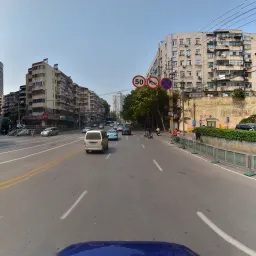
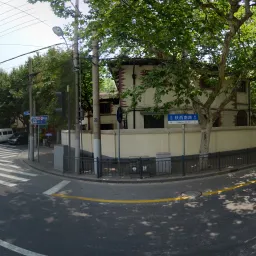
Tập dữ liệu Tsinghua-Tencent 100K (TT100K) là benchmark biển báo giao thông dành cho phát hiện đối tượng, do Zhu và cộng sự tạo cho bài báo CVPR 2016 Phát hiện và phân loại biển báo giao thông trong môi trường thực tế. Cấu hình TT100K của Ultralytics cung cấp 16.817 ảnh (6.105 huấn luyện / 7.641 validation / 3.071 test) thuộc 221 danh mục biển báo giao thông, trong khi benchmark nguồn báo cáo có hơn 30.000 biển báo. “100K” trong tên gọi chỉ khoảng 100.000 ảnh Tencent Street View được dùng để tạo benchmark — không phải số ảnh bạn tải xuống và dùng để huấn luyện. Vì bài báo gốc chỉ giữ lại các danh mục có ít nhất 100 mẫu huấn luyện, nên có một tập con 45 class thường được sử dụng; tuy nhiên, cấu hình Ultralytics giữ lại toàn bộ 221 danh mục được gán nhãn (nhiều danh mục có rất ít mẫu).
Hình ảnh chế độ xem đường phố độ phân giải cao ghi lại những biến thiên lớn về ánh sáng, thời tiết, góc nhìn và khoảng cách, khiến TT100K trở thành benchmark đầy thách thức cho phát hiện đối tượng nhỏ trong các cảnh giao thông thực tế.
Tính năng chính#
- Phát hiện đa class: 221 danh mục biển báo giao thông bao gồm biển giới hạn tốc độ, biển cấm, biển cảnh báo, biển giới hạn chiều cao/chiều rộng và biển chỉ dẫn của Trung Quốc.
- Độ phân giải cao: Ảnh 2048×2048 pixel, với biển báo có kích thước từ lớn, chụp cận cảnh đến nhỏ li ti ở xa, gây áp lực cho khả năng phát hiện chi tiết.
- Điều kiện thực tế: Biến thiên lớn về thời tiết, ánh sáng, góc nhìn và hiện tượng che khuất.
- Chú giải bounding box: Sau khi tự động chuyển đổi, mỗi biển báo được gán nhãn class và bounding box theo định dạng YOLO.
- Các tập chia được xác định trước: Các tập train / val / test cố định (6.105 / 7.641 / 3.071 ảnh) để đánh giá nhất quán.
Cấu trúc dataset#
Cấu hình TT100K của Ultralytics được chia thành ba tập con, tất cả đều dùng chung 221 danh mục:
| Tập dữ liệu | Hình ảnh | Mô tả |
|---|---|---|
| Huấn luyện | 6,105 | Ảnh cảnh giao thông được gán nhãn, dùng để huấn luyện bộ phát hiện |
| Validation | 7,641 | Tập “other” ban đầu của tập dữ liệu, được dùng để đánh giá |
| Kiểm thử | 3,071 | Ảnh giữ lại để đánh giá cuối cùng model đã huấn luyện |
221 danh mục được tổ chức thành một số nhóm chính:
- Biển giới hạn tốc độ — giới hạn cấm
pl*(ví dụ: pl5–pl120) và tốc độ tối thiểupm*(ví dụ: pm5–pm55). - Biển cấm — các lệnh cấm chung
p1–p29, cấm vào/cấm đỗpn/pnevà các hạn chếpr*(pr10–pr100). - Biển cảnh báo —
w1–w67cảnh báo các nguy cơ trên đường như đường giao nhau, khúc cua gấp, đường trơn trượt và công trường. - Biển giới hạn chiều cao/chiều rộng — giới hạn chiều cao
ph*(ví dụ: ph2–ph5.5) và giới hạn chiều rộngpb/pw*. - Biển chỉ dẫn — thông tin chung
i1–i15, thông tin giới hạn tốc độil*(il50–il110), các thông tin kháciovà biển phụ thông tinip.
Ứng dụng#
TT100K được sử dụng rộng rãi để xây dựng và đánh giá chuẩn khả năng nhận dạng biển báo giao thông trong điều kiện thực tế. Các ứng dụng phổ biến bao gồm:
- Hệ thống nhận thức cho xe tự hành
- Hệ thống hỗ trợ người lái nâng cao (ADAS)
- Giám sát giao thông và phân tích hạ tầng đường bộ
- Quy hoạch đô thị và nghiên cứu lưu lượng giao thông
- Nghiên cứu thị giác máy tính về các đối tượng nhỏ trong ảnh độ phân giải cao
YAML của dataset#
Tệp TT100K.yaml định nghĩa cấu hình tập dữ liệu — đường dẫn tập dữ liệu, tên class và script tự động tải xuống, chuyển đổi dữ liệu. Tệp được duy trì trong repository Ultralytics tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
  tt100k2yolo(dir)
Cách sử dụng#
TT100K được tải xuống tự động trong lần đầu huấn luyện và cần khoảng 18 GB dung lượng đĩa trống. Trong lần sử dụng đầu tiên, script tải xuống sẽ lấy dữ liệu gốc và chuyển đổi chú giải sang định dạng YOLO; quá trình này có thể mất vài phút.
Để huấn luyện model YOLO26n trên tập dữ liệu TT100K trong 100 epoch với kích thước ảnh 640, bạn có thể dùng các đoạn mã sau. Để xem danh sách đầy đủ các tham số hiện có, hãy tham khảo trang Huấn luyện model.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model - tập dữ liệu sẽ tự động tải xuống trong lần chạy đầu tiên
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Để gán nhãn thêm ảnh biển báo giao thông và quản lý các lần chạy huấn luyện TT100K trên trình duyệt, hãy sử dụng Ultralytics Platform.
Dữ liệu mẫu và annotation#
Ảnh TT100K là các cảnh đường phố có độ phân giải 2048×2048, trong đó biển báo giao thông thường chỉ chiếm một phần nhỏ của khung hình. Một ảnh có thể chứa nhiều biển báo ở các tỷ lệ và khoảng cách khác nhau; một số biển bị xe cộ, cây cối hoặc công trình che khuất một phần, đồng thời được chụp trong điều kiện ngày/đêm và trời quang/mưa. Sự kết hợp giữa các vật thể nhỏ và điều kiện khó khăn này khiến bộ dữ liệu trở thành phép thử hiệu quả về độ bền vững của bộ phát hiện.
Trích dẫn và lời cảm ơn#
Nếu sử dụng bộ dữ liệu TT100K trong nghiên cứu hoặc công việc phát triển, vui lòng trích dẫn bài báo sau:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Chúng tôi xin ghi nhận sự hợp tác giữa Đại học Thanh Hoa và Tencent trong việc tạo và duy trì tài nguyên giá trị này cho cộng đồng thị giác máy tính và lái xe tự hành. Để biết thêm thông tin về bộ dữ liệu TT100K, hãy truy cập trang web chính thức của bộ dữ liệu.
Câu hỏi thường gặp#
Bộ dữ liệu Tsinghua-Tencent 100K (TT100K) được sử dụng để phát hiện và phân loại biển báo giao thông trong điều kiện thực tế. Với 221 danh mục và ảnh góc nhìn đường phố độ phân giải cao, bộ dữ liệu này thường được dùng làm benchmark cho nhận thức trong lái xe tự hành, hệ thống hỗ trợ lái xe tiên tiến (ADAS) và nghiên cứu phát hiện vật thể nhỏ.
Cấu hình TT100K của Ultralytics có 16,817 ảnh: 6,105 ảnh huấn luyện, 7,641 ảnh validation (phần chia "other" ban đầu của bộ dữ liệu) và 3,071 ảnh kiểm thử. Xem mục Cấu trúc bộ dữ liệu để biết thông tin phân chia đầy đủ.
"100K" chỉ khoảng 100.000 ảnh Tencent Street View được dùng làm nguồn tạo benchmark ban đầu. Cấu hình phát hiện của Ultralytics cung cấp 16,817 ảnh trong số đó với nhãn định dạng YOLO; tên gọi phản ánh bộ sưu tập nguồn, không phải kích thước tập huấn luyện.
TT100K định nghĩa 221 danh mục bao gồm biển giới hạn tốc độ, biển cấm, biển cảnh báo, biển giới hạn chiều cao/chiều rộng và biển chỉ dẫn. Bài báo gốc chỉ giữ lại 45 danh mục có ít nhất 100 mẫu huấn luyện, nhưng cấu hình Ultralytics giữ lại cả 221 danh mục. Xem Cấu trúc bộ dữ liệu để biết thông tin phân nhóm.
TT100K có dung lượng khoảng 18 GB và tự động tải xuống khi bạn huấn luyện lần đầu bằng
data="TT100K.yaml"— không cần tải xuống thủ công. Script cũng chuyển đổi annotation gốc sang định dạng YOLO trong lần chạy đầu tiên.Huấn luyện model YOLO26n trên TT100K trong 100 epoch với kích thước ảnh 640:
Ví dụ huấn luyệnfrom ultralytics import YOLO # Tải model model = YOLO("yolo26n.pt") # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện) # Huấn luyện model results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Để xem cấu hình chi tiết, hãy tham khảo trang Huấn luyện và mẹo huấn luyện model.
Bắt đầu với
imgsz=640để thực hiện các thử nghiệm ban đầu, sau đó tăng lênimgsz=1280(vớibatchnhỏ hơn) nếu GPU có đủ bộ nhớ, vì độ phân giải cao hơn giúp nhận diện các biển báo nhỏ ở xa:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # độ phân giải cao hơn cho biển báo nhỏBạn cũng có thể tinh chỉnh tăng cường dữ liệu và cân nhắc các chiến lược chia ô cho những vật thể rất nhỏ. Xem Mẹo huấn luyện model để biết thêm.