Dataset xView#
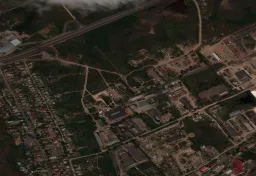
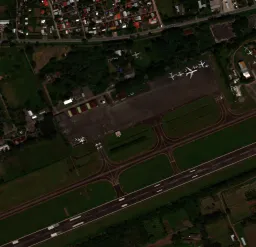
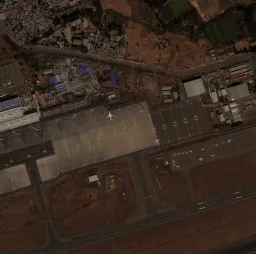
Dataset xView là một trong những benchmark ảnh vệ tinh công khai lớn nhất dành cho phát hiện đối tượng, cung cấp hơn 1 triệu đối tượng thuộc 60 lớp được gán nhãn bằng bounding box trên hơn 1,400 km² ảnh WorldView-3 có độ phân giải 0.3 m. Dataset được Cơ quan Tình báo Địa không gian Quốc gia Hoa Kỳ (NGA) phát hành cho Thử thách DIUx xView 2018 và cần tải xuống thủ công khoảng 20.7 GB.
Dataset được tạo ra nhằm thúc đẩy bốn hướng phát triển của thị giác máy tính:
- Giảm độ phân giải tối thiểu cần thiết để phát hiện.
- Nâng cao hiệu quả học.
- Tạo điều kiện khám phá thêm nhiều lớp đối tượng.
- Nâng cao khả năng phát hiện các lớp có mức độ chi tiết cao.
Dựa trên các benchmark như COCO, xView tập trung vào ảnh chụp từ trên cao, nơi các đối tượng nhỏ hơn nhiều và dày đặc hơn so với ảnh chụp từ mặt đất.
Dataset xView không được tải xuống tự động. Đăng ký trên trang web Thử thách DIUx xView 2018 để tải train_images.zip (~15 GB), train_labels.zip và val_images.zip (~5 GB), sau đó giải nén chúng vào datasets/xView/ sao cho thư mục này chứa:
datasets/xView/
├── train_images/          # 847 TIF satellite images
├── val_images/            # 282 TIF images (no public labels)
└── xView_train.geojson    # bounding-box annotations
Trong lần chạy huấn luyện đầu tiên, Ultralytics tự động chuyển đổi chú thích GeoJSON sang định dạng YOLO và chia các hình ảnh được gán nhãn thành tập huấn luyện và validation theo tỷ lệ khoảng 90/10 — không cần chuyển đổi thủ công.
Tính năng chính#
- Các lớp chi tiết: 60 lớp đối tượng bao gồm máy bay, phương tiện, đầu máy toa xe, tàu thuyền, thiết bị xây dựng và tòa nhà — nhiều lớp có đối tượng nhỏ, hiếm gặp và trông tương tự nhau.
- Độ phân giải cao: khoảng cách lấy mẫu mặt đất 0.3 m, thu thập từ các vệ tinh WorldView-3.
- Chú thích dày đặc: hơn 1 triệu đối tượng trên hơn 1,400 km² ảnh, tất cả đều được gán nhãn bằng bounding box nằm ngang.
- Chuyển đổi tự động: script tải xuống của Ultralytics chuyển đổi nhãn GeoJSON gốc sang định dạng YOLO và tạo tập train/val trong lần sử dụng đầu tiên.
Cấu trúc dataset#
Ảnh xView là các cảnh vệ tinh lớn ở định dạng TIF và chỉ có 847 hình ảnh huấn luyện đi kèm nhãn công khai — tập validation gồm 282 hình ảnh của thử thách không có nhãn. Vì vậy, cấu hình xView.yaml của Ultralytics tự động chia các hình ảnh được gán nhãn trong lần sử dụng đầu tiên:
| Tập dữ liệu | Hình ảnh | Mô tả |
|---|---|---|
| Huấn luyện | ~90% trong số 847 hình ảnh | Các hình ảnh được gán nhãn liệt kê trong autosplit_train.txt, được tạo trong lần chạy đầu tiên |
| Validation | ~10% trong số 847 hình ảnh | Các hình ảnh được gán nhãn liệt kê trong autosplit_val.txt, được dùng để đánh giá |
60 lớp bao gồm các danh mục chi tiết như Máy bay cánh cố định, Máy bay chở hàng, Ô tô cỡ nhỏ, Xe buýt, Đầu máy xe lửa, Tàu thuyền, Máy xúc, Tòa nhà, Nhà chứa máy bay và Bể chứa; xem danh sách đầy đủ trong Dataset YAML bên dưới. Trong quá trình chuyển đổi, ID lớp gốc của thử thách (11–94) được ánh xạ lại thành các chỉ số liên tiếp từ 0–59.
Ứng dụng#
Các lớp chi tiết và góc nhìn từ trên cao có độ phân giải cao của xView khiến dataset này trở thành benchmark tiêu chuẩn để huấn luyện và đánh giá model deep learning trong lĩnh vực viễn thám. Các ứng dụng phổ biến bao gồm:
- Trinh sát quân sự và quốc phòng
- Quy hoạch và phát triển đô thị
- Giám sát môi trường
- Ứng phó và đánh giá thiên tai
- Lập bản đồ và quản lý cơ sở hạ tầng
Để xem các benchmark ảnh chụp từ trên cao khác, hãy tham khảo dataset VisDrone tập trung vào drone hoặc dataset DOTA-v2 sử dụng oriented box.
YAML của dataset#
Tệp xView.yaml định nghĩa cấu hình dataset — đường dẫn dataset, tên của 60 lớp và script tải xuống để chuyển đổi chú thích GeoJSON và tạo tập autosplit. Tệp được duy trì trong repository Ultralytics tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/xView.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DIUx xView 2018 Challenge dataset https://challenge.xviewdataset.org by U.S. National Geospatial-Intelligence Agency (NGA)
# --------  Download and extract data manually to `datasets/xView` before running the train command.  --------
# Documentation: https://docs.ultralytics.com/datasets/detect/xview
# Example usage: yolo train data=xView.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── xView ← downloads here (20.7 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: xView # dataset root dir
train: images/autosplit_train.txt # train images (relative to 'path') 90% of 847 train images
val: images/autosplit_val.txt # val images (relative to 'path') 10% of 847 train images

# Classes
names:
  0: Fixed-wing Aircraft
  1: Small Aircraft
  2: Cargo Plane
  3: Helicopter
  4: Passenger Vehicle
  5: Small Car
  6: Bus
  7: Pickup Truck
  8: Utility Truck
  9: Truck
  10: Cargo Truck
  11: Truck w/Box
  12: Truck Tractor
  13: Trailer
  14: Truck w/Flatbed
  15: Truck w/Liquid
  16: Crane Truck
  17: Railway Vehicle
  18: Passenger Car
  19: Cargo Car
  20: Flat Car
  21: Tank car
  22: Locomotive
  23: Maritime Vessel
  24: Motorboat
  25: Sailboat
  26: Tugboat
  27: Barge
  28: Fishing Vessel
  29: Ferry
  30: Yacht
  31: Container Ship
  32: Oil Tanker
  33: Engineering Vehicle
  34: Tower crane
  35: Container Crane
  36: Reach Stacker
  37: Straddle Carrier
  38: Mobile Crane
  39: Dump Truck
  40: Haul Truck
  41: Scraper/Tractor
  42: Front loader/Bulldozer
  43: Excavator
  44: Cement Mixer
  45: Ground Grader
  46: Hut/Tent
  47: Shed
  48: Building
  49: Aircraft Hangar
  50: Damaged Building
  51: Facility
  52: Construction Site
  53: Vehicle Lot
  54: Helipad
  55: Storage Tank
  56: Shipping container lot
  57: Shipping Container
  58: Pylon
  59: Tower

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  from pathlib import Path
  import shutil

  import numpy as np
  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.data.split import autosplit
  from ultralytics.utils.ops import xyxy2xywhn

  def convert_labels(fname=Path("xView/xView_train.geojson")):
      """Convert xView GeoJSON labels to YOLO format (classes 0-59) and save them as text files."""
      path = fname.parent
      with open(fname, encoding="utf-8") as f:
          print(f"Loading {fname}...")
          data = json.load(f)

      # Make dirs
      labels = path / "labels" / "train"
      shutil.rmtree(labels, ignore_errors=True)
      labels.mkdir(parents=True, exist_ok=True)

      # xView classes 11-94 to 0-59
      xview_class2index = [-1, -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, 0, 1, 2, -1, 3, -1, 4, 5, 6, 7, 8, -1, 9, 10, 11,
                           12, 13, 14, 15, -1, -1, 16, 17, 18, 19, 20, 21, 22, -1, 23, 24, 25, -1, 26, 27, -1, 28, -1,
                           29, 30, 31, 32, 33, 34, 35, 36, 37, -1, 38, 39, 40, 41, 42, 43, 44, 45, -1, -1, -1, -1, 46,
                           47, 48, 49, -1, 50, 51, -1, 52, -1, -1, -1, 53, 54, -1, 55, -1, -1, 56, -1, 57, -1, 58, 59]

      shapes = {}
      for feature in TQDM(data["features"], desc=f"Converting {fname}"):
          p = feature["properties"]
          if p["bounds_imcoords"]:
              image_id = p["image_id"]
              image_file = path / "train_images" / image_id
              if image_file.exists():  # 1395.tif missing
                  try:
                      box = np.array([int(num) for num in p["bounds_imcoords"].split(",")])
                      assert box.shape[0] == 4, f"incorrect box shape {box.shape[0]}"
                      cls = p["type_id"]
                      cls = xview_class2index[int(cls)]  # xView class to 0-59
                      assert 59 >= cls >= 0, f"incorrect class index {cls}"

                      # Write YOLO label
                      if image_id not in shapes:
                          shapes[image_id] = Image.open(image_file).size
                      box = xyxy2xywhn(box[None].astype(float), w=shapes[image_id][0], h=shapes[image_id][1], clip=True)
                      with open((labels / image_id).with_suffix(".txt"), "a", encoding="utf-8") as f:
                          f.write(f"{cls} {' '.join(f'{x:.6f}' for x in box[0])}\n")  # write label.txt
                  except Exception as e:
                      print(f"WARNING: skipping one label for {image_file}: {e}")

  # Download manually from https://challenge.xviewdataset.org
  dir = Path(yaml["path"])  # dataset root dir
  # urls = [
  #     "https://d307kc0mrhucc3.cloudfront.net/train_labels.zip",  # train labels
  #     "https://d307kc0mrhucc3.cloudfront.net/train_images.zip",  # 15G, 847 train images
  #     "https://d307kc0mrhucc3.cloudfront.net/val_images.zip",  # 5G, 282 val images (no labels)
  # ]
  # download(urls, dir=dir)

  # Convert labels
  convert_labels(dir / "xView_train.geojson")

  # Move images
  images = Path(dir / "images")
  images.mkdir(parents=True, exist_ok=True)
  Path(dir / "train_images").rename(dir / "images" / "train")
  Path(dir / "val_images").rename(dir / "images" / "val")

  # Split
  autosplit(dir / "images" / "train")
Cách sử dụng#
Quá trình huấn luyện yêu cầu giải nén nội dung đã tải xuống thủ công như mô tả ở trên vào datasets/xView/; sau đó, việc chuyển đổi chú thích và chia tập train/val sẽ tự động diễn ra.
Để huấn luyện model trên dataset xView trong 100 epoch với kích thước ảnh 640, bạn có thể sử dụng các đoạn mã sau. Để xem danh sách đầy đủ các tham số hiện có, hãy tham khảo trang Training của model.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model
results = model.train(data="xView.yaml", epochs=100, imgsz=640)
Để gán nhãn cho các ảnh vệ tinh bổ sung và quản lý các lần chạy huấn luyện xView trên trình duyệt, hãy sử dụng Ultralytics Platform.
Dữ liệu mẫu và annotation#
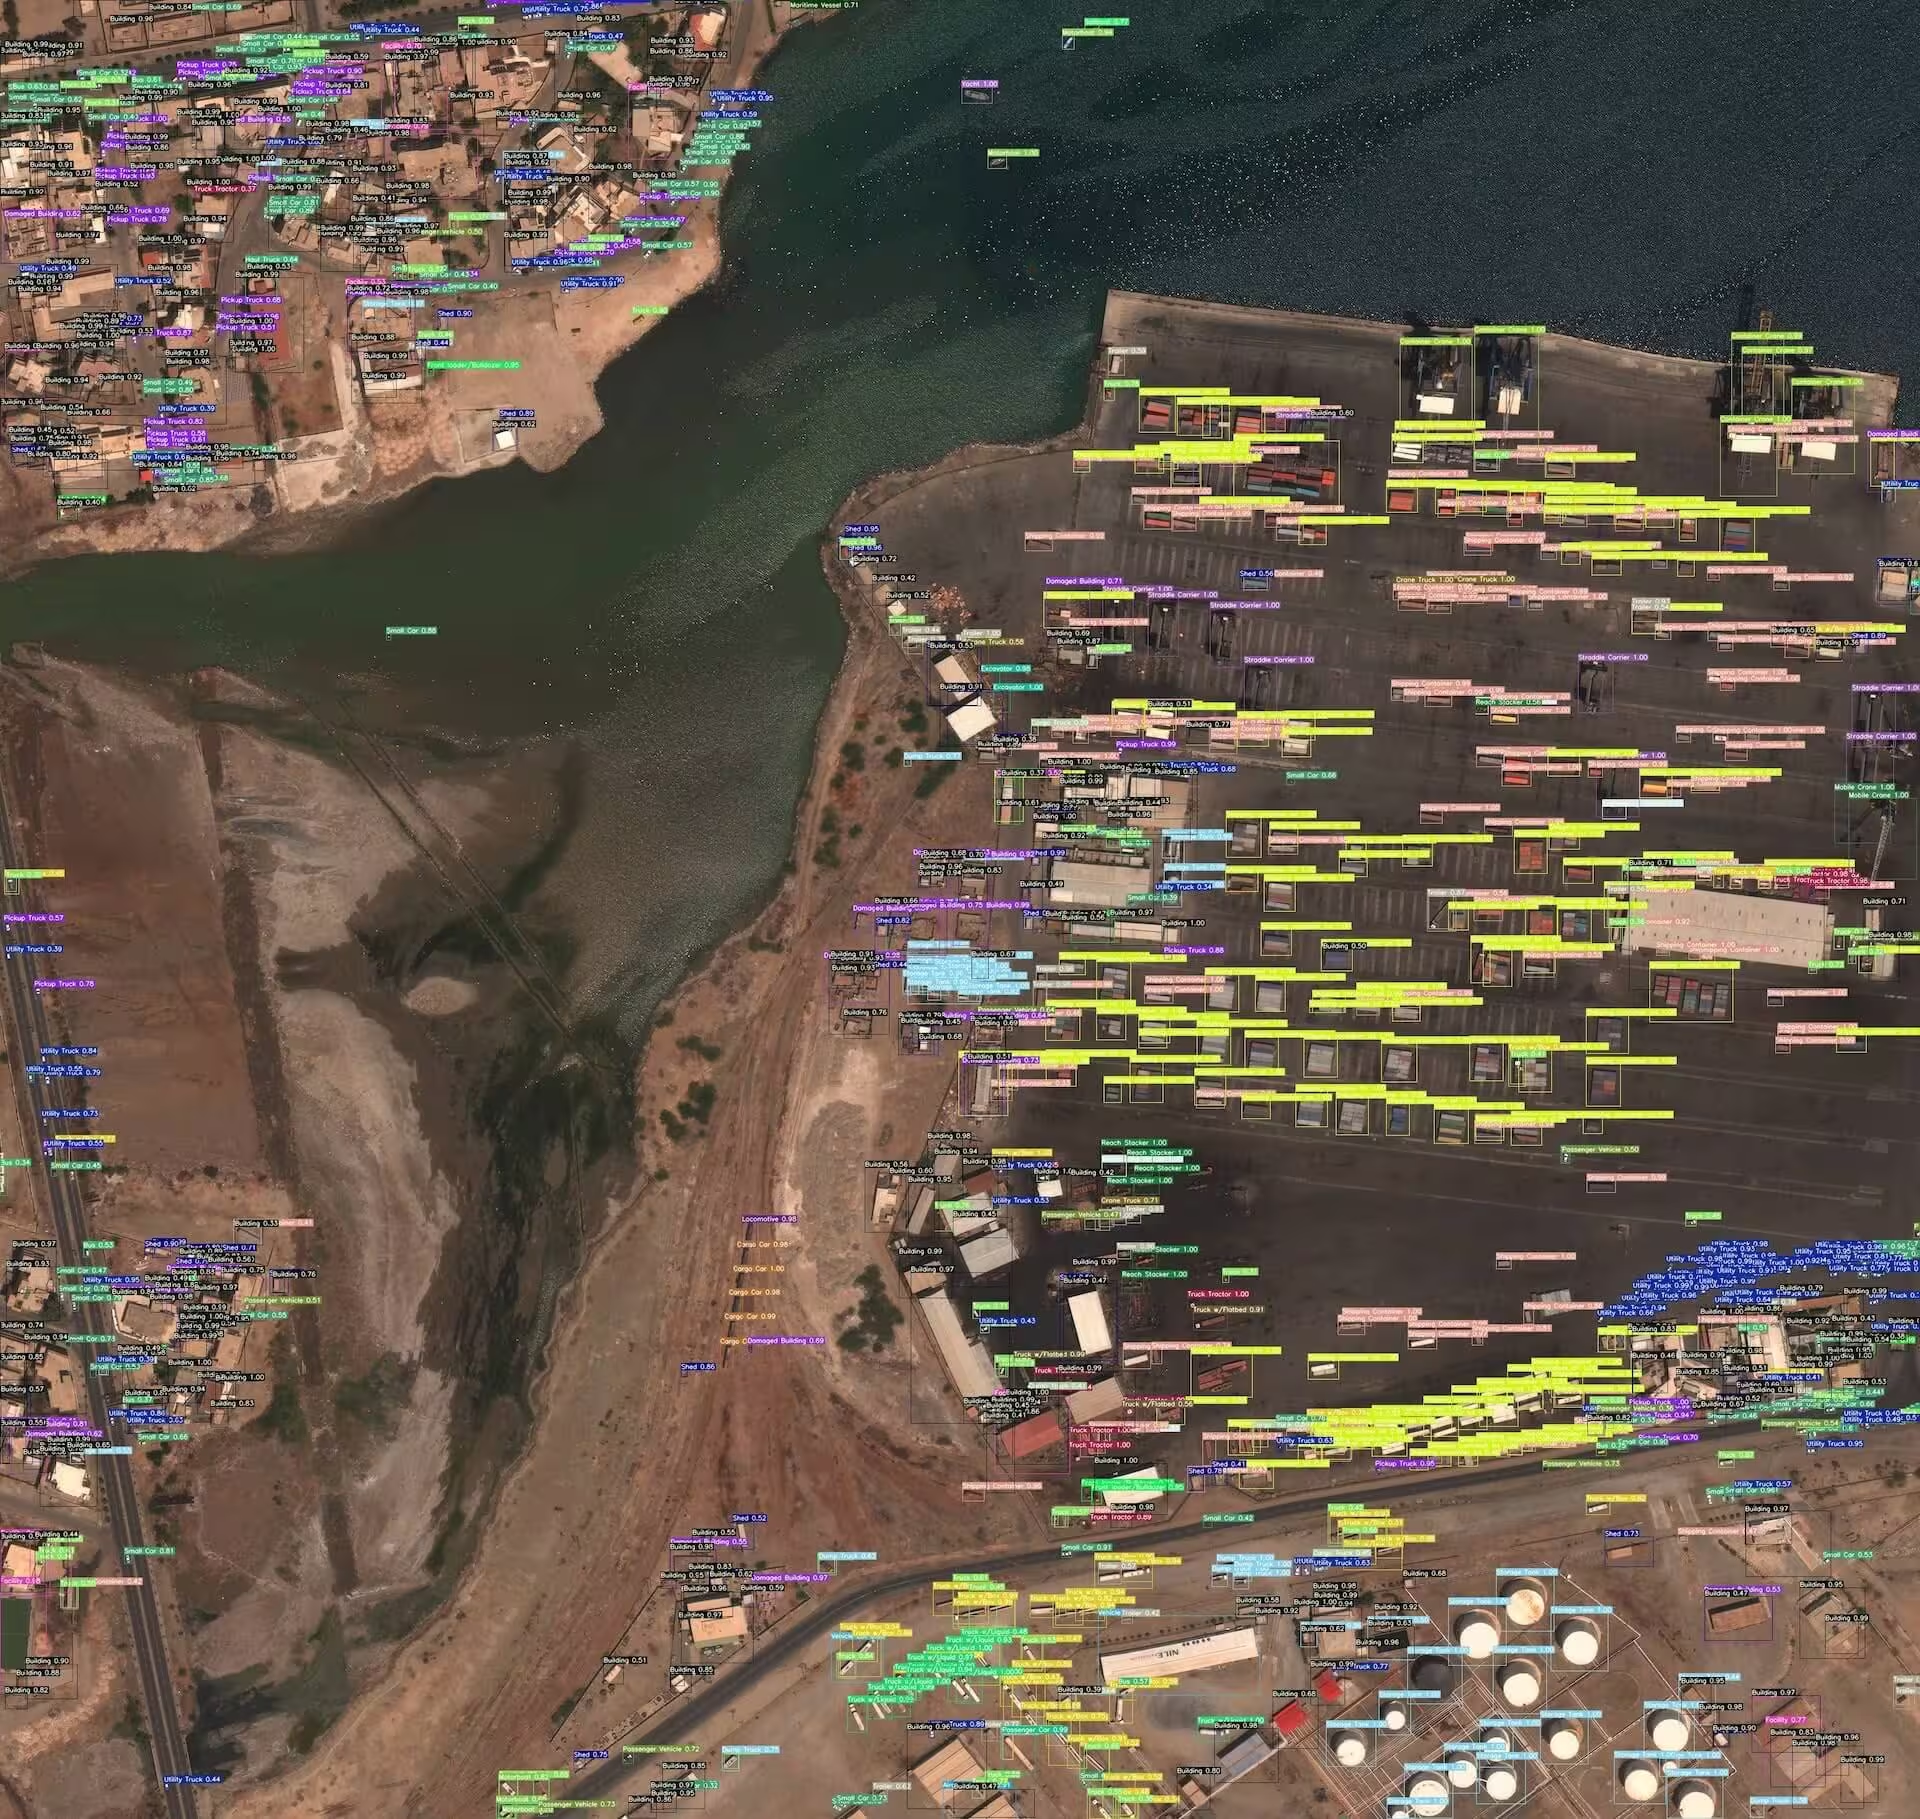
Ví dụ bên dưới cho thấy một cảnh xView điển hình: ảnh chụp từ trên cao có độ phân giải cao, trong đó các đối tượng nhỏ như phương tiện và tòa nhà được chú thích bằng bounding box, minh họa lý do phát hiện đối tượng trong ảnh vệ tinh đòi hỏi khả năng định vị chi tiết.
Trích dẫn và lời cảm ơn#
Nếu sử dụng dataset xView trong nghiên cứu hoặc công việc phát triển, vui lòng trích dẫn bài báo sau:
@misc{lam2018xview,
      title={xView: Objects in Context in Overhead Imagery},
      author={Darius Lam and Richard Kuzma and Kevin McGee and Samuel Dooley and Michael Laielli and Matthew Klaric and Yaroslav Bulatov and Brendan McCord},
      year={2018},
      eprint={1802.07856},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Chúng tôi xin ghi nhận Defense Innovation Unit (DIU) và những người tạo ra dataset xView vì những đóng góp quý giá cho cộng đồng nghiên cứu thị giác máy tính. Để biết thêm thông tin, hãy truy cập trang web dataset xView.
Câu hỏi thường gặp#
Dataset xView là benchmark ảnh vệ tinh được Cơ quan Tình báo Địa không gian Quốc gia Hoa Kỳ phát hành cho Thử thách DIUx xView 2018, cung cấp hơn 1 triệu đối tượng thuộc 60 lớp chi tiết trong ảnh WorldView-3 có độ phân giải 0.3 m. Dataset hỗ trợ nghiên cứu về phát hiện các đối tượng nhỏ, hiếm gặp và có mức độ chi tiết cao trong ảnh chụp từ trên cao — những đối tượng khó phát hiện hơn nhiều so với trong ảnh chụp từ mặt đất.
xView cần được tải xuống thủ công: đăng ký trên trang web Thử thách DIUx xView 2018, tải
train_images.zip(~15 GB),train_labels.zipvàval_images.zip(~5 GB) — tổng cộng khoảng 20.7 GB — rồi giải nén chúng vàodatasets/xView/theo cấu trúc được minh họa trong cảnh báo ở đầu trang này. Trong lần chạy huấn luyện đầu tiên, Ultralytics tự động chuyển đổi chú thích GeoJSON sang định dạng YOLO và tạo tập train/validation.xView có 847 hình ảnh huấn luyện được gán nhãn và 282 hình ảnh validation không có nhãn công khai, tất cả đều do vệ tinh WorldView-3 chụp ở độ phân giải 0.3 m. Chú thích bao gồm hơn 1 triệu đối tượng thuộc 60 lớp. Vì chỉ có nhãn huấn luyện được công khai, cấu hình
xView.yamlcủa Ultralytics chia 847 hình ảnh được gán nhãn thành tập huấn luyện và validation theo tỷ lệ khoảng 90/10; xem Cấu trúc dataset để biết chi tiết.Huấn luyện model YOLO26n trên xView trong 100 epoch với kích thước ảnh 640:
Ví dụ huấn luyệnfrom ultralytics import YOLO # Tải model model = YOLO("yolo26n.pt") # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện) # Huấn luyện model results = model.train(data="xView.yaml", epochs=100, imgsz=640)Để biết các tham số và thiết lập chi tiết, hãy tham khảo trang Training của model.
Trích dẫn bài báo "xView: Objects in Context in Overhead Imagery" (Lam et al., arXiv:1802.07856, 2018); mục Trích dẫn và lời cảm ơn ở trên có mục BibTeX đầy đủ.