Hướng dẫn sử dụng Kaggle để huấn luyện model YOLO26
Nếu bạn đang tìm hiểu về AI và thực hiện các dự án nhỏ, có thể bạn chưa có quyền truy cập vào tài nguyên điện toán mạnh, trong khi phần cứng cao cấp thường đắt đỏ. Kaggle, nền tảng thuộc sở hữu của Google, cung cấp môi trường đám mây miễn phí, nơi bạn có thể truy cập tài nguyên GPU, xử lý tập dữ liệu lớn và cộng tác với cộng đồng đa dạng gồm các nhà khoa học dữ liệu và người đam mê machine learning.
Kaggle là lựa chọn thiết thực để huấn luyện và thử nghiệm model Ultralytics YOLO26. Kaggle Notebook được cài sẵn các thư viện và framework machine learning phổ biến. Hướng dẫn này giới thiệu các tính năng chính của Kaggle và cách huấn luyện model YOLO26 trên nền tảng này.
Kaggle là gì?#
Kaggle là nền tảng quy tụ các nhà khoa học dữ liệu trên toàn thế giới để cộng tác, học hỏi và cạnh tranh nhằm giải quyết các vấn đề khoa học dữ liệu trong thực tế. Được Anthony Goldbloom và Jeremy Howard ra mắt vào năm 2010, sau đó được Google mua lại vào năm 2017, Kaggle cho phép người dùng kết nối, khám phá và chia sẻ tập dữ liệu, sử dụng notebook tăng tốc bằng GPU và tham gia các cuộc thi khoa học dữ liệu. Nền tảng phục vụ cả chuyên gia giàu kinh nghiệm lẫn người học.
Với hơn 10 triệu người dùng tính đến năm 2022, Kaggle cung cấp môi trường phong phú để phát triển và thử nghiệm model machine learning. Bạn không cần lo về cấu hình hay thiết lập máy cục bộ; tất cả những gì bạn cần là tài khoản Kaggle và trình duyệt web.
Cài đặt#
Trước khi bắt đầu huấn luyện model YOLO26 trên Kaggle, bạn cần đảm bảo môi trường notebook được cấu hình đúng cách. Hãy làm theo các bước sau:
Bật quyền truy cập Internet#
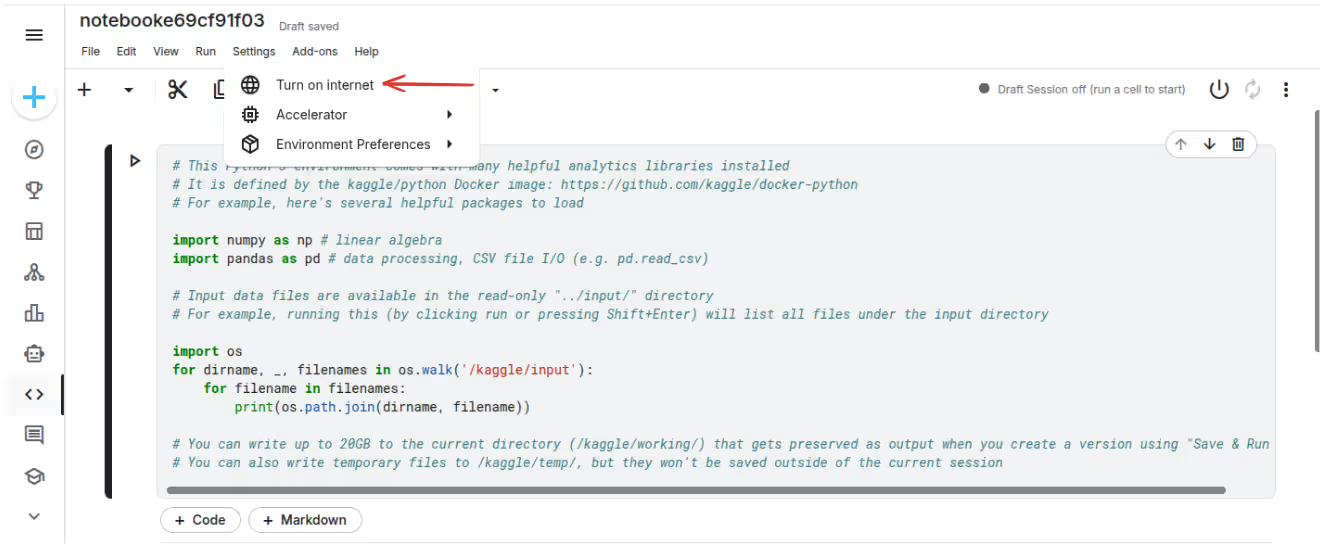
Notebook Kaggle cần kết nối Internet để tải package và dependency. Để bật Internet trong notebook Kaggle:
- Mở notebook Kaggle của bạn
- Nhấp vào bảng Settings ở bên phải giao diện notebook
- Cuộn xuống phần Internet
- Bật công tắc sang ON để kích hoạt kết nối Internet
Lưu ý: Cần có kết nối Internet để cài đặt gói Ultralytics và tải model hoặc tập dữ liệu đã huấn luyện trước. Nếu không bật Internet, quá trình cài đặt gói sẽ thất bại.
Cài đặt Ultralytics#
Sau khi bật quyền truy cập Internet, hãy cài đặt package Ultralytics bằng cách chạy lệnh sau trong một ô notebook:
!pip install ultralyticsĐể cài phiên bản phát triển mới nhất, bạn có thể cài trực tiếp từ GitHub:
!pip install git+https://github.com/ultralytics/ultralytics.gitGiải quyết xung đột dependency#
Trong quá trình cài đặt, bạn có thể gặp xung đột dependency, đặc biệt với các package như opencv-python, numpy hoặc torch. Dưới đây là các giải pháp thường dùng:
Phương pháp 1: Buộc cài đặt lại bằng --upgrade#
Nếu gặp xung đột với các package hiện có, hãy buộc nâng cấp:
!pip install --upgrade --force-reinstall ultralyticsPhương pháp 2: Khởi động lại kernel sau khi cài đặt#
Đôi khi, bạn cần khởi động lại kernel sau khi cài đặt để khắc phục vấn đề import:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
Giải pháp cho lỗi thường gặp#
Lỗi: "No module named 'ultralytics'"
- Giải pháp: Đảm bảo đã bật Internet rồi chạy lại lệnh cài đặt
- Khởi động lại kernel sau khi cài đặt
Lỗi: "ERROR: pip's dependency resolver does not currently take into account..."
- Giải pháp: Đây thường chỉ là cảnh báo và có thể bỏ qua an toàn. Quá trình cài đặt thường vẫn thành công dù xuất hiện thông báo này
Lỗi: "ModuleNotFoundError" sau khi cài đặt
- Giải pháp: Khởi động lại kernel bằng nút khởi động lại trong giao diện notebook
- Chạy lại các câu lệnh import trong ô mới
Xác minh cài đặt#
Sau khi cài đặt, hãy xác minh Ultralytics đã được cài đặt đúng cách bằng cách chạy:
import ultralytics

ultralytics.checks()
Lệnh này sẽ hiển thị thông tin hệ thống và xác minh tất cả dependency đã được cài đặt chính xác.
Huấn luyện YOLO26 bằng Kaggle#
GPU miễn phí của Kaggle giúp việc huấn luyện model YOLO26 trở nên đơn giản.
Để bắt đầu, hãy mở notebook hướng dẫn Ultralytics YOLO26 trên Kaggle. Môi trường Kaggle được cài sẵn các thư viện như TensorFlow và PyTorch, giúp đơn giản hóa quá trình thiết lập.
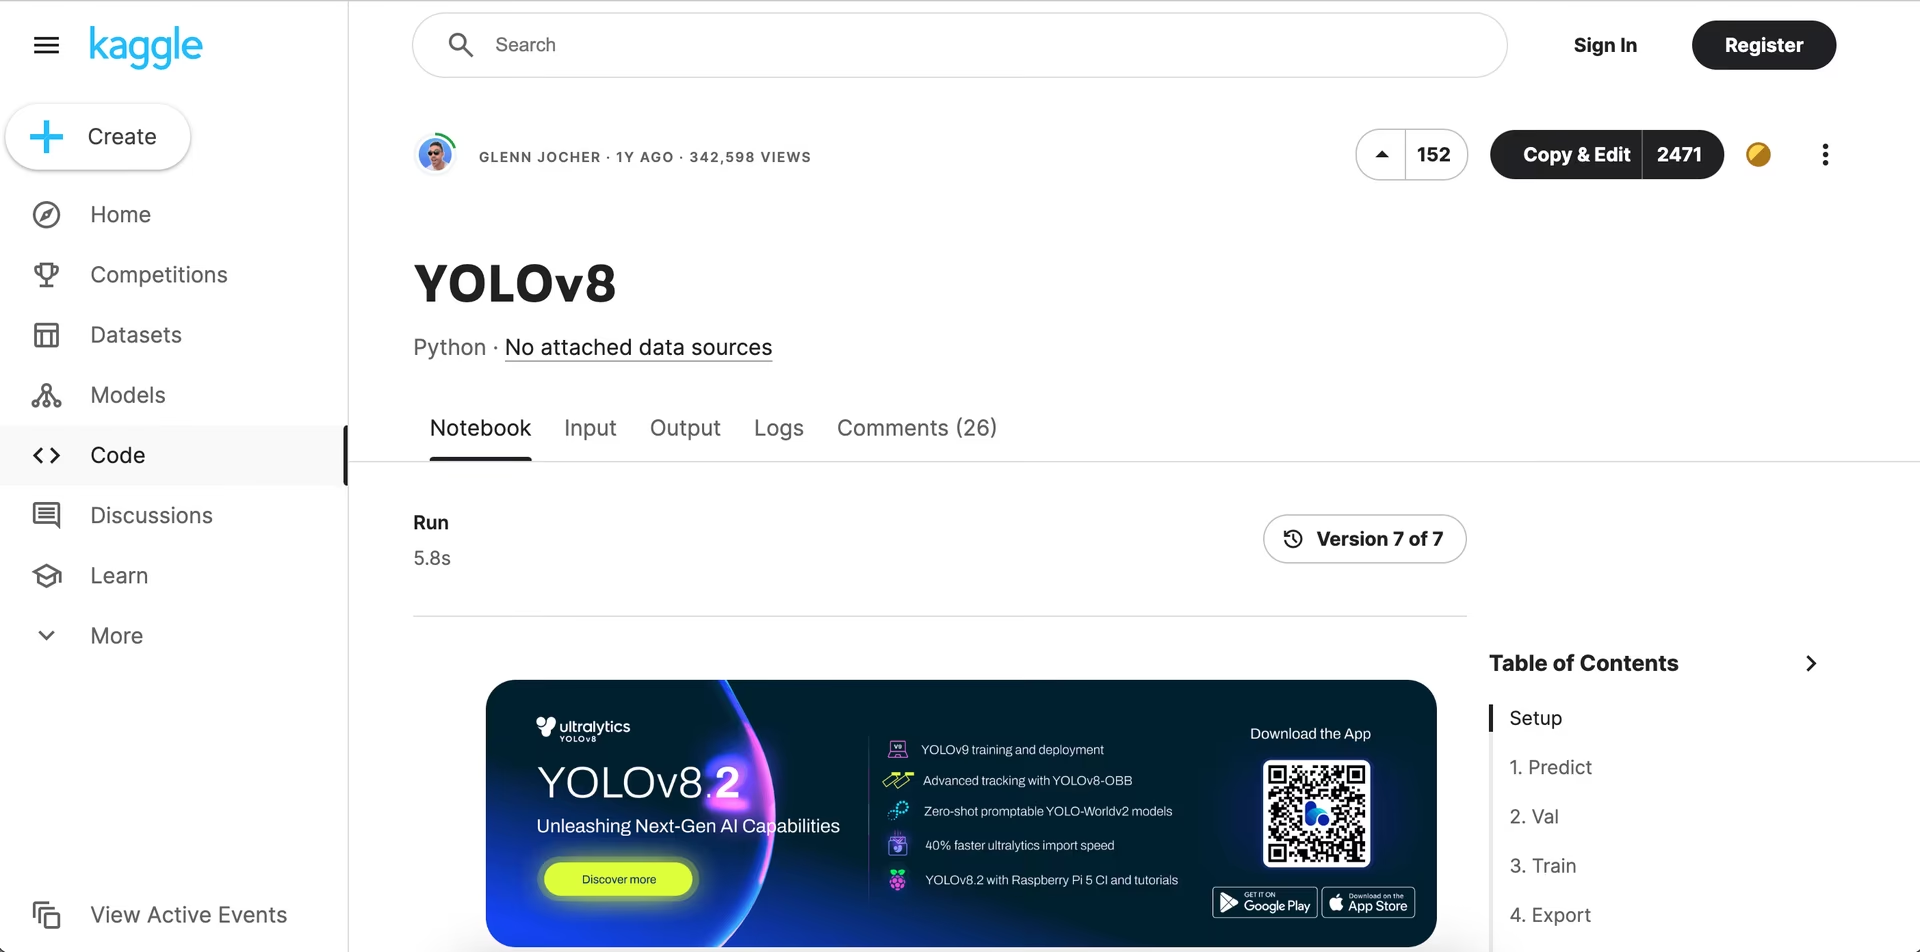
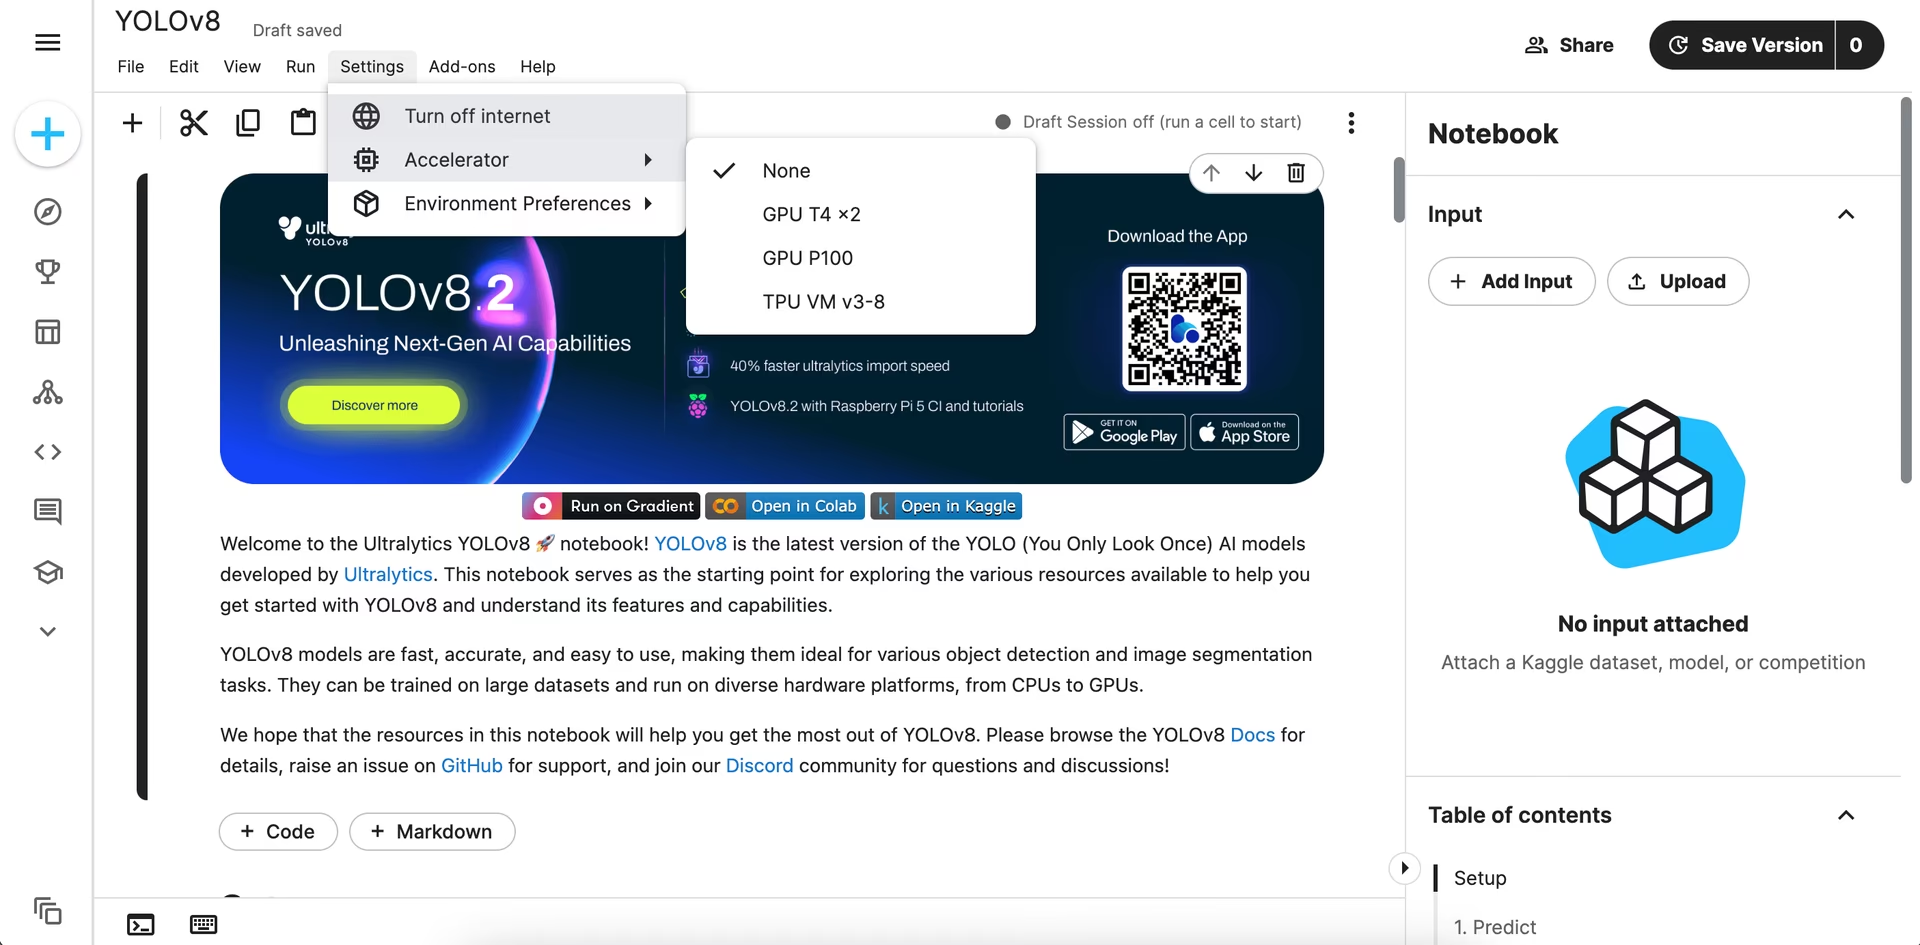
Sau khi đăng nhập vào tài khoản Kaggle, notebook sẽ mở dưới dạng bản sao có thể chỉnh sửa của riêng bạn: chọn GPU trong phần cài đặt bộ tăng tốc, rồi chạy các ô của notebook để bắt đầu huấn luyện model. Để hiểu chi tiết quy trình huấn luyện model và các phương pháp hay nhất, hãy tham khảo hướng dẫn Huấn luyện Model YOLO26 của chúng tôi.
Các vấn đề thường gặp khi làm việc với Kaggle#
Khi làm việc với Kaggle, bạn có thể gặp một số vấn đề thường gặp. Dưới đây là các điểm chính giúp bạn sử dụng nền tảng:
- Quyền truy cập GPU: Trong notebook Kaggle, bạn có thể bật GPU bất cứ lúc nào và được phép sử dụng tối đa 30 giờ mỗi tuần. Kaggle cung cấp GPU NVIDIA Tesla P100 với bộ nhớ 16GB, đồng thời có tùy chọn NVIDIA T4 x2. Tăng tốc GPU giúp quá trình huấn luyện và inference model nhanh hơn nhiều.
- Kaggle Kernels: Kaggle Kernels là các máy chủ Jupyter notebook miễn phí có thể tích hợp GPU, cho phép bạn thực hiện các tác vụ machine learning trên máy tính đám mây. Bạn không cần phụ thuộc vào CPU của máy tính cá nhân, nhờ đó tránh quá tải và giải phóng tài nguyên cục bộ.
- Dataset Kaggle: Dataset trên Kaggle được tải xuống miễn phí. Tuy nhiên, điều quan trọng là kiểm tra giấy phép của từng dataset để hiểu các hạn chế sử dụng. Một số dataset có thể bị hạn chế sử dụng trong các ấn phẩm học thuật hoặc mục đích thương mại. Bạn có thể tải dataset trực tiếp vào notebook Kaggle hoặc bất kỳ nơi nào khác thông qua Kaggle API.
- Lưu và commit notebook: Để lưu và commit notebook trên Kaggle, hãy nhấp vào "Save Version". Thao tác này lưu trạng thái hiện tại của notebook. Sau khi kernel chạy nền tạo xong các tệp đầu ra, bạn có thể truy cập các tệp này từ tab Output trên trang notebook chính.
- Cộng tác: Kaggle hỗ trợ cộng tác, nhưng nhiều người dùng không thể chỉnh sửa notebook cùng lúc. Hoạt động cộng tác trên Kaggle diễn ra không đồng bộ, nghĩa là người dùng có thể chia sẻ và làm việc trên cùng một notebook vào các thời điểm khác nhau.
- Khôi phục phiên bản trước: Nếu cần khôi phục phiên bản trước của notebook, hãy mở notebook rồi nhấp vào dấu ba chấm dọc ở góc trên bên phải để chọn "View Versions". Tìm phiên bản cần khôi phục, nhấp vào menu "..." bên cạnh phiên bản đó rồi chọn "Revert to Version". Sau khi notebook được khôi phục, hãy nhấp vào "Save Version" để commit các thay đổi.
Các tính năng chính của Kaggle#
Sau đây là một số tính năng chính mà Kaggle cung cấp cho khoa học dữ liệu và machine learning:
- Tập dữ liệu: Kaggle lưu trữ bộ sưu tập lớn các tập dữ liệu thuộc nhiều chủ đề. Bạn có thể tìm kiếm và sử dụng các tập dữ liệu này trong dự án, đặc biệt hữu ích khi huấn luyện và kiểm thử model YOLO26.
- Cuộc thi: Các cuộc thi Kaggle cho phép nhà khoa học dữ liệu và người làm machine learning giải quyết các vấn đề thực tế. Việc tham gia thi giúp bạn nâng cao kỹ năng, học kỹ thuật mới và được cộng đồng ghi nhận.
- Truy cập TPU miễn phí: Kaggle cung cấp quyền truy cập miễn phí vào TPU cho các framework hỗ trợ chúng. Quá trình huấn luyện Ultralytics YOLO26 chạy trên GPU hoặc CPU của Kaggle, không chạy trên TPU.
- Tích hợp với GitHub: Kaggle cho phép bạn kết nối kho lưu trữ GitHub để tải notebook lên và lưu công việc. Tích hợp này giúp quản lý và truy cập tệp thuận tiện hơn.
- Cộng đồng và thảo luận: Kaggle có cộng đồng lớn gồm các nhà khoa học dữ liệu và người làm machine learning. Diễn đàn thảo luận và notebook được chia sẻ là những tài nguyên hữu ích để học hỏi và khắc phục sự cố. Bạn có thể tìm trợ giúp, chia sẻ kiến thức và cộng tác với người khác.
Tại sao nên sử dụng Kaggle cho các dự án YOLO26?#
Có nhiều nền tảng để huấn luyện và đánh giá model machine learning. Sau đây là một số lợi ích khi dùng Kaggle cho các dự án machine learning:
- Notebook công khai: Bạn có thể đặt notebook Kaggle ở chế độ công khai để người dùng khác xem, bình chọn, fork và thảo luận về công việc của mình. Kaggle khuyến khích cộng tác, phản hồi và chia sẻ ý tưởng, giúp bạn cải thiện model YOLO26.
- Lịch sử commit notebook toàn diện: Kaggle tạo lịch sử chi tiết về các commit notebook. Nhờ đó, bạn có thể xem lại và theo dõi các thay đổi theo thời gian, hiểu rõ hơn quá trình phát triển dự án và khôi phục phiên bản trước nếu cần.
- Truy cập console: Kaggle cung cấp console, giúp bạn kiểm soát môi trường tốt hơn. Tính năng này cho phép bạn thực hiện nhiều tác vụ trực tiếp từ dòng lệnh.
- Tài nguyên sẵn có: Mỗi phiên chỉnh sửa notebook trên Kaggle được cấp tài nguyên đáng kể: 12 giờ thực thi cho các phiên CPU và GPU, 9 giờ thực thi cho các phiên TPU và 20 gigabyte dung lượng ổ đĩa tự động lưu.
- Lên lịch notebook: Kaggle cho phép bạn lên lịch chạy notebook vào những thời điểm cụ thể. Bạn có thể tự động hóa các tác vụ lặp lại mà không cần can thiệp thủ công, chẳng hạn như huấn luyện model định kỳ.
Tiếp tục tìm hiểu về Kaggle#
Nếu muốn tìm hiểu thêm về Kaggle, dưới đây là một số tài nguyên hữu ích hướng dẫn bạn:
- Kaggle Learn: Khám phá nhiều hướng dẫn tương tác miễn phí trên Kaggle Learn. Các khóa học này bao gồm những chủ đề thiết yếu về khoa học dữ liệu với bài tập thực hành.
- Bắt đầu với Kaggle: Hướng dẫn này giúp bạn nắm các kiến thức cơ bản về Kaggle, từ tham gia cuộc thi đến tạo notebook đầu tiên.
- Trang Medium của Kaggle: Khám phá hướng dẫn, tin cập nhật và đóng góp của cộng đồng trên trang Medium của Kaggle.
- Huấn luyện model Ultralytics YOLO bằng tích hợp Kaggle: Bài đăng blog này hướng dẫn cách sử dụng Kaggle dành riêng cho các model Ultralytics YOLO.
Tóm tắt#
Kaggle cung cấp cho các dự án YOLO26 quyền truy cập GPU miễn phí để huấn luyện và đánh giá model, cùng các thư viện được cài đặt sẵn giúp thiết lập nhanh chóng. Kết hợp Ultralytics YOLO26 với Kaggle, bạn có thể phát triển, huấn luyện và triển khai model thị giác máy tính mà không cần phần cứng đắt tiền.
Để biết thêm chi tiết, hãy truy cập tài liệu Kaggle.
Câu hỏi thường gặp#
Để cài đặt Ultralytics YOLO26 trên Kaggle:
- Bật Internet: Mở bảng Settings và bật công tắc Internet
- Cài đặt package: Chạy
!pip install ultralyticstrong một cell của notebook - Xác minh cài đặt: Chạy
import ultralytics; ultralytics.checks()để xác nhận
Nếu gặp xung đột dependency, hãy thử
!pip install --upgrade --force-reinstall ultralyticshoặc khởi động lại kernel sau khi cài đặt. Để biết cách khắc phục sự cố chi tiết, xem phần Cài đặt ở trên.Huấn luyện model YOLO26 trên Kaggle rất đơn giản. Trước tiên, hãy mở notebook hướng dẫn Ultralytics YOLO26 trên Kaggle. Đăng nhập vào tài khoản Kaggle và chọn GPU trong phần cài đặt bộ tăng tốc. Chạy các ô notebook để bắt đầu huấn luyện. Để xem các bước chi tiết hơn, hãy tham khảo hướng dẫn Huấn luyện Model YOLO26 của chúng tôi.
Kaggle có một số lợi thế khi huấn luyện model YOLO26:
- Truy cập GPU miễn phí: Sử dụng GPU như NVIDIA Tesla P100 hoặc T4 x2 tối đa 30 giờ mỗi tuần.
- Thư viện cài đặt sẵn: Các thư viện như TensorFlow và PyTorch được cài đặt sẵn, giúp đơn giản hóa quá trình thiết lập.
- Cộng tác cộng đồng: Tham gia cộng đồng đông đảo gồm các nhà khoa học dữ liệu và người đam mê machine learning.
- Kiểm soát phiên bản: Quản lý các phiên bản khác nhau của notebook và khôi phục phiên bản trước đó khi cần.
Các vấn đề thường gặp bao gồm:
- Truy cập GPU: Đảm bảo bạn bật GPU trong phần cài đặt notebook. Kaggle cho phép sử dụng GPU tối đa 30 giờ mỗi tuần.
- Chưa bật Internet: Đảm bảo bật Internet trong bảng Settings trước khi cài đặt package.
- Xung đột dependency: Sử dụng
!pip install --upgrade --force-reinstall ultralytics. - Giấy phép dataset: Kiểm tra giấy phép của từng dataset để hiểu các hạn chế sử dụng.
- Lưu và commit notebook: Nhấp vào "Save Version" để lưu trạng thái notebook và truy cập các tệp đầu ra từ tab Output.
- Cộng tác: Kaggle hỗ trợ cộng tác không đồng bộ; nhiều người dùng không thể chỉnh sửa notebook cùng lúc.
Để biết thêm mẹo khắc phục sự cố, hãy xem phần Cài đặt và hướng dẫn Các vấn đề thường gặp của chúng tôi.
Kaggle cung cấp một số tính năng tạo nên sự khác biệt so với Google Colab:
- Notebook công khai: Chia sẻ công việc với cộng đồng để nhận phản hồi và cộng tác.
- Lịch sử toàn diện: Theo dõi các thay đổi theo thời gian nhờ lịch sử commit notebook chi tiết.
- Tài nguyên sẵn có: Mỗi phiên notebook được cấp tài nguyên đáng kể, bao gồm 12 giờ thực thi cho các phiên CPU và GPU.
Để khôi phục phiên bản trước:
- Mở notebook rồi nhấp vào dấu ba chấm dọc ở góc trên bên phải.
- Chọn "View Versions".
- Tìm phiên bản cần khôi phục, nhấp vào menu "..." bên cạnh phiên bản đó rồi chọn "Revert to Version".
- Nhấp vào "Save Version" để commit các thay đổi.


Bình luận3
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?