Tăng cường dữ liệu khi kiểm thử (TTA)#
📚 Hướng dẫn này giải thích cách sử dụng Tăng cường dữ liệu khi kiểm thử (TTA) trong quá trình kiểm thử và suy luận để cải thiện mAP và Recall với YOLOv5 🚀.
Trước khi bắt đầu#
Clone repository và cài đặt requirements.txt trong môi trường Python>=3.8.0, bao gồm PyTorch>=1.8. Model và dataset được tự động tải xuống từ bản phát hành YOLOv5 mới nhất.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Kiểm thử thông thường#
Trước khi thử TTA, cần thiết lập hiệu năng cơ sở để so sánh. Lệnh này kiểm thử YOLOv5x trên COCO val2017 với kích thước ảnh 640 pixel. yolov5x.pt là model lớn nhất và chính xác nhất hiện có. Các tùy chọn khác gồm yolov5n.pt, yolov5s.pt, yolov5m.pt và yolov5l.pt, hoặc checkpoint của riêng bạn từ quá trình huấn luyện trên dataset tùy chỉnh, chẳng hạn runs/train/exp/weights/best.pt. Xem tài liệu YOLOv5 để biết chi tiết về tất cả model hiện có.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfĐầu ra:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Kiểm thử với TTA#
Thêm --augment vào bất kỳ lệnh val.py hiện có nào để bật TTA, đồng thời tăng kích thước ảnh khoảng 30% để cải thiện kết quả. Lưu ý rằng suy luận khi bật TTA thường mất thời gian gấp khoảng 2-3X so với suy luận thông thường vì ảnh được lật trái-phải và xử lý ở 3 độ phân giải khác nhau; đầu ra được hợp nhất trước khi áp dụng NMS. Một phần thời gian xử lý tăng thêm chỉ do kích thước ảnh lớn hơn (832 so với 640), phần còn lại là do các phép toán TTA thực tế, vì vậy hãy đảm bảo GPU còn đủ bộ nhớ trước khi tăng --img.
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --halfĐầu ra:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
Suy luận với TTA#
Suy luận TTA detect.py hoạt động tương tự như TTA val.py: chỉ cần thêm --augment vào bất kỳ lệnh detect.py hiện có nào:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augmentĐầu ra:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)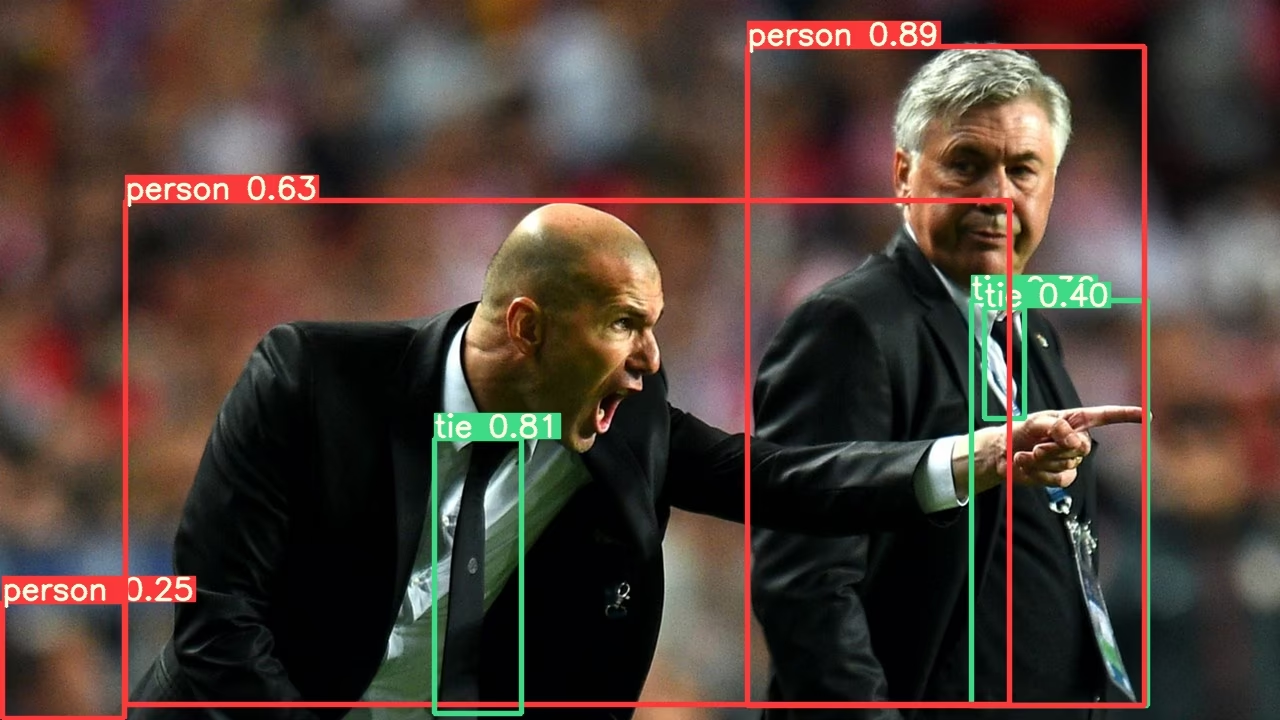
TTA trên PyTorch Hub#
TTA được tích hợp tự động vào tất cả model YOLOv5 PyTorch Hub và có thể được sử dụng bằng cách truyền augment=True khi suy luận.
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # hoặc yolov5m, yolov5x, custom

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # hoặc file, PIL, OpenCV, numpy, multiple

# Inference
results = model(img, augment=True)  # <--- suy luận TTA

# Results
results.print()  # or .show(), .save(), .crop(), .pandas(), etc.
Tùy chỉnh#
Bạn có thể tùy chỉnh các phép toán TTA được áp dụng trong phương thức YOLOv5 forward_augment().
Lợi ích của Tăng cường dữ liệu khi kiểm thử#
Tăng cường dữ liệu khi kiểm thử mang lại một số lợi ích chính cho các tác vụ phát hiện đối tượng:
- Độ chính xác được cải thiện: Như kết quả ở trên cho thấy, TTA tăng mAP từ 0.504 lên 0.516 và mAR từ 0.681 lên 0.696.
- Phát hiện vật thể nhỏ tốt hơn: TTA đặc biệt cải thiện khả năng phát hiện vật thể nhỏ, với AP trên vùng nhỏ tăng từ 0.351 lên 0.361.
- Tăng độ bền vững: Bằng cách kiểm thử nhiều biến thể của mỗi ảnh, TTA giảm ảnh hưởng của góc nhìn, ánh sáng và các yếu tố môi trường khác.
- Triển khai đơn giản: Chỉ cần thêm flag
--augmentvào các lệnh hiện có.
Đánh đổi là thời gian suy luận tăng, khiến TTA phù hợp hơn với các ứng dụng ưu tiên độ chính xác hơn tốc độ.
Môi trường được hỗ trợ#
Ultralytics cung cấp nhiều môi trường sẵn sàng sử dụng, mỗi môi trường được cài đặt sẵn các dependency thiết yếu như CUDA, CUDNN, Python và PyTorch, giúp bạn bắt đầu dự án nhanh chóng.
- Notebook GPU miễn phí:


- Google Cloud: Hướng dẫn bắt đầu nhanh với GCP
- Amazon: Hướng dẫn bắt đầu nhanh với AWS
- Azure: Hướng dẫn bắt đầu nhanh với AzureML
- Docker: Hướng dẫn bắt đầu nhanh với Docker

Trạng thái dự án#

Huy hiệu này cho biết tất cả bài kiểm thử Continuous Integration (CI) của GitHub Actions cho YOLOv5 đều đã chạy thành công. Các bài kiểm thử CI này kiểm tra nghiêm ngặt chức năng và hiệu năng của YOLOv5 trên nhiều khía cạnh chính: huấn luyện, validation, inference, export và benchmark. Các bài kiểm thử đảm bảo hoạt động nhất quán và đáng tin cậy trên macOS, Windows và Ubuntu; chúng được thực hiện mỗi 24 giờ và sau mỗi commit mới.
Câu hỏi thường gặp#
Mỗi ảnh được xử lý ở ba tỷ lệ và lật trái-phải; các dự đoán được hợp nhất trước khi áp dụng NMS. Các góc nhìn bổ sung giúp cải thiện recall, đặc biệt với vật thể nhỏ, nhưng cần nhiều tài nguyên tính toán hơn.
Thời gian suy luận dự kiến tăng khoảng 2-3 lần so với thông thường. Một phần chi phí đến từ kích thước
--imglớn hơn, vì vậy hãy đảm bảo GPU có đủ bộ nhớ trước khi tăng kích thước này.Chạy ở độ phân giải lớn hơn khoảng 30%, chẳng hạn 832 thay vì 640, giúp các lượt xử lý đa tỷ lệ có thêm chi tiết và mang lại kết quả tốt nhất trong các benchmark ở trên.
Không. Lượt forward có tăng cường dữ liệu nằm trong
DetectionModelcủa PyTorch, vì vậy--augmentchỉ ảnh hưởng đến các checkpoint.pt. Các định dạng ONNX, TensorRT và định dạng đã export khác sẽ bỏ qua tính năng này.