Các tác vụ thị giác máy tính được Ultralytics YOLO26 hỗ trợ
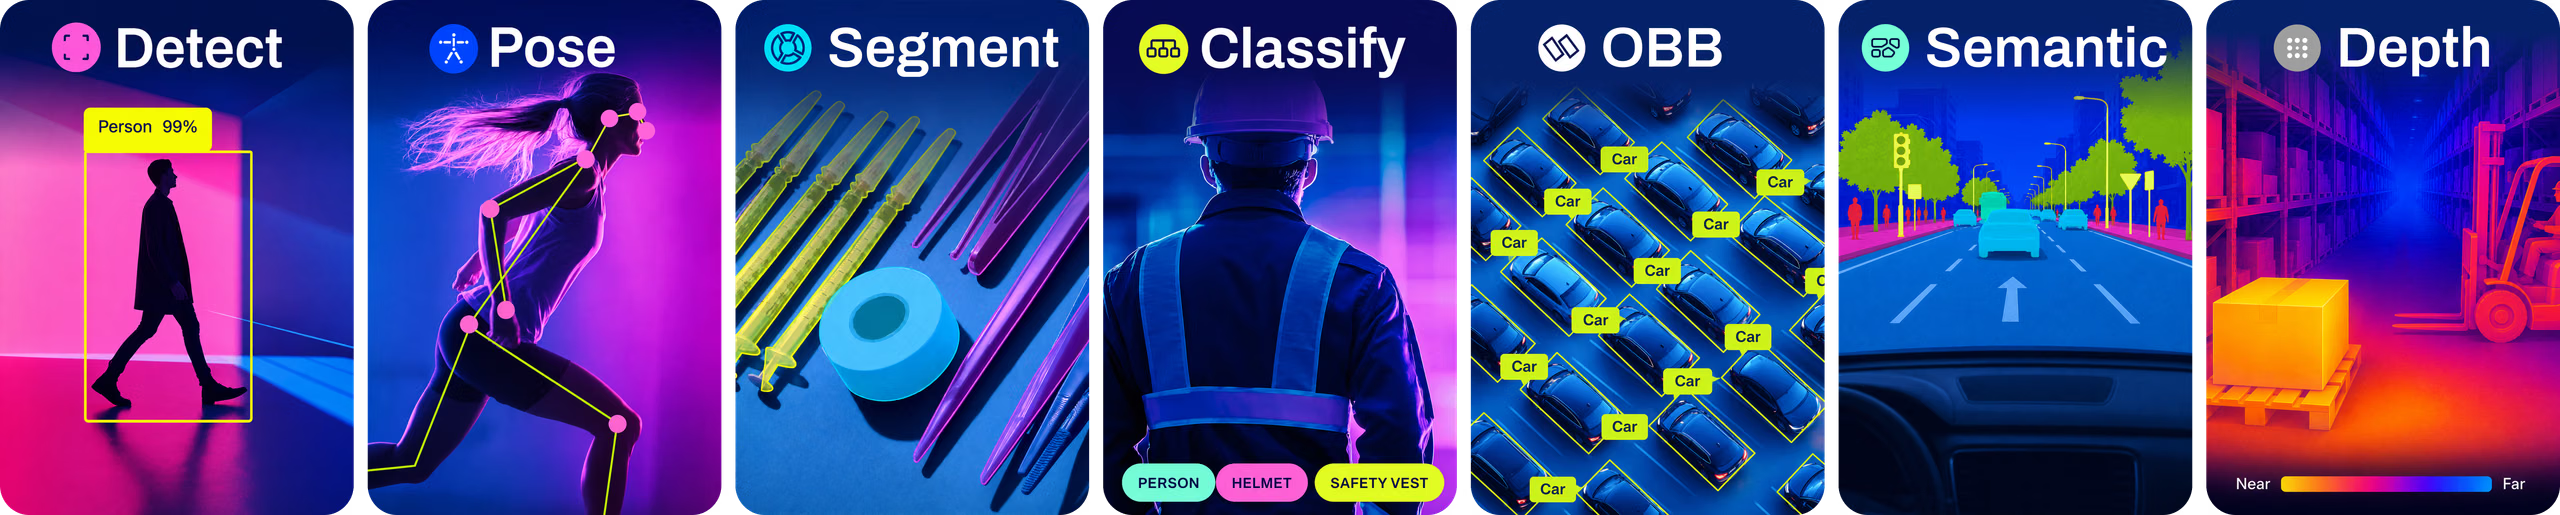
Ultralytics YOLO26 hỗ trợ nhiều tác vụ thị giác máy tính: phát hiện, phân đoạn, phân đoạn ngữ nghĩa, ước tính độ sâu, phân loại, ước tính pose và OBB. Mỗi tác vụ có mục tiêu và trường hợp sử dụng riêng, giúp bạn giải quyết nhiều bài toán thị giác máy tính bằng một framework duy nhất.
Để biết thông tin về kế hoạch hỗ trợ YOLO27, hãy xem bản xem trước YOLO27. YOLO27 sẽ ra mắt trong thời gian tới và hiện chưa khả dụng; hướng dẫn này sử dụng các model YOLO26 đã phát hành.
Xem: Khám phá các tác vụ của Ultralytics YOLO26: Phát hiện đối tượng, Phân đoạn instance, Phân đoạn ngữ nghĩa, Ước tính độ sâu, Phân loại, Ước tính pose và OBB.
Phát hiện#
Phát hiện đối tượng là tác vụ chính được YOLO26 hỗ trợ. Tác vụ này xác định đối tượng trong ảnh hoặc frame video và vẽ bounding box quanh chúng. Các đối tượng được phát hiện sẽ được phân loại thành nhiều danh mục dựa trên đặc điểm. YOLO26 phát hiện nhiều đối tượng trong một ảnh hoặc frame video đủ nhanh để sử dụng trong các ứng dụng thời gian thực như hệ thống giám sát và xe tự hành.
Phân đoạn đối tượng#
Phân đoạn instance mở rộng khả năng phát hiện đối tượng bằng cách tạo mask ở cấp pixel cho từng đối tượng. Độ chính xác này hữu ích trong các ứng dụng như chẩn đoán hình ảnh y khoa, phân tích nông nghiệp và kiểm soát chất lượng sản xuất.
Phân đoạn ngữ nghĩa#
Phân đoạn ngữ nghĩa gán nhãn lớp cho từng pixel trong ảnh, tạo ra bản đồ lớp dày đặc cho toàn bộ cảnh. Khác với phân đoạn instance, phương pháp này không phân biệt các đối tượng riêng lẻ cùng lớp. Đặc điểm này khiến phương pháp phù hợp với lái xe tự hành, phân tích cảnh và lập bản đồ lớp phủ đất, nơi việc hiểu toàn bộ bố cục không gian quan trọng hơn việc xác định từng đối tượng.
Ước lượng độ sâu#
Ước tính độ sâu đơn ảnh dự đoán bản đồ độ sâu theo từng pixel, tính bằng mét, từ một ảnh RGB. Đầu ra là bản đồ float dày đặc, khớp với ảnh đầu vào, phù hợp cho tái tạo cảnh 3D, điều hướng robot và các ứng dụng AR/VR cần suy luận bố cục không gian từ một camera duy nhất.
Classification#
Phân loại ảnh là quá trình phân loại toàn bộ ảnh dựa trên nội dung. Tác vụ này hữu ích trong các ứng dụng như phân loại sản phẩm trong thương mại điện tử, kiểm duyệt nội dung và giám sát động vật hoang dã.
Ước lượng tư thế#
Ước tính pose phát hiện các keypoint cụ thể trong ảnh hoặc frame video để tracking chuyển động hoặc ước tính pose. Các keypoint này có thể biểu diễn khớp cơ thể người, đặc điểm khuôn mặt hoặc những điểm quan tâm quan trọng khác. Model pose YOLO26 phát hiện keypoint theo thời gian thực, phù hợp cho ứng dụng thể dục, phân tích thể thao và tương tác người-máy.
OBB#
Phát hiện hộp giới hạn định hướng (OBB) cải thiện khả năng phát hiện đối tượng truyền thống bằng cách bổ sung góc định hướng để xác định vị trí của đối tượng xoay chính xác hơn. Khả năng này đặc biệt hữu ích cho phân tích ảnh hàng không, xử lý tài liệu và ứng dụng công nghiệp, nơi đối tượng xuất hiện ở nhiều góc độ. Model OBB YOLO26 được pretrained trên bộ dữ liệu ảnh hàng không DOTAv1.
Tiếp theo là gì#
Đã chọn tác vụ? Hãy định dạng dữ liệu cho tác vụ đó bằng hướng dẫn về dataset, sau đó huấn luyện bằng hình ảnh của riêng bạn.
Câu hỏi thường gặp#
Ultralytics YOLO26 hỗ trợ các tác vụ thị giác máy tính sau:
- Phát hiện đối tượng: Xác định và định vị đối tượng trong ảnh hoặc khung hình video bằng cách vẽ hộp giới hạn quanh đối tượng.
- Phân đoạn thực thể: Tạo mask ở cấp pixel cho từng đối tượng được phát hiện, hữu ích trong các ứng dụng như chẩn đoán hình ảnh y tế.
- Phân đoạn ngữ nghĩa: Gán nhãn lớp cho từng pixel trong ảnh để hiểu cảnh ở mức chi tiết.
- Ước lượng độ sâu: Dự đoán bản đồ độ sâu tính bằng mét cho từng pixel từ một ảnh RGB.
- Phân loại: Phân loại toàn bộ ảnh dựa trên nội dung.
- Ước lượng tư thế: Phát hiện các keypoint cụ thể trong ảnh hoặc khung hình video để theo dõi chuyển động hoặc tư thế.
- Phát hiện đối tượng có định hướng (OBB): Phát hiện đối tượng xoay bằng cách bổ sung góc định hướng để tăng độ chính xác.
Để sử dụng Ultralytics YOLO26 cho tác vụ phát hiện đối tượng, hãy làm theo các bước sau:
- Chuẩn bị dataset theo định dạng phù hợp.
- Huấn luyện model YOLO26 bằng tác vụ phát hiện.
- Dùng model để đưa ra dự đoán bằng cách cung cấp ảnh hoặc khung hình video mới.
Ví dụfrom ultralytics import YOLO # Tải model YOLO đã huấn luyện trước (điều chỉnh loại model nếu cần) model = YOLO("yolo26n.pt") # Có các phiên bản n, s, m, l, x # Thực hiện phát hiện đối tượng trên hình ảnh results = model.predict(source="image.jpg") # Cũng có thể dùng video, thư mục, URL, v.v. # Hiển thị kết quả results[0].show() # Hiển thị kết quả của ảnh đầu tiênĐể xem hướng dẫn chi tiết hơn, hãy tham khảo ví dụ phát hiện của chúng tôi.
Sử dụng YOLO26 cho các tác vụ phân đoạn mang lại một số ưu điểm:
- Độ chính xác cao: Tác vụ phân đoạn tạo ra mask chính xác ở cấp pixel.
- Tốc độ: YOLO26 được tối ưu cho các ứng dụng thời gian thực, xử lý nhanh ngay cả với ảnh có độ phân giải cao.
- Nhiều ứng dụng: Model phù hợp cho chẩn đoán hình ảnh y tế, xe tự hành và các ứng dụng khác cần phân đoạn ảnh chi tiết.
Tìm hiểu thêm về lợi ích và trường hợp sử dụng YOLO26 cho phân đoạn trong mục phân đoạn ảnh.
Có. Model pose YOLO26 phát hiện keypoint, chẳng hạn như khớp cơ thể người, trong ảnh và frame video rồi kết nối chúng thành pose. Tính năng này hữu ích để tracking chuyển động trong phân tích thể thao, chăm sóc sức khỏe và các ứng dụng tương tác người-máy.
Để biết thêm chi tiết và mẹo triển khai, hãy xem ví dụ ước lượng tư thế của chúng tôi.
Phát hiện đối tượng định hướng (OBB) bằng YOLO26 dự đoán thêm một tham số góc cho mỗi box, nhờ đó định vị đối tượng xoay sát hơn so với box căn theo trục. Tính năng này hữu ích cho các ứng dụng cần định vị chính xác đối tượng xoay, chẳng hạn như phân tích ảnh hàng không và tự động hóa kho bãi.
- Box khít hơn: Box xoay chứa ít nền hơn, giúp tách biệt các đối tượng nằm sát nhau hoặc nghiêng góc.
- Ứng dụng đa dạng: Hữu ích cho các tác vụ phân tích không gian địa lý, robot học, v.v.
Xem mục Phát hiện đối tượng có định hướng để biết thêm chi tiết và ví dụ.


Bình luận15
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(đã chỉnh sửa)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(đã chỉnh sửa)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(đã chỉnh sửa)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1