YOLO 的 OpenVINO 推理优化#
简介#
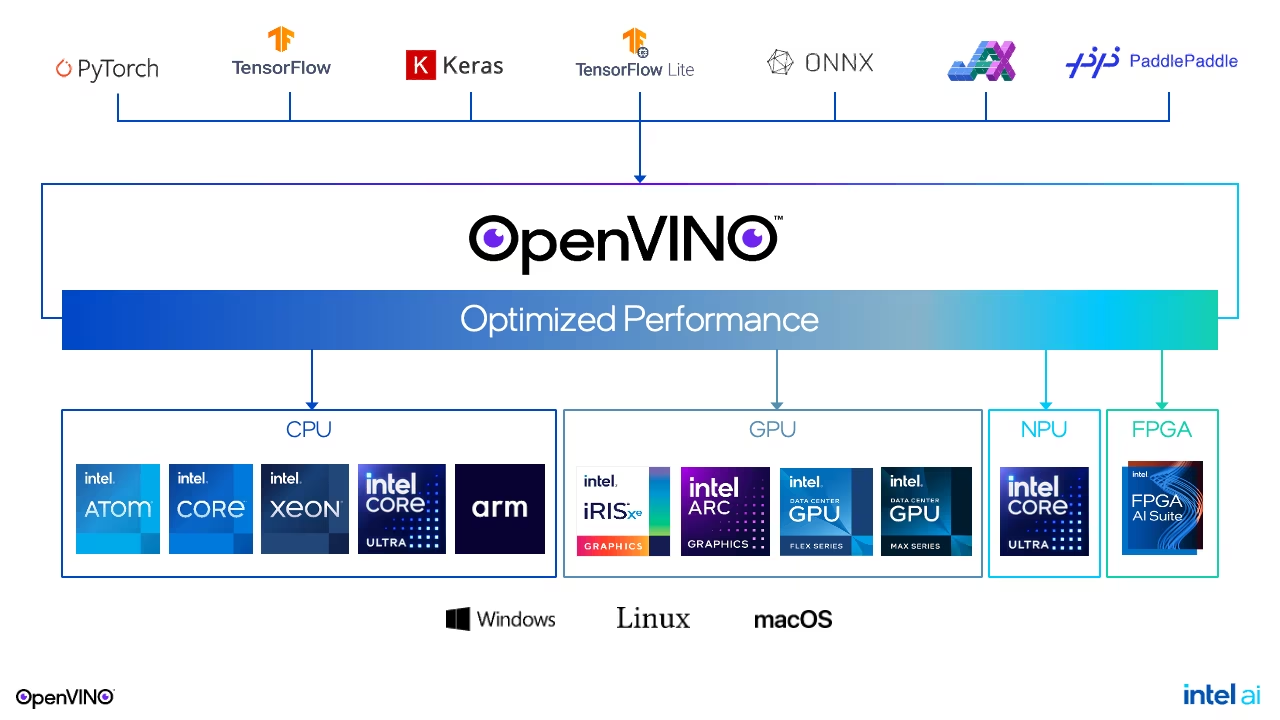
部署深度学习模型时,尤其是 Ultralytics YOLO 等用于目标检测的模型,实现最佳性能至关重要。本指南深入介绍如何利用Intel 的 OpenVINO 工具套件优化推理,重点关注延迟和吞吐量。无论你开发的是消费级应用,还是大规模部署,了解并应用这些优化策略,都能确保模型在各种设备上高效运行。
针对延迟进行优化#
对于要求单个模型对单个输入立即作出响应的应用,降低延迟至关重要,这在消费级场景中很常见。目标是尽量缩短输入与推理结果之间的延迟。不过,要实现低延迟,需要仔细权衡,尤其是在并发运行推理或管理多个模型时。
延迟优化的关键策略#
- 每台设备执行单次推理:实现低延迟最简单的方法是限制每台设备一次只执行一个推理任务。增加并发通常会导致延迟上升。
- 利用子设备:多插槽 CPU 或多芯片 GPU 等设备可以利用内部子设备执行多个请求,同时只带来极小的延迟增长。
- OpenVINO 性能提示:在模型编译期间,使用 OpenVINO 的
ov::LATENCY设置ov::performance_mode属性,可简化性能调优,并提供与设备无关且面向未来的方案。
管理首次推理延迟#
- 模型缓存:为避免模型加载和编译时间影响延迟,请尽可能使用模型缓存。如果无法使用缓存,CPU 通常能提供最快的模型加载速度。
- 模型映射与读取:为缩短加载时间,OpenVINO 使用映射取代了模型读取。不过,如果模型位于可移动磁盘或网络驱动器上,可以考虑使用
ov::enable_mmap(false)切换回读取方式。 - AUTO 设备选择:此模式会先在 CPU 上开始推理,待加速器就绪后再切换过去,从而无缝降低首次推理延迟。
针对吞吐量进行优化#
对于需要同时处理大量推理请求的场景,优化吞吐量至关重要;这样可以最大限度地提高资源利用率,同时不会大幅牺牲单个请求的性能。
吞吐量优化方法#
-
OpenVINO 性能提示:使用性能提示提升各类设备的吞吐量,这是一种高级且面向未来的方法。
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
显式批处理与流:一种更精细的方法,通过显式批处理和使用流来进行高级性能调优。
设计面向吞吐量的应用#
要最大限度地提高吞吐量,应用应当:
- 并行处理输入,充分利用设备的能力。
- 将数据流拆分为并发推理请求,并安排这些请求并行执行。
- 使用带回调的 Async API 来保持效率并避免设备闲置。
多设备执行#
OpenVINO 的多设备模式可自动在多个设备间平衡推理请求,无需在应用层管理设备,从而简化吞吐量扩展。
实际性能提升#
使用 Ultralytics YOLO 模型实现 OpenVINO 优化,可显著提升性能。正如基准测试所示,用户在 Intel CPU 上的推理速度最高可提升 3 倍;在 Intel 的各类硬件上,包括集成 GPU、独立 GPU 和 NPU,还可能获得更大的加速效果。
例如,在 Intel Xeon CPU 上运行 YOLO26 模型时,OpenVINO 优化版本在单张图像的推理时间方面始终优于 PyTorch 对应版本,同时不会影响精度。
实际实现#
要将 Ultralytics YOLO 模型导出并优化为 OpenVINO 格式,可以使用导出功能:
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n.pt")

# 将模型导出为 OpenVINO 格式
model.export(format="openvino", quantize=16)  # 以 FP16 精度导出
导出后,你可以使用优化后的模型运行推理:
# 加载 OpenVINO 模型
ov_model = YOLO("yolo26n_openvino_model/")

# 运行推理(Ultralytics 使用 LATENCY 性能提示编译 OpenVINO 模型)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)结论#
使用 OpenVINO 优化 Ultralytics YOLO 模型的延迟和吞吐量,可显著提升应用性能。开发者仔细应用本指南中介绍的策略,就能确保模型高效运行,满足各种部署场景的需求。请记住,选择优化延迟还是吞吐量,取决于具体的应用需求和部署环境的特点。
如需了解更详细的技术信息和最新动态,请参阅 OpenVINO 文档和 Ultralytics YOLO 代码库。这些资源提供深入指南、教程和社区支持,帮助你充分发挥深度学习模型的潜力。
确保模型实现最佳性能,不只是调整配置;还要了解应用需求并据此作出明智的决策。无论你是要优化实时响应,还是要提高大规模处理的吞吐量,Ultralytics YOLO 模型与 OpenVINO 的组合都能为开发者提供强大的工具集,用于部署高性能 AI 解决方案。
常见问题#
优化 Ultralytics YOLO 模型以实现低延迟,涉及以下几项关键策略:
- 每台设备执行单次推理:限制每台设备一次只执行一个推理任务,以尽量减少延迟。
- 利用子设备:使用多插槽 CPU 或多芯片 GPU 等设备,这些设备可以处理多个请求,同时只带来极小的延迟增长。
- OpenVINO 性能提示:在模型编译期间使用 OpenVINO 的
ov::LATENCY,简化与设备无关的调优。
如需了解更多实用的延迟优化技巧,请参阅指南中的延迟优化章节。
OpenVINO 可在不牺牲性能的前提下,最大限度地利用设备资源,从而提升 Ultralytics YOLO 模型的吞吐量。主要优势包括:
- 性能提示:以简单的高级方式跨设备进行性能调优。
- 显式批处理与流:针对高级性能进行精细调优。
- 多设备执行:自动平衡推理负载,简化应用层管理。
配置示例:
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config)如需详细了解吞吐量优化,请参阅详细指南中的吞吐量优化章节。
要降低首次推理延迟,可以考虑以下做法:
- 模型缓存:使用模型缓存缩短加载和编译时间。
- 模型映射与读取:默认使用映射(
ov::enable_mmap(true)),但如果模型位于可移动磁盘或网络驱动器上,则切换为读取(ov::enable_mmap(false))。 - AUTO 设备选择:使用 AUTO 模式,先在 CPU 上开始推理,再无缝切换到加速器。
如需了解管理首次推理延迟的详细策略,请参阅管理首次推理延迟章节。
平衡延迟和吞吐量优化,需要了解应用的需求:
- 延迟优化:适用于需要立即响应的实时应用(例如消费级应用)。
- 吞吐量优化:适用于有大量并发推理任务的场景,能够最大限度地利用资源(例如大规模部署)。
使用 OpenVINO 的高级性能提示和多设备模式,有助于找到合适的平衡点。根据你的具体需求选择合适的 OpenVINO 性能提示。
可以,Ultralytics YOLO 模型用途广泛,可以集成到各种 AI 框架中。可选方案包括:
- TensorRT:针对 NVIDIA GPU 进行优化,请参阅 TensorRT 集成指南。
- CoreML:适用于 Apple 设备,请参阅我们的 CoreML 导出说明。
- LiteRT.js:适用于 Web 和 Node.js 应用,请参阅 LiteRT 集成指南和 LiteRT.js Web 运行时。
在 Ultralytics 集成页面了解更多集成方案。