使用 Ultralytics YOLO 进行数据增强
简介#
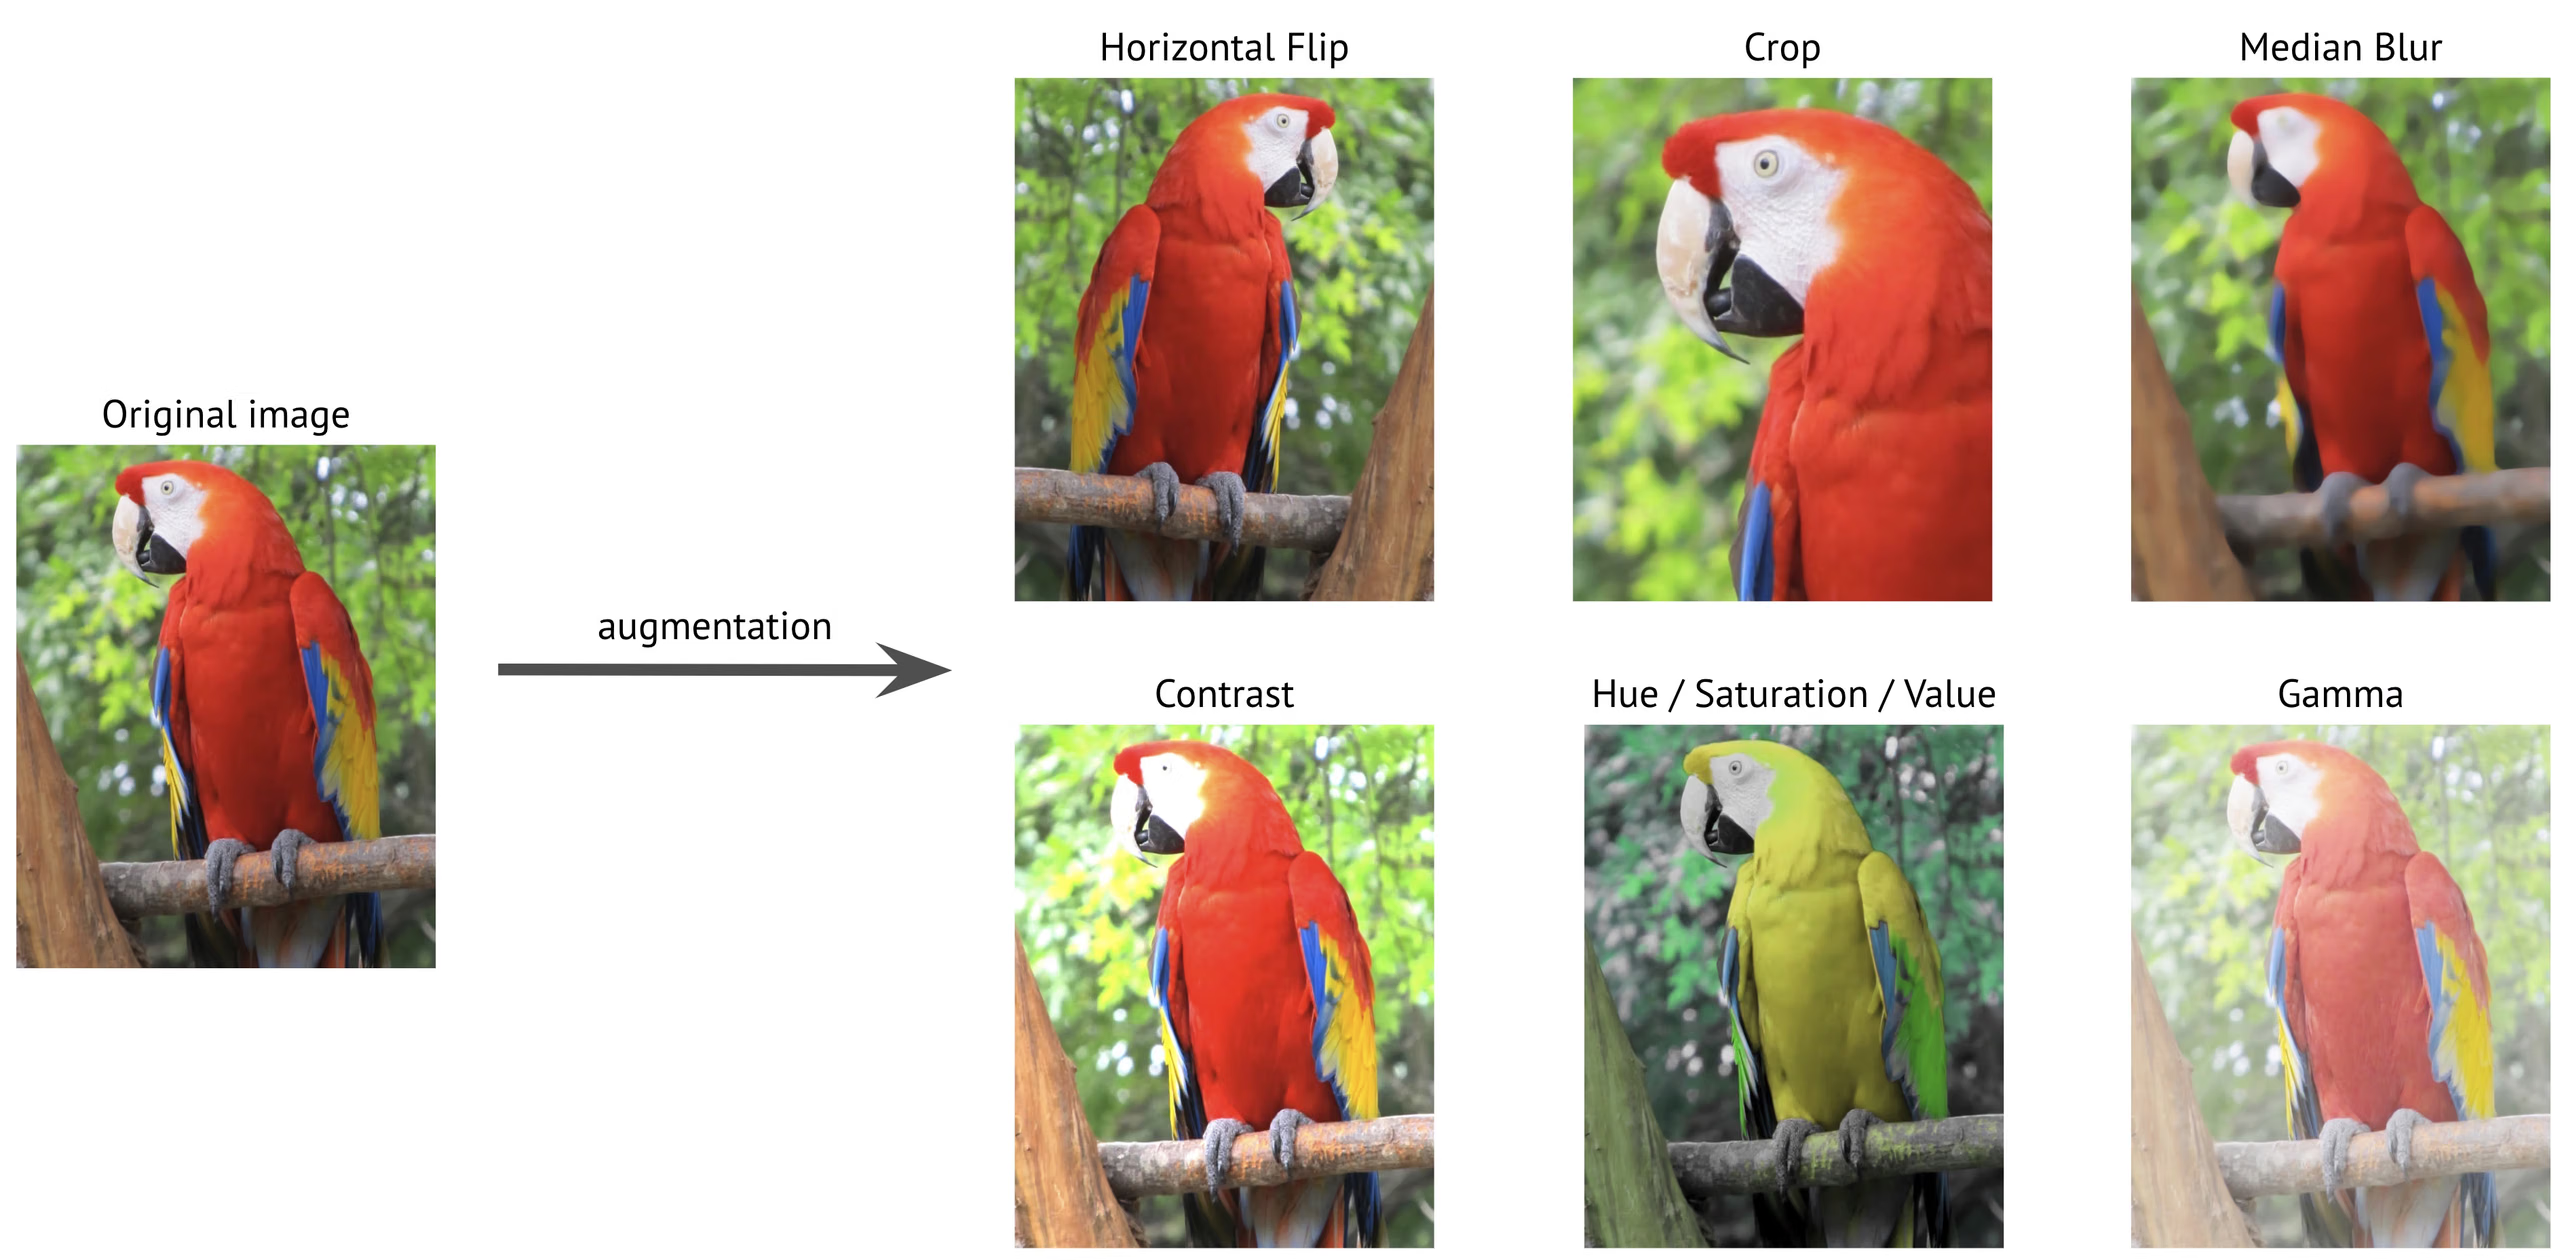
数据增强是计算机视觉中的一项关键技术,它通过对现有图像应用各种变换,人为扩充训练数据集。训练 Ultralytics YOLO 等深度学习模型时,数据增强有助于提升模型鲁棒性、减少过拟合,并增强模型对真实场景的泛化能力。
观看: 如何使用 Mosaic、MixUp 等数据增强方法,帮助 Ultralytics YOLO 模型提升泛化能力 🚀
数据增强为何重要#
数据增强在计算机视觉模型训练中发挥着多项关键作用:
- 扩充数据集:通过生成现有图像的变体,你可以有效扩大训练数据集,而无需收集新数据。
- 提升泛化能力:模型能够学习在各种条件下识别物体,从而在实际应用中更具鲁棒性。
- 减少过拟合:通过在训练数据中引入变化,模型不太可能记住特定的图像特征。
- 提升性能:使用适当增强方法训练的模型通常能在验证集和测试集上取得更高的准确率。
Ultralytics YOLO 的实现提供了一套全面的数据增强技术,每种技术都有特定用途,并以不同方式提升模型性能。本指南将介绍以下增强设置,帮助你了解何时以及如何在项目中有效使用这些设置。
配置示例#
你可以通过 Python API、命令行界面 (CLI) 或配置文件自定义每个参数。以下示例展示了如何通过每种方法设置数据增强。
import albumentations as A

from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n.pt")

# 使用自定义增强参数进行训练
model.train(data="coco8.yaml", epochs=100, hsv_h=0.03, hsv_s=0.6, hsv_v=0.5)

# 禁用所有可配置增强项进行训练(为清晰起见,省略已禁用的值)
model.train(
    data="coco8.yaml",
    epochs=100,
    hsv_h=0.0,
    hsv_s=0.0,
    hsv_v=0.0,
    translate=0.0,
    scale=0.0,
    fliplr=0.0,
    mosaic=0.0,
    erasing=0.0,
    auto_augment=None,
)

# 使用自定义 Albumentations 变换进行训练(仅限 Python API)
custom_transforms = [
    A.Blur(blur_limit=7, p=0.5),
    A.CLAHE(clip_limit=4.0, p=0.5),
]
model.train(data="coco8.yaml", epochs=100, augmentations=custom_transforms)本页列出的变换可通过训练参数进行控制。只要安装了 albumentations 包,Ultralytics 还会应用一组轻量级的 Albumentations 变换——模糊、中值模糊、灰度化和 CLAHE,每种变换的概率均为 p=0.01;而且 default.yaml 中没有任何参数可以将其关闭。卸载该包即可移除这些变换,或者向 augmentations 传入你自己的变换列表来替换它们。
使用配置文件#
你可以在 YAML 配置文件(例如 train_custom.yaml)中定义所有训练参数,包括增强参数。只有使用 CLI 时才需要 mode 参数。随后,这个新的 YAML 文件会覆盖 ultralytics 包中的默认配置文件。
# train_custom.yaml
# 'mode' is required only for CLI usage
mode: train
data: coco8.yaml
model: yolo26n.pt
epochs: 100
hsv_h: 0.03
hsv_s: 0.6
hsv_v: 0.5
然后使用 Python API 或 CLI 启动训练:
from ultralytics import YOLO

# 加载经过 COCO 预训练的 YOLO26n 模型
model = YOLO("yolo26n.pt")

# 使用自定义配置训练模型
model.train(cfg="train_custom.yaml")色彩空间增强#
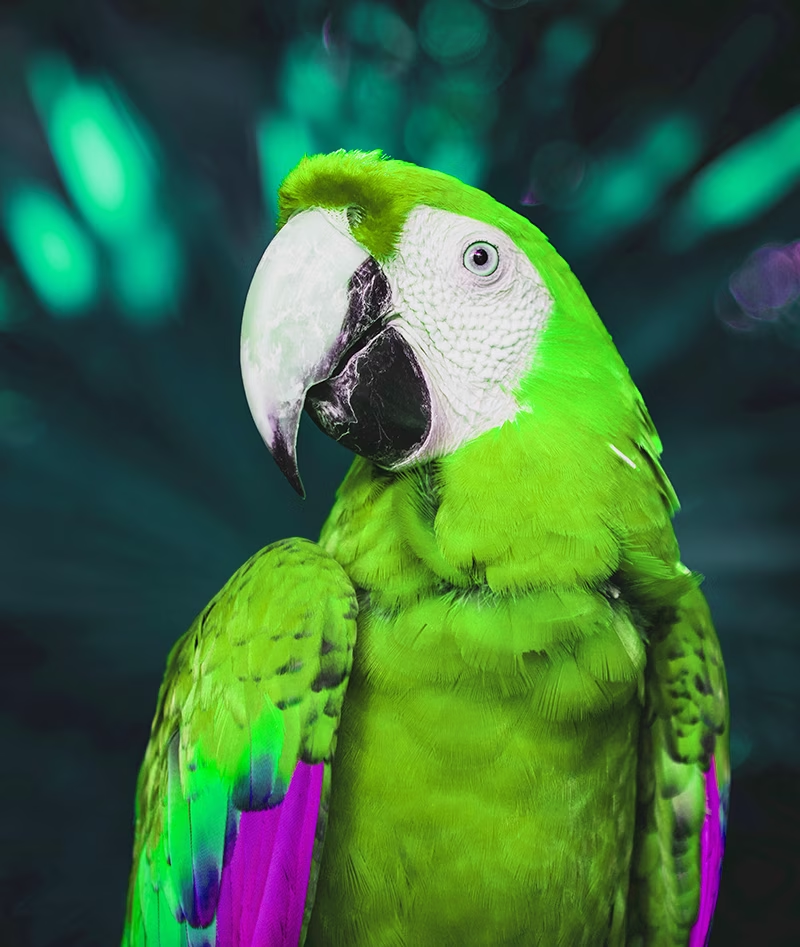
色调调整 (hsv_h)#
- 范围:
0.0-1.0 - 默认值:
0.015 - 用法:改变图像颜色,同时保持颜色之间的关系。
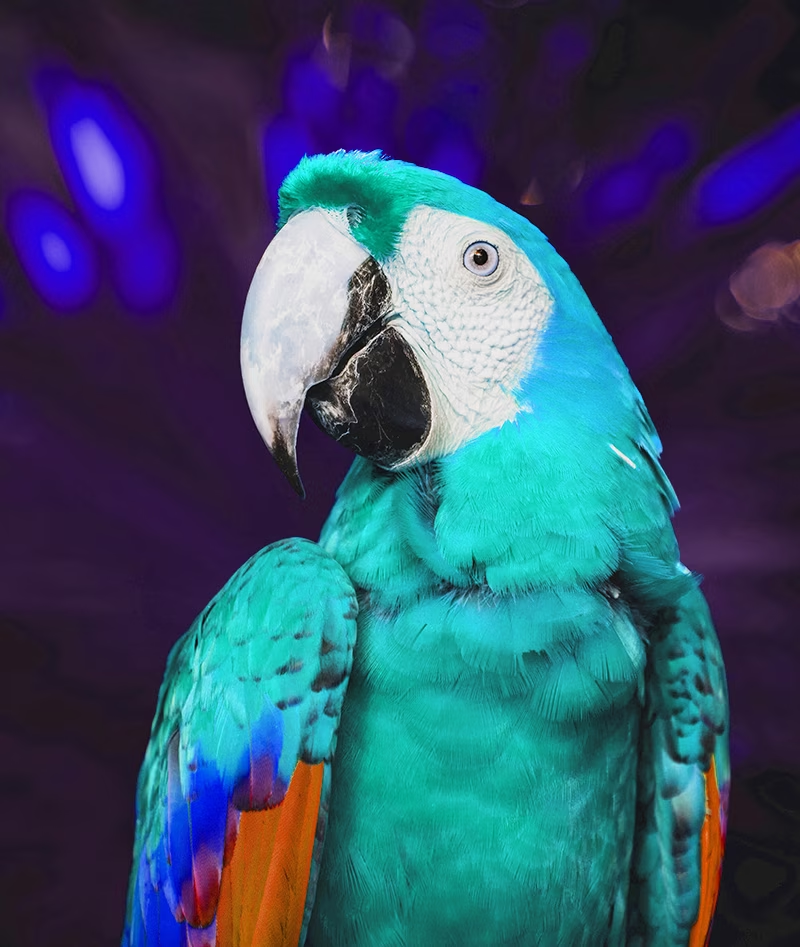
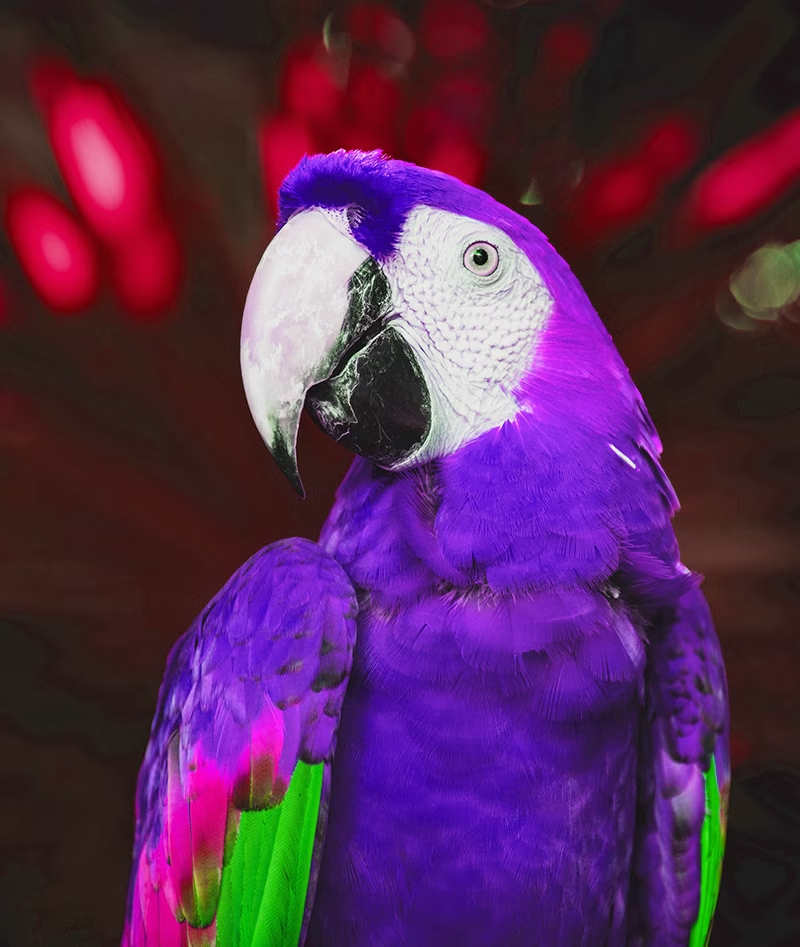
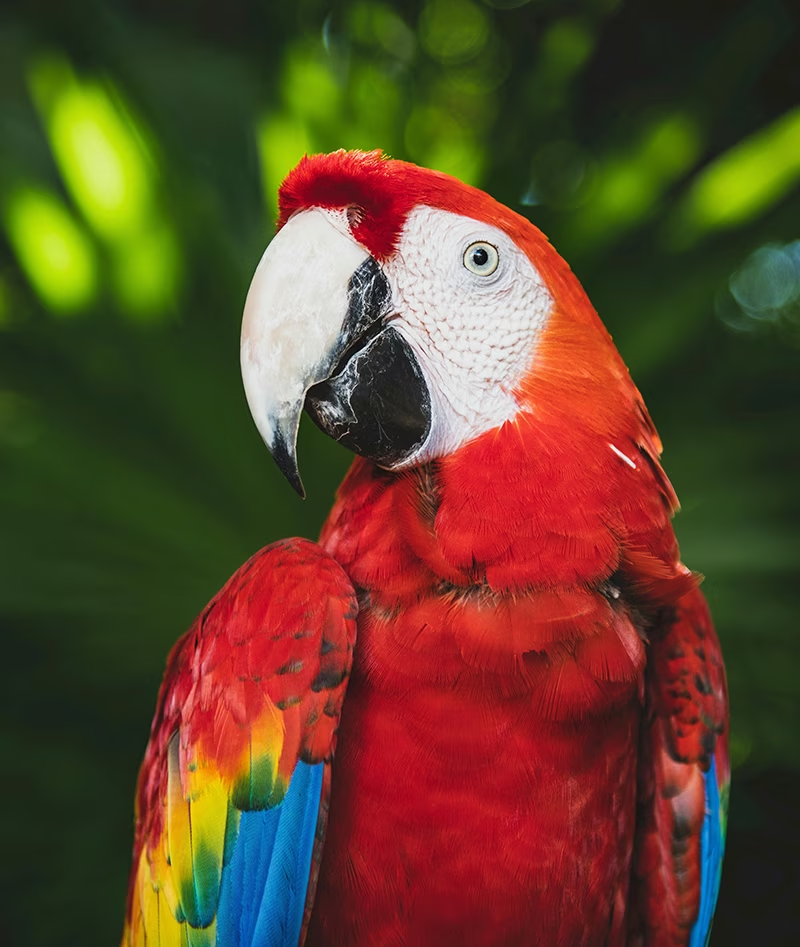
hsv_h超参数定义偏移幅度,最终调整值会在-hsv_h和hsv_h之间随机选取。例如,使用hsv_h=0.3时,偏移值会在-0.3到0.3之间随机选取。对于高于0.5的值,色相偏移会绕色轮循环,因此在0.5和-0.5时,增强效果看起来相同。 - 目的:这种方法对户外场景尤其有用,因为光照条件会显著影响物体外观。例如,香蕉在明亮的阳光下可能看起来更黄,而在室内则可能偏绿。
- Ultralytics 的实现:RandomHSV
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
 |  |  |  | |
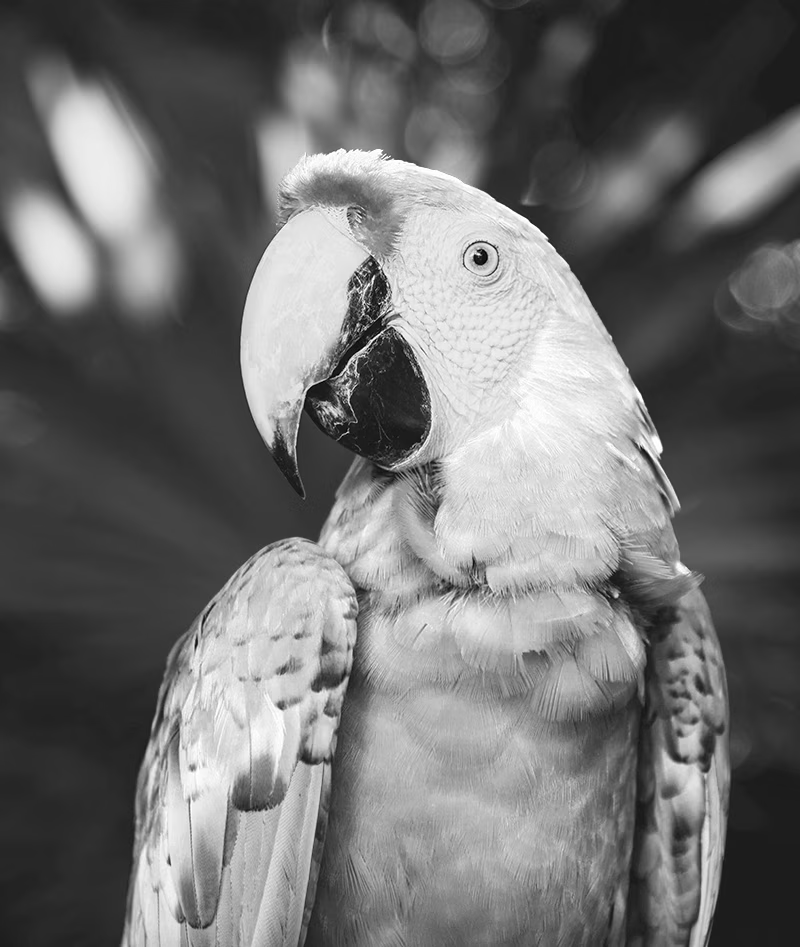
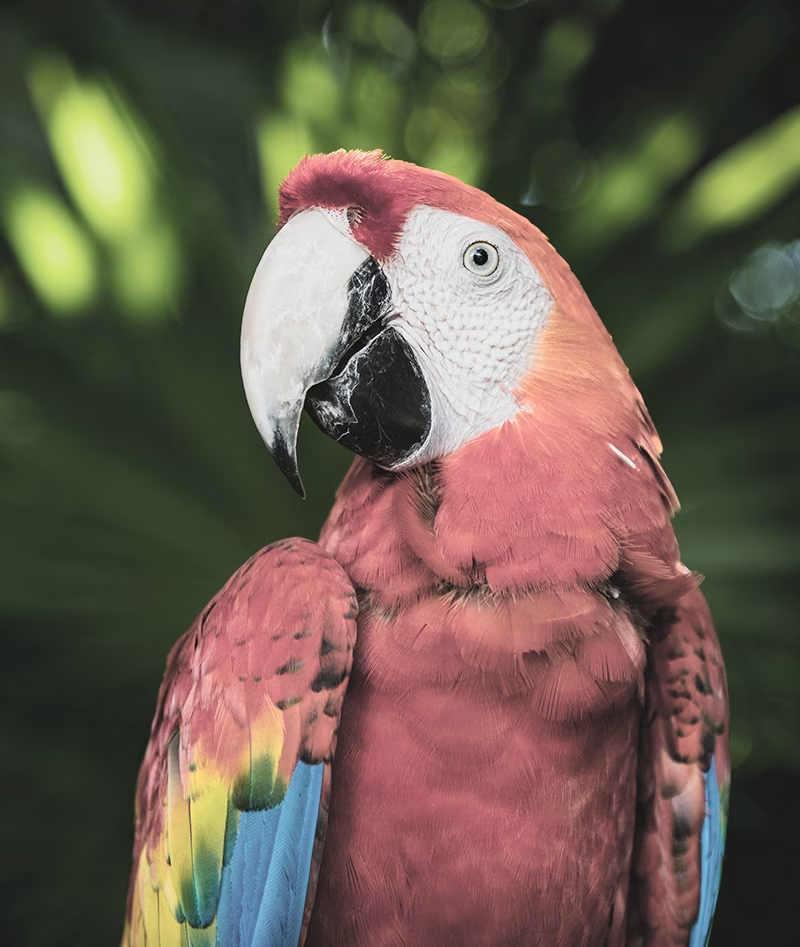
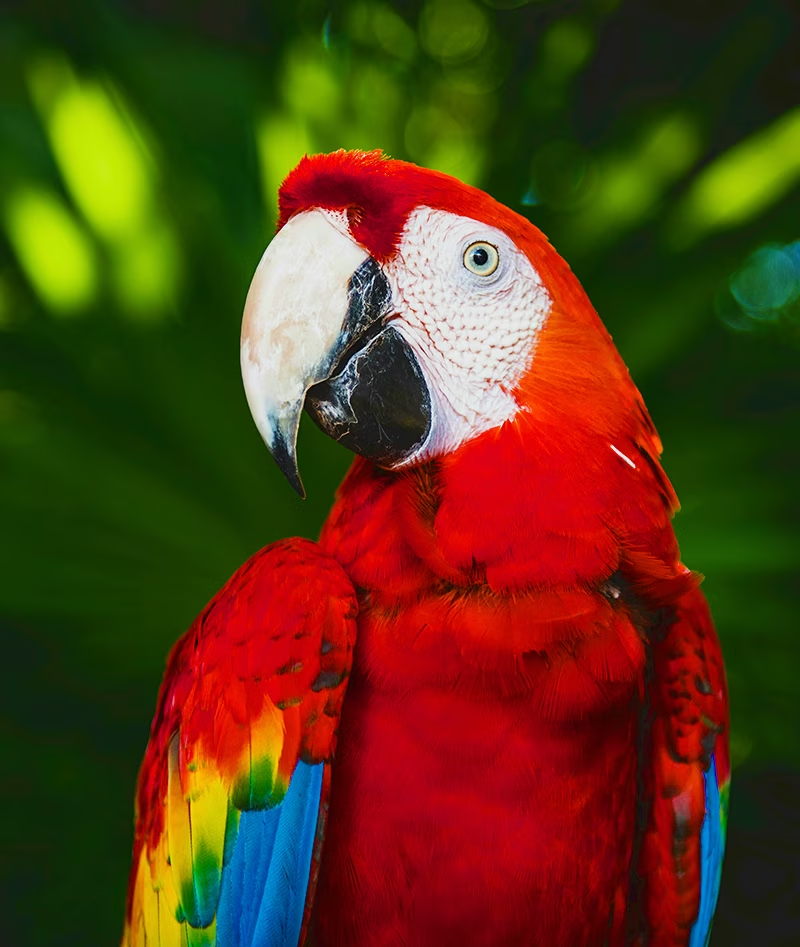
饱和度调整 (hsv_s)#
- 范围:
0.0-1.0 - 默认值:
0.7 - 用法:调整图像中颜色的强度。
hsv_s超参数定义偏移幅度,最终调整值会在-hsv_s和hsv_s之间随机选取。例如,设置为hsv_s=0.7时,强度会在-0.7到0.7之间随机选取。 - 目的:帮助模型适应不同的天气条件和相机设置。例如,红色交通标志在晴天可能颜色鲜艳,在有雾的条件下则可能显得暗淡褪色。
- Ultralytics 的实现:RandomHSV
-1.0 | -0.5 | 0.0 | 0.5 | 1.0 |
|---|---|---|---|---|
 |  | | 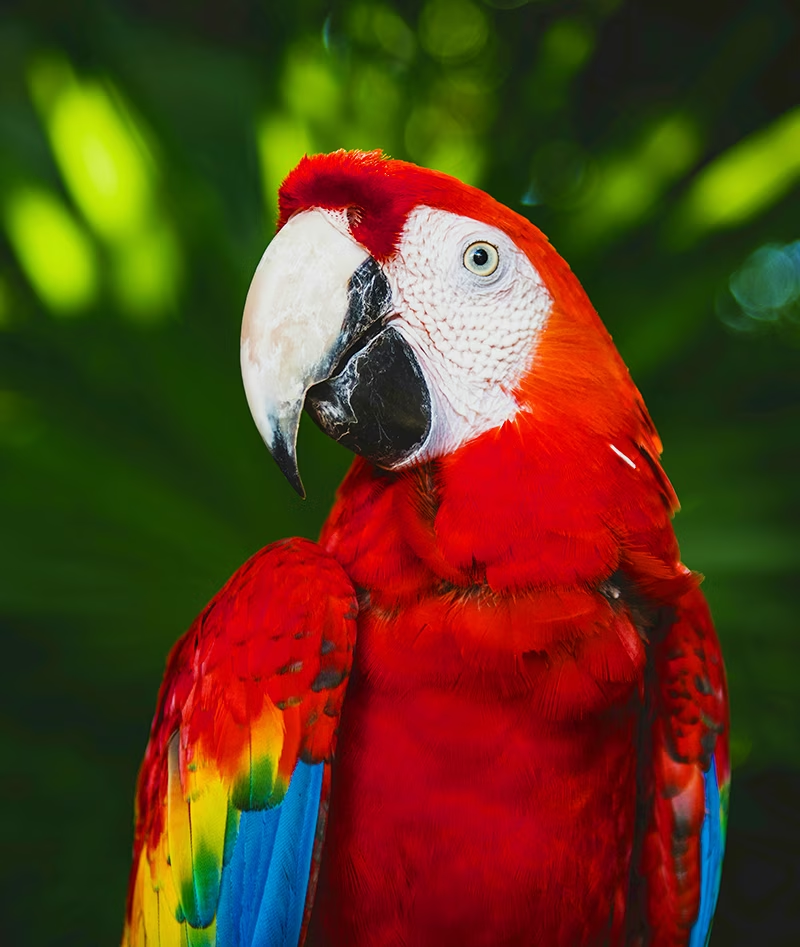 |  |
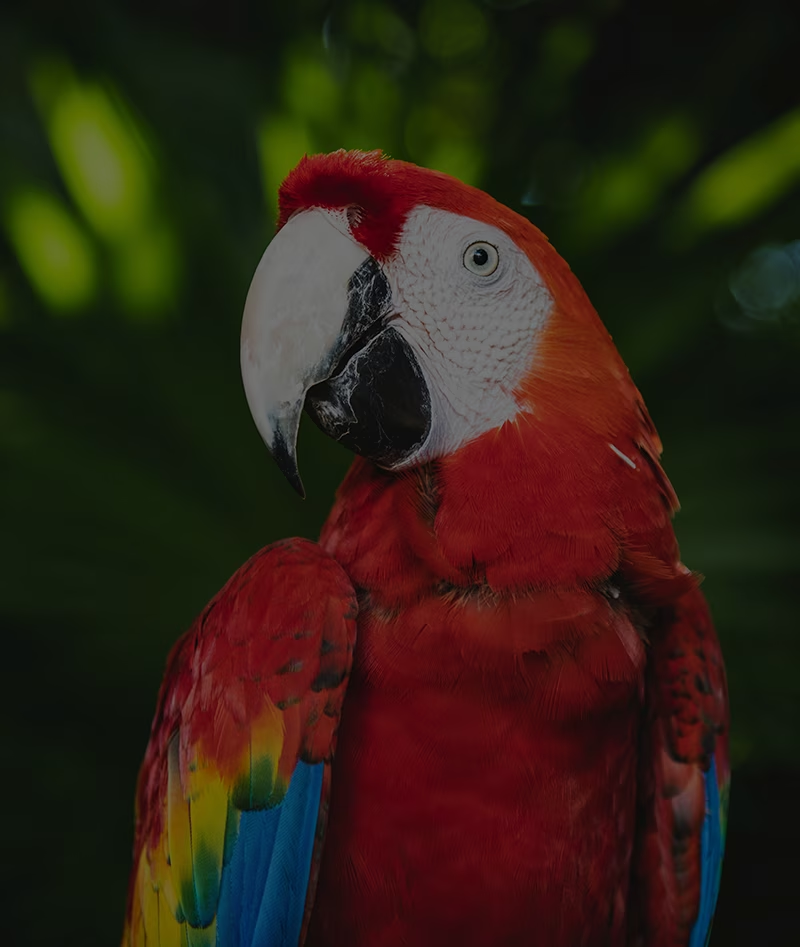
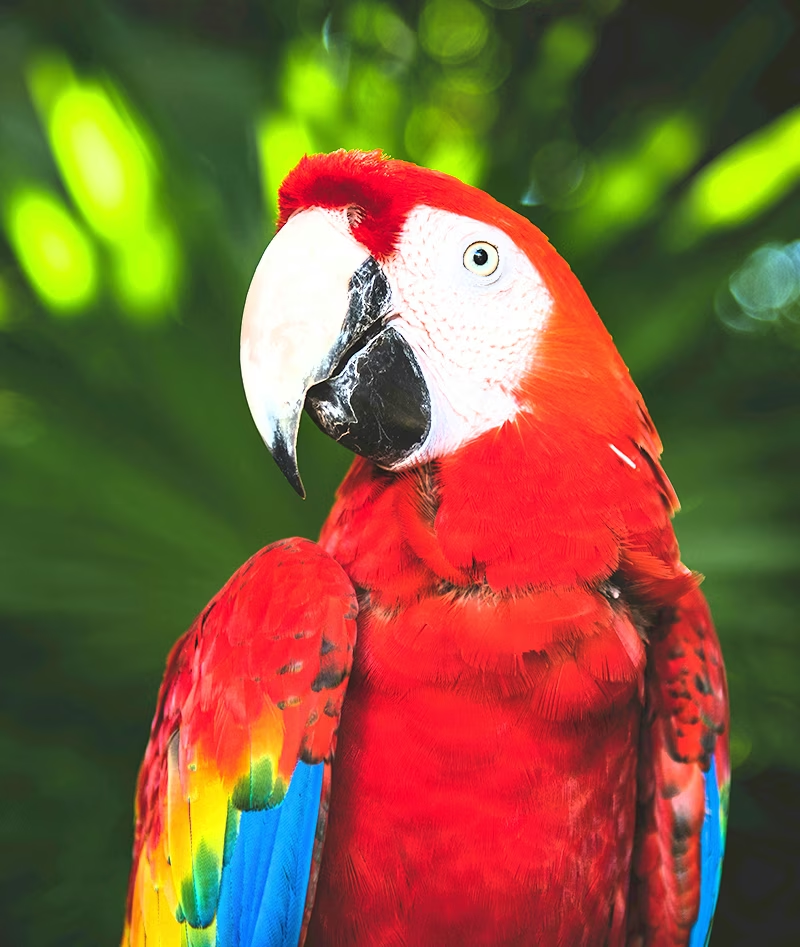
亮度调整 (hsv_v)#
- 范围:
0.0-1.0 - 默认值:
0.4 - 用法:改变图像亮度。
hsv_v超参数定义偏移幅度,最终调整值会在-hsv_v和hsv_v之间随机选取。例如,设置为hsv_v=0.4时,强度会在-0.4到0.4之间随机选取。 - 目的:对于需要在不同光照条件下运行的模型而言,这项增强必不可少。例如,红苹果在阳光下可能看起来很亮,在阴影中则会暗得多。
- Ultralytics 的实现:RandomHSV
-1.0 | -0.5 | 0.0 | 0.5 | 1.0 |
|---|---|---|---|---|
 |  | |  |  |
几何变换#
旋转 (degrees)#
- 范围:
0.0到180 - 默认值:
0 - 用法:在指定范围内随机旋转图像。
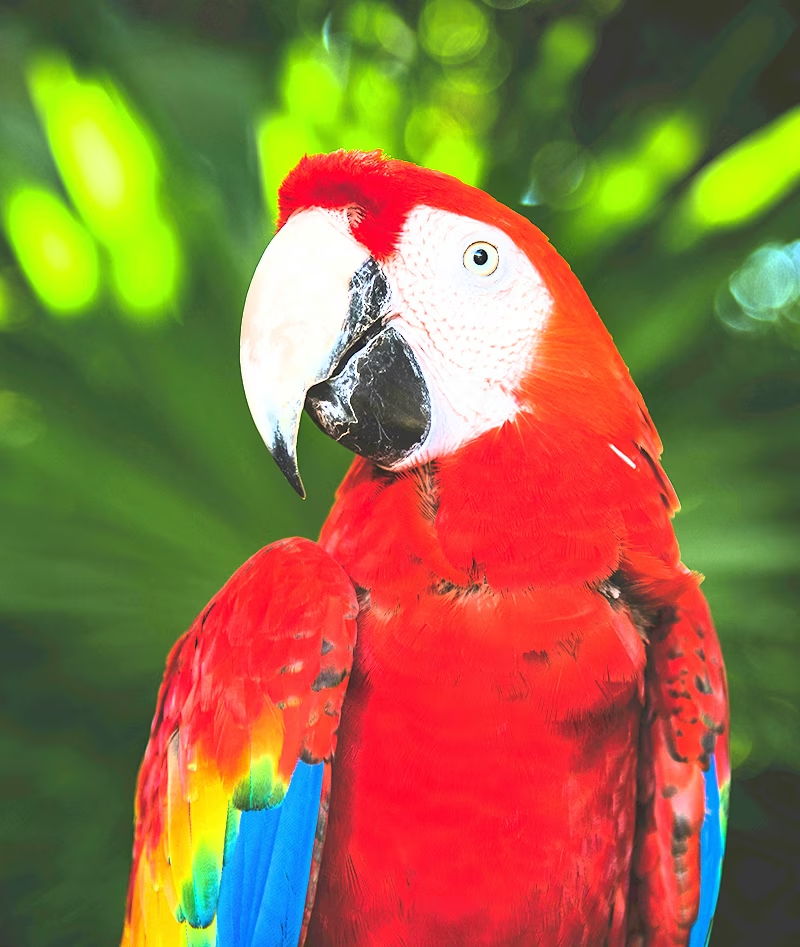
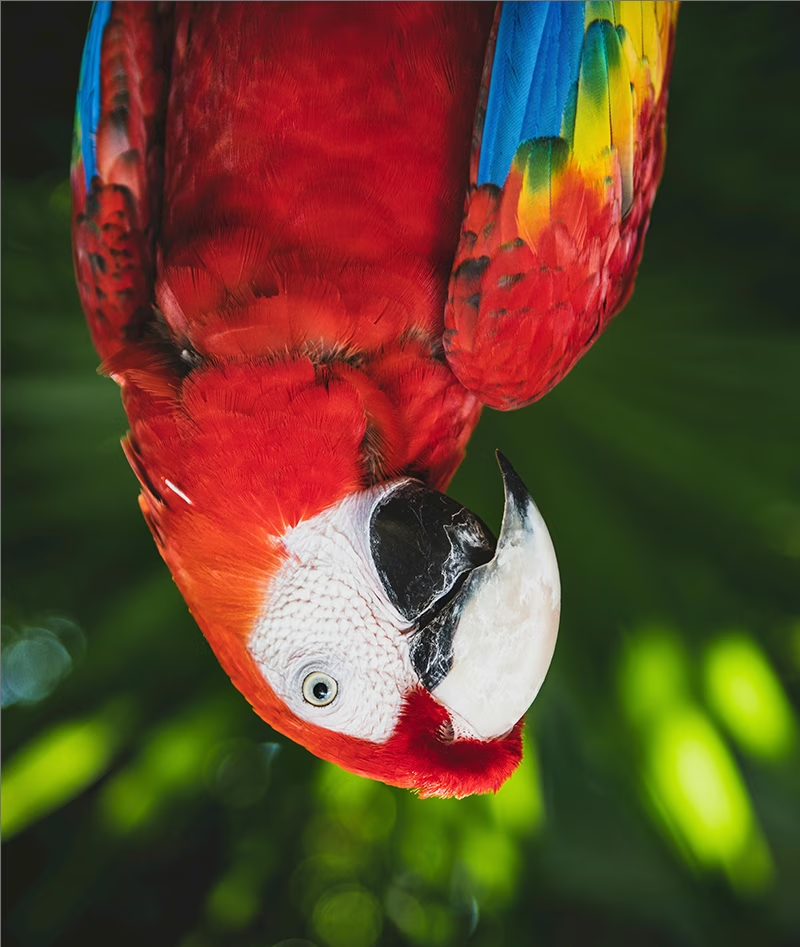
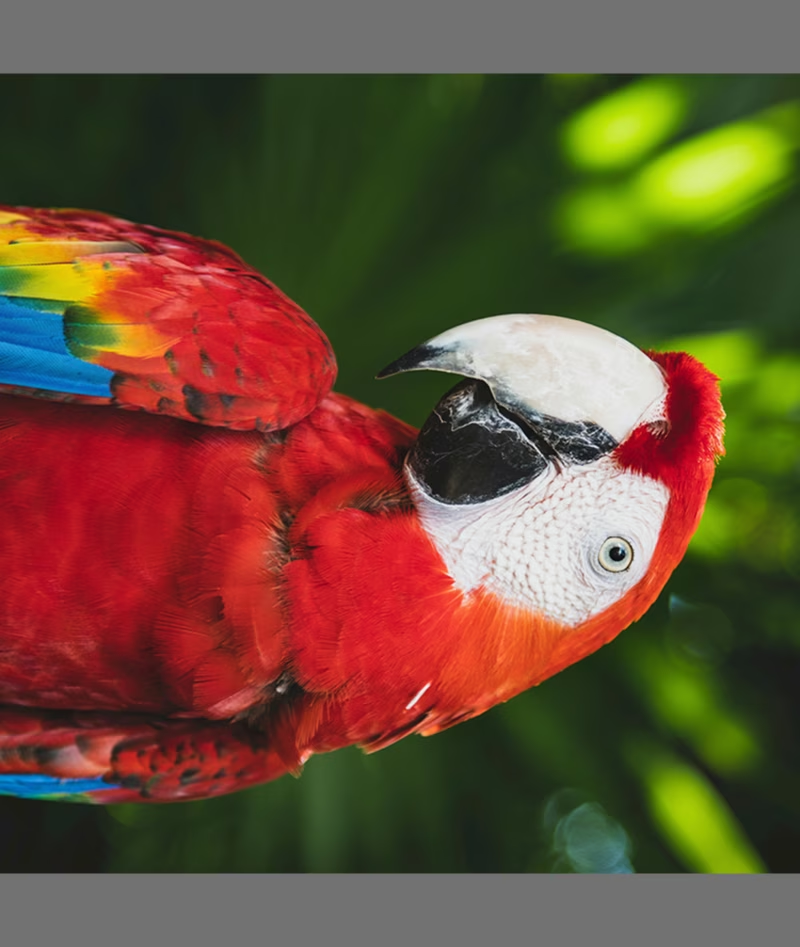
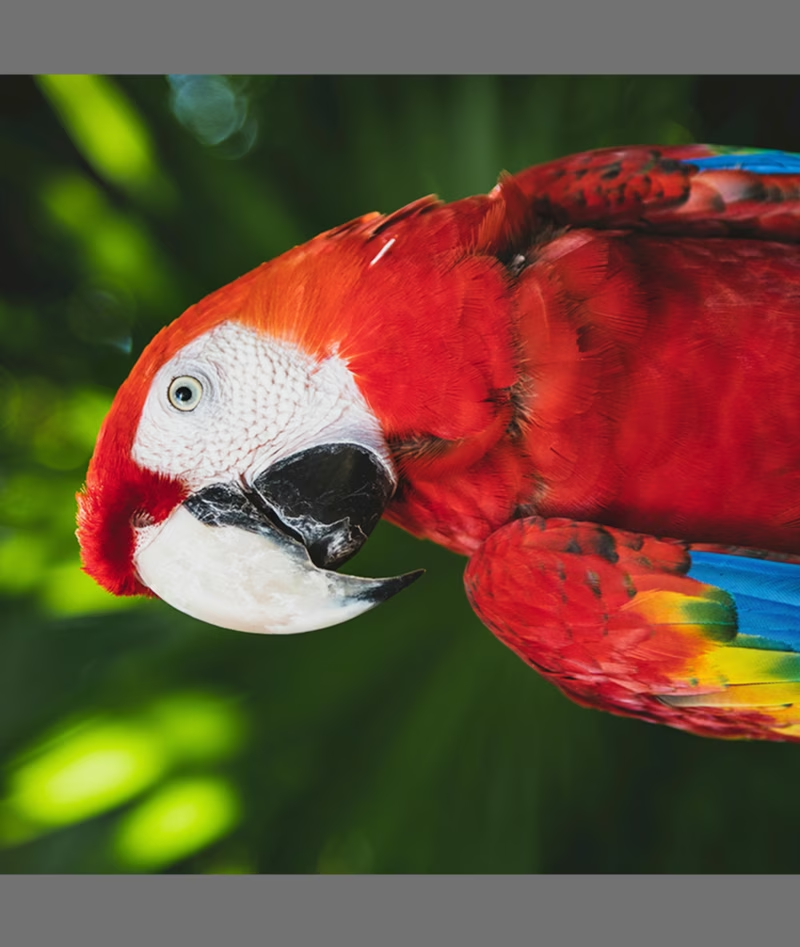
degrees超参数定义旋转角度,最终调整值会在-degrees和degrees之间随机选取。例如,设置为degrees=10.0时,旋转角度会在-10.0到10.0之间随机选取。 - 目的:对于物体可能以不同方向出现的应用场景,这项增强至关重要。例如,在无人机航拍图像中,车辆可能朝向任意方向,因此模型需要无论物体旋转角度如何都能识别它们。
- Ultralytics 的实现:RandomPerspective
-180 | -90 | 0.0 | 90 | 180 |
|---|---|---|---|---|
 |  | |  | |
平移 (translate)#
- 范围:
0.0-1.0 - 默认值:
0.1 - 用法:按图像尺寸的一定随机比例,沿水平方向和垂直方向移动图像。
translate超参数定义偏移幅度,最终调整值会在-translate和translate范围内随机选取两次(每个轴各选一次)。例如,设置为translate=0.5时,x 轴方向的平移量会在-0.5到0.5之间随机选取,y 轴方向则会在相同范围内独立随机选取另一个值。 - 目的:帮助模型学会检测部分可见的物体,并提升模型对物体位置的鲁棒性。例如,在车辆损伤评估应用中,汽车部件可能会因拍摄者的位置和距离而完整或部分出现在画面中;平移增强可以教会模型无论这些特征是否完整、位于何处,都能识别它们。
- Ultralytics 的实现:RandomPerspective
- 注意:为简单起见,下方应用的平移在
x和y轴上每次都相同。未展示-1.0和1.0的值,因为这些值会将图像完全移出画面。
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
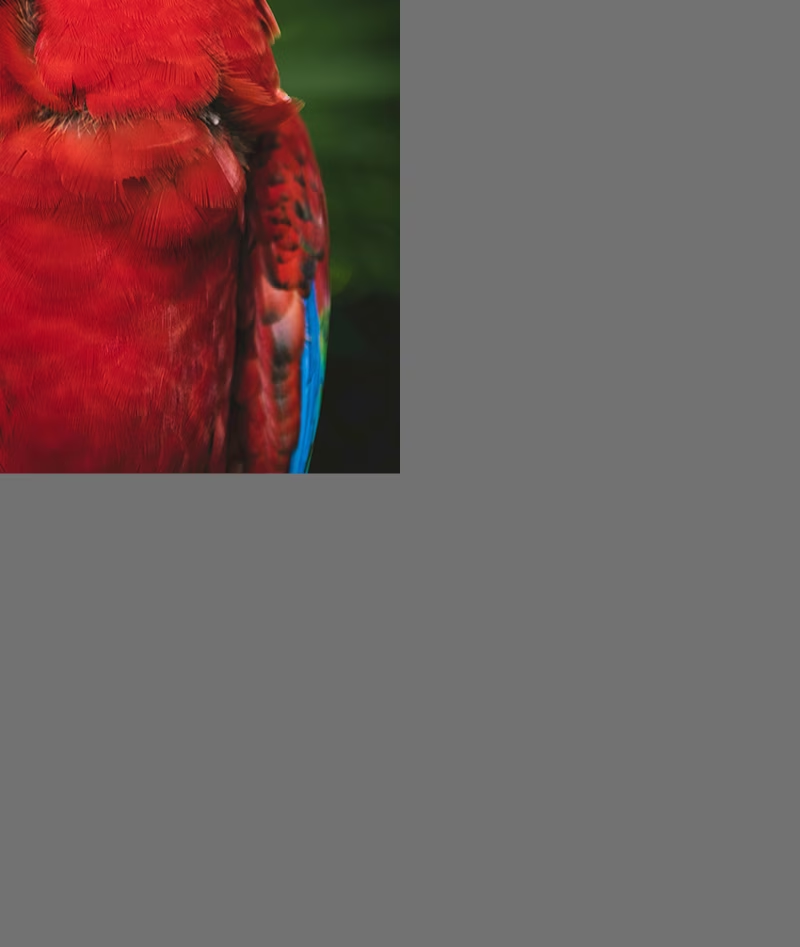 | 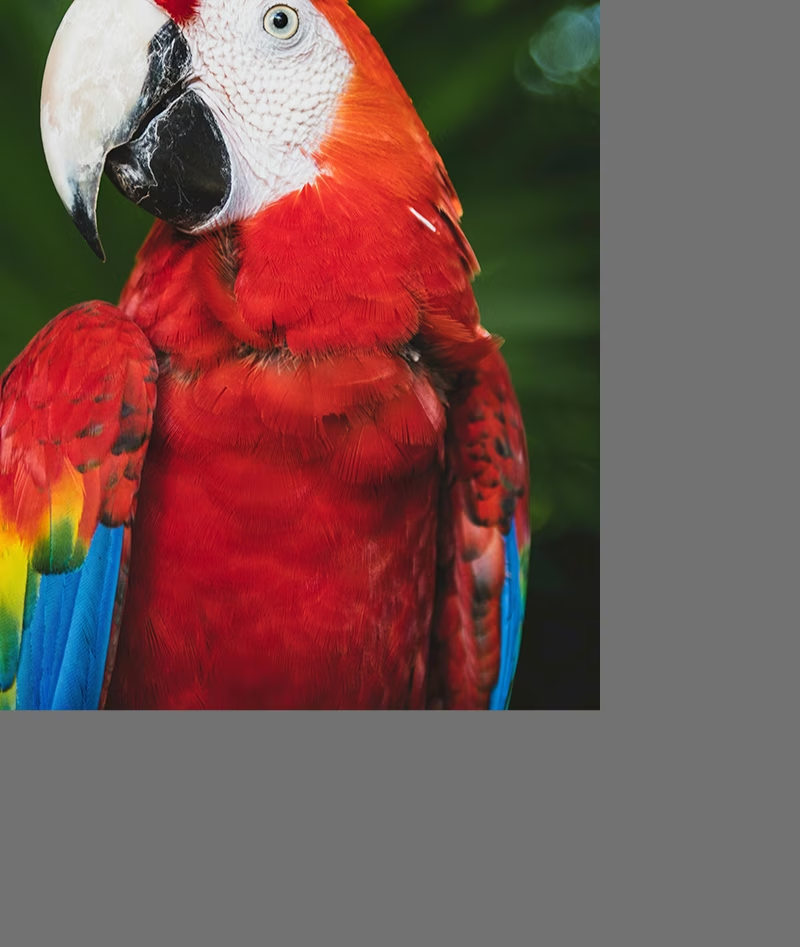 | | 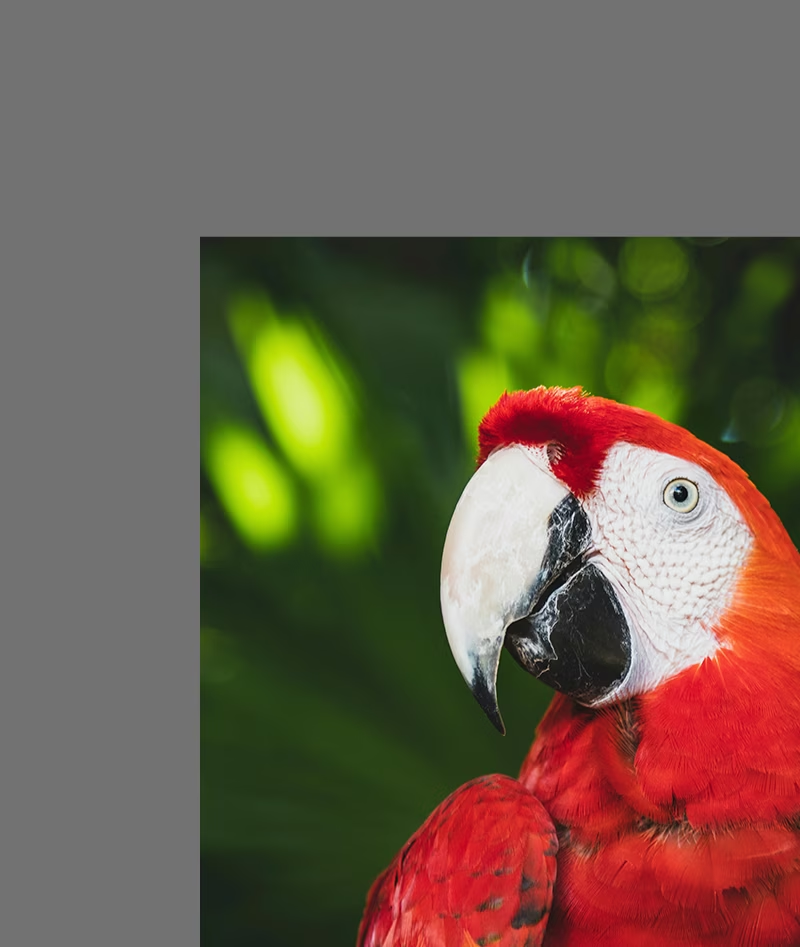 | 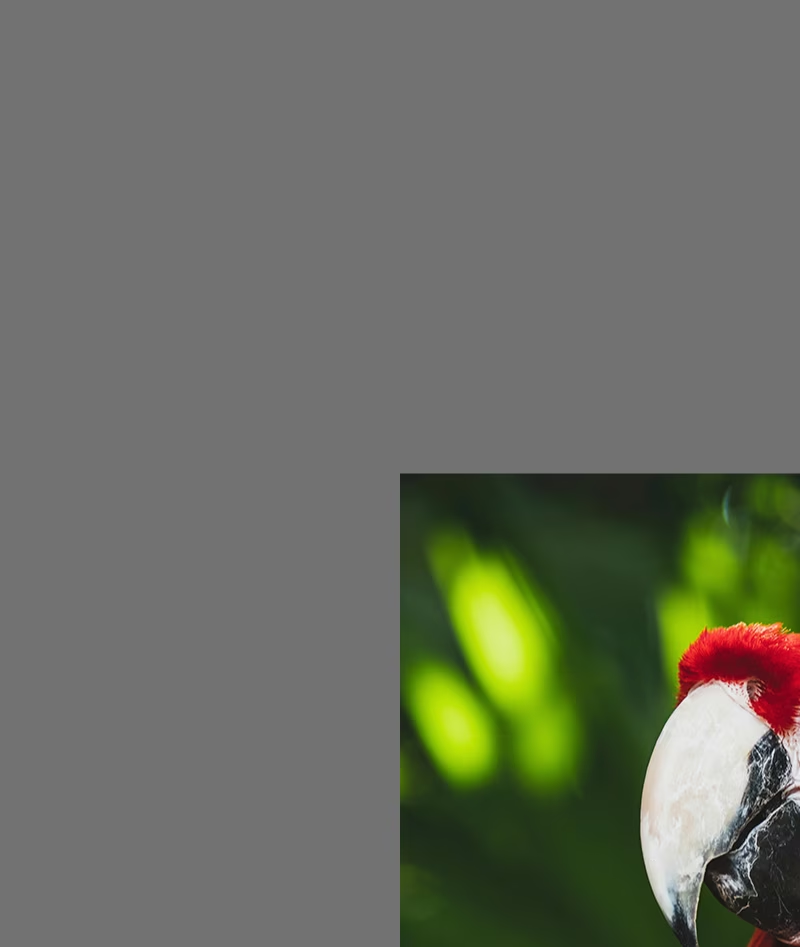 |
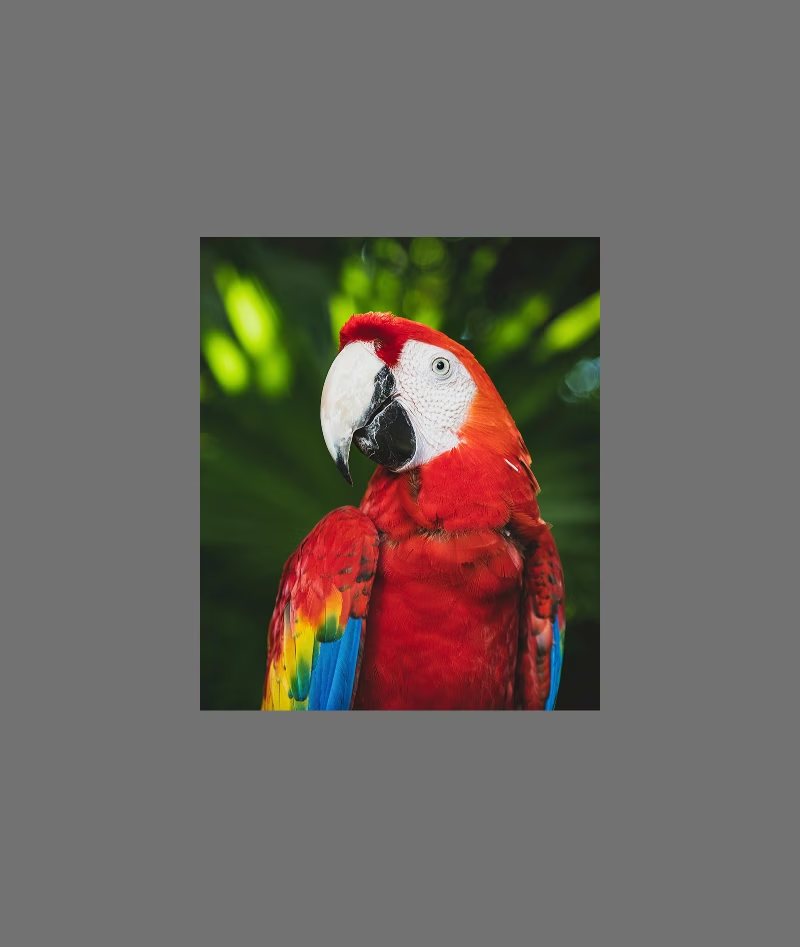
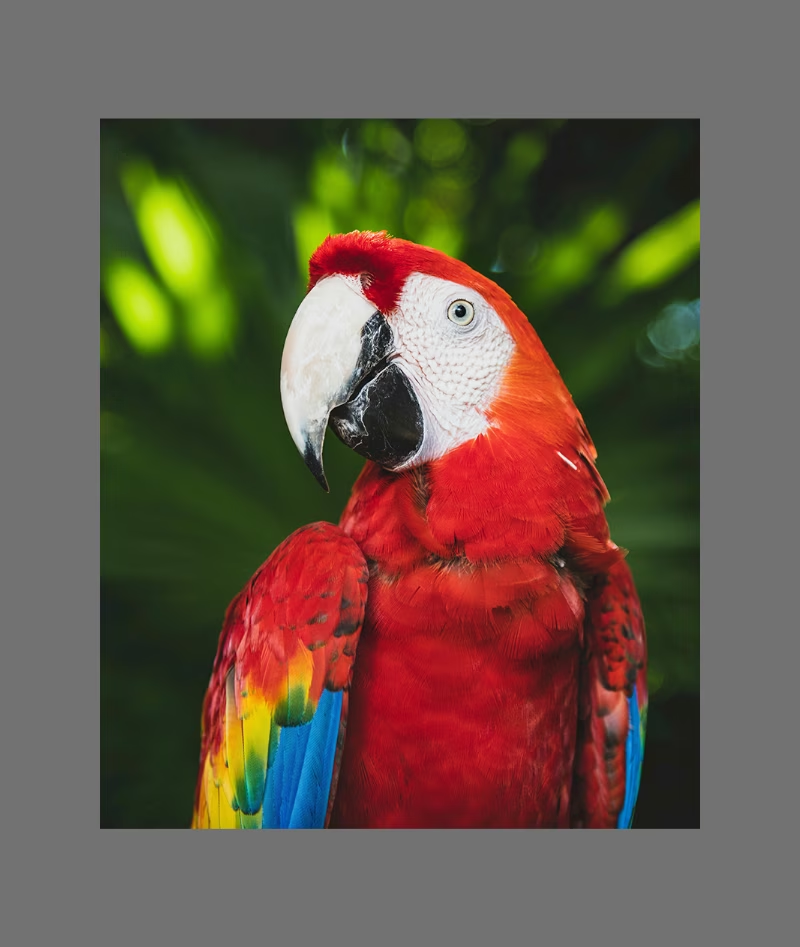
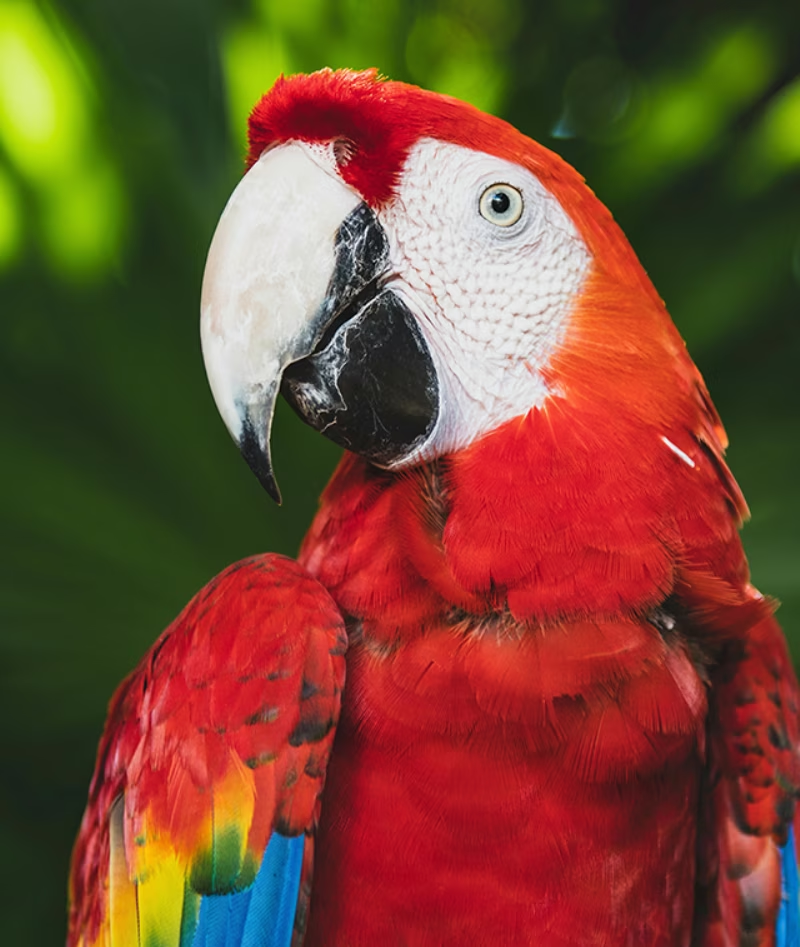
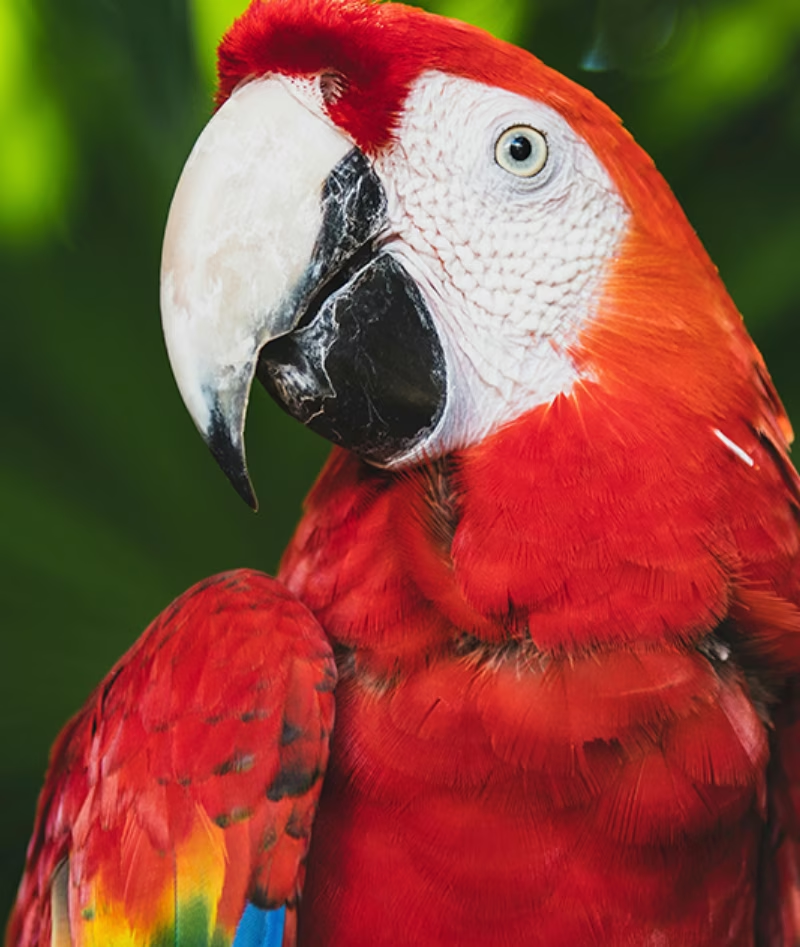
缩放 (scale)#
- 范围:浮点数
0.0-1.0,或显式指定的(min, max)元组 - 默认值:
0.5 - 用法:在指定范围内按随机因子调整图像尺寸。使用浮点数时,
scale超参数定义缩放增益,最终因子会在1-scale和1+scale之间随机选取。例如,设置为scale=0.5时,缩放因子会在0.5到1.5之间随机选取。使用元组时,scale会直接设定该范围,因此scale=(0.5, 2.0)会在0.5和2.0之间采样缩放因子。 - 目的:让模型能够处理不同距离和尺寸的物体。例如,在自动驾驶应用中,车辆与相机之间的距离各不相同,因此模型需要无论车辆尺寸如何都能识别它们。
- Ultralytics 的实现:RandomPerspective
- 注意:
- 此处未展示
-1.0的值,因为它会使图像消失;1.0则只会产生 2 倍缩放效果。 - 下表显示的是实际生成的缩放变化量,而不是你传给
scale超参数的值。 - 浮点数形式的值会被限制在
0.0-1.0范围内,超出范围会引发ValueError。若要采样超过 2 倍缩放的因子,请改用(min, max)元组形式。 - 元组形式仅适用于几何任务。分类训练会根据浮点数(
1.0 - scale到1.0)推导自己的裁剪范围,因此在此处传入元组会引发TypeError。
- 此处未展示
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
 |  | |  |  |
剪切 (shear)#
- 范围:
-180到+180 - 默认值:
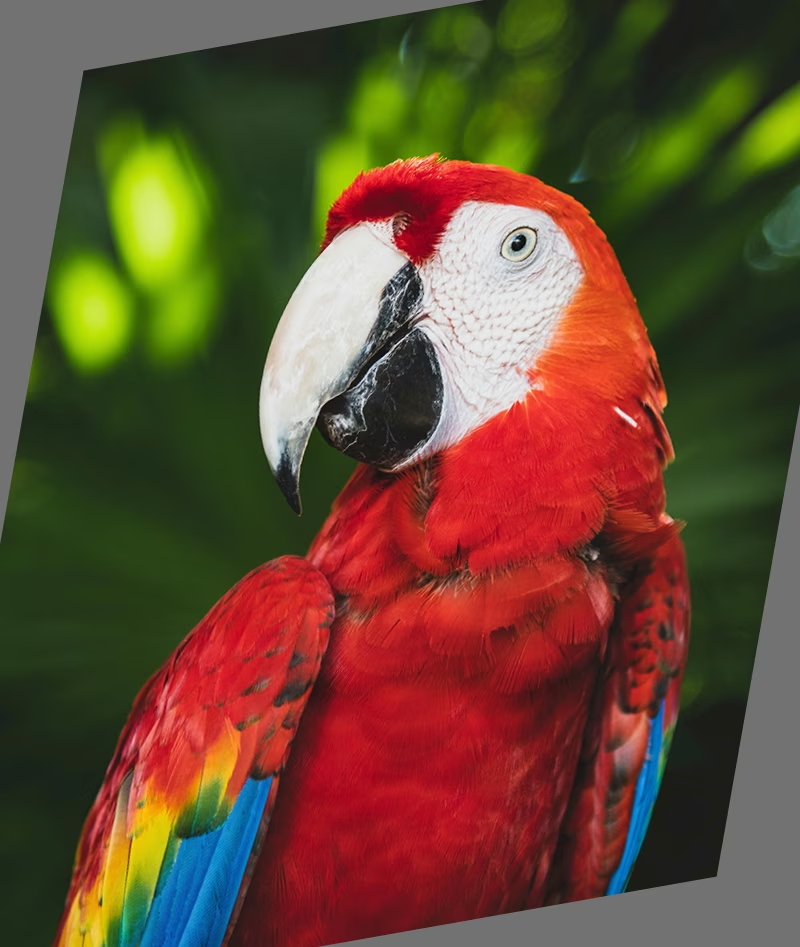
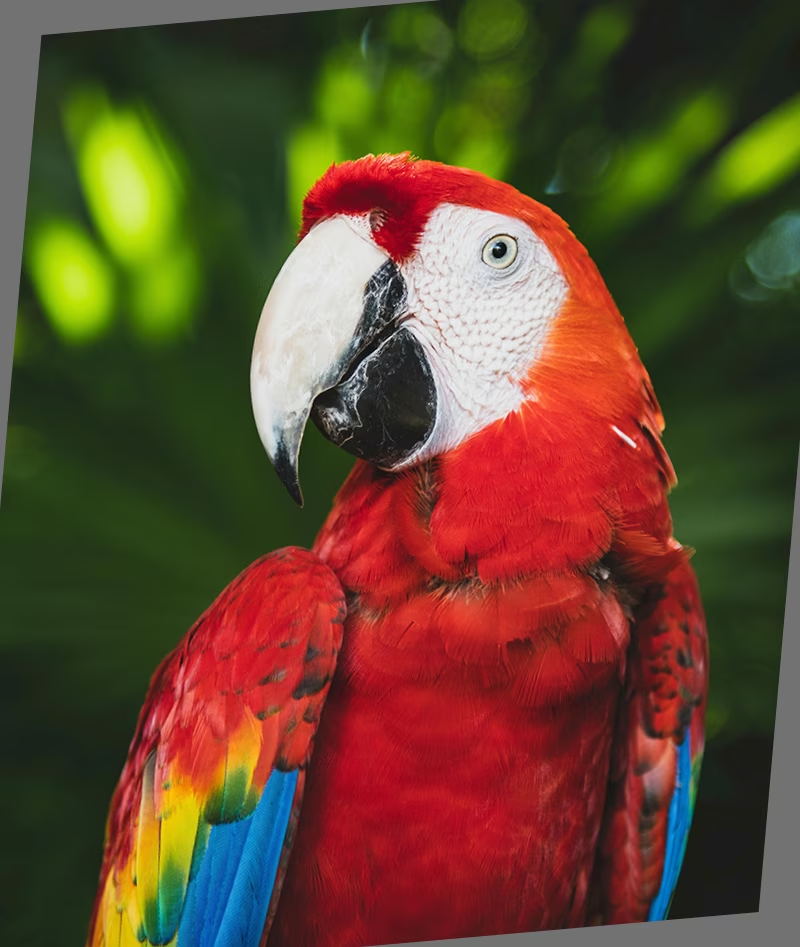
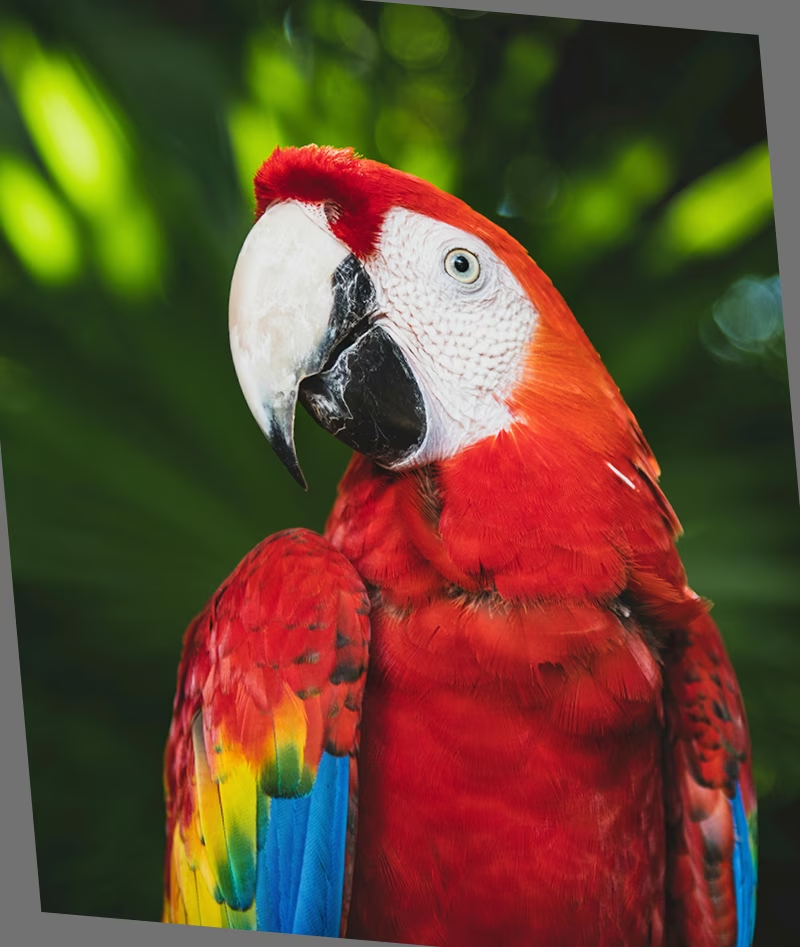
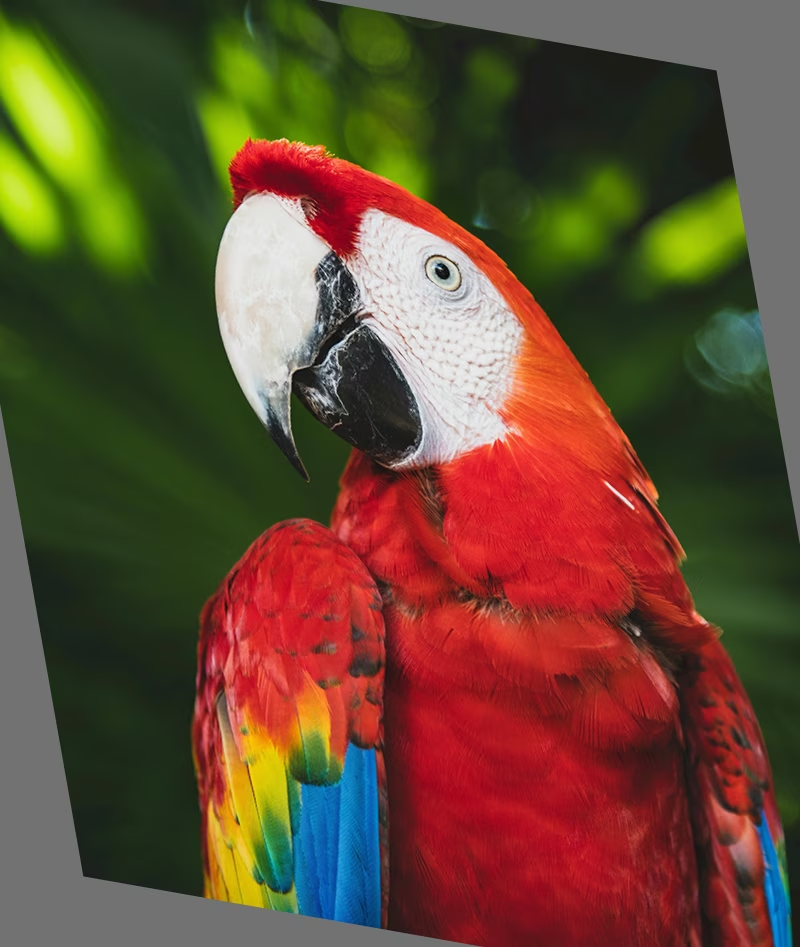
0 - 用法:引入一种几何变换,沿 x 轴和 y 轴倾斜图像,在保持平行线的同时将图像部分向一个方向偏移。
shear超参数定义剪切角度,最终调整值会在-shear和shear之间随机选取。例如,设置为shear=10.0时,x 轴方向的剪切值会在-10到10之间随机选取,y 轴方向则会在相同范围内独立随机选取另一个值。 - 目的:帮助模型适应轻微倾斜或斜视角造成的视角变化。例如,在交通监控中,由于相机并非垂直于目标安装,汽车和道路标志等物体可能会呈现倾斜。应用剪切增强可确保模型即使面对这类倾斜变形,也能学会识别物体。
- Ultralytics 的实现:RandomPerspective
- 注意:
shear的值可能会迅速扭曲图像,因此建议从较小的值开始,再逐步增大。- 与透视变换不同,剪切不会引入深度或消失点,而是通过改变物体的角度来扭曲其形状,同时保持相对边平行。
-10 | -5 | 0.0 | 5 | 10 |
|---|---|---|---|---|
 |  | |  |  |
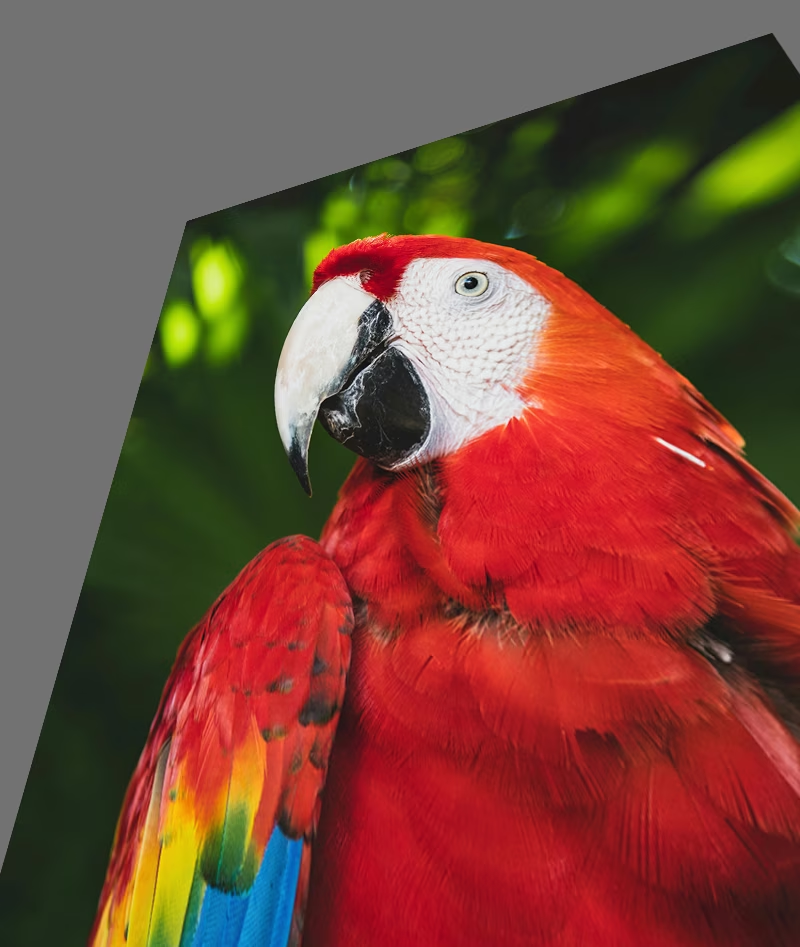
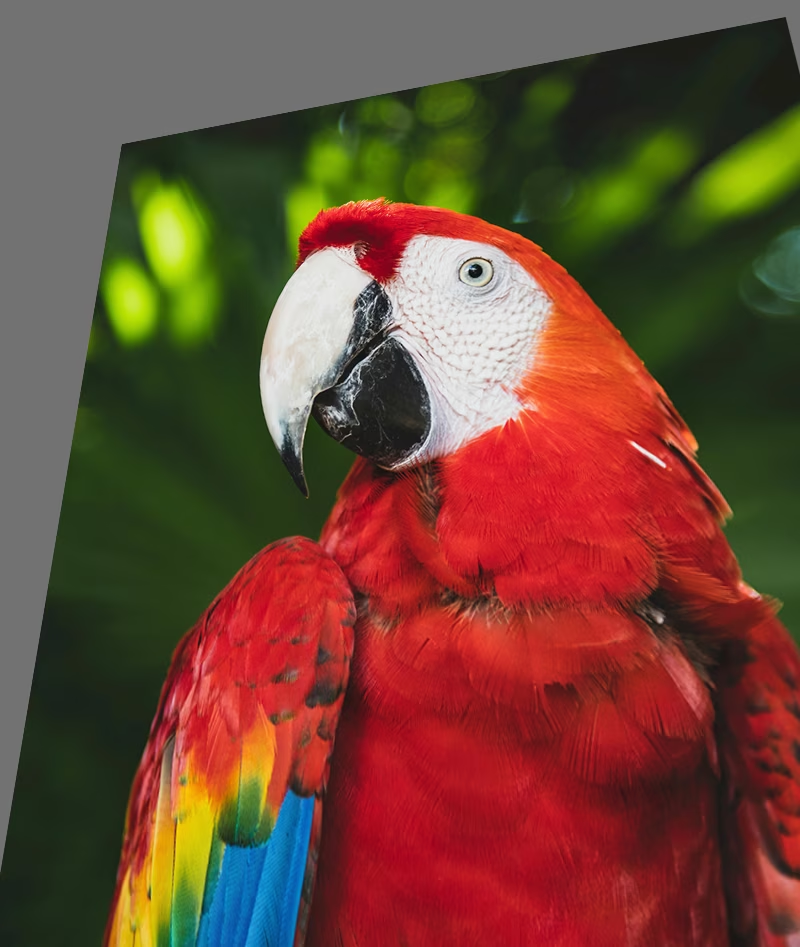
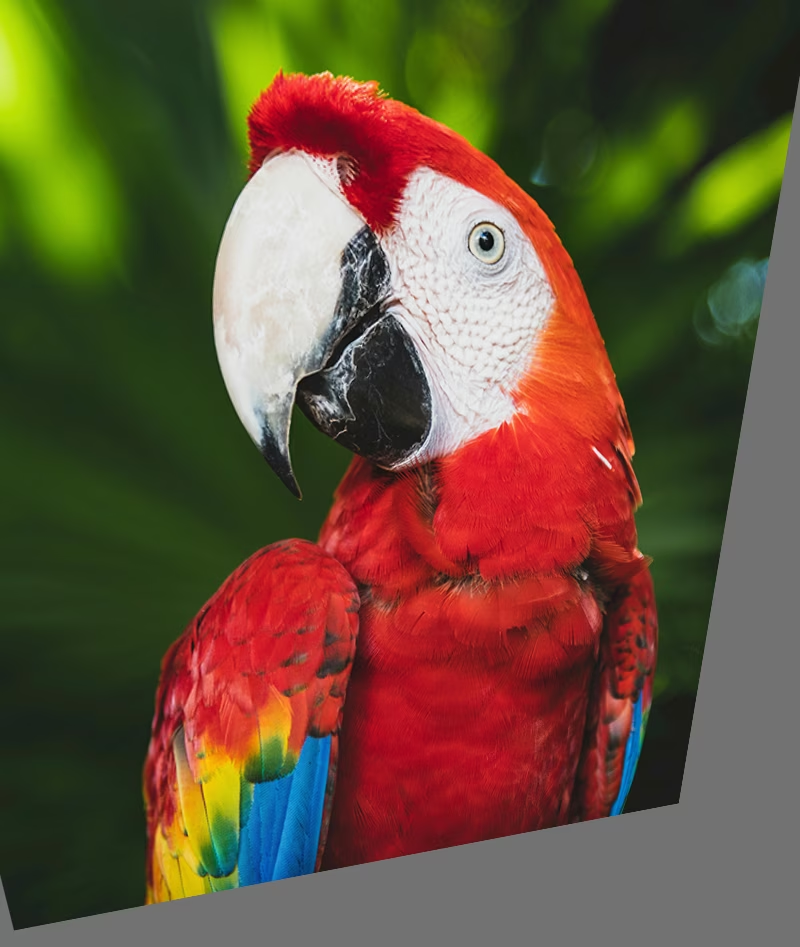
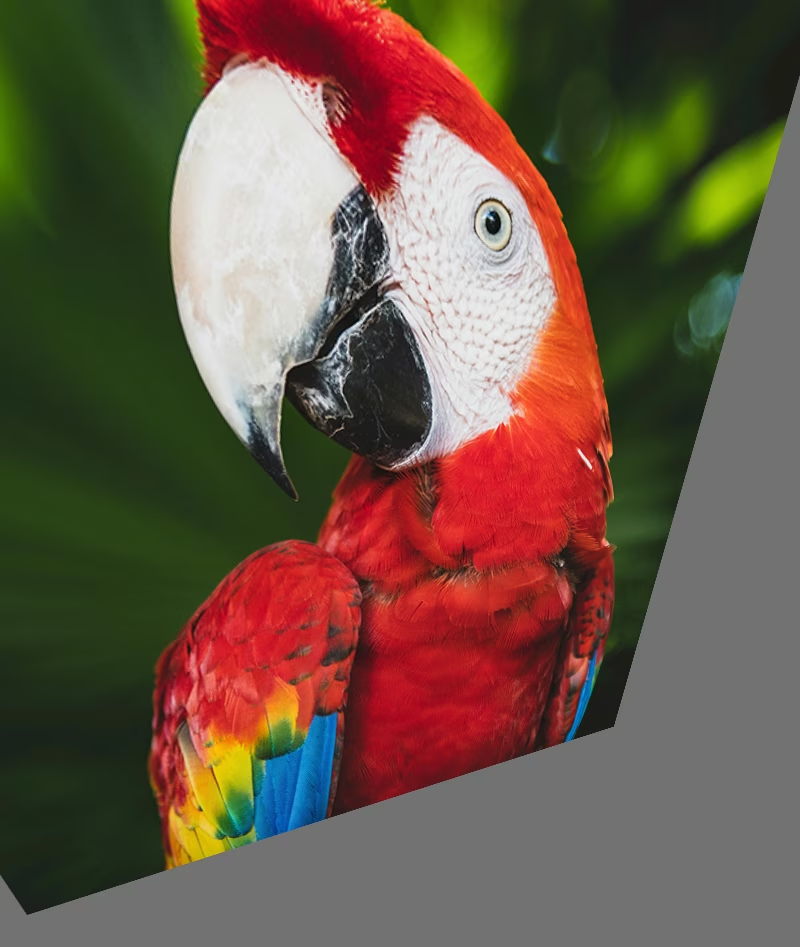
透视变换 (perspective)#
- 范围:
0.0-0.001 - 默认值:
0 - 用法:沿 x 轴和 y 轴应用完整的透视变换,模拟从不同深度或角度观察物体时的外观。
perspective超参数定义透视变换幅度,最终调整值会在-perspective和perspective之间随机选取。例如,设置为perspective=0.001时,x 轴方向的透视变换值会在-0.001到0.001之间随机选取,y 轴方向则会在相同范围内独立随机选取另一个值。 - 目的:透视增强对于处理极端视角变化至关重要,尤其是在物体因透视变化而显得缩短或变形的场景中。例如,在基于无人机的目标检测中,建筑物、道路和车辆可能会因无人机的倾斜角度和高度而显得拉伸或压缩。应用透视变换后,模型能够学会识别这些受透视影响而变形的物体,从而提升模型在实际部署中的鲁棒性。
- Ultralytics 的实现:RandomPerspective
-0.001 | -0.0005 | 0.0 | 0.0005 | 0.001 |
|---|---|---|---|---|
 |  | |  |  |
上下翻转 (flipud)#
- 范围:
0.0-1.0 - 默认值:
0 - 用法:沿 y 轴翻转图像,进行垂直翻转。这种变换会将整幅图像上下颠倒,但保留物体之间的所有空间关系。
flipud超参数定义应用变换的概率,值为flipud=1.0时会翻转所有图像,值为flipud=0.0时则完全禁用该变换。例如,使用flipud=0.5时,每张图像都有 50% 的概率被上下翻转。 - 目的:适用于物体可能上下颠倒的场景。例如,在机器人视觉系统中,传送带或机械臂上的物体可能会以各种方向被拾取和放置。垂直翻转有助于模型无论物体朝向如何都能识别它们。
- Ultralytics 的实现:RandomFlip
flipud 关闭 | flipud 开启 |
|---|---|
|  |
左右翻转 (fliplr)#
- 范围:
0.0-1.0 - 默认值:
0.5 - 用法:沿 x 轴镜像图像,实现水平翻转。这种变换会交换左右两侧,同时保持空间关系一致,从而帮助模型泛化到呈镜像方向的物体。
fliplr超参数定义应用该变换的概率;值为fliplr=1.0时,所有图像都会翻转,值为fliplr=0.0时则会完全禁用该变换。例如,设置为fliplr=0.5时,每张图像都有 50% 的概率左右翻转。 - 目的:水平翻转广泛用于目标检测、姿态估计和人脸识别,以提升模型应对左右方向变化的鲁棒性。例如,在自动驾驶中,车辆和行人可能出现在道路的任意一侧,水平翻转有助于模型同样准确地识别两种方向的目标。
- Ultralytics 的实现:RandomFlip
fliplr 关闭 | fliplr 开启 |
|---|---|
|  |
BGR 通道交换 (bgr)#
- 范围:
0.0-1.0 - 默认值:
0 - 用法:将图像的颜色通道从 RGB 交换为 BGR,改变颜色的表示顺序。
bgr超参数定义应用该变换的概率;bgr=1.0会使所有图像都进行通道交换,bgr=0.0则会禁用该变换。例如,设置为bgr=0.5时,每张图像都有 50% 的概率从 RGB 转换为 BGR。 - 目的:提升模型对不同颜色通道顺序的鲁棒性。例如,在训练需要适配多种相机系统和成像库的模型时,RGB 和 BGR 格式的使用可能不一致;或者在输入颜色格式可能与训练数据不同的环境中部署模型时,这项增强也很有用。
- Ultralytics 的实现:Format
bgr 关闭 | bgr 开启 |
|---|---|
|  |
Mosaic (mosaic)#
- 范围:
0.0-1.0 - 默认值:
1 - 用法:将四张训练图像合并为一张。
mosaic超参数定义应用该变换的概率;mosaic=1.0会使所有图像都进行合并,mosaic=0.0则会禁用该变换。例如,设置为mosaic=0.5时,每张图像都有 50% 的概率与另外三张图像合并。 - 目的:对提升小物体检测和上下文理解能力非常有效。例如,在动物可能以不同距离和大小出现的野生动物保护项目中,Mosaic 增强可以利用有限数据人工生成多样化的训练样本,帮助模型学习识别不同尺寸、部分遮挡及处于不同环境背景中的同一物种。
- Ultralytics 的实现:Mosaic
- 注意:
- 尽管
mosaic增强能提升模型的鲁棒性,但也会让训练过程更具挑战性。 - 你可以在训练接近结束时禁用
mosaic增强:将close_mosaic设为结束前需要关闭增强的轮数。例如,如果epochs设为200,且close_mosaic设为20,那么mosaic增强会在180轮后禁用。如果close_mosaic设为0,则mosaic增强会在整个训练过程中持续启用。 - 关闭 Mosaic 时,也会在同一轮关闭
copy_paste、mixup和cutmix。这四种增强会一起关闭,因此最后几轮训练不会使用它们,而其他所有增强——几何变换、HSV、翻转和 Albumentations——仍会继续运行。请注意,copy_paste在默认的flip模式下仅作用于单张图像,不会合并多张图像。 - 生成的 Mosaic 中心位置由随机值确定,可能位于图像内部,也可能在图像外部。
- 当前
mosaic增强的实现会将当前图像与另外 3 张图像合并;这 3 张图像取自最近加载图像的缓冲区,或者在cache='ram'时从整个数据集中抽取。无论采用哪种方式,抽样时都允许重复,因此同一张图像可能会在单个 Mosaic 中出现多次。
- 尽管
mosaic 关闭 | mosaic 开启 |
|---|---|
|  |
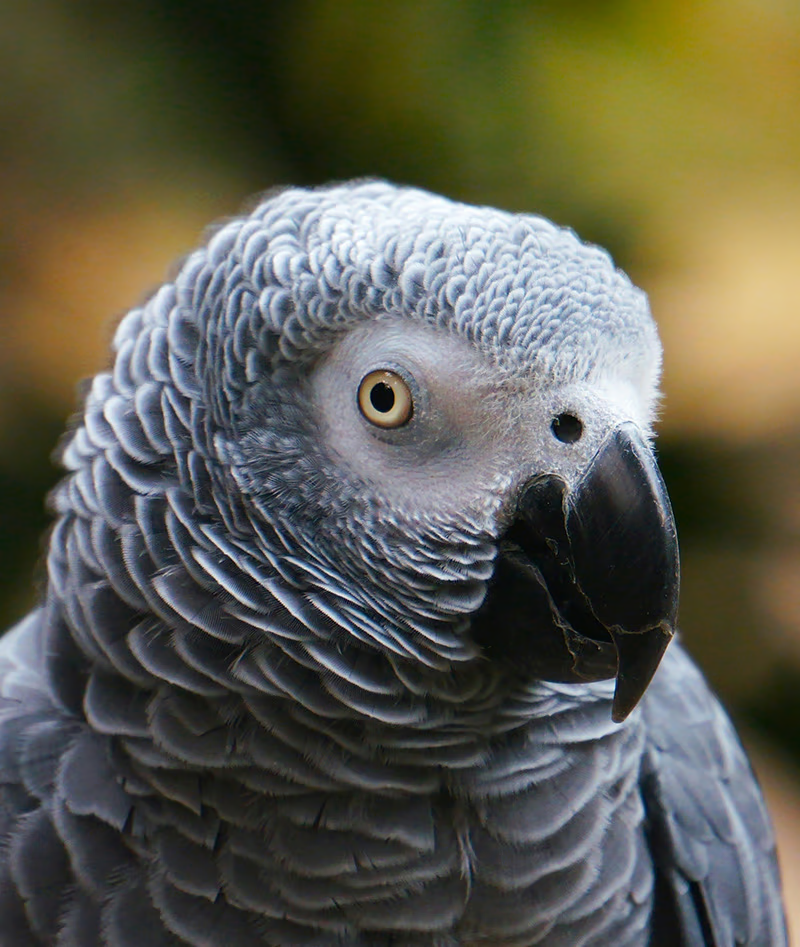
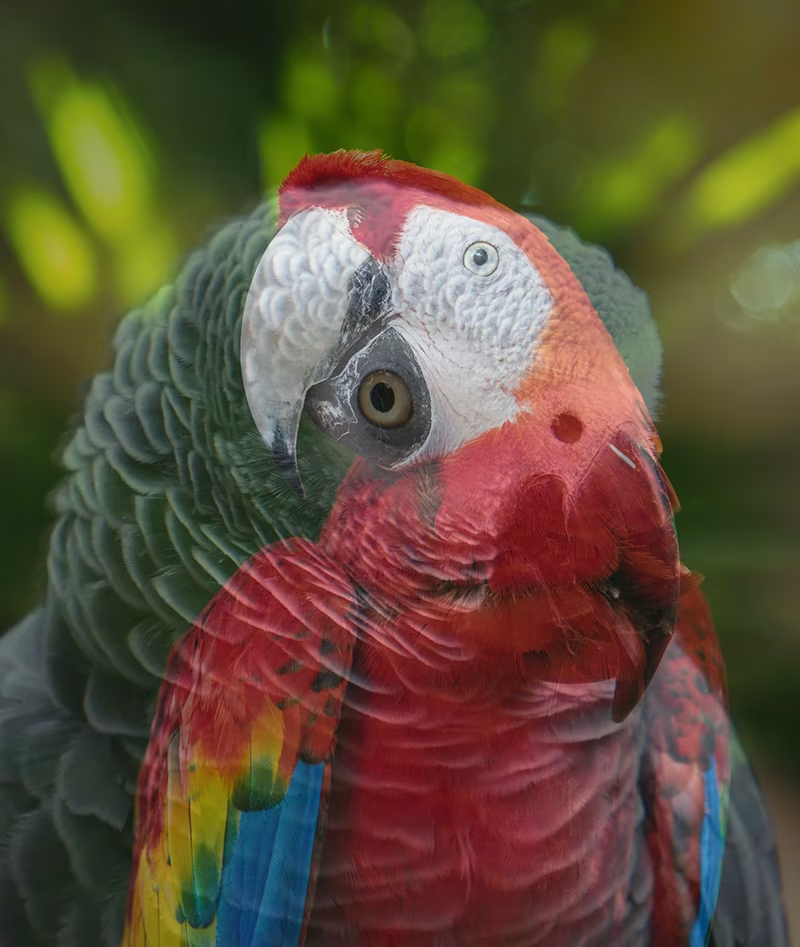
Mixup (mixup)#
- 范围:
0.0-1.0 - 默认值:
0 - 用法:按给定概率混合两张图像及其标签。
mixup超参数定义应用变换的概率,mixup=1.0会确保混合所有图像,mixup=0.0则会禁用该变换。例如,使用mixup=0.5时,每张图像都有 50% 的概率与另一张图像混合。 - 目的:提升模型鲁棒性并减少过拟合。例如,在零售商品识别系统中,Mixup 有助于模型通过混合不同商品的图像来学习更鲁棒的特征,使模型即使在商品部分可见,或在拥挤的商店货架上被其他商品遮挡时,也能识别商品。
- Ultralytics 的实现:MixUp
- 注意:
mixup比率是从np.random.beta(32.0, 32.0)贝塔分布中随机抽取的值,这意味着每张图像的贡献约为 50%,但会略有变化。
第一张图像,mixup 关闭 | 第二张图像,mixup 关闭 | mixup 开启 |
|---|---|---|
|  |  |
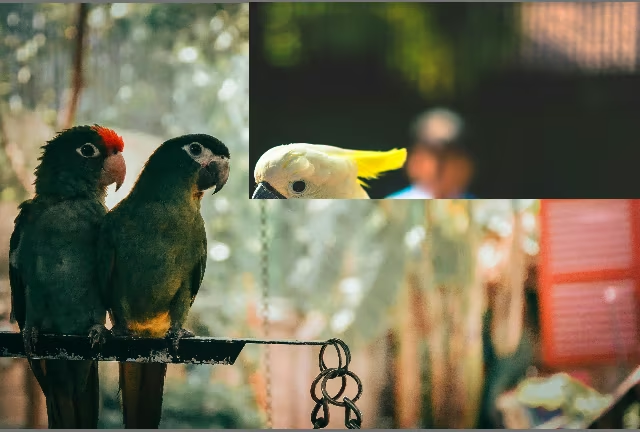
CutMix (cutmix)#
- 范围:
0.0-1.0 - 默认值:
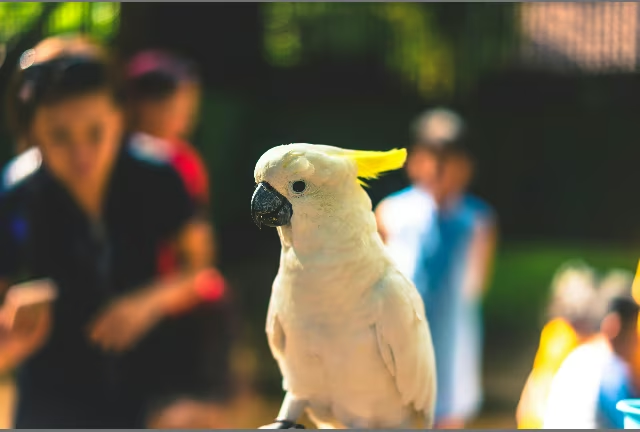
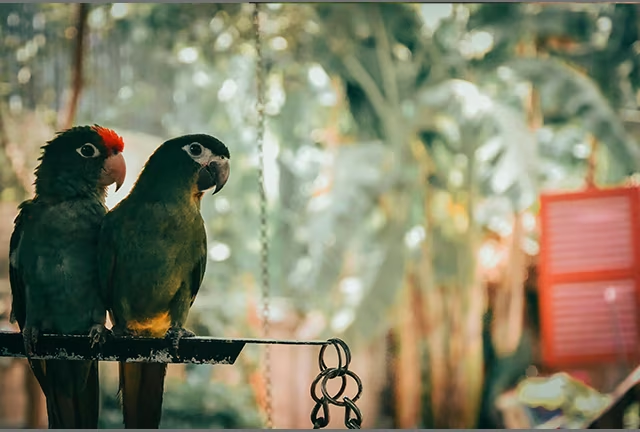
0 - 用法:应用 CutMix,按给定概率从一张图像中裁剪矩形区域并粘贴到另一张图像上。
cutmix超参数定义应用变换的概率,cutmix=1.0会确保所有图像都应用此变换,cutmix=0.0则会完全禁用该变换。例如,使用cutmix=0.5时,每张图像都有 50% 的概率被另一张图像的图块替换一个区域。 - 用途:在保留局部特征完整性的同时,创建逼真的遮挡场景,从而提升模型性能。例如,在自动驾驶系统中,即使车辆或行人被其他物体部分遮挡,CutMix 也能帮助模型学会识别它们,从而提升模型在物体重叠的复杂真实环境中的检测准确率。
- Ultralytics 的实现:CutMix
- 注意:
- 每次应用时,裁剪区域的大小和位置都会随机确定。
- 与全局混合像素值的
mixup不同,cutmix会保留裁剪区域内的原始像素强度,从而保留局部特征。 - 只有当粘贴区域与任何现有边界框都不重叠时,才会将其粘贴到目标图像中。此外,只有在粘贴后仍保留足够原始面积的边界框才会保留。
- 当前实现无法更改此最小边界框面积阈值。对于检测标签,该值为
0.1(10%);对于包含分段的标签,该值为0.01(1%)。
第一张图像,cutmix 关闭 | 第二张图像,cutmix 关闭 | cutmix 开启 |
|---|---|---|
 |  |  |
Copy-Paste 增强#
Copy-Paste(copy_paste)#
- 范围:
0.0-1.0 - 默认值:
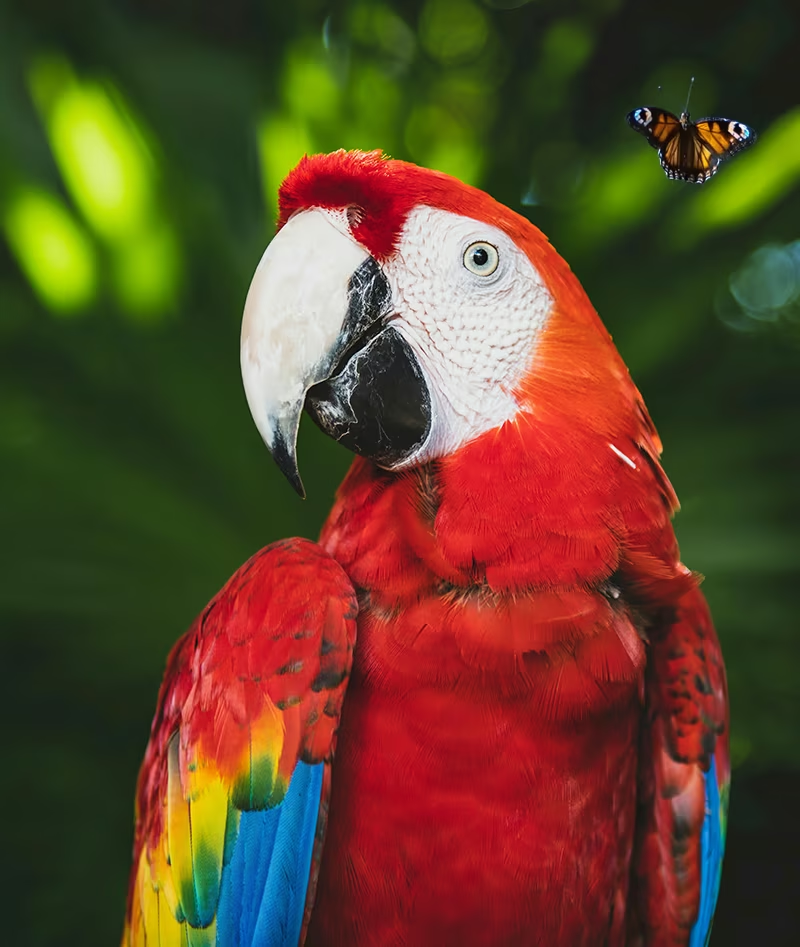
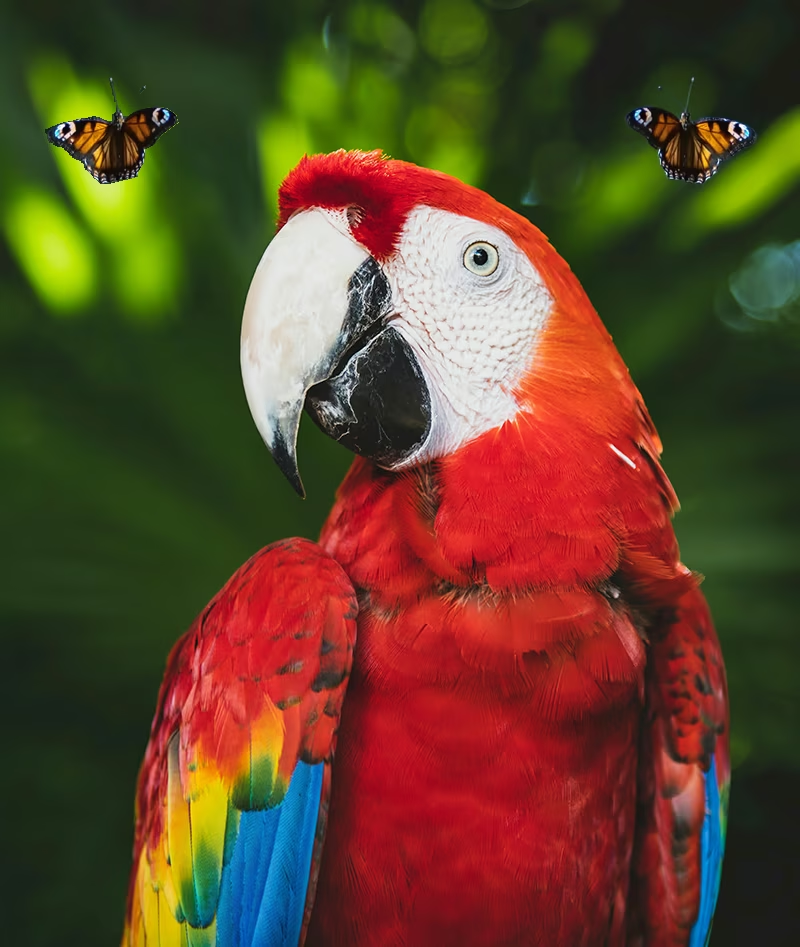
0 - 用法:需要多边形标签,因此适用于分割和 OBB 任务;此增强会在图像内部或不同图像之间复制对象,具体由
copy_paste_mode控制。在flip模式下,copy_paste表示符合条件的对象中被复制的比例:一张有 6 个符合条件对象的图像在copy_paste=0.5时会增加 3 个副本。在mixup模式下,同一数值还会控制运行 copy-paste 的概率。copy_paste=0.0会禁用此变换。 - 用途:尤其适用于实例分割任务和稀有对象类别。例如,在某些缺陷类型很少出现的工业缺陷检测中,copy-paste 增强可以将这些稀有缺陷从一张图像复制到另一张图像,人为增加其出现频率,帮助模型更好地学习这些代表性不足的情况,而无需额外收集缺陷样本。
- Ultralytics 的实现:CopyPaste
- 注意:
- 如下方视频所示,
copy_paste增强可用于将对象从一张图像复制到另一张图像。 - 选中要复制的对象后,会计算该对象与目标图像中所有现有对象的 IoA,无论
copy_paste_mode的值如何。只有当所有 IoA 值都低于0.3(30%)时,才会粘贴该对象;如果任一 IoA 值达到或超过0.3,则不会粘贴。 - 当前实现无法更改 IoA 阈值,默认值为
0.3。
- 如下方视频所示,
copy_paste 关闭 | 开启 copy_paste 并使用 copy_paste_mode=flip | 可视化 copy_paste 流程 |
|---|---|---|
 |  |
Copy-Paste 模式(copy_paste_mode)#
- 选项:
'flip'、'mixup' - 默认值:
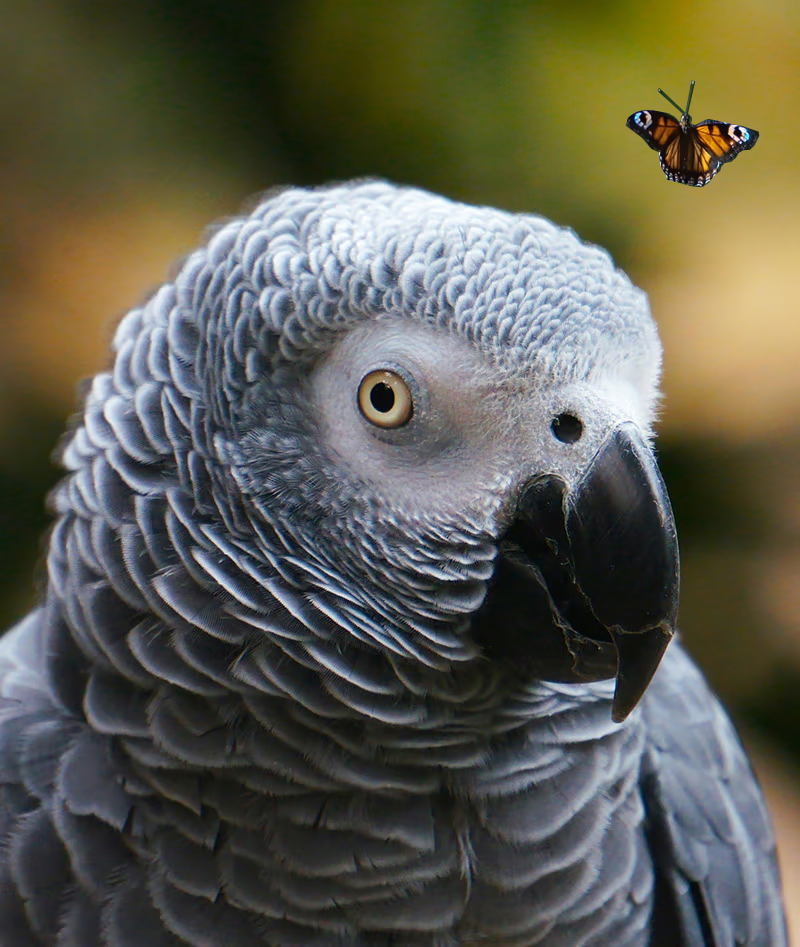
'flip' - 用法:确定用于 copy-paste 增强的方法。如果设置为
'flip',对象来自同一张图像;而'mixup'则允许从不同图像复制对象。 - 用途:灵活控制复制对象整合到目标图像中的方式。
- Ultralytics 的实现:CopyPaste
- 注意:
- 两种
copy_paste_mode选项使用相同的 IoA 原理,但复制对象的方式不同。 - 根据图像尺寸,对象有时可能只被部分复制,或完全位于画面之外。
- 根据多边形标注的质量,复制的对象形状可能与原对象略有差异。
- 两种
| 参考图像 | 为 copy_paste 选取的图像 | 开启 copy_paste 并使用 copy_paste_mode=mixup |
|---|---|---|
| |  |
分类专用增强#
Auto Augment(auto_augment)#
- 选项:
'randaugment'、'autoaugment'、'augmix'、None - 默认值:
'randaugment' - 用法:为分类任务应用自动化增强策略。
'randaugment'选项使用 RandAugment,'autoaugment'使用 AutoAugment,'augmix'使用 AugMix。设为None会禁用自动增强。 - 用途:自动优化分类任务的增强策略。它们的区别如下:
- AutoAugment:此模式应用从 ImageNet、CIFAR-10 和 SVHN 等数据集中学习得到的预定义增强策略。用户可以选择这些现有策略,但无法在 Torchvision 中训练新的策略。若要为特定数据集找到最佳增强策略,需要使用外部库或自定义实现。
- RandAugment:以统一的幅度随机选择并应用变换。这种方法减少了对大规模搜索阶段的需求,在增强模型鲁棒性的同时,计算效率也更高。
- AugMix:AugMix 是一种数据增强方法,通过随机组合简单变换生成多样化的图像变化,从而提升模型鲁棒性。
- Ultralytics 的实现:classify_augmentations()
- 注意:
- 本质上,这三种方法的主要区别在于增强策略的定义和应用方式。
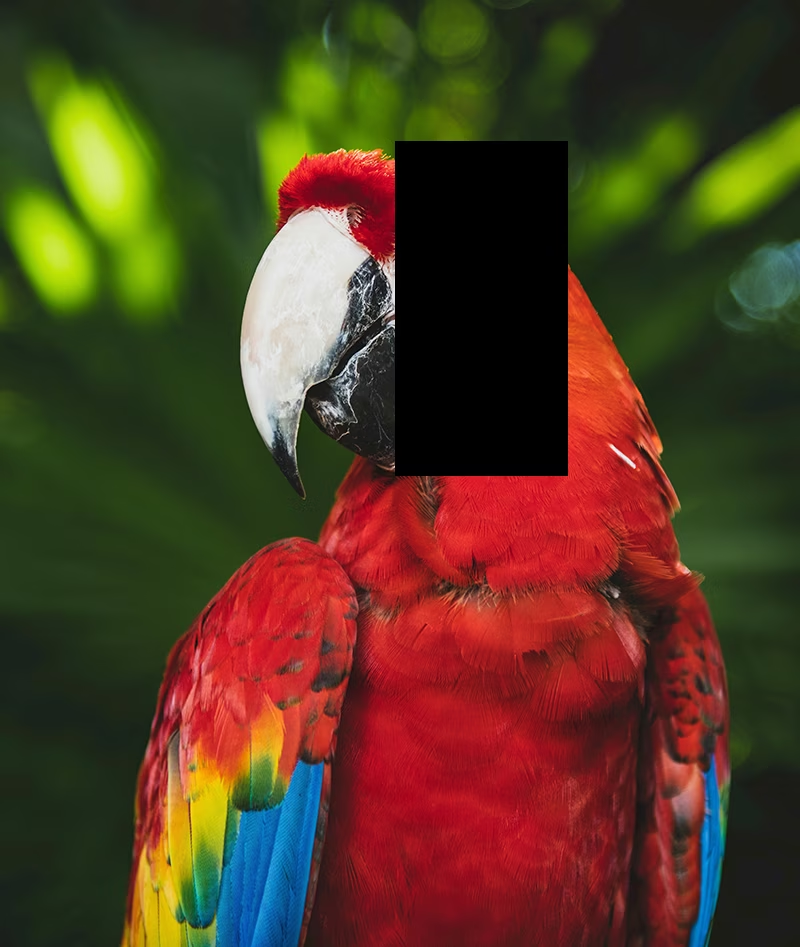
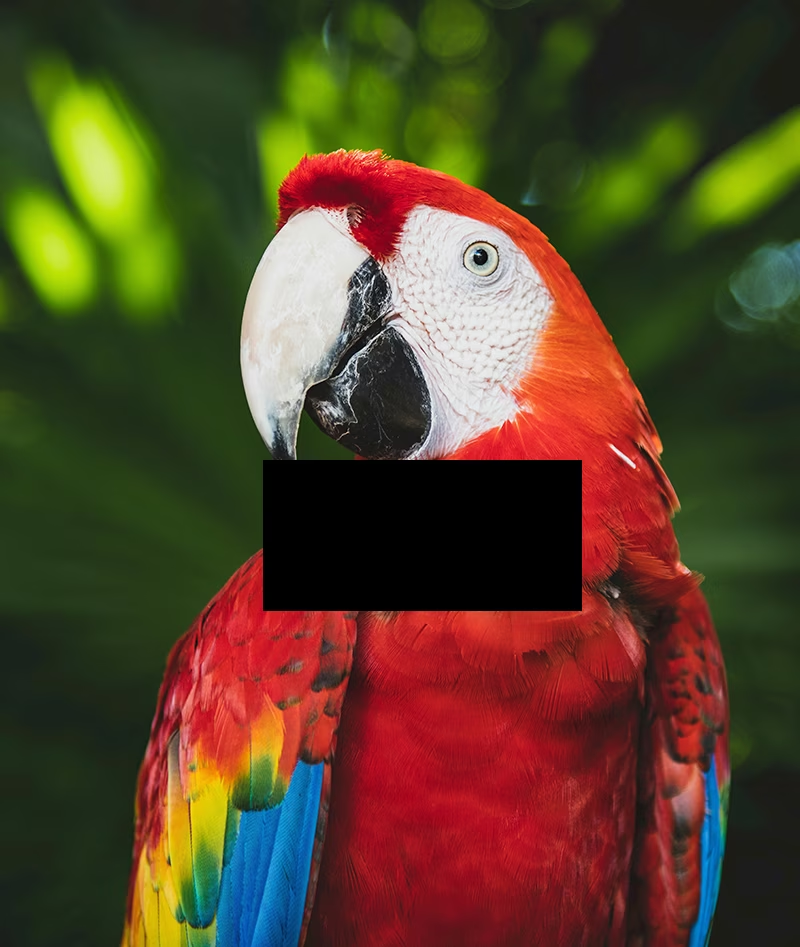
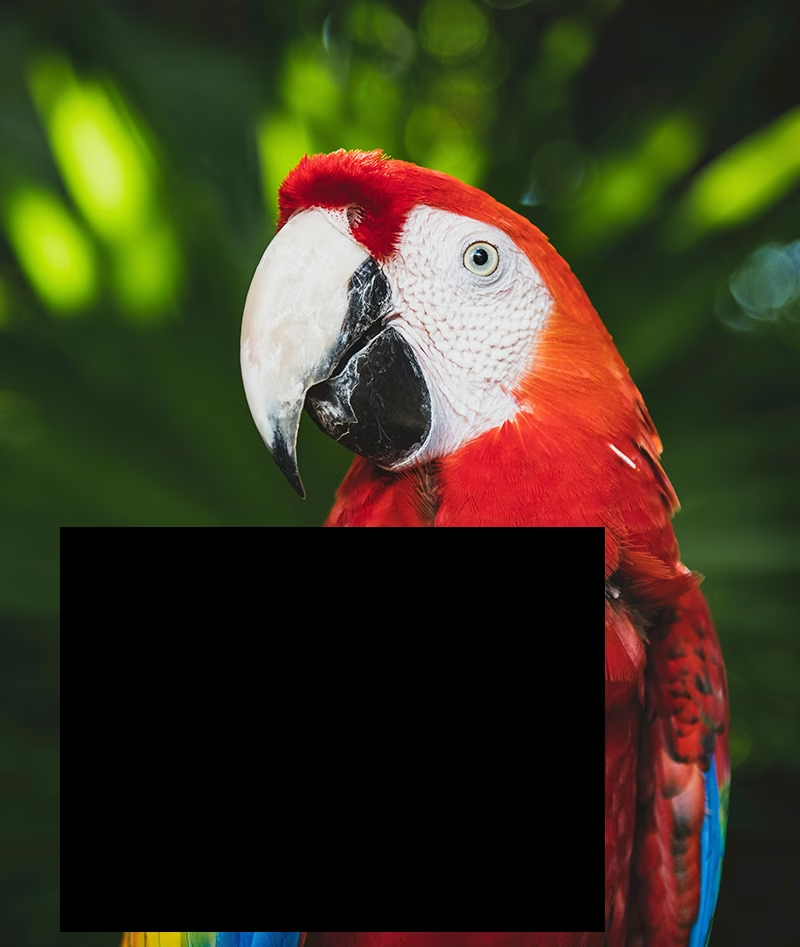
随机擦除(erasing)#
- 范围:
0.0-1.0 - 默认值:
0.4 - 用法:在分类训练过程中随机擦除图像的部分区域。
erasing超参数定义应用此变换的概率,其中erasing=1.0会在每张图像中擦除一个区域,而erasing=0.0会禁用此变换。例如,设置为erasing=0.5时,每张图像都有 50% 的概率被擦除一部分。 - 用途:帮助模型学习鲁棒特征,避免过度依赖图像的特定区域。例如,在人脸识别系统中,随机擦除有助于提升模型应对局部遮挡的能力,例如太阳镜、口罩或其他可能遮住部分面部特征的物体。通过迫使模型利用多种面部特征识别人物,而不是只依赖可能被遮挡的显著特征,这种方法能提升模型在真实场景中的表现。
- Ultralytics 的实现:classify_augmentations()
- 注意:
erasing增强包含scale、ratio和value超参数,使用当前实现无法更改这些参数。PyTorch 的 RandomErasing 文档中说明,这些参数的默认值分别是(0.02, 0.33)、(0.3, 3.3)和0。
erasing 关闭 | 开启 erasing(示例 1) | 开启 erasing(示例 2) | 开启 erasing(示例 3) |
|---|---|---|---|
|  |  |  |
高级增强功能#
自定义 Albumentations 变换(augmentations)#
- 类型:Albumentations 变换的
list - 默认值:
None - 用法:通过 Python API 提供自定义 Albumentations 变换以进行数据增强。此参数接受 Albumentations 变换对象列表,这些对象会在训练期间应用,以替代默认的 Albumentations 变换。
- 用途:利用丰富的 Albumentations 变换库,精细控制数据增强策略。当你需要内置 YOLO 选项之外的专用增强时,这尤其有用,例如用于医学影像的弹性形变和网格扭曲、针对俯视航拍和卫星视角调整的变换、模拟低光照条件的噪声和亮度变化,或用于工业检测的类缺陷纹理变化。
- Ultralytics 的实现:Albumentations
- 注意:
- 构建变换对象需要使用 Python API。保存检查点时,Ultralytics 会使用
A.to_dict()对这些对象进行序列化,因此已序列化的列表可以通过 YAML 配置文件或 CLI 完整往返传递,从而让resume能够还原这些对象。 - 自定义变换会完全替代默认的 Albumentations 变换集。本页其他位置配置的所有增强——
mosaic、hsv_h、degrees等——仍会保持启用并独立应用。 - 改变图像几何结构的空间变换(包括嵌套在
A.OneOf或A.Compose中的变换)会使边界框、多边形、关键点以及深度或语义掩码随图像一起移动;A.RandomGridShuffle无法保留多边形或关键点的拓扑结构,因此遇到分割、姿态和 OBB 样本时会报错。 - Albumentations 提供 70 多种变换;Albumentations 文档列出了所有变换。添加过多变换或计算开销较大的变换会拖慢训练,因此建议从少量变换开始,并关注每个 epoch 的耗时。
- 适用于
detect、segment、semantic、depth、pose和obb任务。分类任务除外,因为分类使用独立的增强流程。
- 构建变换对象需要使用 Python API。保存检查点时,Ultralytics 会使用
以下示例需要 Albumentations 1.4.22 或更高版本,因此也需要 Python 3.9 或更高版本。
import albumentations as A

from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n.pt")

# 定义自定义 Albumentations 变换
custom_transforms = [
    A.Blur(blur_limit=7, p=0.5),
    A.GaussNoise(std_range=(0.0124, 0.0277), p=0.3),
    A.CLAHE(clip_limit=4.0, p=0.5),
    A.RandomBrightnessContrast(brightness_limit=0.2, contrast_limit=0.2, p=0.5),
    A.HueSaturationValue(hue_shift_limit=20, sat_shift_limit=30, val_shift_limit=20, p=0.5),
]

# 使用自定义 Albumentations 变换进行训练
model.train(
    data="coco8.yaml",
    epochs=100,
    augmentations=custom_transforms,  # 传入自定义变换
    imgsz=640,
)常见问题#
选择合适的数据增强取决于你的具体用例和数据集。以下是一些通用建议,可帮助你做出选择:
- 在大多数情况下,轻微改变颜色和亮度会有帮助。
hsv_h、hsv_s和hsv_v的默认值是不错的起点。 - 如果相机视角固定,且模型部署后不会改变,你可能可以跳过几何变换,例如
degrees(旋转)、translate、scale、shear或perspective。不过,如果相机角度可能变化,且你希望模型更鲁棒,最好保留这些增强。 - 只有在图像中出现部分遮挡的对象或多个对象可以接受,且不会改变标签值时,才使用
mosaic增强。你也可以保持mosaic启用,但调高close_mosaic的值,使其在训练过程中更早禁用。
简而言之:保持简单。从少量增强开始,再根据需要逐步增加。目标是提升模型的泛化能力和鲁棒性,而不是让训练过程过于复杂。另外,请确保所用增强反映模型在生产环境中会遇到的相同数据分布。
- 在大多数情况下,轻微改变颜色和亮度会有帮助。
如果安装了
albumentations包,Ultralytics 会自动使用该包应用一组额外的图像增强。这些增强由内部处理,无需额外配置。你可以在我们的技术文档和 Albumentations 集成指南中找到所应用变换的完整列表。请注意,只有概率
p大于0的增强才会启用。这些增强特意以较低频率应用,以模拟模糊或灰度效果等真实视觉伪影。你也可以通过 Python API 提供自己的自定义 Albumentations 变换。更多详情请参阅高级增强功能部分。
检查是否已安装
albumentations包。如果没有,请安装:pip install albumentations安装后,Ultralytics 应会自动检测并使用该包。
你可以通过创建自定义数据集类和训练器来自定义数据增强。例如,你可以将 Ultralytics 默认的分类增强替换为 PyTorch 的 torchvision.transforms.Resize 或其他变换。有关实现详情,请参阅分类文档中的自定义训练示例。


评论5
提出问题、分享结果,或帮助其他人。
shkim-lp
Hello, I have 2 questions with respect to hsv_s, the saturation adjustment.
-
Google AI claims "hsv_s = 1.0" results in adjustment of input images' saturation level to any number within (0,1) range. Since there is an infinite number of different real values within (0.0, 1.0) range, I reckon that larger number of epochs entails more diverse saturation levels. Am I correct?
-
Every image within the same batch can get assigned a different hsv_s value?
Thank you for your clarification!
 Glenn JocherUltralytics
hsv_sin Ultralytics YOLO is a per-image random jitter magnitude: on each time an image is augmented, a (continuous) random saturation adjustment is sampled within the configured range, so more training iterations/epochs generally expose the model to more saturation variations, but repeats are normal since it’s stochastic (it’s not a finite set). Yes, it’s sampled independently per image, so different images in the same batch can receive different saturation adjustments; see the YOLO data augmentation guide and the RandomHSV reference.
-
dolokbutarbutar24
is that randaugment choosing randomly augmentation like shear or other augmentation technique? i dont understand the differences between randaugment and normal augment like shear and other
is it woth to use if my data is plant disease image that sensitive to local feature?
- Glenn JocherUltralytics
randaugmentis not “randomly choosingshear/mosaic/etc.” — in Ultralytics it’s theauto_augment='randaugment'option used only forclassify, and it randomly samples from a predefined torchvision-style augmentation policy; the “normal” YOLO args likeshear,degrees,mosaic,mixup,cutmixare separate controls used in thedetect/segment/pose/obbaugmentation pipeline (see the Data Augmentation guide and the augmentation arguments table).For plant disease images (often very local/texture-sensitive), it can be worth trying, but start conservative and validate: if RandAugment hurts fine lesion detail, disable it (and
erasing) and rely on mild color jitter/flip instead, e.g.from ultralytics import YOLO model = YOLO("yolo11n-cls.pt") model.train(data="your_dataset", auto_augment=None, erasing=0.0)