مجموعة بيانات Caltech-256#
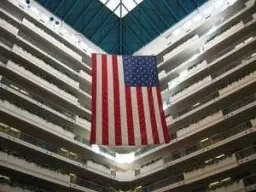
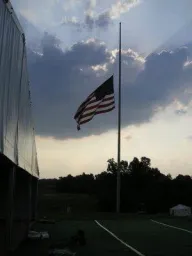
تُعد مجموعة بيانات Caltech-256 معيارًا مرجعيًا كلاسيكيًا لـتصنيف الصور، إذ تضم 30,607 صورة تغطي 256 فئة من الكائنات، بالإضافة إلى فئة واحدة للخلفية. وتحتوي كل فئة على 80 صورة على الأقل لكائنات من العالم الحقيقي — مثل الحيوانات والمركبات والأدوات المنزلية والأشخاص — مما يجعلها إصدارًا أكبر وأكثر تحديًا من Caltech-101 لنماذج التعرّف على الكائنات.
استكشف Caltech-256 على منصة Ultralytics لمعاينة العينات وفحص إحصاءات مجموعة البيانات واستنساخها لأغراض التدريب.
تأتي Caltech-256 من دون تقسيم محدد مسبقًا إلى التدريب والتحقق. تقسم أوامر التدريب أدناه المجموعة تلقائيًا بنسبة 80% للتدريب و20% للتحقق، لذا لا حاجة إلى إعداد يدوي.
الميزات الرئيسية#
- تحتوي Caltech-256 على 30,607 صورة ملونة موزعة على 256 فئة من الكائنات، بالإضافة إلى فئة خلفية واحدة هي
257.clutter(بإجمالي 257 مجلدًا للفئات). - تغطي الفئات مجموعة واسعة من الكائنات من العالم الحقيقي، بما في ذلك الحيوانات والمركبات والأدوات المنزلية والأشخاص.
- تحتوي كل فئة على 80 صورة على الأقل، بينما تضم أكبر الفئات نحو 800 صورة، ولذلك فإن أحجام الفئات غير متوازنة.
- تختلف أحجام الصور ودقة وضوحها.
- تُستخدم Caltech-256 على نطاق واسع لتقييم خوارزميات تصنيف الصور والتعرّف على الكائنات.
بنية مجموعة البيانات#
تُوزَّع Caltech-256 على شكل 257 مجلدًا — مجلد واحد لكل فئة، يغطي 256 فئة من الكائنات بالإضافة إلى فئة خلفية هي 257.clutter — من دون تقسيم محدد مسبقًا إلى التدريب والتحقق. عند بدء التدريب، تقسم Ultralytics الصور تلقائيًا بحيث تتدرب النماذج على جميع الفئات البالغ عددها 257 من دون أي إعداد يدوي:
- الفئات: 257 (256 فئة من الكائنات + فئة خلفية واحدة)
- إجمالي الصور: 30,607
- تقسيم التدريب/التحقق: تلقائي بنسبة 80% / 20% (نحو 24,385 صورة للتدريب و6,222 صورة للتحقق)
- الصور لكل فئة: 80 صورة على الأقل (غير متوازنة، وتصل إلى نحو 800 صورة)
التطبيقات#
تُستخدم مجموعة بيانات Caltech-256 على نطاق واسع لتدريب نماذج تصنيف الصور والتعرّف على الكائنات وتقييمها، بما في ذلك الشبكات العصبية الالتفافية (CNNs) وآلات المتجهات الداعمة (SVMs). ويجعل العدد الكبير من الفئات والصور عالية الجودة منها معيارًا مرجعيًا شائعًا لأبحاث التعلّم الآلي والرؤية الحاسوبية وإنشاء النماذج الأولية.
الاستخدام#
درّب نموذج YOLO على Caltech-256 لمدة 100 حقبة وبحجم صورة قدره 416. للحصول على القائمة الكاملة للوسائط المتاحة، راجع صفحة التدريب ودليل مهمة تصنيف الصور.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech256", epochs=100, imgsz=416)
الصور والتعليقات التوضيحية النموذجية#
تحتوي مجموعة بيانات Caltech-256 على صور ملونة عالية الجودة لكائنات متنوعة، مما يوفر مجموعة بيانات منظمة جيدًا لمهام تصنيف الصور. فيما يلي بعض أمثلة الصور من مجموعة البيانات (المصدر):
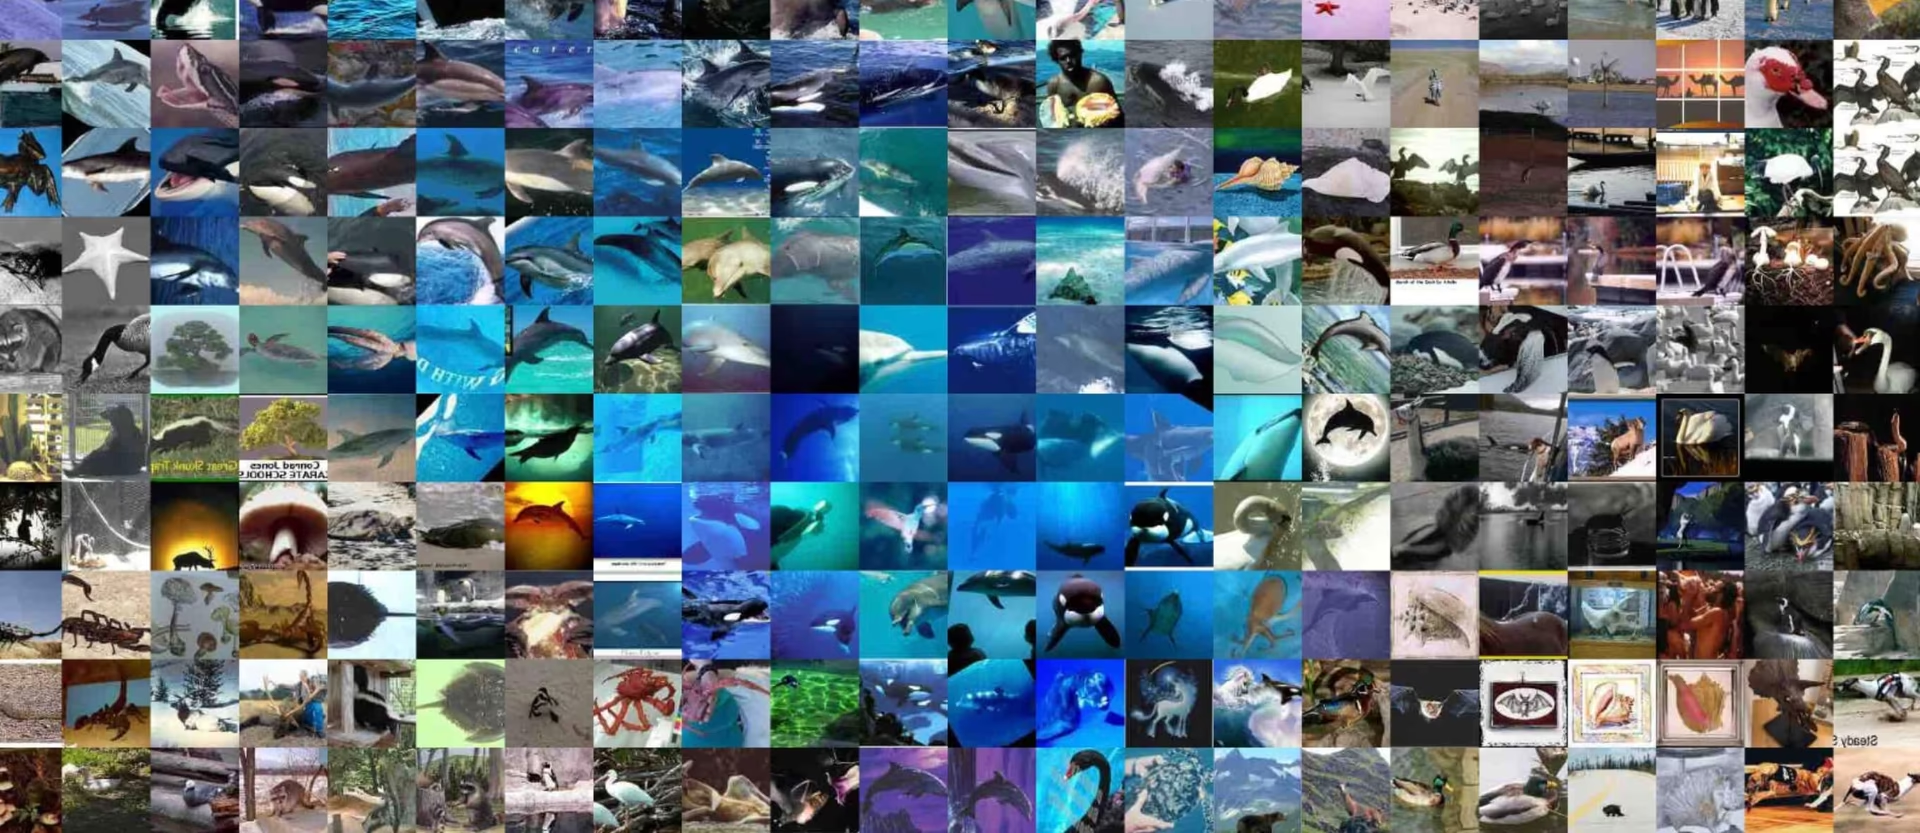
تُظهر العينات تنوع وتعقيد الكائنات في مجموعة بيانات Caltech-256، مما يؤكد قيمة استخدام مجموعة بيانات متنوعة لتدريب نماذج قوية للتعرّف على الكائنات.
الاقتباسات والشكر والتقدير#
إذا استخدمت مجموعة بيانات Caltech-256 في أبحاثك أو أعمال التطوير، فيُرجى الاستشهاد بالورقة البحثية التالية:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
نود أن نعرب عن تقديرنا لـ Gregory Griffin وAlex Holub وPietro Perona لإنشائهم مجموعة بيانات Caltech-256 وصيانتها بوصفها موردًا قيّمًا لمجتمع أبحاث التعلّم الآلي والرؤية الحاسوبية. لمزيد من المعلومات حول مجموعة بيانات Caltech-256 ومنشئيها، تفضل بزيارة موقع مجموعة بيانات Caltech-256.
الأسئلة الشائعة#
تُستخدم مجموعة بيانات Caltech-256 على نطاق واسع لتدريب نماذج تصنيف الصور والتعرّف على الكائنات وتقييمها. وتحتوي على 30,607 صورة موزعة على 256 فئة من الكائنات، بالإضافة إلى فئة خلفية، مما يوفر معيارًا مرجعيًا أكبر وأكثر تحديًا من Caltech-101 لخوارزميات مثل الشبكات العصبية الالتفافية (CNNs) وآلات المتجهات الداعمة (SVMs).
لتدريب نموذج Ultralytics YOLO على Caltech-256، استخدم مقتطفات التعليمات البرمجية أدناه. تُنزَّل مجموعة البيانات تلقائيًا عند استخدامها للمرة الأولى. للحصول على القائمة الكاملة للوسائط، راجع صفحة تدريب النموذج.
مثال على التدريبfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech256", epochs=100, imgsz=416)تحتوي Caltech-256 على 256 فئة من الكائنات بالإضافة إلى فئة خلفية واحدة هي
257.clutter، أي 257 مجلدًا للفئات و30,607 صورة إجمالًا. عند التدريب باستخدام Ultralytics، يتعلم النموذج جميع الفئات البالغ عددها 257. وتحتوي كل فئة على 80 صورة على الأقل، لكن أحجام الفئات غير متوازنة، إذ تضم أكبر الفئات نحو 800 صورة.لا تحتوي Caltech-256 على تقسيم محدد مسبقًا. في المرة الأولى التي تجري فيها التدريب، تقسمها Ultralytics تلقائيًا بنسبة 80% للتدريب و20% للتحقق — نحو 24,385 صورة للتدريب و6,222 صورة للتحقق — لذلك لا تحتاج إلى إنشاء التقسيمات يدويًا. للتحكم في التقسيم بنفسك، نظّم الصور في مجلدي
train/وval/قبل التدريب.نعم. تتيح لك منصة Ultralytics إدارة مجموعات البيانات وتدريب نماذج تصنيف الصور ونشرها من دون الحاجة إلى كتابة تعليمات برمجية مكثفة. وهي طريقة ملائمة لإجراء تجارب Caltech-256 في السحابة، ويمكنك استكشاف مزيد من الخيارات في نظرة عامة على مجموعات بيانات التصنيف.