مجموعة بيانات Dog-Pose
مقدمة#
مجموعة بيانات Ultralytics Dog-Pose مجموعة بيانات لتقدير الوضعيات، أُعدت لتقدير النقاط المفتاحية للكلاب، وتوفر 6,773 صورة تدريب و1,703 صور تحقق.
شاهد: كيفية تدريب نموذج Ultralytics YOLO على مجموعة بيانات تقدير وضعية الكلاب من ستانفورد | شرح تعليمي خطوة بخطوة
تتضمن كل صورة مشروحة 24 نقطة مفتاحية، ولكل نقطة 3 أبعاد (x, y, الرؤية)، ما يدعم الأبحاث والتطبيقات المعنية بتقدير وضعيات الكلاب.
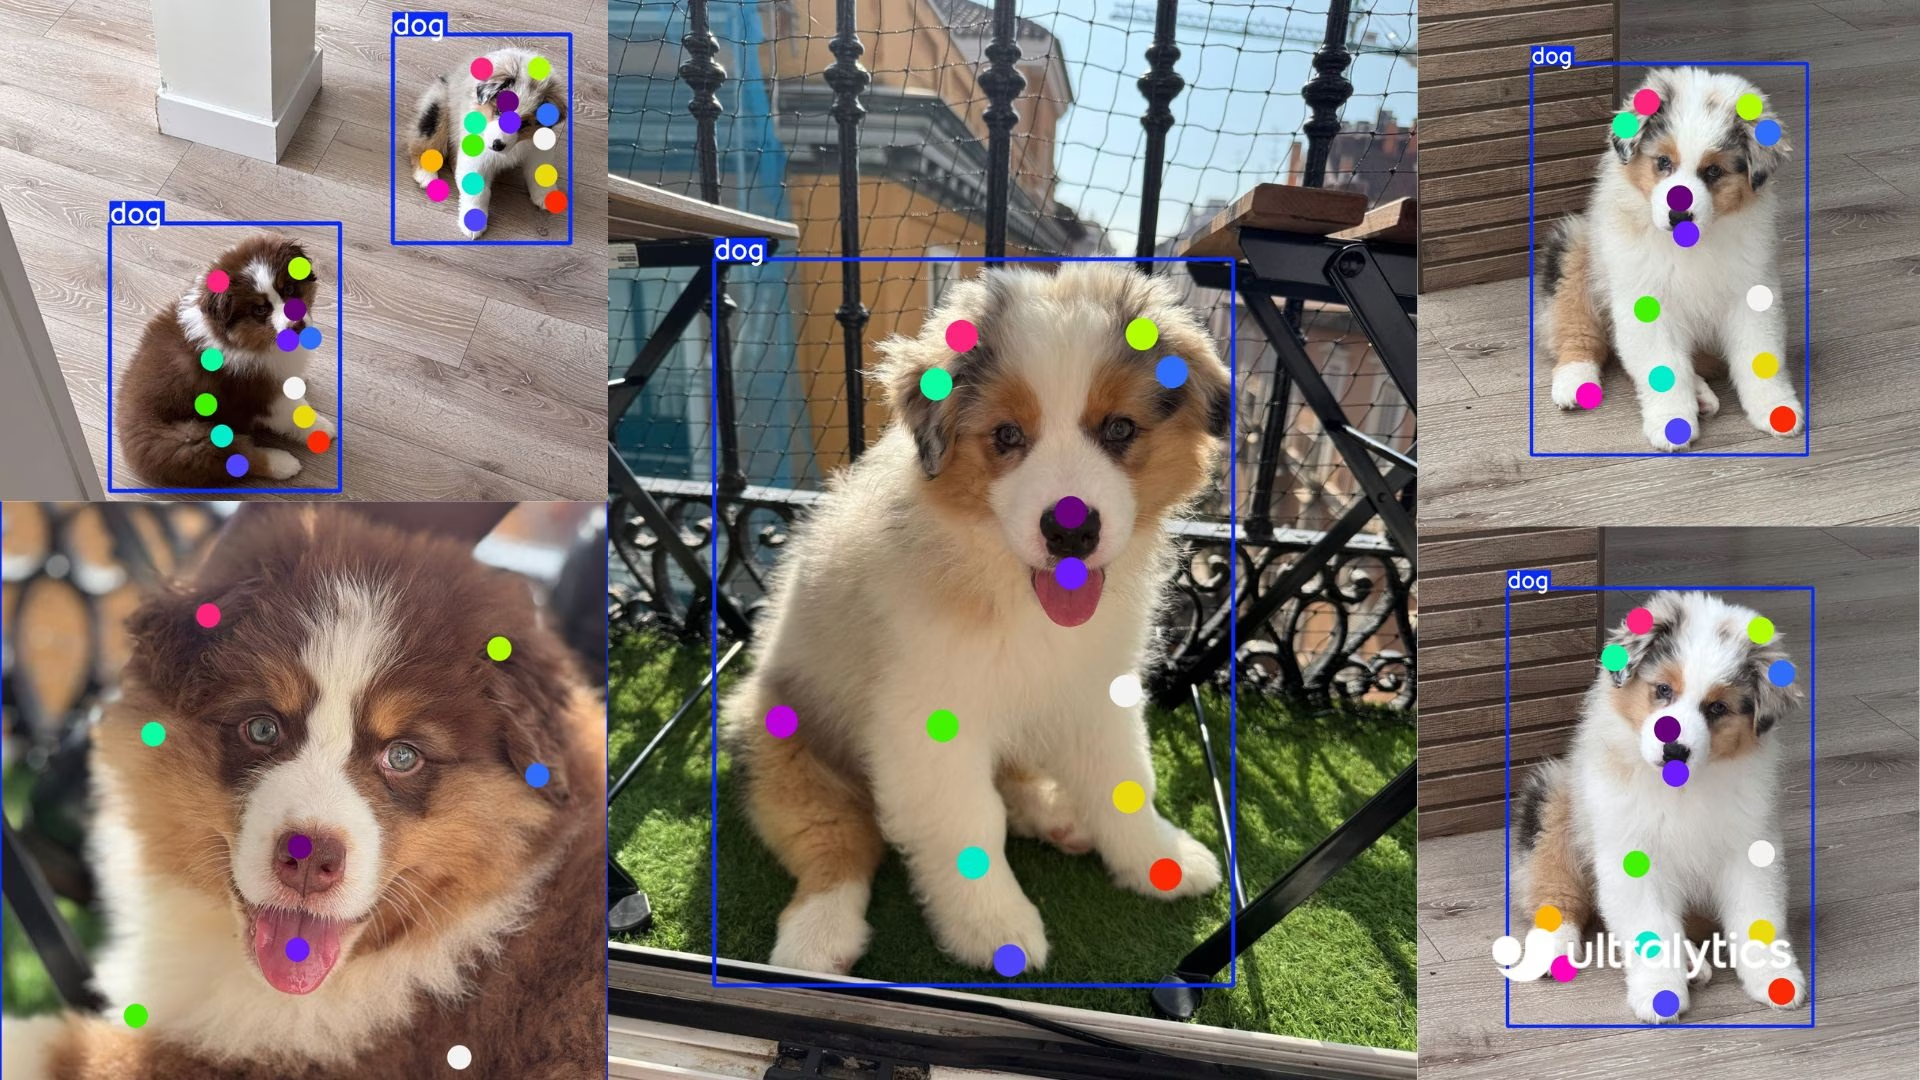
إذا كنت تبحث عن سلالة معينة أو حيوان مختلف تمامًا، تتولى منصة Ultralytics رفع البيانات وتصنيفها وتدريب نموذج نقاط مفتاحية مخصص على بياناتك، من دون الحاجة إلى إدارة البنية التحتية.
بنية مجموعة البيانات#
-
إجمالي الصور: 8,476 (6,773 للتدريب / 1,703 للتحقق)، مع ملفات تسميات مطابقة بتنسيق YOLO.
-
النقاط المفتاحية: 24 لكل كلب، ضمن ثلاثيات
(x, y, visibility). -
حجم التنزيل: ~337 MB.
-
التنظيم:
datasets/dog-pose/
├── images/{train,val}
└── labels/{train,val}
ملف YAML لمجموعة البيانات#
يُستخدم ملف YAML لتحديد إعدادات مجموعة البيانات. ويتضمن المسارات وتفاصيل النقاط المفتاحية وغيرها من المعلومات ذات الصلة. في حالة مجموعة بيانات Dog-Pose، يتوفر الملف dog-pose.yaml في https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Dogs dataset http://vision.stanford.edu/aditya86/ImageNetDogs/ by Stanford
# Documentation: https://docs.ultralytics.com/datasets/pose/dog-pose
# Example usage: yolo train data=dog-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dog-pose ← downloads here (337 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dog-pose # dataset root dir
train: images/train # train images (relative to 'path') 6773 images
val: images/val # val images (relative to 'path') 1703 images

# Keypoints
kpt_shape: [24, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)

# Classes
names:
  0: dog

# Keypoint names per class
kpt_names:
  0:
    - front_left_paw
    - front_left_knee
    - front_left_elbow
    - rear_left_paw
    - rear_left_knee
    - rear_left_elbow
    - front_right_paw
    - front_right_knee
    - front_right_elbow
    - rear_right_paw
    - rear_right_knee
    - rear_right_elbow
    - tail_start
    - tail_end
    - left_ear_base
    - right_ear_base
    - nose
    - chin
    - left_ear_tip
    - right_ear_tip
    - left_eye
    - right_eye
    - withers
    - throat

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dog-pose.zipالاستخدام#
من أجل تدريب نموذج YOLO26n-pose على مجموعة بيانات Dog-Pose لمدة 100 حقبة باستخدام حجم صورة يبلغ 640، يمكنك استخدام مقتطفات التعليمات البرمجية التالية.
from ultralytics import YOLO
# تحميل نموذج
model = YOLO("yolo26n-pose.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب)
# تدريب النموذج
results = model.train(data="dog-pose.yaml", epochs=100, imgsz=640)صور وتعليقات توضيحية نموذجية#
فيما يلي بعض الأمثلة على صور من مجموعة بيانات Dog-Pose، إلى جانب التعليقات التوضيحية المقابلة لها:
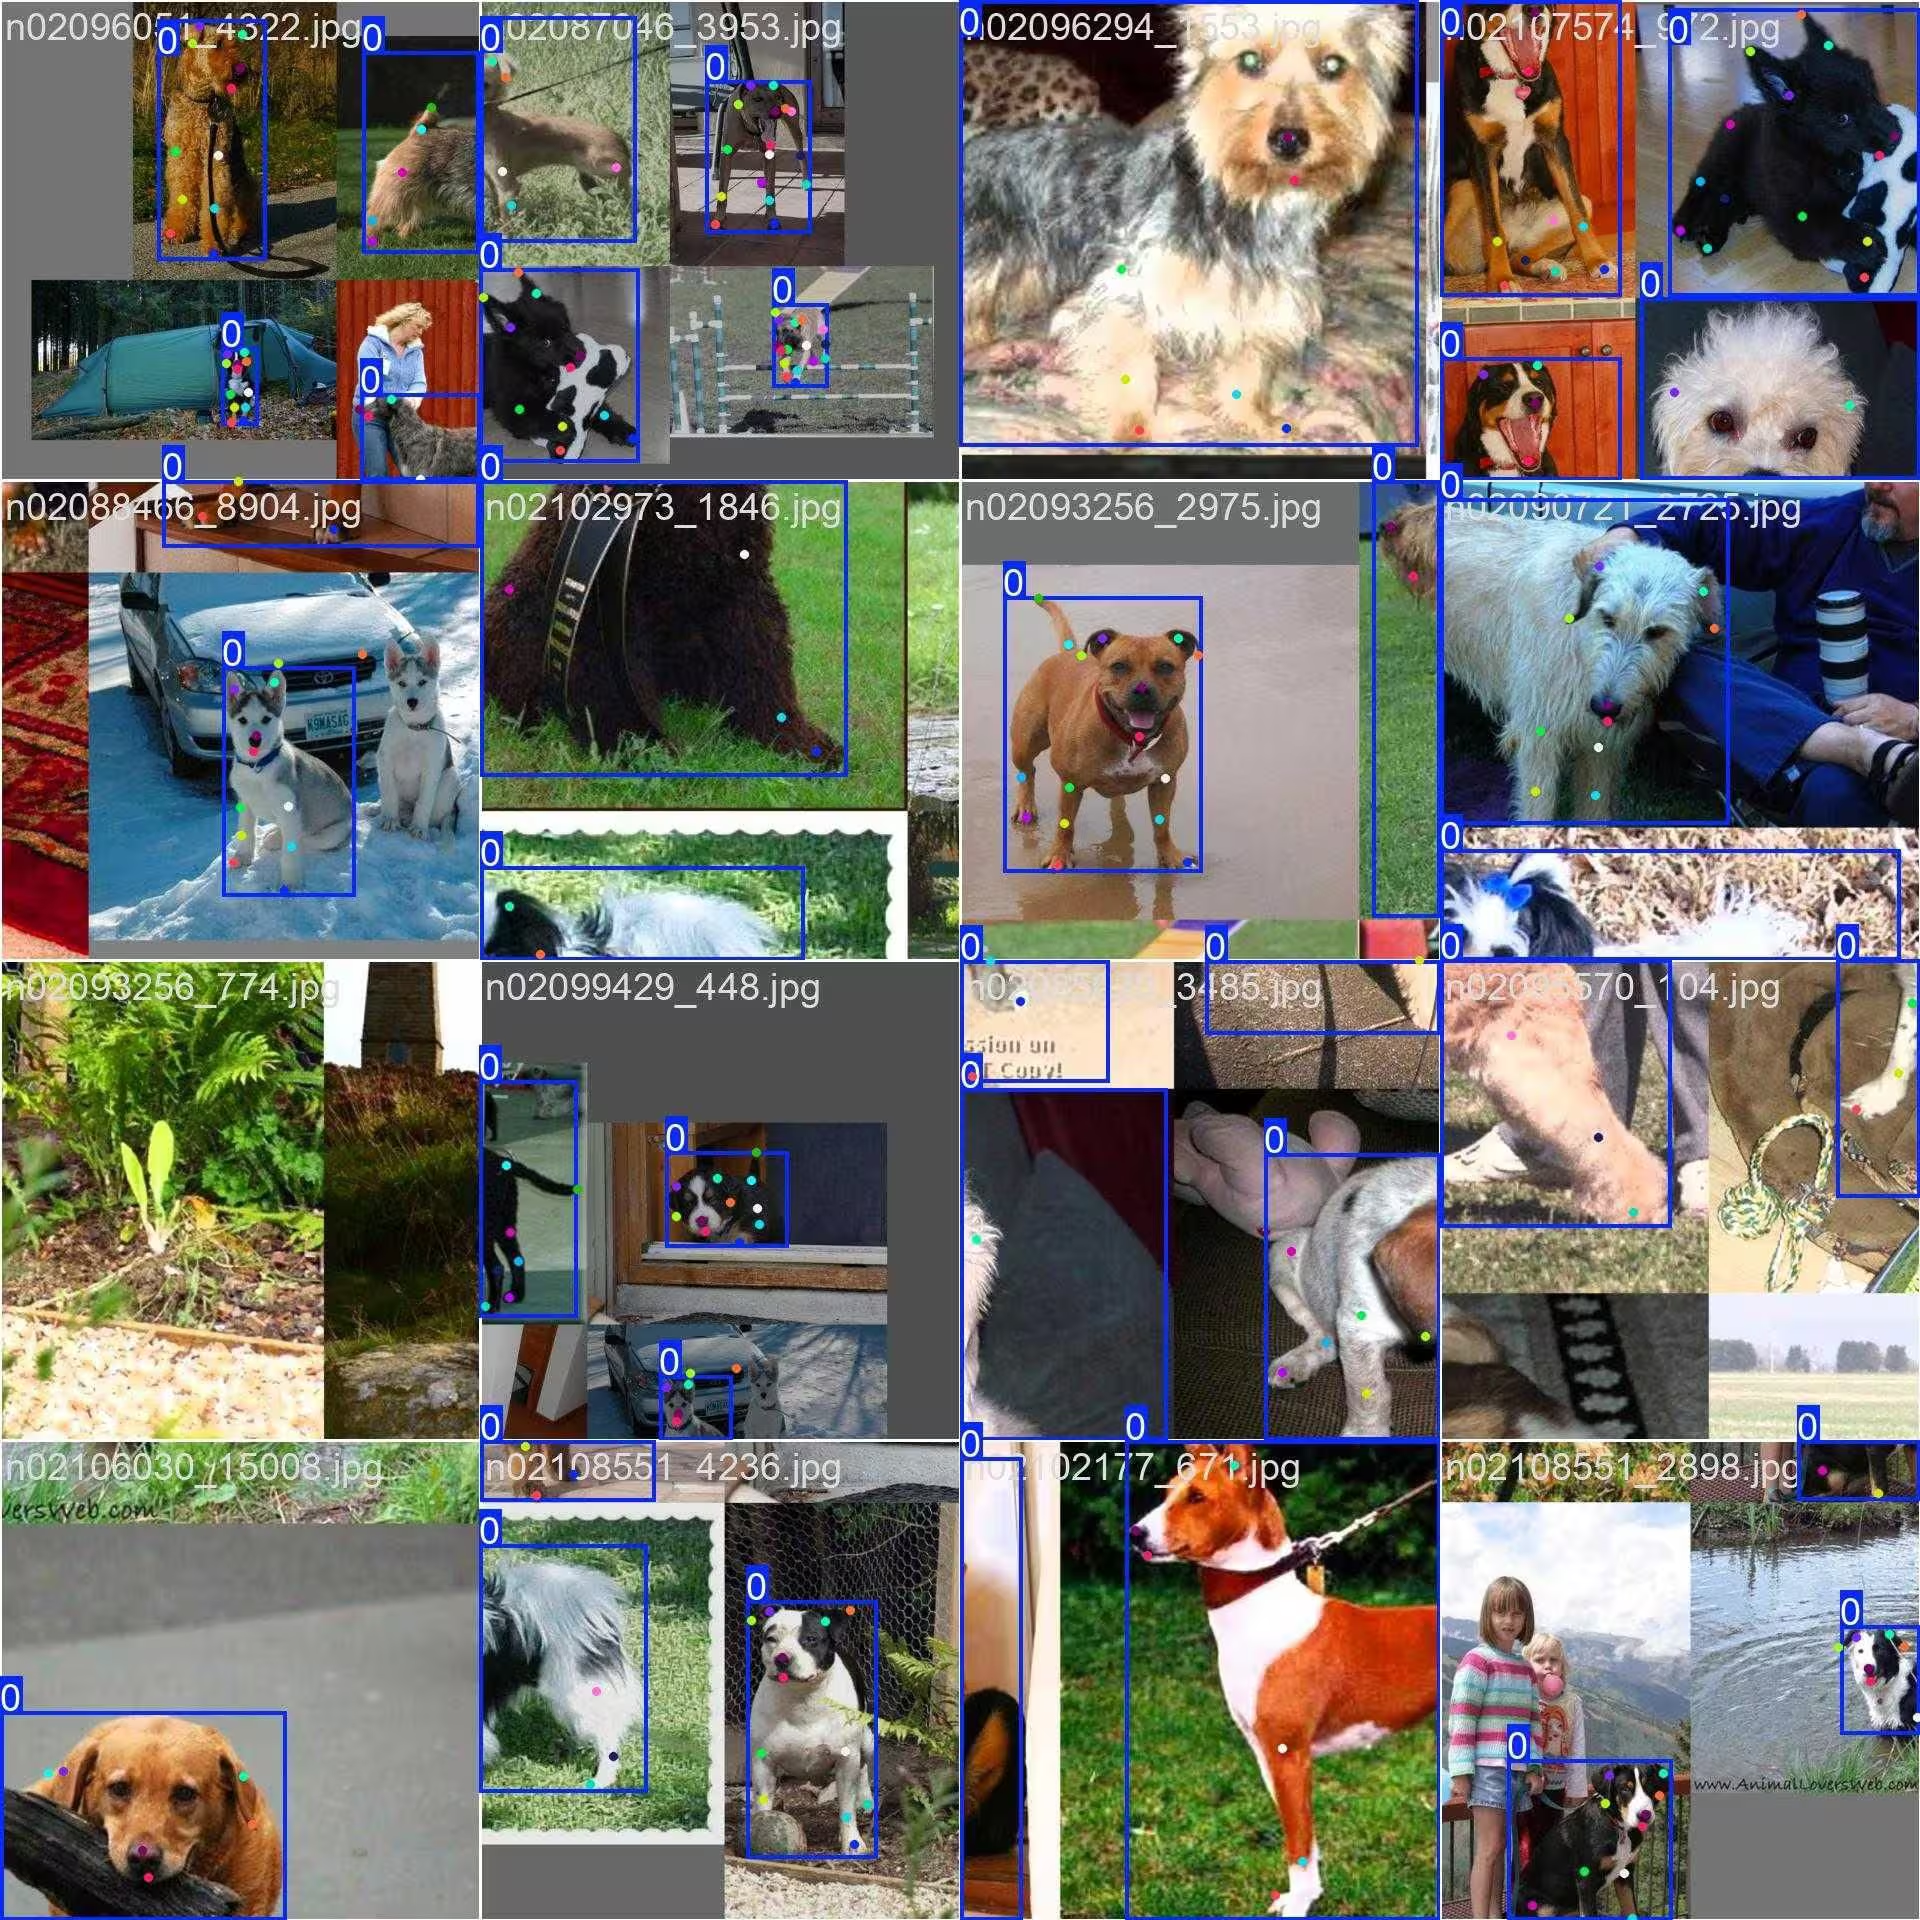
- صورة فسيفسائية: توضح هذه الصورة دفعة تدريب مكوّنة من صور مجموعة البيانات بعد دمجها بتقنية الفسيفساء. الفسيفساء تقنية تُستخدم أثناء التدريب، وتجمع صوراً متعددة في صورة واحدة لزيادة تنوع الكائنات والمشاهد في كل دفعة تدريب. ويساعد ذلك على تحسين قدرة النموذج على التعميم على أحجام الكائنات ونسب أبعادها وسياقاتها المختلفة.
يوضح المثال تنوع الصور وتعقيدها في مجموعة بيانات Dog-Pose، وفوائد استخدام تقنية الفسيفساء أثناء عملية التدريب.
الاستشهادات والشكر والتقدير#
إذا استخدمت مجموعة بيانات Dog-Pose في أبحاثك أو أعمال التطوير، فيُرجى الاستشهاد بالورقة البحثية التالية:
@inproceedings{khosla2011fgvc,
  title={Novel dataset for Fine-Grained Image Categorization},
  author={Aditya Khosla and Nityananda Jayadevaprakash and Bangpeng Yao and Li Fei-Fei},
  booktitle={First Workshop on Fine-Grained Visual Categorization (FGVC), IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
  year={2011}
}
@inproceedings{deng2009imagenet,
  title={ImageNet: A Large-Scale Hierarchical Image Database},
  author={Jia Deng and Wei Dong and Richard Socher and Li-Jia Li and Kai Li and Li Fei-Fei},
  booktitle={IEEE Computer Vision and Pattern Recognition (CVPR)},
  year={2009}
}
نود أن نعرب عن تقديرنا لفريق Stanford لإنشائه هذا المورد القيّم لمجتمع الرؤية الحاسوبية والمحافظة عليه. لمزيد من المعلومات حول مجموعة بيانات Dog-Pose ومطوريها، تفضل بزيارة موقع مجموعة بيانات Stanford Dogs.
الأسئلة الشائعة#
تضم مجموعة بيانات Dog-Pose عدد 6,773 صورة تدريب و1,703 صور تحقق، مشروحة بـ24 نقطة مفتاحية من أجل تقدير وضعيات الكلاب. وصُممت لتدريب النماذج والتحقق منها باستخدام Ultralytics YOLO26، وتدعم تطبيقات مثل تحليل سلوك الحيوانات ومراقبة الحيوانات الأليفة والدراسات البيطرية. وتجعل شروحها التفصيلية منها خيارًا مناسبًا لتطوير نماذج دقيقة لتقدير وضعيات الكلاب.
حمّل
yolo26n-pose.ptواستدعِmodel.train(data="dog-pose.yaml", epochs=100, imgsz=640)— راجع مثال التدريب أعلاه للاطلاع على مقتطفات Python وCLI كاملة، وصفحة التدريب الخاصة بالنموذج للاطلاع على قائمة شاملة بالوسيطات.بفضل 8,476 صورة إجمالًا (6,773 للتدريب / 1,703 للتحقق) تغطي مجموعة واسعة من سلالات الكلاب ووضعياتها، و24 نقطة مفتاحية في 3 أبعاد (x, y, visibility) لكل ترميز، توفر مجموعة بيانات Dog-Pose للنماذج تغطية لسيناريوهات العالم الحقيقي اللازمة لتطبيقات مثل مراقبة الحيوانات الأليفة وتحليل سلوكها.
تجمع تقنية الفسيفساء عدة صور من مجموعة Dog-Pose في صورة تدريب واحدة، ما يزيد تنوع وضعيات الكلاب وأحجامها وخلفياتها التي يراها النموذج في كل خطوة. وهذا يحسّن التعميم على السياقات والمقاييس الجديدة مع الحد من فرط التكيّف. للاطلاع على أمثلة الصور، راجع قسم الصور النموذجية والتعليقات التوضيحية.
يمكن العثور على ملف YAML لمجموعة بيانات Dog-Pose في https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. يحدد هذا الملف إعدادات مجموعة البيانات، بما فيها المسارات والفئات وتفاصيل النقاط المفتاحية وغيرها من المعلومات ذات الصلة. يحدد ملف YAML عددًا قدره 24 نقطة مفتاحية، لكل منها 3 أبعاد، ما يجعله مناسبًا لمهام تقدير الوضعيات التفصيلية.
لاستخدام هذا الملف مع نصوص تدريب YOLO26، أشر إليه في أمر التدريب كما هو موضح في قسم الاستخدام. ستُنزّل مجموعة البيانات تلقائيًا عند استخدامها لأول مرة، ما يسهّل إعدادها.
لمزيد من المعلومات عن نماذج النقاط المفتاحية، راجع وثائق مهمة تقدير الوضعيات.


التعليقات12
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
legend-zhen
Hello, although YOLOv11-pose can perform both object detection and pose estimation tasks simultaneously, there seems to be little correlation between the performance of pose estimation and object detection. What could be the reason for this? As I understand, YOLOv11-pose was specifically designed for human pose estimation, so can it also be perfectly adapted for animal pose estimation, as it is for humans? Are any special settings required when performing animal pose estimation?
 Glenn JocherUltralytics(تم التعديل)
@legend-zhen YOLO26 and YOLO11 pose models are indeed versatile and can be adapted for animal pose estimation, such as with the Dog-Pose dataset. While the architecture is optimized for human pose estimation, adapting it to animals typically requires a dataset with accurate annotations (e.g., 24 keypoints for dogs in Dog-Pose). No special settings are mandatory beyond ensuring the dataset YAML file is properly configured. For details on Dog-Pose, check here.
Peakednesss
I can just find 20 points, 4 for ears, 1 for nose, 1 for mouth, 2 for tail, and 12 for legs, where are the other four points?
- Glenn JocherUltralytics(تم التعديل)
@Peakednesss the Dog-Pose dataset has 24 keypoints. Beyond the 20 you found (ears, nose, chin, tail and legs), the other four are the left eye, right eye, withers and throat. The full list is in
kpt_namesin the dataset YAML: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. thank you very much
goodbetterbest1
do you know where are the other 4 points’ definitions? I can’t find any useful information in the yaml document. thx
chengziNaomi
When we annotate the key point data set in a picture, if the two boxes have overlapping parts, how to annotate the key points in the overlapping boxes?
- Glenn JocherUltralytics
@chengziNaomi when annotating overlapping bounding boxes in a keypoint dataset, ensure that each object's keypoints are labeled independently, even if they share overlapping regions. Annotate each keypoint based on its respective object, maintaining clear separation to avoid ambiguity during model training. For guidelines on keypoint annotation, refer to Dog-Pose Dataset Documentation.
If I have multiple objects in a picture, should I frame all the objects at once and then label the key points together, or should I frame an object, label the key points of that object, then frame an object, and then label the key points of that object?
- Glenn JocherUltralytics
@chengziNaomi when annotating a single image with multiple objects, you should annotate each object separately. Frame one object, label its keypoints completely, then move to the next object. This ensures clarity and avoids confusion during model training. Refer to Dog-Pose Dataset Documentation for more annotation insights.
Thank you very much! and how can I draw heatmap for key point detection?
- Glenn JocherUltralytics
You're welcome! To draw a heatmap for keypoint detection, you can preprocess the keypoints into Gaussian blobs on a blank image using libraries like OpenCV or NumPy, then overlay them on the original image. For detailed implementation, check external heatmap solutions or visualization tools as it currently falls outside YOLO's built-in features. Let me know if you have further questions!