YOLOE: الكشف والتجزئة بمفردات مفتوحة في الوقت الفعلي
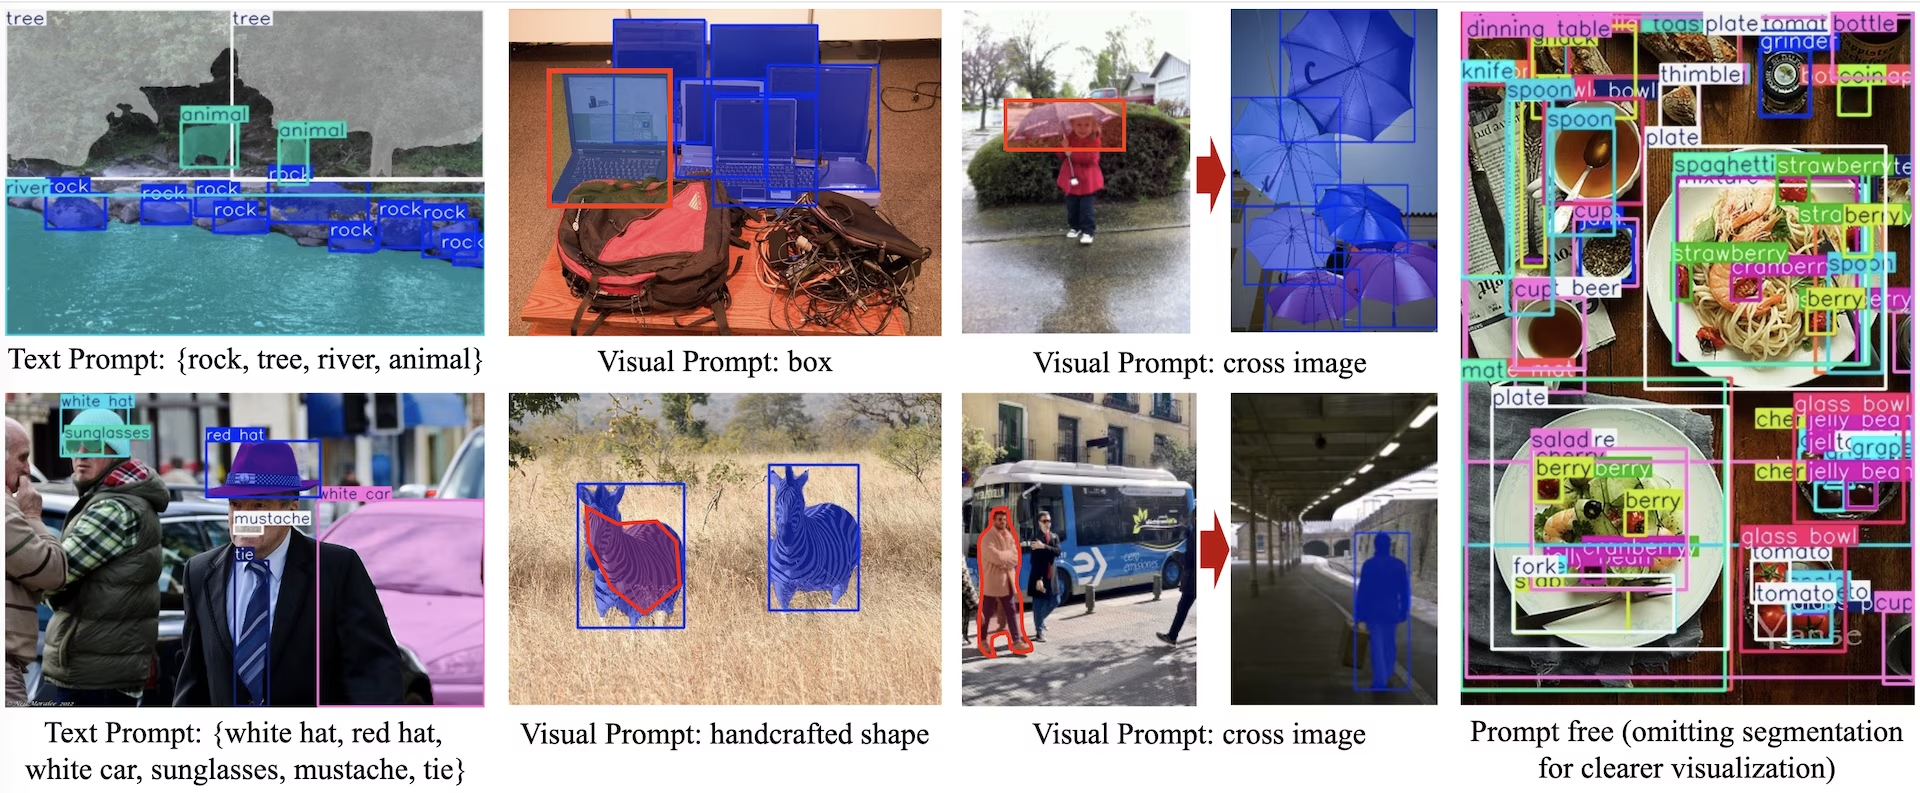
Ultralytics YOLOE (رؤية كل شيء في الوقت الفعلي) نموذج للكشف وتجزئة الكائنات بمفردات مفتوحة: فبدلًا من قائمة فئات ثابتة وقت التدريب، يستقبل الفئات التي تريدها وقت الاستدلال، على هيئة مطالبة نصية أو مثال مرئي أو مفردات مدمجة تضم 4,585 اسمًا. بُني YOLOE على بُنى Ultralytics YOLO — وهي YOLOv8 وYOLO11 وYOLO26 — واستُلهم من YOLO-World، ويحقق دقة عالية في التعلّم دون أمثلة بسرعة تقارب سرعة YOLO ذي الفئات المغلقة.
شاهد: كيفية استخدام Ultralytics YOLOE-26 (الجديد) | المفردات المفتوحة ورؤية كل شيء في الوقت الفعلي
البدء السريع#
حدّد الفئات التي تريدها وابدأ التشغيل. يعيد YOLOE-26 مربعات وأقنعة تجزئة للكائنات ضمن فئات لم يسبق له التدريب عليها.
from ultralytics import YOLOE
model = YOLOE("yoloe-26s-seg.pt")
# «حافلة ذات طابقين» ليست فئة في COCO؛ إذ يتعرف YOLOE عليها من الكلمات وحدها
model.set_classes(["double-decker bus", "person"])
results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()يُنزّل أول استدعاء لـ set_classes() مُرمِّزًا نصيًا؛ راجع التثبيت والمتطلبات قبل النشر على جهاز لا يتصل بالشبكة.
اختيار نمط المطالبة#
يدعم YOLOE ثلاثة أنماط للمطالبة، ويحدد اختيار النمط نقطة التحقق التي تحمّلها وشكل تسميات الفئات. اختر الصف المطابق لما يمكنك توفيره وقت الاستدلال.
| النمط | نقطة التحقق | ما توفّره | أسماء الفئات في النتائج | متى تستخدمه |
|---|---|---|---|---|
| مطالبة نصية | *-seg.pt | أسماء الفئات كسلاسل نصية | الأسماء نفسها التي أدخلتها تمامًا | يمكنك وصف الهدف بالكلمات — وهو الخيار المعتاد |
| مطالبة بصرية | *-seg.pt | صناديق أمثلة على صورة مرجعية | قيم عامة مثل object0 وobject1 و… | عندما يتعذر وصف الهدف بالكلمات: كجزء محدد أو شعار أو عيب |
| من دون مطالبة | *-seg-pf.pt | لا شيء | أسماء من المفردات المدمجة التي تضم 4,585 اسمًا | عندما تفهرس المحتوى أو تستكشفه ولا تعرف مسبقًا ما الذي تبحث عنه |
- المطالبات البصرية لا تنقل تسمياتك. تجمع معرّفات الفئات في
visual_promptsالأمثلة معًا؛ ويعرضها النموذج باسمobject0وobject1وما إلى ذلك. عليك ربطها بأسمائك بنفسك. - ترفض نقاط التحقق الخالية من المطالبات
set_classes(). يؤدي استدعاؤه على نموذج*-seg-pf.ptإلى رفعAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. حمّل نقطة تحقق*-seg.ptبدلًا من ذلك عندما تحتاج إلى فئاتك الخاصة.
التثبيت والمتطلبات#
يتوفر YOLOE ضمن حزمة Ultralytics الرئيسية:
pip install -U ultralyticsبالإضافة إلى ذلك، تتطلب المطالبات النصية مُرمِّزًا نصيًا، ويُنزَّل عند الاستخدام لأول مرة بدلًا من وقت التثبيت:
- يثبّت الاستدعاء الأول لـ
set_classes()مستودع ultralytics/CLIP من GitHub باستخدامpip(الذي يوفر أداة تقسيم النصوص إلى رموز)، وينزّل مُرمِّزًا نصيًا بصيغة TorchScript إلى دليل العمل الحالي. ينزّل YOLOE-26 الملفmobileclip2_b.ts، الذي يبلغ حجمه نحو 254 MB؛ بينما ينزّل YOLOE-11 وYOLOE-v8 الملفmobileclip_blt.ts. نفّذ التنزيل مرة واحدة من الدليل الذي ستعمل منه، أو انسخ الملف إليه، وإلا فسيُنزّل مرة أخرى. - تتطلب الخطوتان اتصالًا بالشبكة، لذا نفّذ تنبؤًا واحدًا باستخدام مطالبة قبل النشر على جهاز غير متصل أو معزول عن الشبكة.
- لا تحتاج المطالبات البصرية ونقاط التحقق الخالية من المطالبات إلى مُرمِّز نصي.
تتطلب نقاط التحقق YOLOE-26 الإصدار ultralytics 8.4.0 أو أحدث؛ أما عائلتا YOLOE-11 وYOLOE-v8 فمتاحتان في إصدارات أقدم. يختبر تنبؤ واحد باستخدام مطالبة نصية المسار بأكمله — تنزيل نقطة التحقق، وتثبيت CLIP، والمُرمِّز النصي، والاستدلال:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"لتجاوز تنزيل المُرمِّز النصي بالكامل وقت الاستدلال، أدمج المطالبات في الأوزان مرة واحدة وأعد استخدامها — راجع إعادة استخدام تضمينات المطالبات.
نظرة عامة على المعمارية#

يحافظ YOLOE على بنية YOLO القياسية — عمود فقري التفافي لاستخراج السمات، وعنق لدمج المقاييس المتعددة، ورأس منفصل بلا مراسي يتنبأ بالفئات والصناديق — ويضيف ثلاث وحدات، واحدة لكل نمط مطالبة:
- محاذاة المناطق والنصوص القابلة لإعادة المعلمات (RepRTA) تُحسِّن التضمينات النصية المستمدة من CLIP باستخدام شبكة مساعدة صغيرة. تعمل هذه الشبكة مرة واحدة لكل استدعاء
set_classes()، ويُدمج أثرها في النموذج عند التصدير، لذا لا تترتب عليها تكلفة لكل إطار. أما ما يُنفَّذ في كل مرور أمامي فهو مقارنة تضمينات المطالبات المخزنة بسمات المناطق؛ راجع القيود لمعرفة تكلفة ذلك عند استخدام مجموعة كبيرة من المطالبات. - تشفّر وحدة مُرمِّز المطالبات البصرية المنشّطة دلاليًا (SAVPE) السمات الدلالية وسمات التنشيط من صندوق مثال، لتكييف النموذج مع الأجسام المشابهة له. وهذا هو المسار ذو اللقطة الواحدة للأهداف التي يصعب تسميتها، مثل شعار أو جزء محدد.
- تطابق وحدة التباين الكسول بين المنطقة والمطالبة (LRPC) تضمينات المناطق مع مفردات مدمجة تضم 4,585 اسمًا، ما يتيح لنقاط التحقق الخالية من المطالبات التعرف على الأجسام من دون مطالبة خارجية أو مُرمِّز نصي.
تُنفّذ تجزئة الكائنات عبر فرع أقنعة في رأس الكشف، كما في YOLOv8-Seg، ويحمل كل تنبؤ قناعًا على results[0].masks. بعد تصدير النموذج، تُعاد معلمة وحدات العالم المفتوح لتصبح رأس YOLO قياسيًا، لذا يشغّل الملف المُصدّر مسار الكشف/التجزئة المعتاد.
النماذج المتاحة#
كل نقطة تحقق أدناه هي نموذج لتجزئة الكائنات، وتدعم val وpredict وexport وtrack. حمّل ملف *-seg.pt للمطالبة النصية أو المرئية، وملف *-seg-pf.pt للاستدلال بلا مطالبات؛ فالملفان غير قابلين للتبادل، راجع اختيار وضع المطالبة. وحدها ملفات *-seg.pt تدعم train؛ إذ تُنتج نقطة تحقق بلا مطالبات من نموذج مدرّب بالمطالبات النصية، راجع تدريب النماذج الرسمية من الصفر.
| النموذج | مطالبة نصية / بصرية | من دون مطالبة |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
أداء YOLOE على LVIS#
نتائج دون أمثلة تدريبية على LVIS minival بدقة 640 بكسل، من ورقة Ultralytics YOLO26.
المطالبات النصية والبصرية#
تعرض كل خلية للدقة والمعلمات القيم بالترتيب مطالبة نصية / مطالبة بصرية؛ وتُذكر FLOPs مرة واحدة. تخص قيم المعلمات وFLOPs إعداد الكشف الذي تقيّمه الورقة. الدقة هي قيمة Non-E2E الواردة في الورقة، وهي البروتوكول الوحيد الذي تذكر نتائجه لكل نموذج في المقارنة؛ ويتأخر رأس YOLOE-26 الشامل من البداية إلى النهاية عنها بحد أقصى قدره 1.1 AP مع المطالبات النصية و2.6 AP مع المطالبات البصرية.
| النموذج | mAP50-95 | mAPr | mAPc | mAPf | المعاملات (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
من دون مطالبة#
تستخرج نقاط التحقق الخالية من المطالبات النتائج من مفرداتها المدمجة من دون تقديم مطالبة. تعرض كل خلية للدقة القيم بالترتيب من البداية إلى النهاية / Non-E2E، وهما البروتوكولان اللذان تقيس الورقة YOLOE-26 وفقهما؛ وتورد صفحة YOLO26 عمود Non-E2E.
| النموذج | mAP50-95 | mAPr | mAPc | mAPf | المعاملات (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
في ظل المطالبات النصية والبصرية، تتصدر نماذج YOLOE-26 نظيراتها YOLOE-11 وYOLOE-v8 عند كل حجم متطابق من حيث mAP50-95، مع بقائها أقل من سلسلة v8 في عدد المعاملات وFLOPs. وفي المجموعة نفسها، تذكر الورقة نتائج YOLO-Worldv2 بقيم 24.4 (S) و32.4 (M) و35.5 (L)، وكواشف Transformer بقيم 26.0 لـ GLIP-T، و27.4 لـ GDINO-T، و34.4 لـ DetCLIP-T، ويضم كل منها ما بين 155 و232 مليون معامل. وتضيف ورقة YOLOE الأصلية نتيجتين للنماذج بمقياس v8 التي قدمتها. على LVIS، يتفوق YOLOE-v8s على YOLO-Worldv2-S بمقدار 3.5 AP، بتكلفة تدريب تعادل الثلث وسرعة استدلال تبلغ 1.4×. وعند نقله إلى COCO، يحقق YOLOE-v8l زيادة قدرها 0.6 box AP و0.4 mask AP مقارنةً بـ YOLOv8-L ذي الفئات المغلقة، مع تقليل زمن التدريب بنحو 4×.
تقيّم ورقة YOLO26 إعدادًا للكشف. أما الأوزان المنشورة فهي نقاط تحقق للتجزئة وتتضمن فرع أقنعة وSAVPE وإسقاطًا نصيًا إضافيًا، لذا يعرض yoloe-26l-seg.pt المحمّل 35.4 M و142.0 B بدلًا من 25.5 M و89.0 B المذكورتين أعلاه. وفي الحالتين، لا يشمل رقم FLOPs تشابه المنطقة والنص، لذا ترتفع التكلفة الفعلية مع حجم مجموعة المطالبات رغم ثبات قيمة العمود؛ راجع القيود.
أمثلة الاستخدام#
يُشغَّل كل مثال من أمثلة YOLOE أدناه عبر واجهة Python البرمجية. كما تعمل عمليات التنبؤ بموجهات النص والتحقق والتصدير والتتبع والتدريب العادي عبر CLI؛ أما وصفات الضبط الدقيق فتمرر فئة مدرّب، ويُمرر التوجيه المرئي مصفوفات موجهات NumPy، ولا تقبل ذلك إلا واجهة Python البرمجية.
استخدام التدريب#
اضبط بدقة أي نقطة تحقق مُصدرة من *-seg.pt باستخدام مجموعة بيانات YOLO الخاصة بك. يتبع ذلك إلى حد كبير إجراء تدريب YOLO القياسي؛ والاختلاف هو المدرب الذي تمرّره. يدمج YOLOEPESegTrainer أسماء الفئات الخاصة بك في الرأس، ثم يضبط النموذج بدقة انطلاقًا من هناك، وهذا ما تحتاج إليه عند استخدام التسميات الخاصة بك؛ فالمدرب الافتراضي لا يدرّب النموذج على أسماء الفئات الخاصة بك. تتنبأ نقطة التحقق الناتجة بفئات مجموعة بياناتك مباشرةً: لم يعد الرأس يقرأ المطالبات، لذا يُصدر set_classes() خطأً إذا تغيّرت الفئات، وكذلك المطالبات البصرية. استخدم المطالبات مع نقطة التحقق الأصلية للفئات الأخرى.
شاهد: كيفية تدريب YOLOE على مجموعة بيانات تجزئة أجزاء السيارات | نموذج المفردات المفتوحة والتنبؤ والتصدير
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer
model = YOLOE("yoloe-26s-seg.pt")
results = model.train(
data="coco128-seg.yaml",
epochs=80,
patience=10,
trainer=YOLOEPESegTrainer, # <- مهم: مدرّب الضبط الدقيق، وليس المدرّب الافتراضي
)كل نقطة تحقق منشورة هي نموذج تجزئة. لتدريب كاشف، أنشئ النموذج باستخدام YAML المطابق، وحمّل أوزان التجزئة ذات المقياس نفسه، واستبدل مدرّب التجزئة بمدرّب الكشف. ولا يتغير أي شيء آخر.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
الاستخدام للتنبؤ#
استدعاء موجه النص هو المعروض في البدء السريع. يضيف التوجيه المرئي وسيطة visual_prompts، بينما يحمّل التنبؤ دون موجهات نقطة تحقق -pf بدلًا من ذلك:
تعرض المطالبات البصرية على النموذج مثالًا بدلًا من وصفه. يأخذ visual_prompts مصفوفة bboxes لصناديق أمثلة ومصفوفة cls لمعرّفات الفئات، مع معرّف واحد لكل صندوق. المعرّفات تجميعات مؤقتة، وليست تسميات — ويجب أن تكون متسلسلة بدءًا من 0، وتُعاد النتائج على هيئة object0 وobject1، … بدلًا من الأسماء التي تختارها.
يمكن وضع صناديق الأمثلة على الصورة التي تريد التنبؤ بها:
import numpy as np
from ultralytics import YOLOE
model = YOLOE("yoloe-26l-seg.pt")
# صندوق مثال واحد لكل هدف، ولكل صندوق معرّف فئة خاص به
visual_prompts = {
"bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]), # شخص، نظارات
"cls": np.array([0, 1]),
}
results = model.predict(
"ultralytics/assets/bus.jpg",
visual_prompts=visual_prompts,
)
results[0].show()أو على صورة مرجعية منفصلة تُمرّر بوصفها refer_image، وفي هذه الحالة يصف bboxes وcls الأجسام في الصورة المرجعية، لا في الصورة المستهدفة:
import numpy as np
from ultralytics import YOLOE
model = YOLOE("yoloe-26l-seg.pt")
visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])} # person
results = model.predict(
"ultralytics/assets/zidane.jpg", # الصورة المستهدفة
refer_image="ultralytics/assets/bus.jpg", # موضع صناديق الأمثلة
visual_prompts=visual_prompts,
)
results[0].show()
# يضبط refer_image الفئات نهائيًا أيضًا، لذا لا تحتاج الاستدعاءات اللاحقة إلى أي مطالبات
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # ويحتفظ بها التصدير أيضًاعندما يكون source فيديو أو بثًا، يصبح الإطار الأول تلقائيًا هو refer_image، لذا تُطبّق المطالبات التي تمررها على ذلك الإطار وتستمر على بقية الفيديو. مرّر refer_image صراحةً لاختيار إطار آخر.
يقبل كل من source وrefer_image موترات torch مباشرةً، وهو أمر مفيد عندما تكون الصور آتيةً من مسار معالجة قائم. أعطِ الصناديق إحداثيات البكسل الخاصة بالموتر نفسه:
import numpy as np
import torch
from ultralytics import YOLOE
model = YOLOE("yoloe-11l-seg.pt")
img_tensor = torch.rand(1, 3, 480, 480) # موتر عائم بالشكل (1, 3, H, W) في النطاق [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}
results = model.predict(
img_tensor,
refer_image=img_tensor,
visual_prompts=visual_prompts,
imgsz=640,
)للتنبؤ بعدة صور دفعةً واحدة، ضمّن المطالبات في مستوى أعمق: مصفوفة bboxes واحدة ومصفوفة cls واحدة لكل صورة مصدر، وبالترتيب نفسه للصور المصدر.
import numpy as np
from ultralytics import YOLOE
model = YOLOE("yoloe-26l-seg.pt")
visual_prompts = {
"bboxes": [
np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]), # bus.jpg: شخص، نظارات
np.array([[150, 200, 1150, 700]]), # zidane.jpg: شخص
],
"cls": [np.array([0, 1]), np.array([0])],
}
results = model.predict(
["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
visual_prompts=visual_prompts,
)
results[0].show()الاستخدام للتحقق#
يجري التحقق كما في أي نموذج آخر على مجموعة بيانات تجزئة:
from ultralytics import YOLOE
model = YOLOE("yoloe-26l-seg.pt") # أو yoloe-26s/m-seg.pt للأحجام الأخرى
metrics = model.val(data="coco128-seg.yaml")يمكن أن يكون data أيضًا ملف NDJSON أو عنوان URI لمجموعة بيانات على المنصة ul://؛ ويُحوَّل إلى تنسيق YOLO قبل إنشاء المطالبات النصية أو المرئية.
يغطي شكلان مختلفان للاستدعاء نفسه نمطي المطالبات الآخرين:
- المطالبات البصرية — يستخرج
model.val(data="coco128-seg.yaml", load_vp=True)تضمينًا بصريًا لكل فئة من مجموعة البيانات نفسها. أضفrefer_data="coco.yaml"لاستخدام التضمينات من مجموعة بيانات مختلفة، على أن تتضمن الفئات نفسها تمامًا. - بلا مطالبات — حمّل نقطة تحقق
*-seg-pf.ptومرّرsingle_cls=True.
استخدام التصدير#
يمكن حفظ تضمينات المطالبات مرة واحدة وإعادة استخدامها عند إنشاء عمليات تصدير ثابتة مثل ONNX وOpenVINO وTensorRT وCoreML وLiteRT وRKNN. يُحمّل نموذج PyTorch الأصلي ملف تعريف NPZ قبل التصدير؛ فهو ليس مدخلًا إضافيًا لوقت التشغيل، ولا يتطلب النموذج المُصدّر ملف NPZ.
تُدمج الفئات المضبوطة باستخدام set_classes() (أو عبر refer_image للمطالبات البصرية) في الأوزان المُصدّرة. بعد التصدير، لا يعود النموذج قادرًا على قبول مطالبات جديدة: سيفشل استدعاء set_classes() أو تمرير visual_prompts=... إلى predict() على تصدير محمّل. لتغيير الفئات المكتشفة، أعد التصدير من نقطة التحقق الأصلية .pt بعد ضبط المطالبات الجديدة. يتصرف الملف المُصدّر كنموذج YOLO قياسي، ويمكن تحميله أيضًا باستخدام YOLO() بدلًا من YOLOE().
from ultralytics import YOLOE
model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")
# يرتبط ملف التعريف بنقطة التحقق المصدر، ويمكن إعادة استخدامه في عمليات التصدير اللاحقة.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")يمكن لملف المطالبات نفسه أيضًا إعداد نموذج للكشف فقط، يُبنى وفق بنية YOLOE المطابقة. يؤدي ذلك إلى إزالة فرع الأقنعة مع الإبقاء على الفئات المحددة بالمطالبات:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
تتبُّع الاستخدام#
تنتقل الفئات المحددة بالمطالبات مباشرةً إلى التتبع، ما يتيح لك تتبع أجسام لم يُدرّب المتعقّب عليها قط:
from ultralytics import YOLOE
model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])
# يحافظ persist=True على ثبات معرّفات التتبع عبر الإطارات
for result in model.track("path/to/video.mp4", stream=True, persist=True):
print(result.boxes.id)مقارنة YOLOE#
يقع YOLOE بين كاشف ذي فئات مغلقة ونموذج ثقيل ذي مفردات مفتوحة. وتحدد ثلاثة أوجه مقارنة ما إذا كان الخيار المناسب:
- مقارنةً بـ YOLO ذي الفئات المغلقة. بعد ضبط المطالبات، يتنبأ YOLOE عبر مسار الكشف/التجزئة المعتاد ويُصدّر مثل أي نموذج آخر. وما يضيفه هو إمكانية تغيير قائمة الفئات وقت الاستدلال بدلًا من إعادة التدريب؛ أما تكلفته فهي دقة الاستدلال الصفري الأقل بكثير من دقة نموذج دُرّب على فئاتك.
- مقارنةً بعائلات YOLOE الأقدم. يرث YOLOE-26 الرأس الشامل الخالي من NMS في YOLO26، ويغطي خمسة مقاييس (n/s/m/l/x) مقابل ثلاثة في الإصدارات الأقدم (s/m/l)، ويتصدر عند كل مقياس متطابق في الأداء.
- مقارنةً بكواشف المفردات المفتوحة القائمة على Transformer. يشغّل GLIP وOWL-ViT نموذج Transformer للرؤية واللغة وقت الاستدلال. أما YOLOE فيرمّز المطالبات مرة واحدة، ثم يقارنها بسمات المناطق داخل رأس التفافي.
تقبل أقرب البدائل كلها مطالبة نصية، لكن YOLOE وSAM 3 وحدهما يعيدان أقنعة، وتجيب النماذج الثلاثة عن أسئلة مختلفة:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| مصمم من أجل | الكشف والتجزئة في الوقت الفعلي للفئات المحددة بالاسم | تجزئة المفاهيم والتتبع القابل للتوجيه بالمطالبات | الكشف عن المفردات المفتوحة في الوقت الفعلي |
| الأقنعة | نعم، باستخدام نقاط التحقق *-seg.pt | نعم | لا، صناديق فقط |
| المطالبات البصرية | نعم (SAVPE) | نعم | لا |
| الوضع بلا مطالبات | نعم، مفردات تضم 4,585 اسمًا | لا | لا |
| اختره عندما | تحتاج إلى معدل معالجة مرتفع ويمكنك تسمية الفئات | تحتاج إلى أقوى تجزئة للمفاهيم ويمكنك تخصيص القدرة الحاسوبية اللازمة | تستخدمه بالفعل — راجع ملاحظة الترحيل أدناه |
هل تنتقل من YOLO-World؟ للواجهة البنية نفسها: استبدل YOLOWorld بـ YOLOE، وحمّل نقطة تحقق *-seg.pt، وأبقِ استدعاء set_classes() كما هو. ستحصل على الأقنعة والمطالبات البصرية؛ وتنطبق على كليهما ملاحظة التصدير المتعلقة بتجميد الفئات.
حالات الاستخدام والتطبيقات#
يلغي الكشف ذو المفردات المفتوحة خطوة إعادة التدريب لكل فئة، ويكون ذلك بالغ الأهمية عندما لا تكون قائمة الأهداف معروفة مسبقًا:
- الكشف في عالم مفتوح — الروبوتات وأنظمة الأمن التي تواجه أجسامًا لم يحددها أحد وقت التدريب.
- الكشف من مثال واحد — تلتقط المطالبات البصرية جزءًا أو شعارًا أو عيبًا محددًا من صندوق مرجعي واحد، وهو أمر مفيد في الفحص الصناعي.
- فهرسة العناصر النادرة — تتسع المفردات المدمجة ذات الأسماء البالغ عددها 4,585 لمسوحات رصد التنوع البيولوجي أو مخزون التجزئة.
- التهيئة الأولية لمجموعة البيانات — أضف تسميات مسبقة إلى الصور بصناديق وأقنعة قبل المراجعة البشرية، ثم درّب نموذجًا سريعًا ذا فئات مغلقة على النتائج.
- تجزئة أهداف اعتباطية — تعيد نقاط التحقق المنشورة
*-seg.ptقناعًا مع كل تنبؤ، لذا يحصل كل من التصوير الطبي وتحليل صور الأقمار الصناعية على مخرجات دقيقة على مستوى البكسل دون نموذج ثانٍ.
يجمع نمط شائع بين وضعين: شغّل النموذج بلا مطالبات مرةً لاكتشاف العناصر الموجودة، ثم انتقل إلى المطالبات النصية للفئات المهمة.
القيود#
يستبدل YOLOE بعض الدقة بإمكانية تغيير الفئات وقت الاستدلال. وهذه أهم العواقب التي ينبغي معرفتها قبل اعتماده:
- دقة الاستدلال الصفري أقل بكثير من دقة نموذج دُرّب على فئاتك. تحقق نقاط التحقق الموجّهة بالمطالبات نحو 22–40 mAP على LVIS minival؛ وسيتفوق عليها YOLO ذو الفئات المغلقة والمدرّب على بياناتك ضمن تلك الفئات. استخدم YOLOE لتغطية الفئات التي لا يمكنك التدريب عليها، لا ليحل محل التدريب.
- الفئات النادرة هي نقطة الضعف. يعرض عمود mAPr في الأداء الدقة على الفئات النادرة في LVIS تحديدًا، ويكون أداؤه في ظل المطالبات النصية أدنى من عمودي الفئات الشائعة والمتكررة في كل صف. تحقّق من هذا العمود بدلًا من رقم mAP الإجمالي عندما تكون أهدافك غير مألوفة.
- تصف المطالبة المظهر لا العلاقات. يعمل الكشف بمقارنة سمات المناطق بتضمين المطالبة، لذا لا توفر المطالبات المعتمدة على الحالة أو السياق أو المقارنة — مثل "متضرر" و"الأقصى يسارًا" و"الذي يحمله شخص" — أساسًا موثوقًا للمطابقة. فضّل صياغة قريبة من أسماء الفئات الشائعة.
- تزيد مجموعات المطالبات الكبيرة زمن الاستجابة. تُحسب تضمينات المطالبات مرة واحدة، لكنها تُقارَن بسمات المناطق في كل تمريرة أمامية. وعند القياس على CPU باستخدام
yoloe-26s-seg.pt، تزداد مدة التمريرة الأمامية بنحو 19% عند الانتقال من 80 إلى 1,203 فئات، وبنحو 89% عند استخدام المفردات الكاملة ذات الأسماء البالغ عددها 4,585. لا تتغير قيم FLOPs المُبلّغ عنها مطلقًا، لأن تشابه المنطقة والنص غير محسوب، لذا لن ينبهك الملف التعريفي إلى ذلك. - أسماء الفئات مؤقتة إلى أن تحدد المطالبات. تعرض نقطة تحقق
*-seg.ptالمحمّلة حديثًاnc=80بأسماء رقمية ("0"و"1"و…)، لذا استدعِset_classes()قبل قراءة التسميات. أما نقاط التحقق التي تعمل بلا مطالبات فتأتي ومفرداتها الكاملة معبأة مسبقًا.
ملاحظات النشر#
- الأجهزة. يتطلب الاستدلال وحدة GPU من NVIDIA بذاكرة VRAM سعتها 4–8 GB؛ وتعمل المقاييس
nوsعلى وحدات GPU طرفية مثل Jetson، أو على CPU بدقة منخفضة. ويتطلب الضبط الدقيق وحدة GPU واحدة. - NMS لا يراعي الفئات افتراضيًا. يتنبأ YOLOE باستخدام
agnostic_nms=True. ويثبط هذا الخيار افتراضيًا الصناديق المتداخلة الأقل تسجيلًا عبر الفئات المختلفة بدلًا من الاقتصار على الفئة نفسها، ما يمنع التكرارات عندما يطابق جسم واحد عدة فئات. معnms=False، لا يطبّق YOLOE-26 أي تثبيط وفق IoU؛ ولا يحتفظ الوضع غير المراعي للفئات إلا بأفضل فئة واحدة لكل مرساة، بدلًا من السماح لمرساة واحدة بإخراج تسميات فئات متعددة. مرّرagnostic_nms=Falseلتجاوز الإعداد الافتراضي. - تكون المطالبات البصرية افتراضيًا
conf=0.05. تكون صناديق المطالبات البصرية أدق مما توحي به درجاتها: ففي مجموعة LVIS minival، عند استخدام مثيل واحد من فئة ما مطالبةً، يفوّتconf=0.25ما بين 44 و55% من المثيلات الأخرى التي يعثر عليها YOLOE-26 عندconf=0.05. قد تحتاج المشاهد الكثيفة التي تضم أجسامًا متطابقة تقريبًا، مثل رفوف المتاجر أو الخلايا، إلى قيم أقل، ومعnms=Falseتكون درجات رأس المطابقة واحدًا إلى واحد في YOLOE-26 أقل حتى من ذلك، ويقترب أفضل حدّ له من0.01. وتحتفظ جميع الاستدعاءات الأخرى بالقيمةconf=0.25، بما في ذلك الاستدعاءات اللاحقة والتضمينات المحفوظة وعمليات التصدير التي تعيد استخدام الفئات المحددة بواسطةrefer_image. مرّرconfلتجاوز القيمة الافتراضية. - المعالجة الدفعية. تعمل استدلالات الدفعات مباشرةً، ويمكن أن تختلف المطالبات البصرية لكل صورة في الاستدعاء نفسه.
تدريب النماذج الرسمية من الصفر#
لا يحتاج معظم القراء إلى ذلك مطلقًا. فهو يعيد إنتاج نقاط التحقق المنشورة ذات المفردات المفتوحة من Objects365 وGQA وFlickr30k — نحو 1.4 مليون عينة تدريب على 8× RTX 4090 — ولا صلة له بالضبط الدقيق على بياناتك، المشروح ضمن استخدام التدريب أعلاه.
يرفض كل مدرّب يرث YOLOETrainer القيمة compile=True، بما في ذلك YOLOESegTrainer الافتراضي وجميع المدرّبات التالية التي تدرّب من الصفر. مرّر compile=False (القيمة الافتراضية). ولا يخضع مدرّبا الضبط الدقيق المستخدمان أعلاه، YOLOEPESegTrainer وYOLOEPETrainer، لهذا القيد.
يتطلب التدريب تعليقات توضيحية للمقاطع. إما أن تنزّل الملفات المعالجة أدناه، أو تنشئ ملفاتك باستخدام البرنامج النصي الذي يقدمه الفريق الرسمي، المدعوم بـ SAM 2.1. ويستخدم التحقق LVIS minival.
| مجموعة البيانات | النوع | العينات | الصناديق | تعليقات توضيحية للمقاطع بعد المعالجة |
|---|---|---|---|---|
| Objects365v1 | الكشف | 609k | 9621k | objects365_train_segm.json |
| GQA | التأريض | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | التأريض | 149k | 641k | final_flickr_separateGT_train_segm.json |
يُدرّب نموذج المطالبات النصية أولًا، ويُعد نمطا المطالبات الآخران تحسينين له:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch
data = {
"train": {
"yolo_data": ["Objects365.yaml"],
"grounding_data": [
{
"img_path": "flickr/full_images/",
"json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
},
{
"img_path": "mixed_grounding/gqa/images",
"json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
},
],
},
"val": {"yolo_data": ["lvis.yaml"]},
}
model = YOLOE("yoloe-26l-seg.yaml")
model.train(
data=data, # أو مسار ملف YAML يتضمن البنية نفسها
batch=128,
epochs=30,
close_mosaic=2,
optimizer="AdamW",
lr0=2e-3,
warmup_bias_lr=0.0,
weight_decay=0.025,
momentum=0.9,
workers=4,
trainer=YOLOESegTrainerFromScratch,
device="0,1,2,3,4,5,6,7",
)تبدأ نقاط التحقق الخاصة بالموجّهات المرئية والخالية من الموجّهات من نموذج الموجّه النصي المدرَّب، ويحدّث كل منها وحدة واحدة. تمثل YOLOESegVPTrainer وصفة الموجّه المرئي، وتمثل YOLOEPEFreeTrainer الوصفة الخالية من الموجّهات، لكن أياً منهما لا يجمّد أي شيء بمفرده: يأتي التدريب الانتقائي من قائمة freeze التي تمررها إلى جانبه، والتي تحدد كل عنصر فرعي في الرأس باستثناء savpe (أو كل برج تصنيف). ويحتاج التشغيل الخالي من الموجّهات أيضاً إلى single_cls=True. يضم مستودع YOLOE الأصلي الوصفات الكاملة للنماذج بمقياس v8.
تُعاد تهيئة التشغيل الخالي من الموجّهات بعد اكتماله في نقطة تحقق تعرض أسماء الفئات من دون موجّه وقت الاستدلال، باستخدام get_vocab وset_vocab:
from ultralytics import YOLOE
# الأوزان التي كتبها التشغيل الخالي من الموجّهات والتشغيل ذي الموجّه النصي الذي بدأ منه. كل
# إعادة تشغيل تنشئ دليلاً جديداً (train-2 وtrain-3 و...)؛ لذا استخدم المسارات التي طبعتها عمليات التشغيل.
model = YOLOE("runs/segment/train-2/weights/best.pt") # في التشغيل الخالي من الموجّهات، يكون الرأس مدمجاً بالفعل
text_model = YOLOE("runs/segment/train/weights/best.pt") # في التشغيل ذي الموجّه النصي، لا يزال الرأس غير مدمج
names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values()) # مفردات الأسماء البالغ عددها 4,585، أو قائمتك الخاصة
vocab = text_model.get_vocab(names)
model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt") # لا تستبدل نقطة التحقق المنشورة مطلقاًتعيد get_vocab الفرع الذي يحدده علم end2end الخاص بالنموذج، وتعيد set_vocab تهيئة ذلك الفرع. أما ملفات YOLOE-26 المنشورة فتحمل مفردات لكل فرع، وهذا ما يتيح لـnms الاختيار بينها؛ ويمكنك إعادة إنتاج ذلك بأخذ المفردات الثانية من نسخة أخرى من نموذج الموجّه النصي. لدى YOLOE-11 وYOLOE-v8 فرع واحد، لذا يستخدمان الاستدعاء أعلاه دون تغيير.
one2one_model = YOLOE("runs/segment/train/weights/best.pt") # تدمج get_vocab الرأس الذي تقرأه؛ لذا حمّل نسخة ثانية
one2one_model.model.end2end = True # اقرأ الفرع الخالي من NMS
model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))الاستشهادات والشكر والتقدير#
إذا أسهم YOLOE في بحثك أو مشروعك، يُرجى الاستشهاد بالورقة البحثية الأصلية التي أعدّها Ao Wang وLihao Liu وHui Chen وZijia Lin وJungong Han وGuiguang Ding من جامعة تسينغهوا:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
لمزيد من القراءة، تتوفر ورقة YOLOE الأصلية على arXiv. ويمكن الوصول إلى الشفرة المصدرية للمشروع والموارد الإضافية عبر مستودع GitHub.
الأسئلة الشائعة#
يضيف Ultralytics YOLOE إمكانيتين لا يتوفران في YOLO-World: الموجّهات المرئية، حيث يحلّ صندوق مثال محل اسم الفئة، ونقاط التحقق الخالية من الموجّهات التي تستجيب باستخدام مفردات مدمجة تضم 4,585 اسماً، من دون أي موجّه. وتتضمن كل تنبؤات نقاط التحقق المنشورة من
*-seg.ptأيضاً قناع تقسيم المثيلات. ومن حيث الدقة، تُظهر ورقة YOLOE الأصلية أن YOLOE-v8s يتفوق على YOLO-Worldv2-S بمقدار 3.5 AP على LVIS، مع ثلث تكلفة التدريب وسرعة استدلال أعلى بمقدار 1.4×. الانتقال بسيط ولا يتطلب سوى تغيير سطر واحد — راجع مقارنة YOLOE.يدعم Ultralytics YOLOE ثلاثة أنماط للتوجيه. الموجّه النصي هو أسماء فئات على هيئة سلاسل نصية مع نقطة تحقق
*-seg.pt، وهو الخيار المعتاد. أما الموجّه المرئي فهو صندوق مثال واحد أو أكثر على صورة مرجعية، ويُستخدم للأهداف التي يصعب وصفها بالكلمات. ويستخدم الاستدلال الخالي من الموجّهات نقطة تحقق منفصلة*-seg-pf.ptتستجيب باستخدام مفردات مدمجة تضم 4,585 اسماً من دون إدخال أي شيء. تشترك الموجّهات النصية والمرئية في نقاط التحقق نفسها؛ أما النقاط الخالية من الموجّهات فهي ملفات مختلفة وترفضset_classes(). راجع اختيار نمط التوجيه للاطلاع على المقارنة الكاملة.ابدأ بـ
yoloe-26s-seg.pt: تتفوق عائلة YOLOE-26 على YOLOE-11 وYOLOE-v8 عند كل مقياس مطابق، ويُعد مقياسsالأصغر الذي يتجاوز 30 mAP على LVIS minival. انتقل إلىmأوlأوxعندما تكون الدقة في الفئات النادرة أهم من زمن الاستجابة — فقارن عمود mAPr في الأداء. لا تنتقل إلىnإلا عند النشر على الأجهزة الطرفية. وحمّل ملف*-seg-pf.ptبالمقياس نفسه بدلاً منه عندما تريد استخدام المفردات المدمجة لا أسماء الفئات الخاصة بك.تشير التسميات مثل
object0وobject1إلى أن التنبؤ ناتج عن موجّه مرئي، يجمع صناديق الأمثلة في فئات مؤقتة مرقّمة بدلاً من الاحتفاظ بأسمائك. وتُستخدم معرّفات الفئات التي تمررها فيvisual_prompts["cls"]لهذا التجميع فقط. يعرضها النموذج بأسماءobject0وobject1وما إلى ذلك، وفق ترتيب المعرّفات التي عيّنتها؛ لذا اربطها بتسمياتك الخاصة في النتيجة. إذا أردت ظهور أسمائك في المخرجات، فاستخدم موجّهاً نصياً.تحسم نقاط التحقق الخالية من المطالبات (
*-seg-pf.pt) الفئات باستخدام مفرداتها المضمّنة، وترفضset_classes()معAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. تُصدر المطالبات البصريةAssertionError: Visual prompts need an unfused YOLOE model.. حمّل نقطة تحقق من*-seg.ptعندما تحتاج إلى قائمة الفئات الخاصة بك. راجع اختيار نمط المطالبة.يدفع الموجّه النصي الأول Ultralytics YOLOE إلى تثبيت ultralytics/CLIP من GitHub باستخدام
pip، وتنزيل مُرمّز نصي TorchScript إلى دليل العمل الحالي — نحو 254 MB لـYOLOE-26؛ راجع التثبيت والمتطلبات لمعرفة المكوّن الدقيق لكل عائلة نماذج. لا تحتاج الموجّهات المرئية ونقاط التحقق الخالية من الموجّهات إلى أي منهما. لتجنب التنزيل على الجهاز المستهدف، عيّن الموجّهات مرة واحدة واحفظها باستخدامsave_prompt_embeddings()، أو صدّر النموذج بعد إعداد الفئات مسبقاً.لا — يدمج YOLOE الفئات المحددة بالموجّه في الأوزان وقت التصدير، لذا يرفض التصدير المحمّل كلاً من
set_classes()وvisual_prompts=. أعد التصدير من نقطة التحقق الأصلية.ptبعد إعداد الموجّهات الجديدة. يعمل الملف المُصدَّر مثل نموذج YOLO قياسي، ويمكن تحميله باستخدامYOLO()وكذلكYOLOE().استخدم YOLOE عندما تحتاج إلى معدل معالجة آني ويمكنك تسمية الفئات، واستخدم SAM 3 عندما تكون جودة التقسيم لمفهوم ما أهم من السرعة. يقبل كلاهما أمثلة مرئية؛ لكن YOLOE وحده يتضمن نمطاً خالياً من الموجّهات. تجد المقارنة الكاملة في مقارنة YOLOE.


التعليقات60
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(تم التعديل)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(تم التعديل)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.