Ultralytics YOLOv5 🚀 على مثيل AWS للتعلم العميق: دليلك الشامل#
قد يبدو إعداد بيئة التعلم العميق عالية الأداء أمرًا شاقًا، خصوصًا للمبتدئين. لكن لا تقلق! 🛠️ يقدم هذا الدليل شرحًا تفصيليًا خطوة بخطوة لتشغيل Ultralytics YOLOv5 على مثيل AWS للتعلم العميق. وبالاستفادة من إمكانات Amazon Web Services (AWS)، يمكن حتى لمن هم جدد على التعلم الآلي (ML) البدء بسرعة وبتكلفة معقولة. تجعل قابلية التوسع في منصة AWS المنصة مثالية للتجارب والنشر الإنتاجي على حد سواء.
تشمل خيارات البدء السريع الأخرى مع YOLOv5 دفتر Google Colab  ، وبيئات Kaggle
 ، وآلة GCP الافتراضية للتعلم العميق، وصورة Docker الجاهزة لدينا والمتاحة على Docker Hub

الخطوة 1: تسجيل الدخول إلى وحدة تحكم AWS#
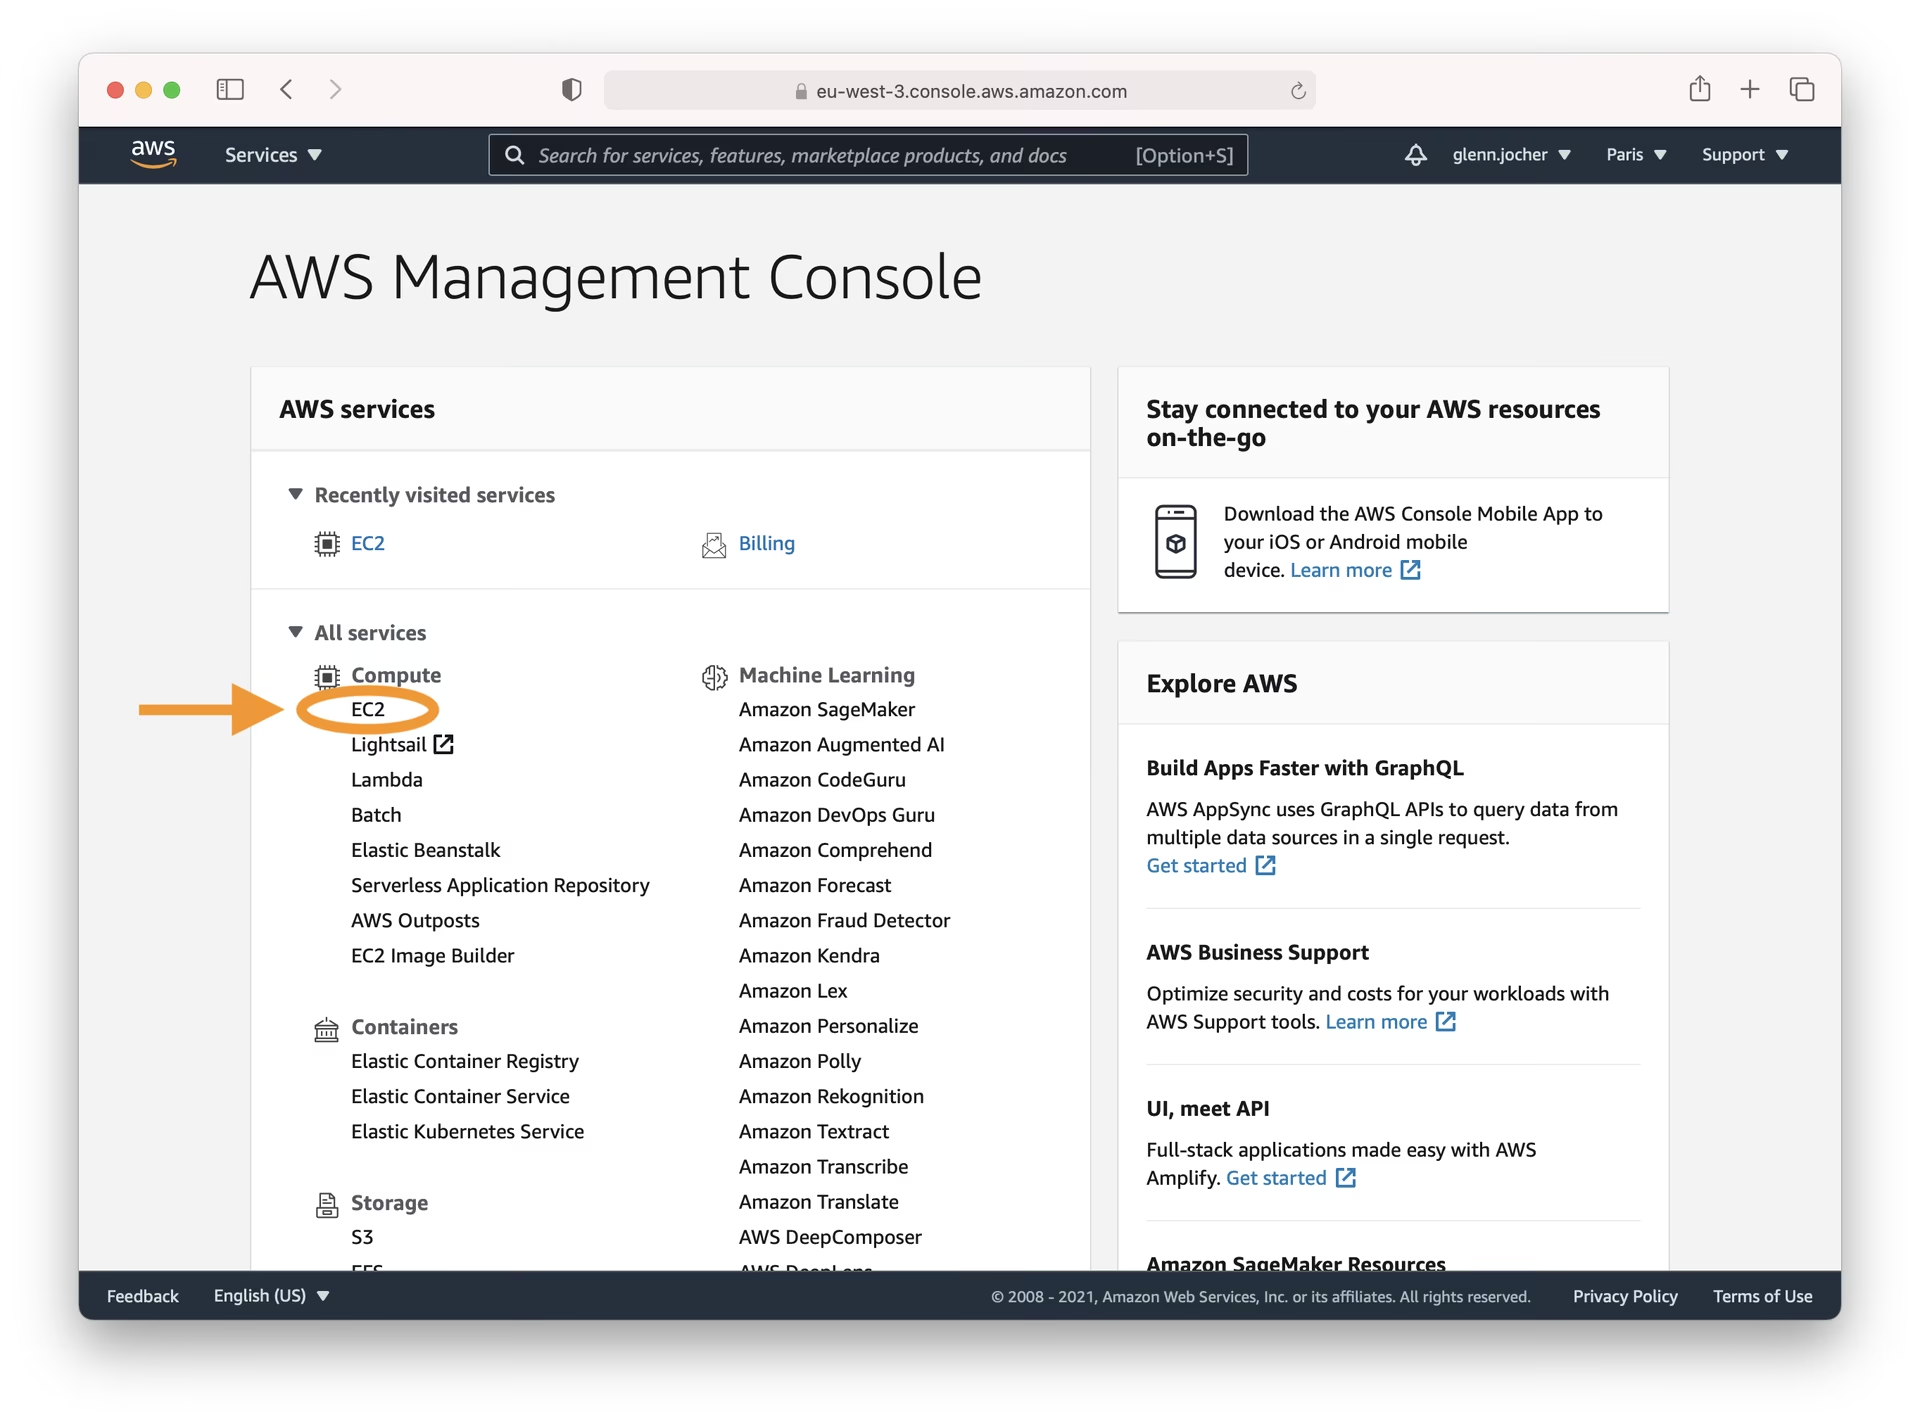
ابدأ بإنشاء حساب أو تسجيل الدخول إلى وحدة تحكم إدارة AWS. بعد تسجيل الدخول، انتقل إلى لوحة خدمة EC2، حيث يمكنك إدارة خوادمك الافتراضية (المثيلات).
الخطوة 2: تشغيل المثيل#
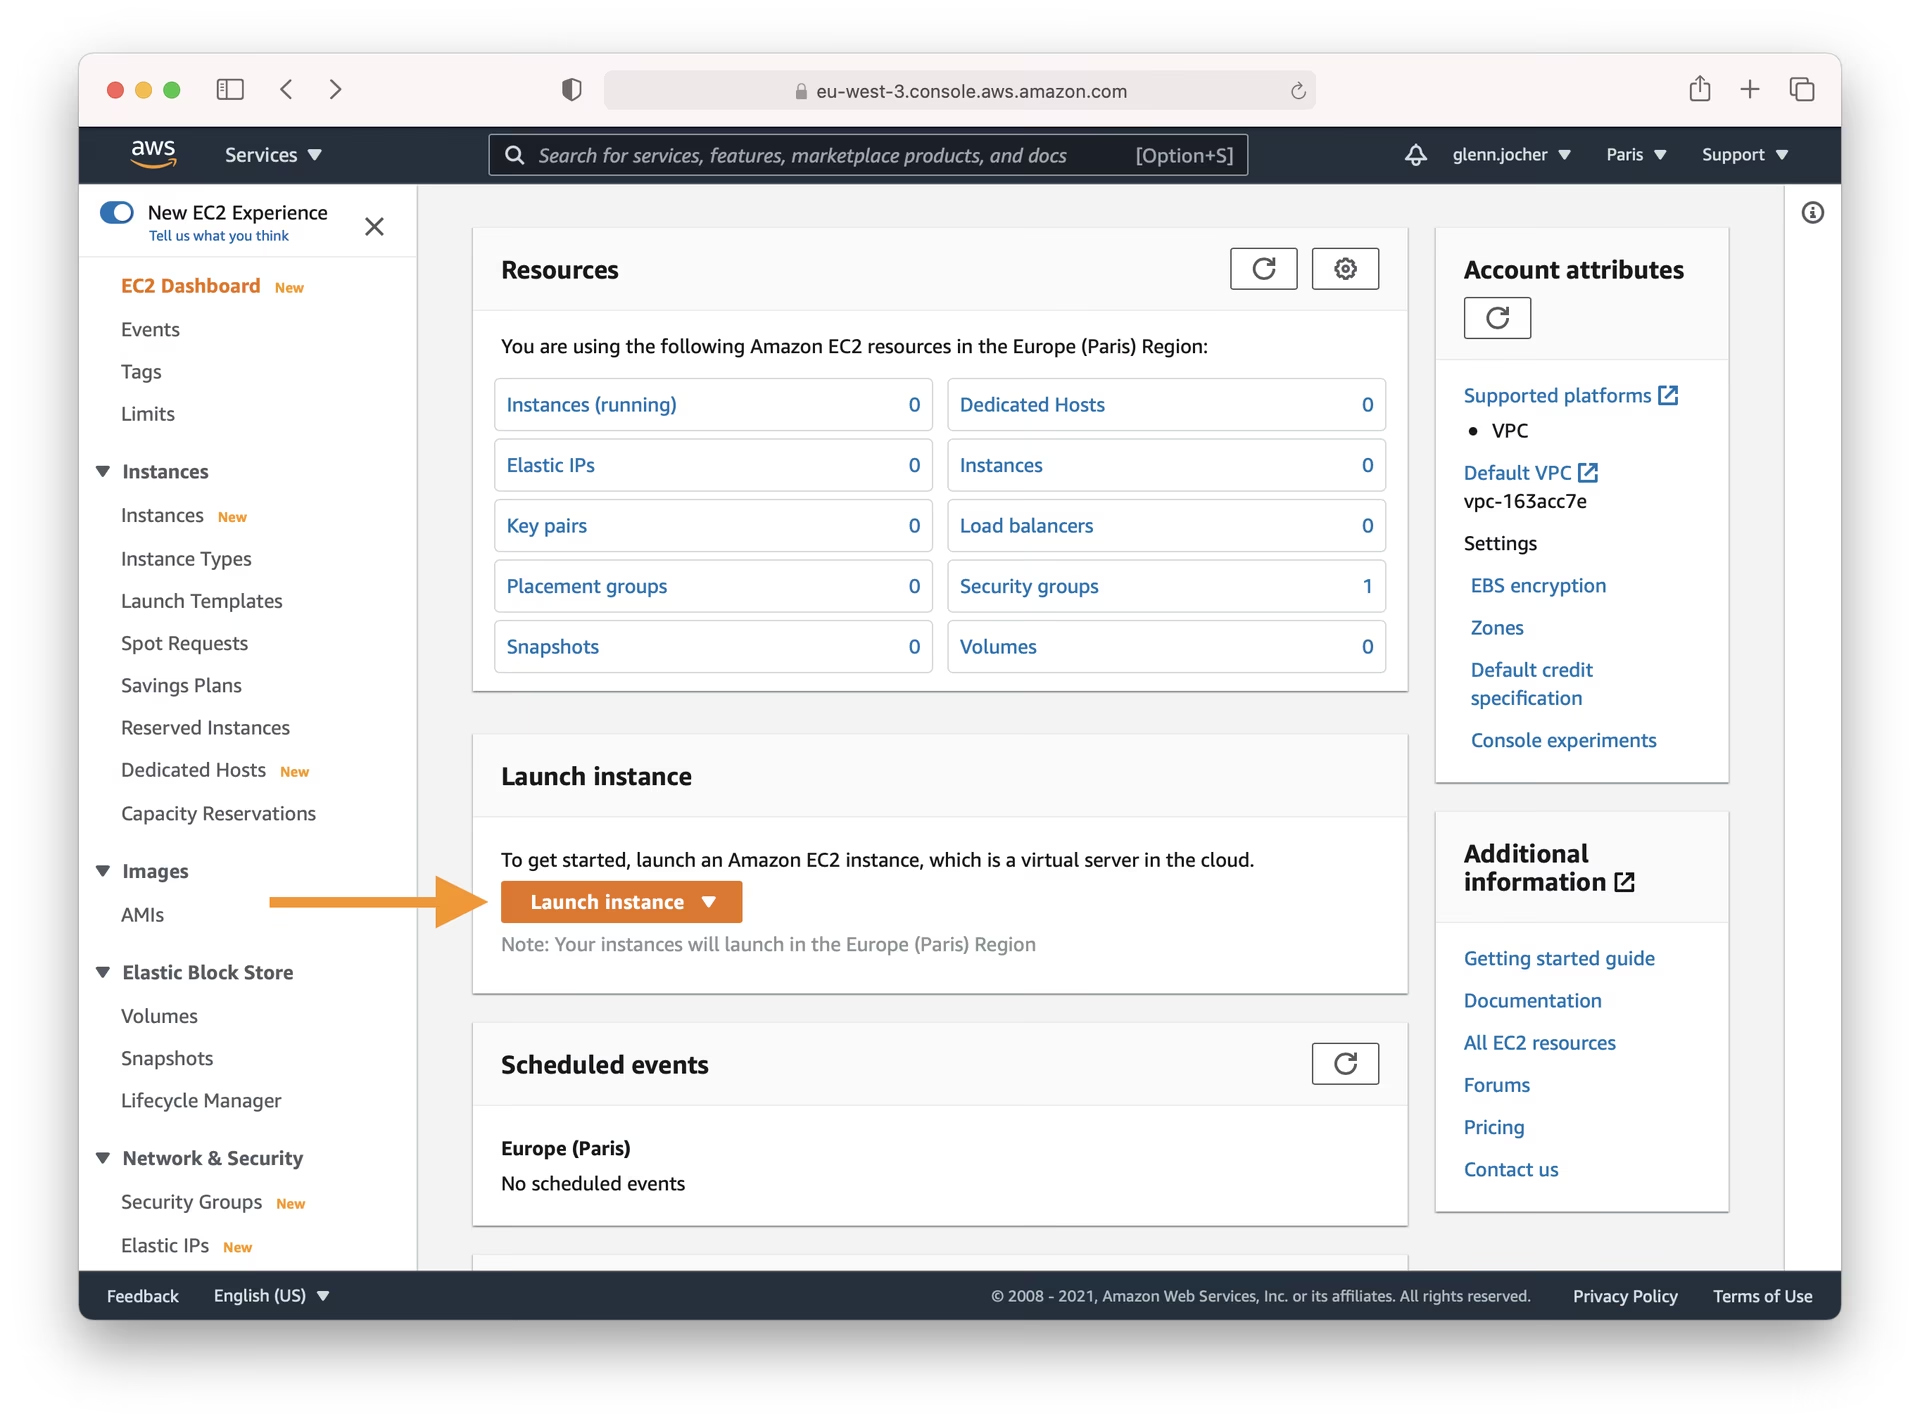
من لوحة تحكم EC2، انقر زر Launch Instance. يؤدي ذلك إلى بدء عملية إنشاء خادم افتراضي جديد مصمم لتلبية احتياجاتك.
اختيار صورة Amazon Machine Image (AMI) المناسبة#
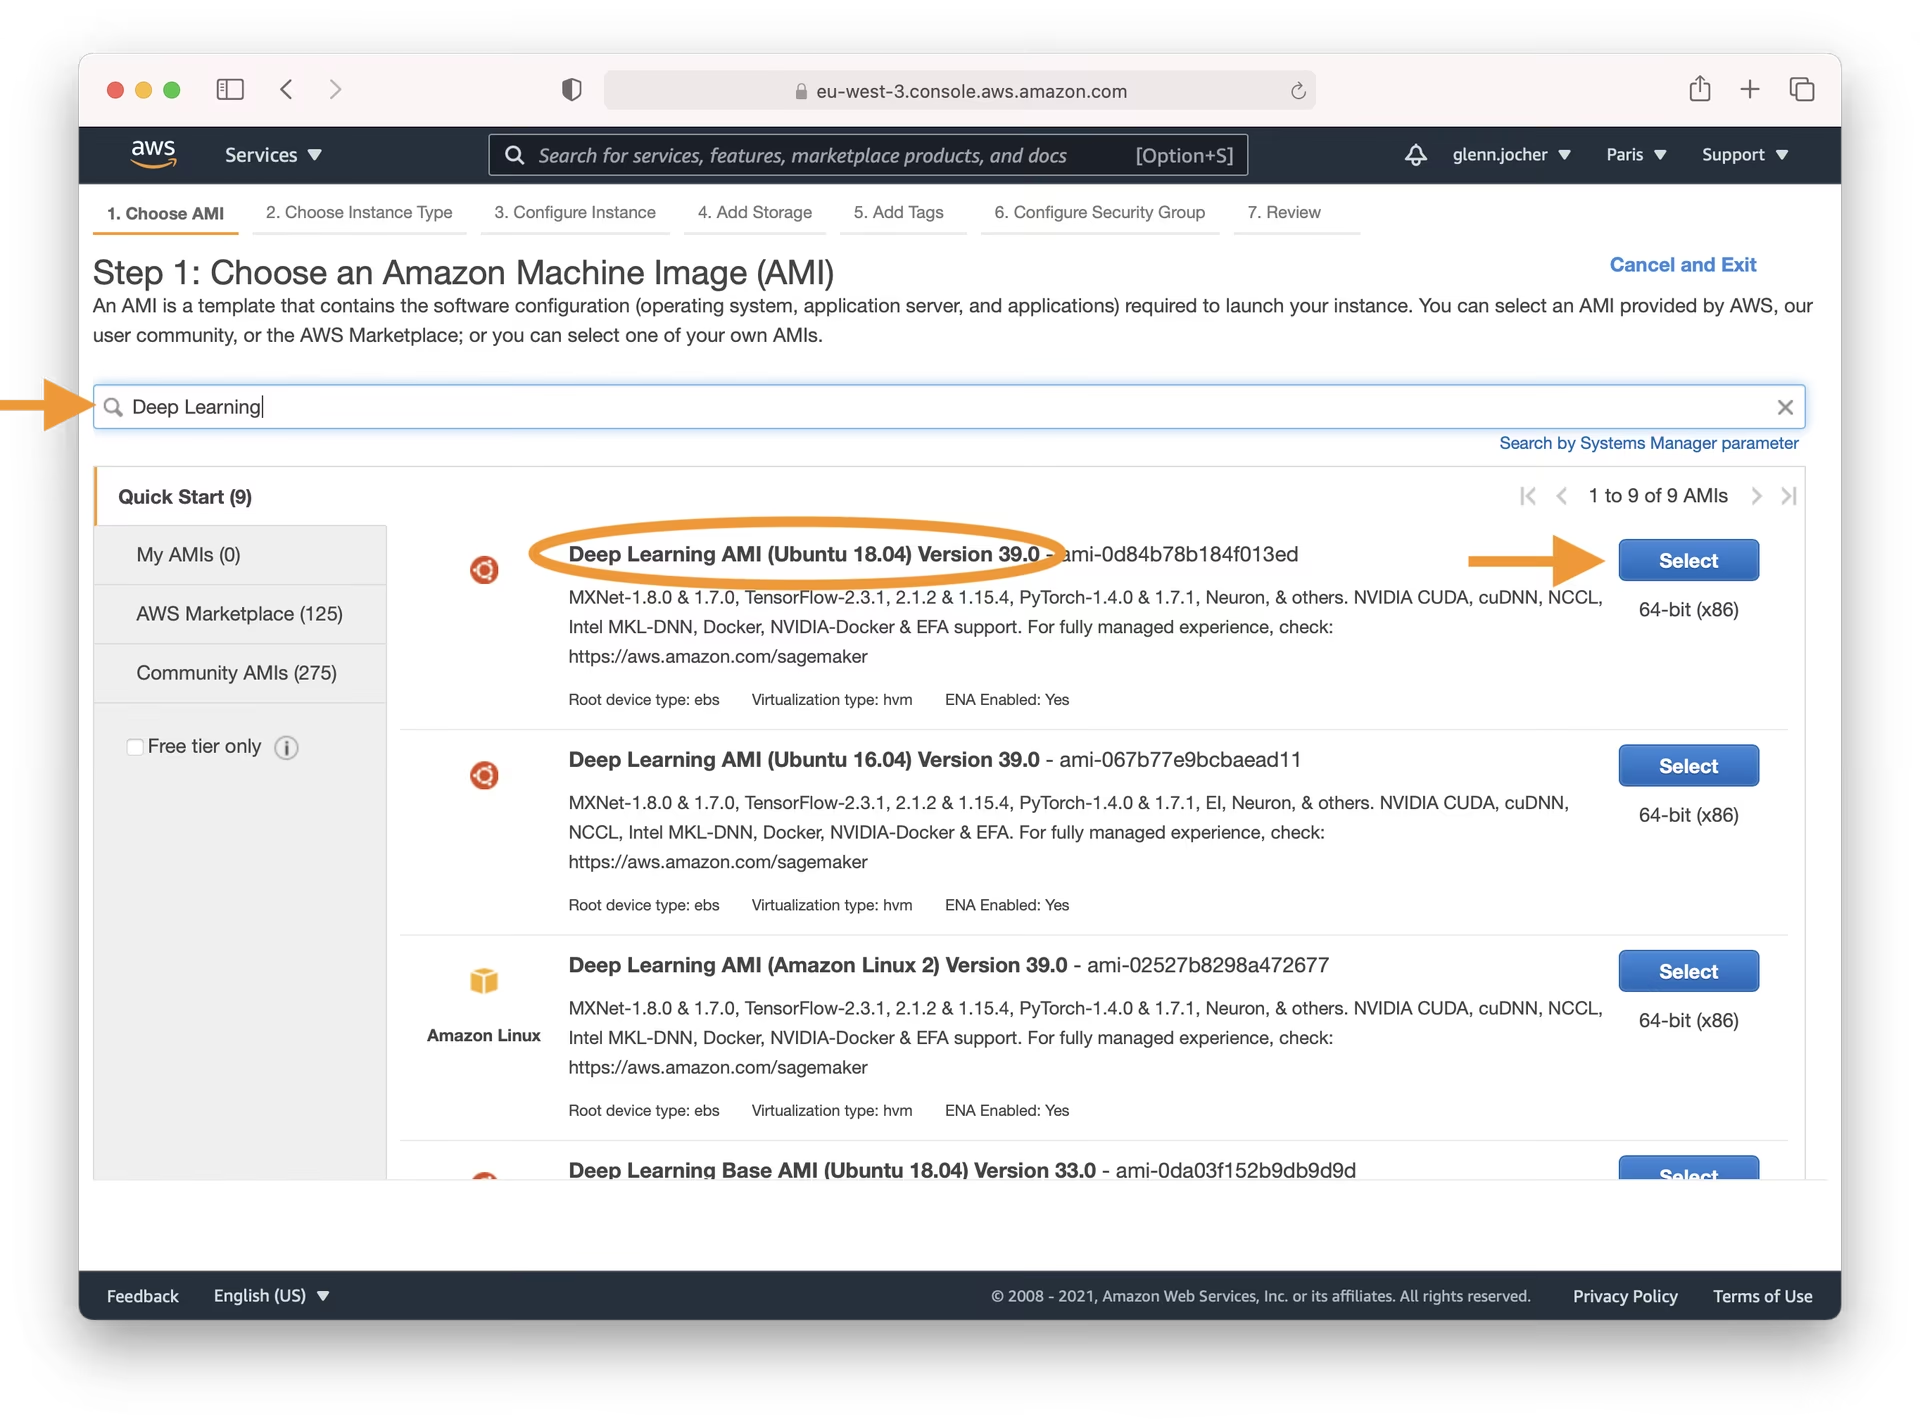
يُعد اختيار AMI المناسبة أمرًا بالغ الأهمية، إذ تحدد نظام التشغيل والبرامج المثبتة مسبقًا للمثيل. اكتب 'التعلم العميق' في شريط البحث، واختر أحدث AMI للتعلم العميق المبنية على Ubuntu (ما لم تكن لديك متطلبات محددة لنظام تشغيل مختلف). تأتي AMI الخاصة بالتعلم العميق من Amazon معدة مسبقًا بأطر عمل التعلم العميق الشائعة (مثل PyTorch، الذي يستخدمه YOLOv5) وبرامج تشغيل GPU اللازمة، ما يسهّل عملية الإعداد بدرجة كبيرة.
اختيار نوع المثيل#
يوصى بشدة باختيار نوع مثيل مُسرّع بوحدة GPU للمهام كثيفة المتطلبات، مثل تدريب نماذج التعلم العميق. يمكن لوحدات GPU تقليل الوقت اللازم لتدريب النماذج بدرجة كبيرة مقارنة بوحدات CPU. عند اختيار حجم المثيل، تأكد من أن سعة ذاكرته (RAM) كافية لنموذجك ومجموعة بياناتك.
ملاحظة: يُعد حجم النموذج ومجموعة البيانات عاملين حاسمين. إذا تطلبت مهمة التعلم الآلي ذاكرة أكبر مما يوفره المثيل المحدد، فستحتاج إلى اختيار نوع مثيل أكبر لتجنب مشكلات الأداء أو الأخطاء.
استكشف أنواع مثيلات GPU المتاحة في صفحة أنواع مثيلات EC2، وتحديدًا ضمن فئة الحوسبة المسرّعة.
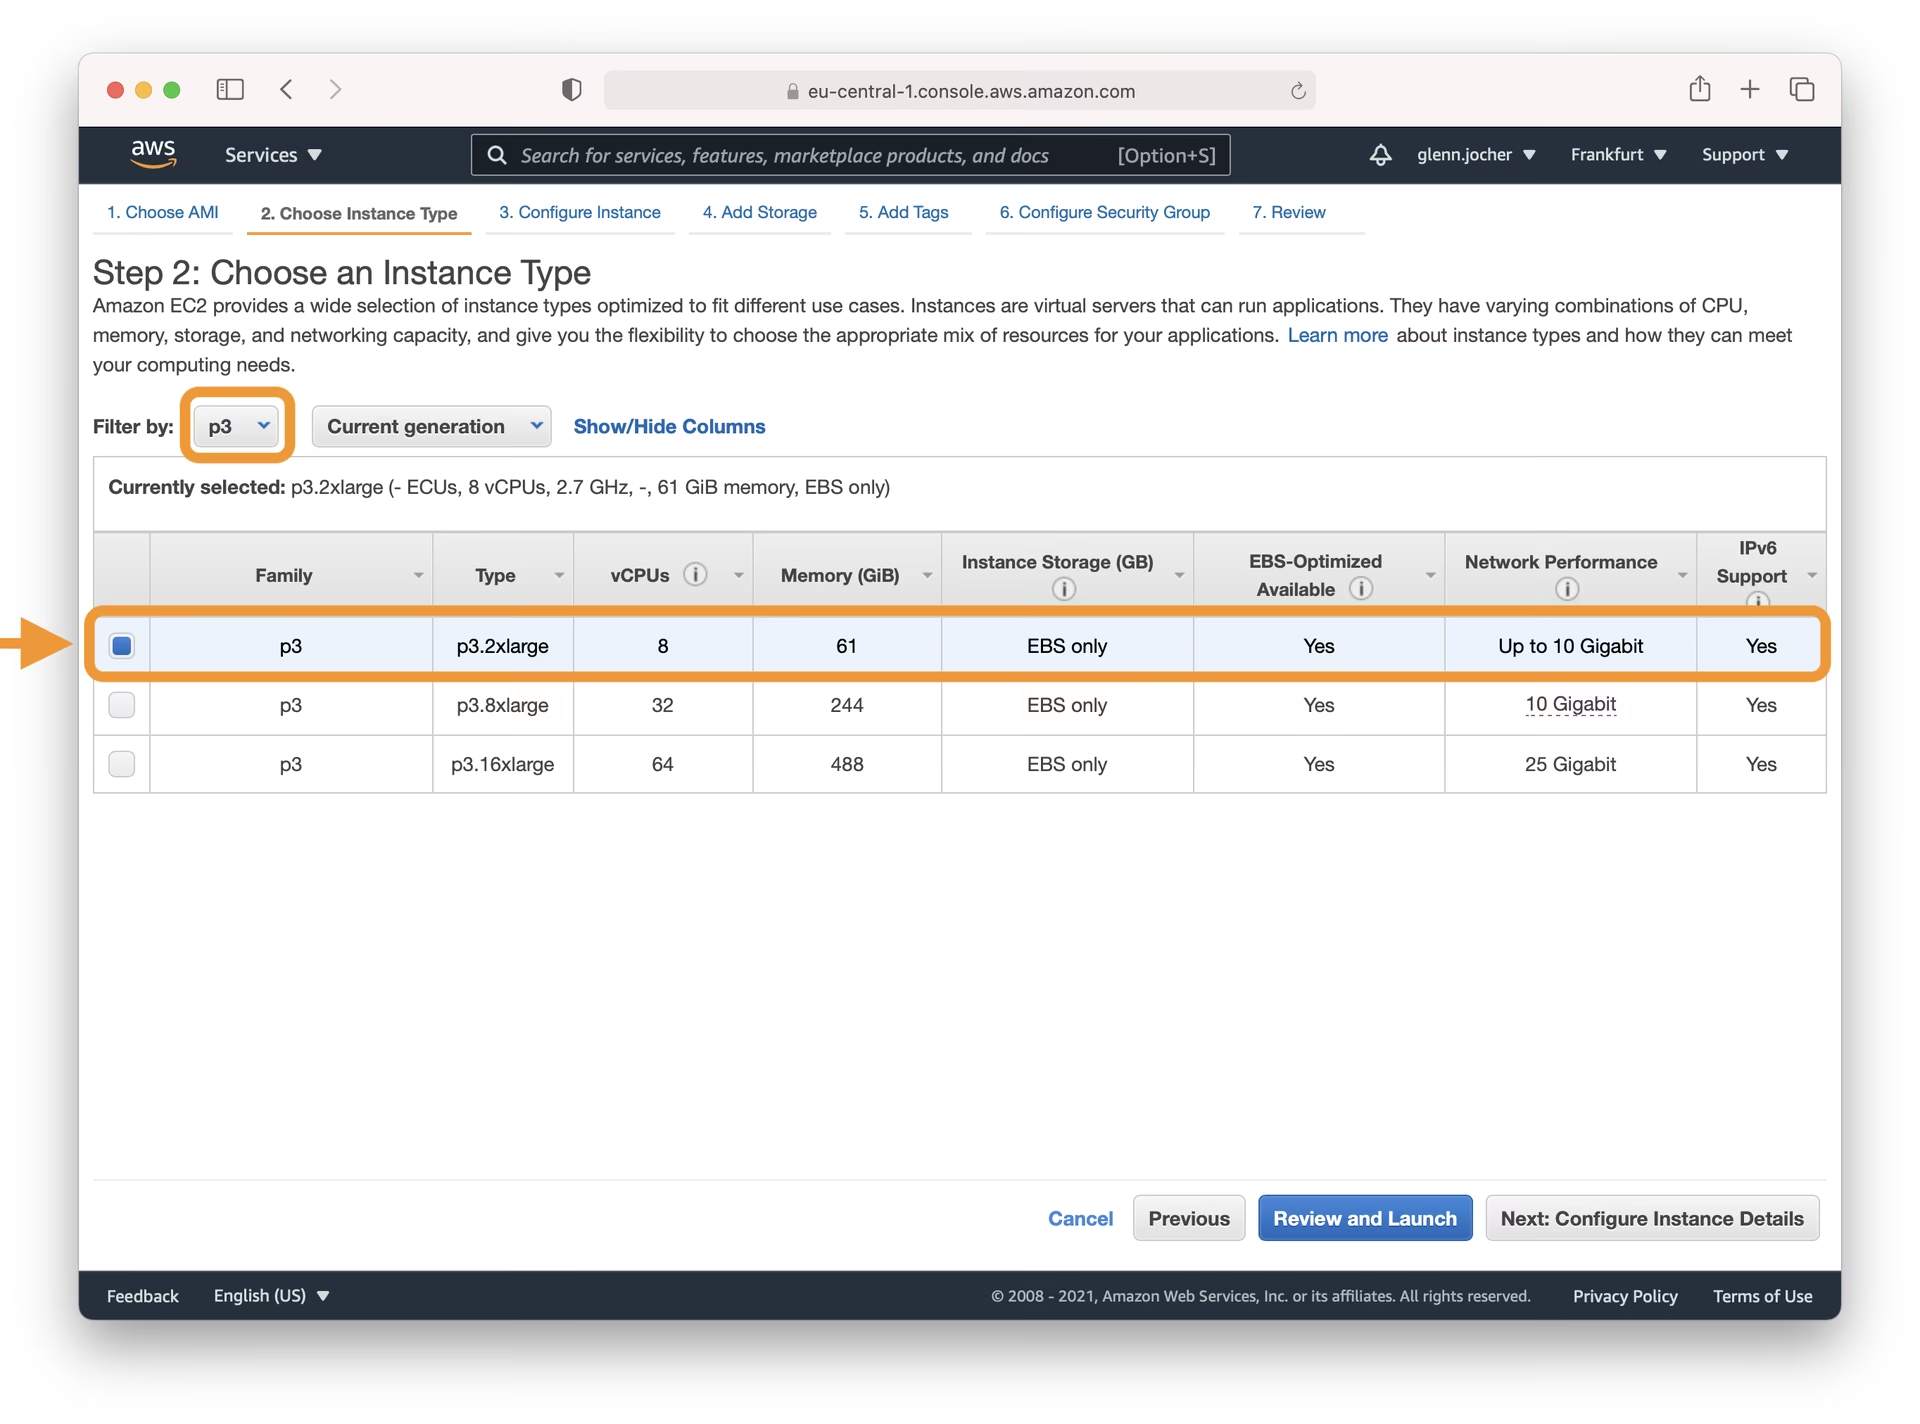
للاطلاع على معلومات مفصلة حول مراقبة استخدام GPU وتحسينه، راجع دليل AWS بشأن مراقبة GPU وتحسينها. قارن التكاليف باستخدام تسعير الطلب الفوري، واستكشف فرص التوفير عبر تسعير المثيلات الفورية.
تهيئة المثيل#
فكّر في استخدام مثيلات Amazon EC2 Spot لتقليل التكاليف. تتيح لك مثيلات Spot استخدام سعة EC2 غير المستغلة، غالبًا بخصم كبير مقارنةً بأسعار الطلب الفوري. وللتدريب الذي يجب أن يستمر بعد انقطاع، اختر طلبًا مستمرًا واضبط سلوك الانقطاع على الإيقاف بدلًا من الإنهاء، حتى يُحتفظ بوحدة تخزين EBS ومخرجات التدريب، ويُعاد تشغيل المثيل عند عودة السعة.
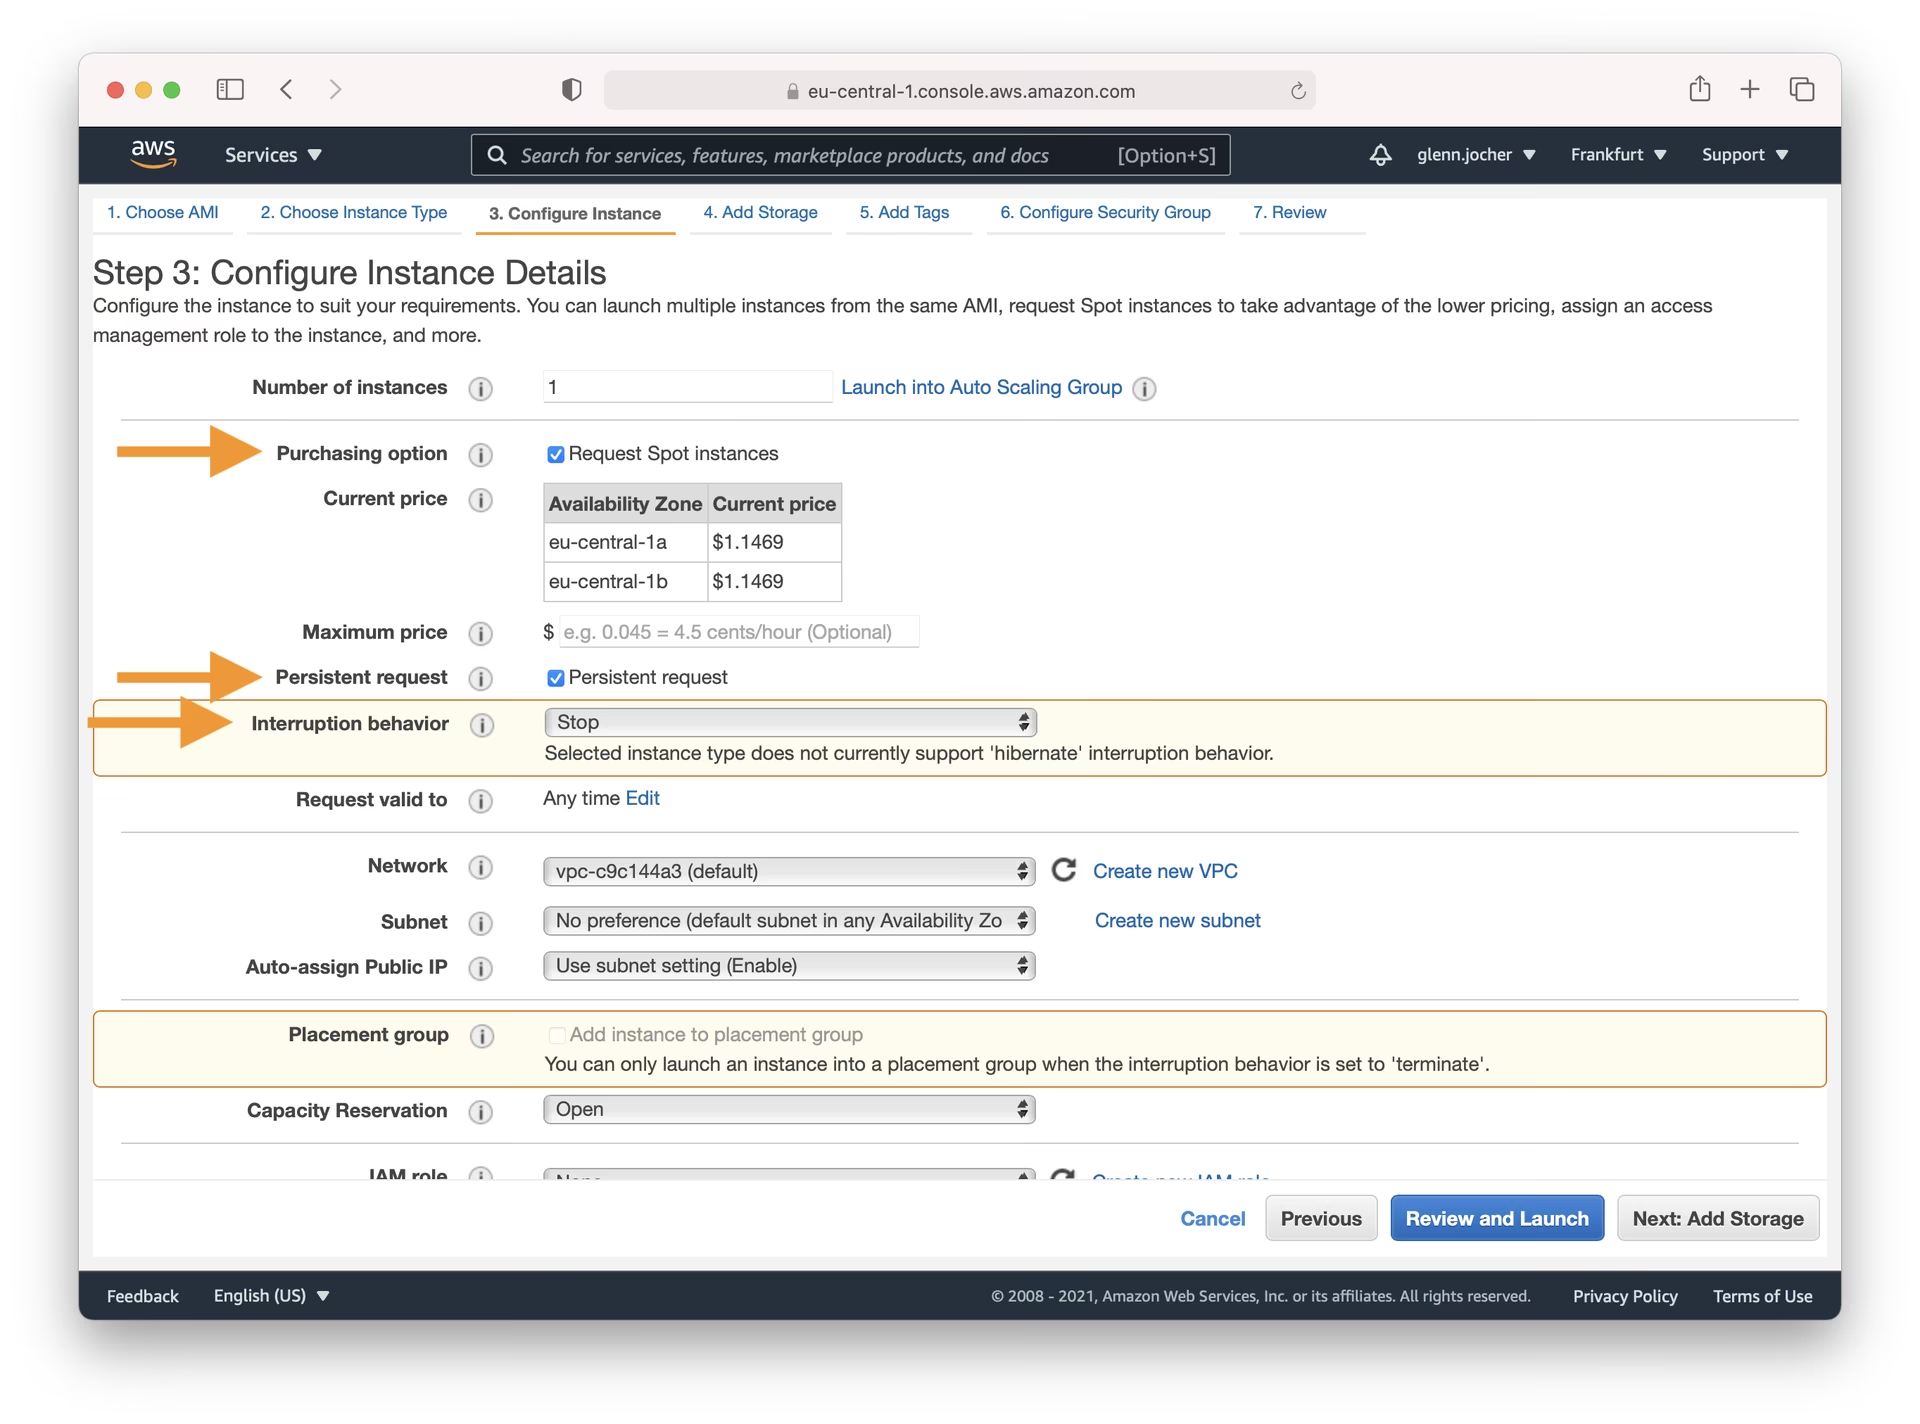
تابع إعدادات التشغيل المتبقية لتهيئة التخزين وإضافة العلامات وإعداد مجموعات الأمان (تأكد من فتح منفذ SSH رقم 22 من عنوان IP الخاص بك)، ثم راجع إعداداتك قبل النقر على Launch. وستحتاج أيضًا إلى إنشاء زوج مفاتيح أو اختيار زوج موجود للوصول الآمن عبر SSH.
الخطوة 3: الاتصال بالمثيل#
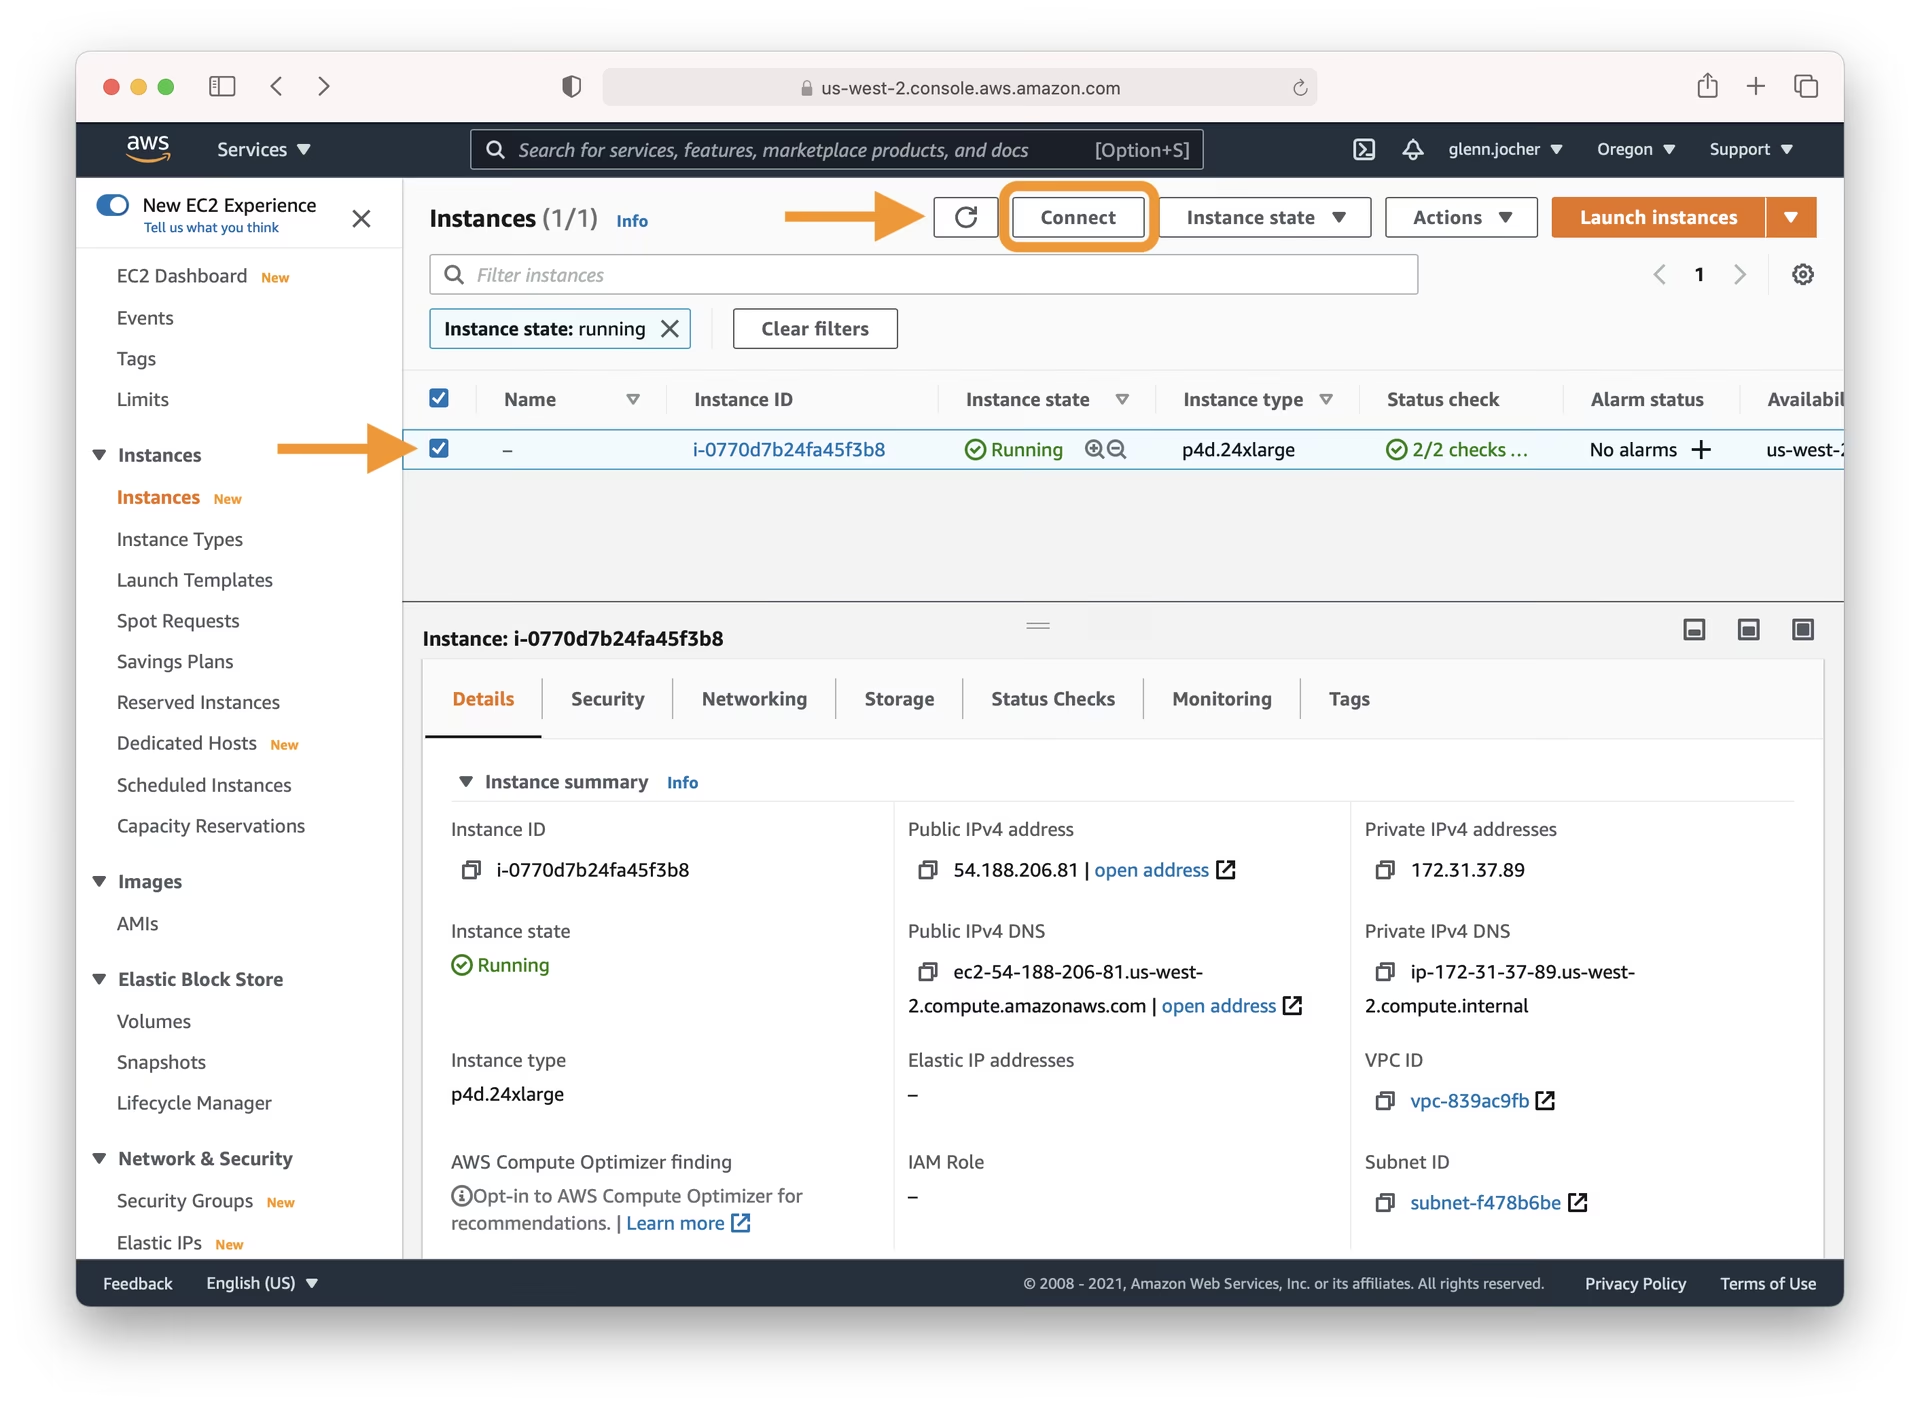
بعد أن تظهر حالة المثيل على أنها «قيد التشغيل»، حدده من لوحة تحكم EC2. انقر زر Connect لعرض خيارات الاتصال. استخدم مثال أمر SSH المقدم في الطرفية المحلية (مثل Terminal على macOS/Linux أو PuTTY/WSL على Windows) لإنشاء اتصال آمن. ستحتاج إلى ملف المفتاح الخاص (.pem) الذي أنشأته أو حددته أثناء التشغيل.
الخطوة 4: تشغيل Ultralytics YOLOv5#
بعد الاتصال عبر SSH، يمكنك إعداد YOLOv5 وتشغيله. أولًا، استنسخ مستودع YOLOv5 الرسمي من GitHub وانتقل إلى الدليل. ثم ثبّت التبعيات المطلوبة باستخدام pip. يُوصى باستخدام بيئة Python 3.8 أو أحدث. ستُنزّل النماذج ومجموعات البيانات اللازمة تلقائيًا من أحدث إصدار من YOLOv5 عند تشغيل أوامر مثل التدريب أو الكشف.
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install required packages
pip install -r requirements.txt
بعد تجهيز البيئة، يمكنك البدء باستخدام YOLOv5 لتنفيذ مهام متنوعة:
# Train a YOLOv5 model on a custom dataset (e.g., coco128.yaml)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the performance (Precision, Recall, mAP) of a trained model (e.g., yolov5s.pt)
python val.py --weights yolov5s.pt --data coco128.yaml --img 640

# Run inference (object detection) on images or videos using a trained model
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos/ --img 640

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite --img 640
راجع البرنامجين التعليميين تدريب بيانات مخصصة وتصدير النموذج للاطلاع على إرشادات مفصلة.
إضافات اختيارية: زيادة ذاكرة التبديل#
إذا كنت تعمل على مجموعات بيانات كبيرة جدًا أو واجهت قيودًا على الذاكرة أثناء التدريب، فقد تساعد زيادة ذاكرة التبديل في المثيل أحيانًا. تتيح مساحة التبديل للنظام استخدام مساحة القرص بوصفها ذاكرة RAM افتراضية.
# Allocate a 64GB swap file (adjust size as needed)
sudo fallocate -l 64G /swapfile

# Set correct permissions
sudo chmod 600 /swapfile

# Set up the file as a Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap memory is active
free -h
تهانينا! 🎉 لقد أعددت بنجاح مثيل AWS للتعلم العميق وثبّت Ultralytics YOLOv5، وأصبحت جاهزًا لتنفيذ مهام الكشف عن الكائنات. سواء كنت تجرب النماذج المدربة مسبقًا أو تدرّب على بياناتك، يوفر هذا الإعداد القوي أساسًا قابلًا للتوسع لمشاريع الرؤية الحاسوبية الخاصة بك. وإذا واجهت أي مشكلات، فاستعن بـوثائق AWS الشاملة وموارد مجتمع Ultralytics المفيدة مثل الأسئلة الشائعة. نتمنى لك كشفًا موفقًا!
الأسئلة الشائعة#
اختر أحدث AMI للتعلم العميق من AWS المبنية على Ubuntu. فهي تتضمن مسبقًا برامج تشغيل NVIDIA وCUDA وPyTorch، لذا لا يتبقى سوى استنساخ المستودع وتثبيت
requirements.txt.يصلح أي مثيل GPU من فئة الحوسبة المسرّعة، مثل المثيلات
g4dnأوg5أوp3. اختر سعة ذاكرة GPU تكفي لحجم الدفعة وحجم الصورة، واستخدم--batch-size -1ليختار YOLOv5 أكبر دفعة ممكنة.استخدم
scpمع مفتاح.pemلنقل الملفات الصغيرة، أو خزّن البيانات مؤقتًا في Amazon S3 وانسخها باستخدامaws s3 sync. تُحفظ مخرجات التدريب فيruns/train/، والأوزان فيruns/train/exp/weights/.استخدم طلب Spot مستمرًا واضبط سلوك الانقطاع على الإيقاف للاحتفاظ بوحدة تخزين EBS، ثم استأنف التشغيل من آخر نقطة تحقق باستخدام
python train.py --resumeعند إعادة تشغيل المثيل. انسخlast.ptوbest.ptإلى S3 دوريًا إذا لم يكن فقدان التقدم خيارًا متاحًا.