إتقان نشر YOLOv5 على آلة Google Cloud Platform (GCP) الافتراضية للتعلم العميق#
قد تكون خوض تجربة الذكاء الاصطناعي (AI) والتعلم الآلي (ML) مثيرة، خصوصًا عند الاستفادة من قوة منصة الحوسبة السحابية ومرونتها. تقدم Google Cloud Platform (GCP) أدوات قوية مصممة لتلبية احتياجات المهتمين بالتعلم الآلي والمحترفين على حد سواء. ومن هذه الأدوات الآلة الافتراضية للتعلم العميق، المُهيأة مسبقًا لمهام علوم البيانات والتعلم الآلي. في هذا البرنامج التعليمي، سنستعرض عملية إعداد Ultralytics YOLOv5 على آلة GCP الافتراضية للتعلم العميق. سواء كنت تخطو خطواتك الأولى في التعلم الآلي أو كنت ممارسًا خبيرًا، يقدم هذا الدليل مسارًا واضحًا لتطبيق نماذج الكشف عن الكائنات المعتمدة على YOLOv5.
🆓 بالإضافة إلى ذلك، إذا كنت مستخدمًا جديدًا لـ GCP، فأنت محظوظ إذ يمكنك الاستفادة من عرض رصيد مجاني بقيمة 300 دولار لبدء مشاريعك.
إلى جانب GCP، استكشف خيارات أخرى يسهل الوصول إليها للبدء السريع مع YOLOv5، مثل دفتر Google Colab  لتجربة عبر المتصفح، أو قابلية التوسع التي توفرها Amazon AWS. ويمكن أيضًا لعشاق الحاويات استخدام صورة Docker الرسمية المتاحة على Docker Hub

الخطوة 1: إنشاء الآلة الافتراضية للتعلم العميق وتهيئتها#
لنبدأ بإنشاء آلة افتراضية محسّنة لـالتعلم العميق:
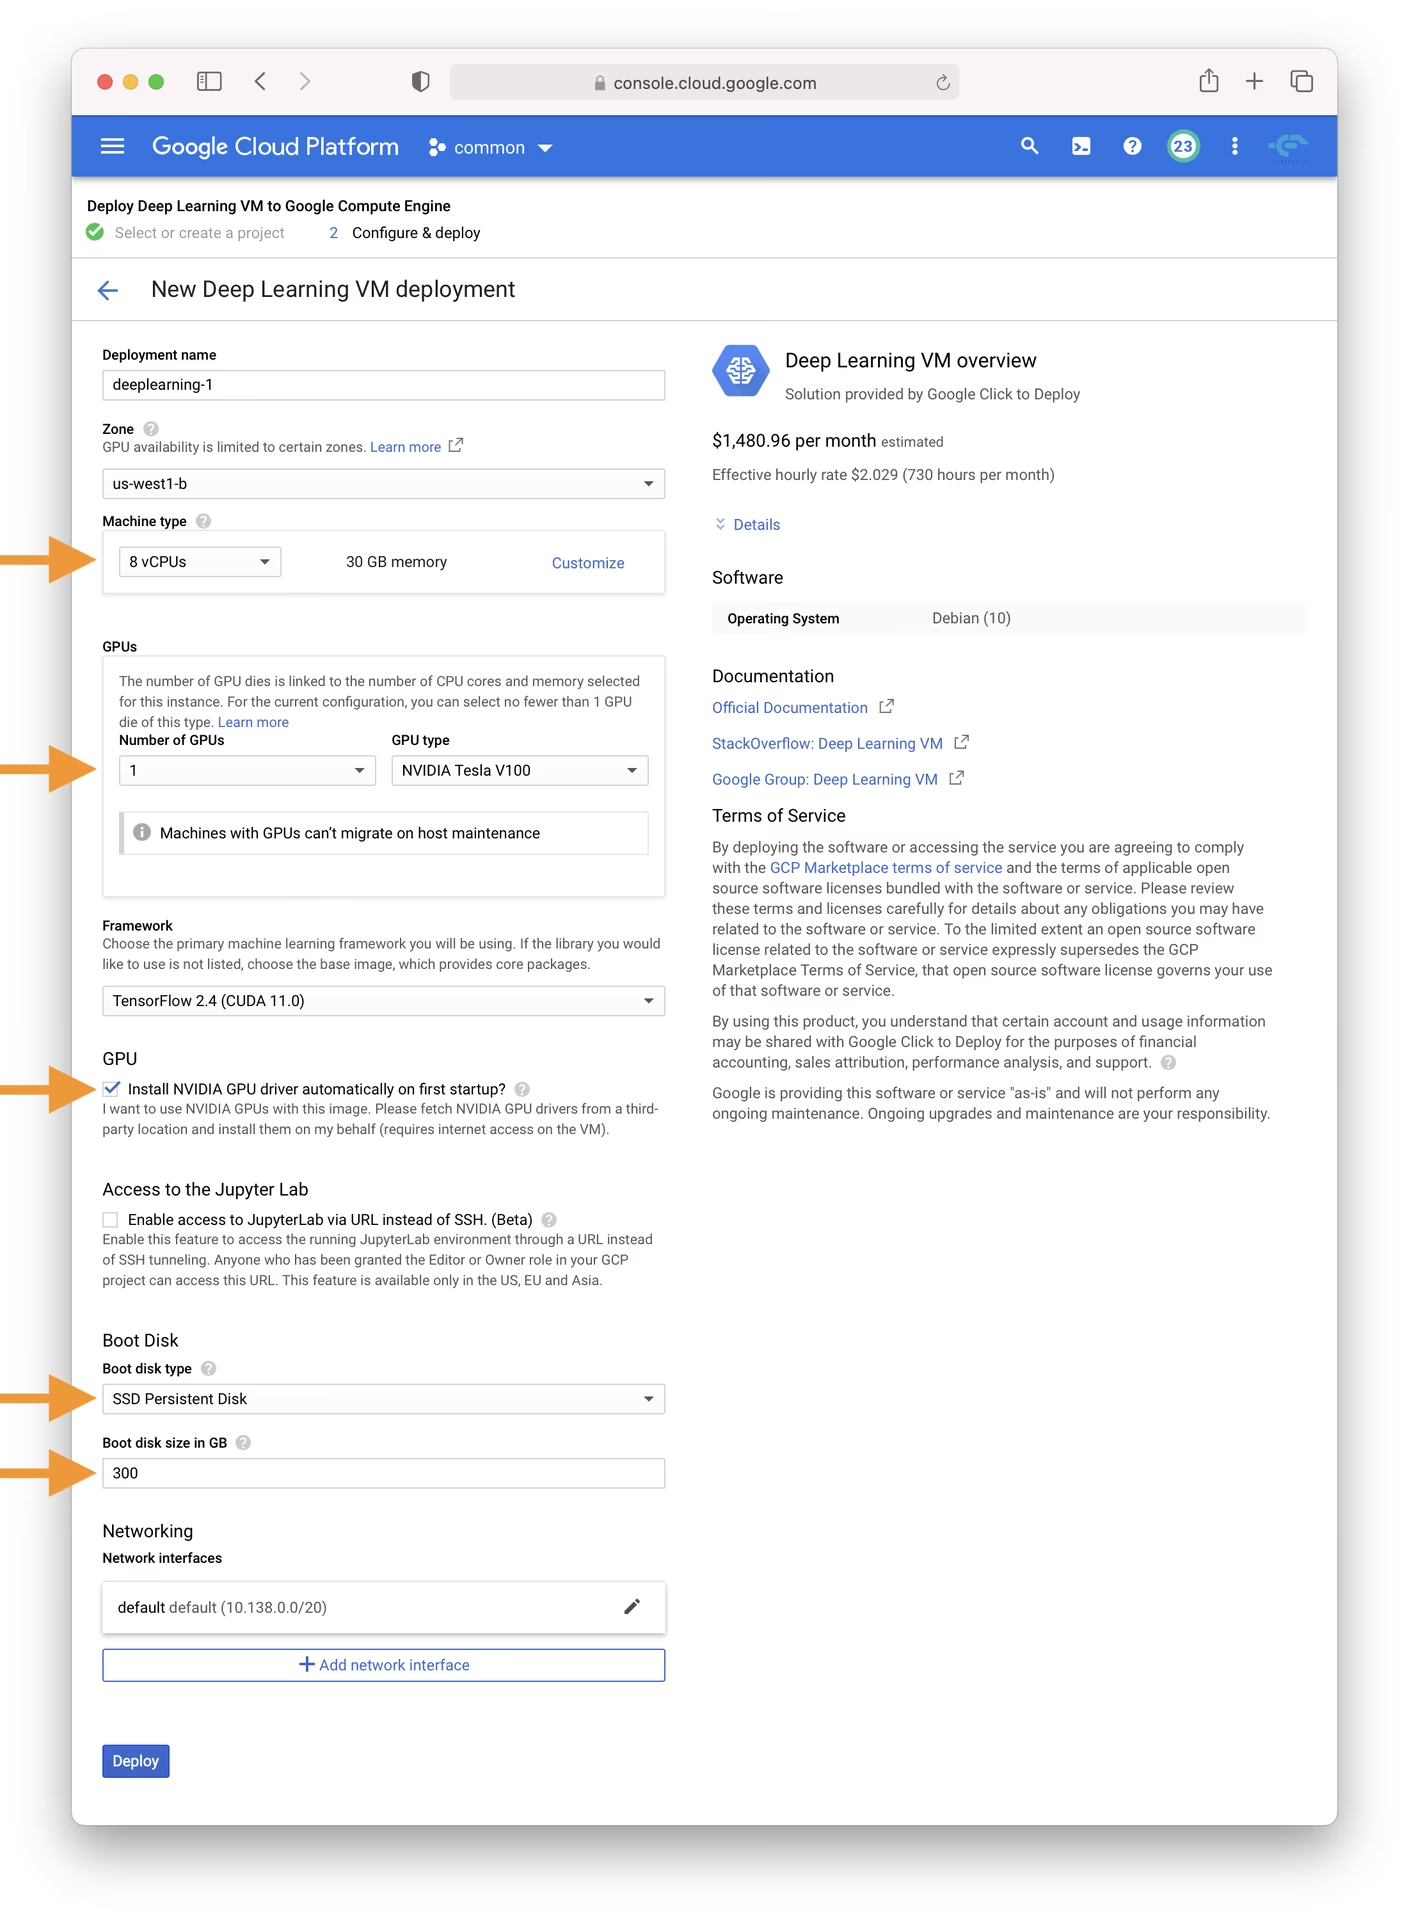
- انتقل إلى سوق GCP واختر Deep Learning VM.
- اختر مثيلًا من نوع n1-standard-8؛ فهو يوفر توازنًا بين 8 وحدات vCPU وذاكرة بسعة 30 GB، ما يجعله مناسبًا لكثير من مهام التعلم الآلي.
- اختر وحدة GPU. يعتمد الاختيار على عبء العمل؛ حتى وحدة GPU أساسية من طراز T4 ستسرّع تدريب النماذج بدرجة كبيرة.
- حدد مربع الاختيار «تثبيت برنامج تشغيل NVIDIA GPU تلقائيًا عند بدء التشغيل لأول مرة؟» لضمان إعداد سلس.
- خصص قرص Persistent Disk من نوع SSD بسعة 300 GB لتجنب اختناقات الإدخال والإخراج.
- انقر على «Deploy» ودع GCP يجهز آلة التعلم العميق الافتراضية المخصصة.
تأتي هذه الآلة الافتراضية محمّلة مسبقًا بالأدوات وأطر العمل الأساسية، بما في ذلك توزيعة Python من Anaconda، التي تجمع ملائمًا كثيرًا من التبعيات اللازمة لـ YOLOv5.
الخطوة 2: تجهيز الآلة الافتراضية لـ YOLOv5#
بعد إعداد البيئة، لنثبّت YOLOv5 ونجهزه للاستخدام:
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install dependencies
pip install -r requirements.txt
تضمن عملية الإعداد هذه توفر بيئة Python بالإصدار 3.8.0 أو أحدث وPyTorch بالإصدار 1.8 أو أحدث. تنزّل نصوصنا البرمجية تلقائيًا النماذج ومجموعات البيانات من أحدث إصدار من YOLOv5، ما يسهّل بدء تدريب النموذج.
الخطوة 3: تدريب نماذج YOLOv5 ونشرها#
بعد اكتمال الإعداد، ستصبح جاهزًا لتدريب YOLOv5 والتحقق من صحته وإجراء التنبؤات به وتصديره على آلة GCP الافتراضية:
# Train a YOLOv5 model on your dataset (e.g., yolov5s)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the trained model to check Precision, Recall, and mAP
python val.py --weights yolov5s.pt --data coco128.yaml

# Run inference using the trained model on images or videos
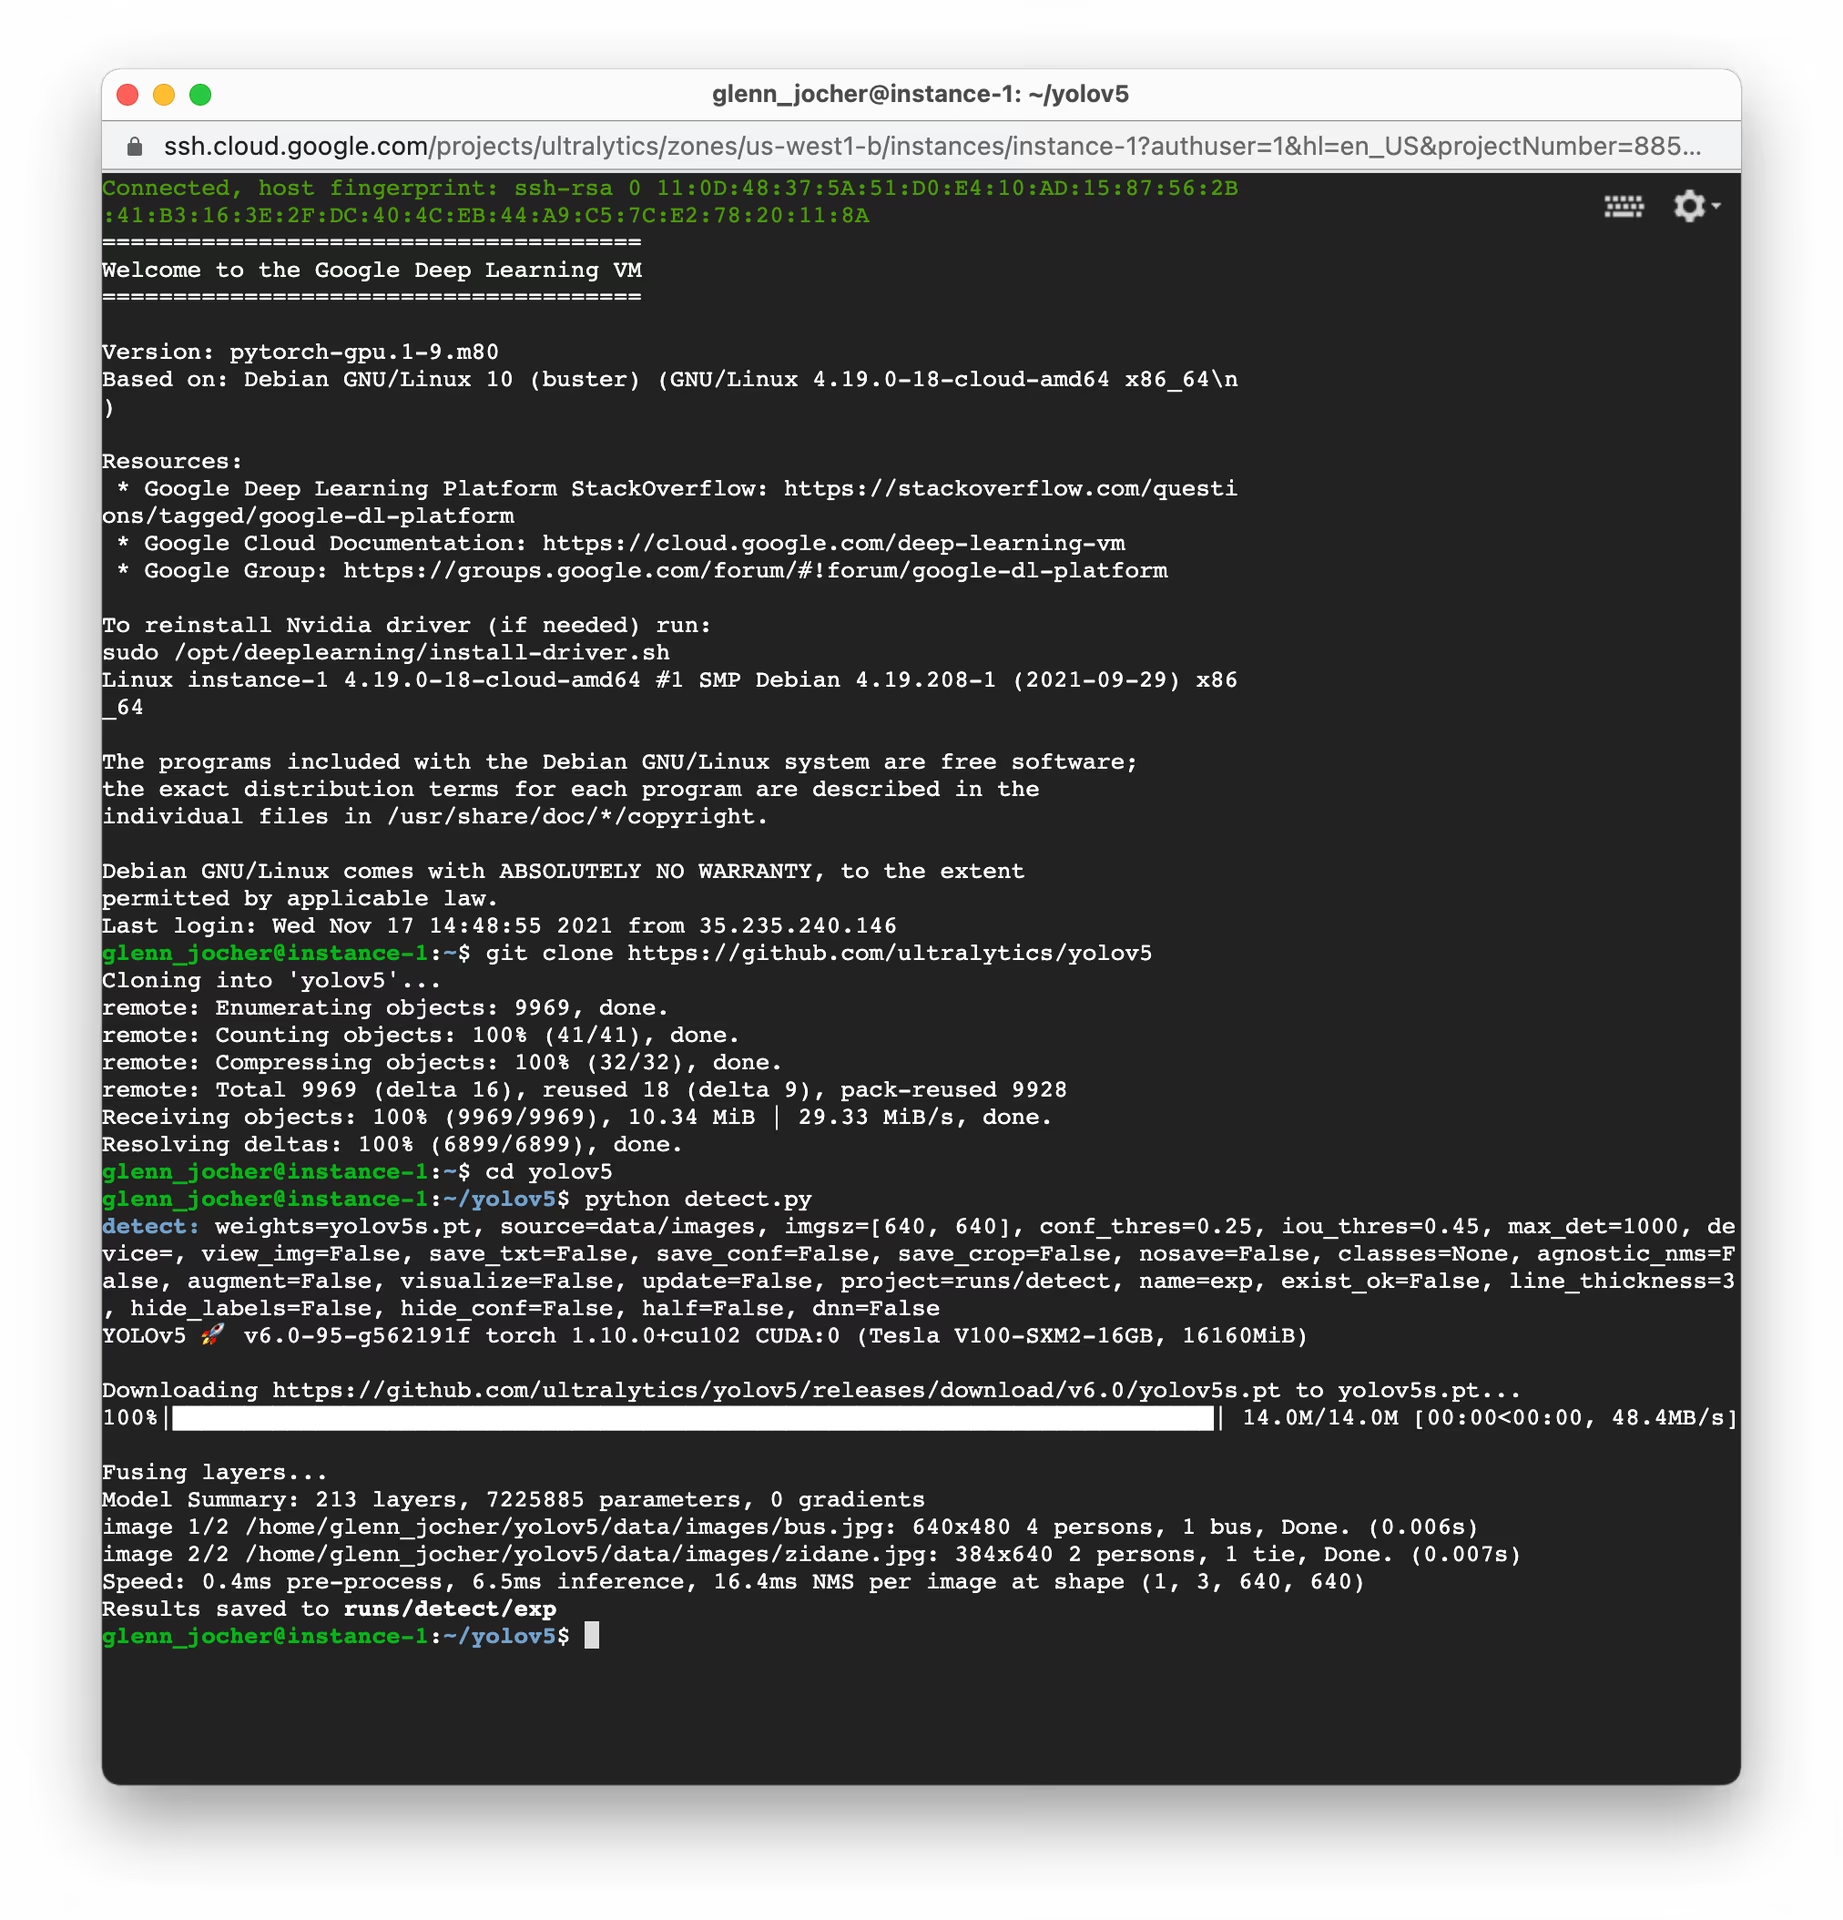
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite
باستخدام بضعة أوامر فقط، يتيح لك YOLOv5 تدريب نماذج الكشف عن الكائنات المخصصة وفق احتياجاتك، أو استخدام أوزان مدربة مسبقًا للحصول بسرعة على نتائج في مهام متنوعة. استكشف خيارات نشر النماذج المختلفة بعد التصدير.
تخصيص مساحة للتبديل (اختياري)#
إذا كنت تعمل على مجموعات بيانات كبيرة جدًا قد تتجاوز سعة RAM في آلتك الافتراضية، ففكّر في إضافة مساحة للتبديل لتجنب أخطاء الذاكرة:
# Allocate a 64GB swap file
sudo fallocate -l 64G /swapfile

# Set the correct permissions for the swap file
sudo chmod 600 /swapfile

# Set up the Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap space allocation (should show increased swap memory)
free -h
تدريب مجموعات بيانات مخصصة#
لتدريب YOLOv5 على مجموعة بياناتك المخصصة ضمن GCP، اتبع الخطوات العامة التالية:
-
جهّز مجموعة البيانات وفق تنسيق YOLOv5 (الصور وملفات التسميات المقابلة). راجع نظرة عامة على مجموعات البيانات للاسترشاد.
-
حمّل مجموعة البيانات إلى آلة GCP الافتراضية باستخدام
gcloud compute scpأو ميزة SSH في وحدة تحكم الويب. -
أنشئ ملف YAML لتهيئة مجموعة البيانات (
custom_dataset.yaml) يحدد مسارات بيانات التدريب والتحقق، وعدد الفئات وأسماءها. -
ابدأ عملية التدريب باستخدام ملف YAML الخاص بمجموعة بياناتك، ويمكنك البدء بأوزان مدربة مسبقًا:
# Example: Train YOLOv5s on a custom dataset for 100 epochs
python train.py --img 640 --batch 16 --epochs 100 --data custom_dataset.yaml --weights yolov5s.pt
للحصول على تعليمات شاملة حول إعداد البيانات والتدريب باستخدام مجموعات بيانات مخصصة، راجع البرنامج التعليمي تدريب بيانات مخصصة.
الاستفادة من التخزين السحابي#
لإدارة البيانات بكفاءة، خصوصًا عند التعامل مع مجموعات بيانات كبيرة أو تجارب عديدة، ادمج سير عمل YOLOv5 مع Google Cloud Storage:
# Ensure Google Cloud SDK is installed and initialized
# If not installed: curl https://sdk.cloud.google.com/ | bash
# Then initialize: gcloud init

# Example: Copy your dataset from a GCS bucket to your VM
gsutil cp -r gs://your-data-bucket/my_dataset ./datasets/

# Example: Copy trained model weights from your VM to a GCS bucket
gsutil cp -r ./runs/train/exp/weights gs://your-models-bucket/yolov5_custom_weights/
يتيح لك هذا الأسلوب تخزين مجموعات البيانات الكبيرة والنماذج المدرّبة بأمان وبتكلفة معقولة في السحابة، مع تقليل متطلبات التخزين على مثيلك الافتراضي.
أفكار ختامية#
تهانينا! أصبحت الآن مستعدًا للاستفادة من قدرات Ultralytics YOLOv5 إلى جانب القدرة الحاسوبية لمنصة Google Cloud Platform. يوفر هذا الإعداد قابلية التوسع والكفاءة والمرونة لمشاريع الكشف عن الكائنات. سواء كان هدفك الاستكشاف الشخصي أو البحث الأكاديمي أو إنشاء حلول صناعية، فقد خطوت خطوة مهمة نحو عالم الذكاء الاصطناعي والتعلم الآلي في السحابة.
فكّر في استخدام منصة Ultralytics للاستمتاع بتجربة مبسطة بلا تعليمات برمجية لتدريب نماذجك وإدارتها.
احرص على توثيق تقدمك ومشاركة الرؤى مع مجتمع Ultralytics النشط، واستفد من موارد مثل نقاشات GitHub للتعاون والدعم. والآن، انطلق وابتكر باستخدام YOLOv5 وGCP!
هل ترغب في مواصلة تطوير مهاراتك في تعلّم الآلة؟ تعمّق في الوثائق واستكشف مدونة Ultralytics للاطلاع على مزيد من الشروحات والأفكار. لتتواصل رحلتك في عالم الذكاء الاصطناعي!
الأسئلة الشائعة#
تكفي آلة
n1-standard-8مزودة بوحدة GPU واحدة من طراز T4 لمعظم عمليات تدريب YOLOv5 والاستدلال. انتقل إلى L4 أو A100 عند استخدام مجموعات بيانات كبيرة أو نماذج أكبر، واحرص دائمًا على تحديد خيار تثبيت برنامج تشغيل NVIDIA تلقائيًا عند بدء التشغيل لأول مرة.أوقف تشغيل الآلة الافتراضية من وحدة تحكم Compute Engine عندما تكون خاملة. ستظل تُحاسب على القرص المتصل، لذا احذف الآلة الافتراضية والقرص بعد انتهاء المشروع ونسخ الأوزان بأمان إلى Cloud Storage.
استخدم
gcloud compute scpلمجموعات البيانات الصغيرة. أما المجموعات الأكبر، فارفعها إلى حاوية Cloud Storage واسحبها باستخدامgsutil cp -r gs://your-bucket/dataset ./datasets/، إذ تكون هذه الطريقة أسرع بكثير داخل شبكة Google.نعم. تتضمن آلة Deep Learning VM مكتبة PyTorch مسبقًا، لذا تضيف
pip install ultralyticsإمكانات التدريب والتصدير في YOLO26 باستخدام CLI لـyolo. راجع دليل البدء السريع لمزيد من التفاصيل.