بنية Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) خوارزمية لكشف الأجسام طوّرتها Ultralytics. تشرح هذه المقالة بنية YOLOv5، واستراتيجيات تعزيز البيانات، ومنهجيات التدريب، وتقنيات حساب الخسارة. وسيساعدك فهمها على تطبيق كشف الأجسام في مجالات مثل المراقبة والمركبات ذاتية القيادة والتعرّف على الصور.
1. بنية النموذج#
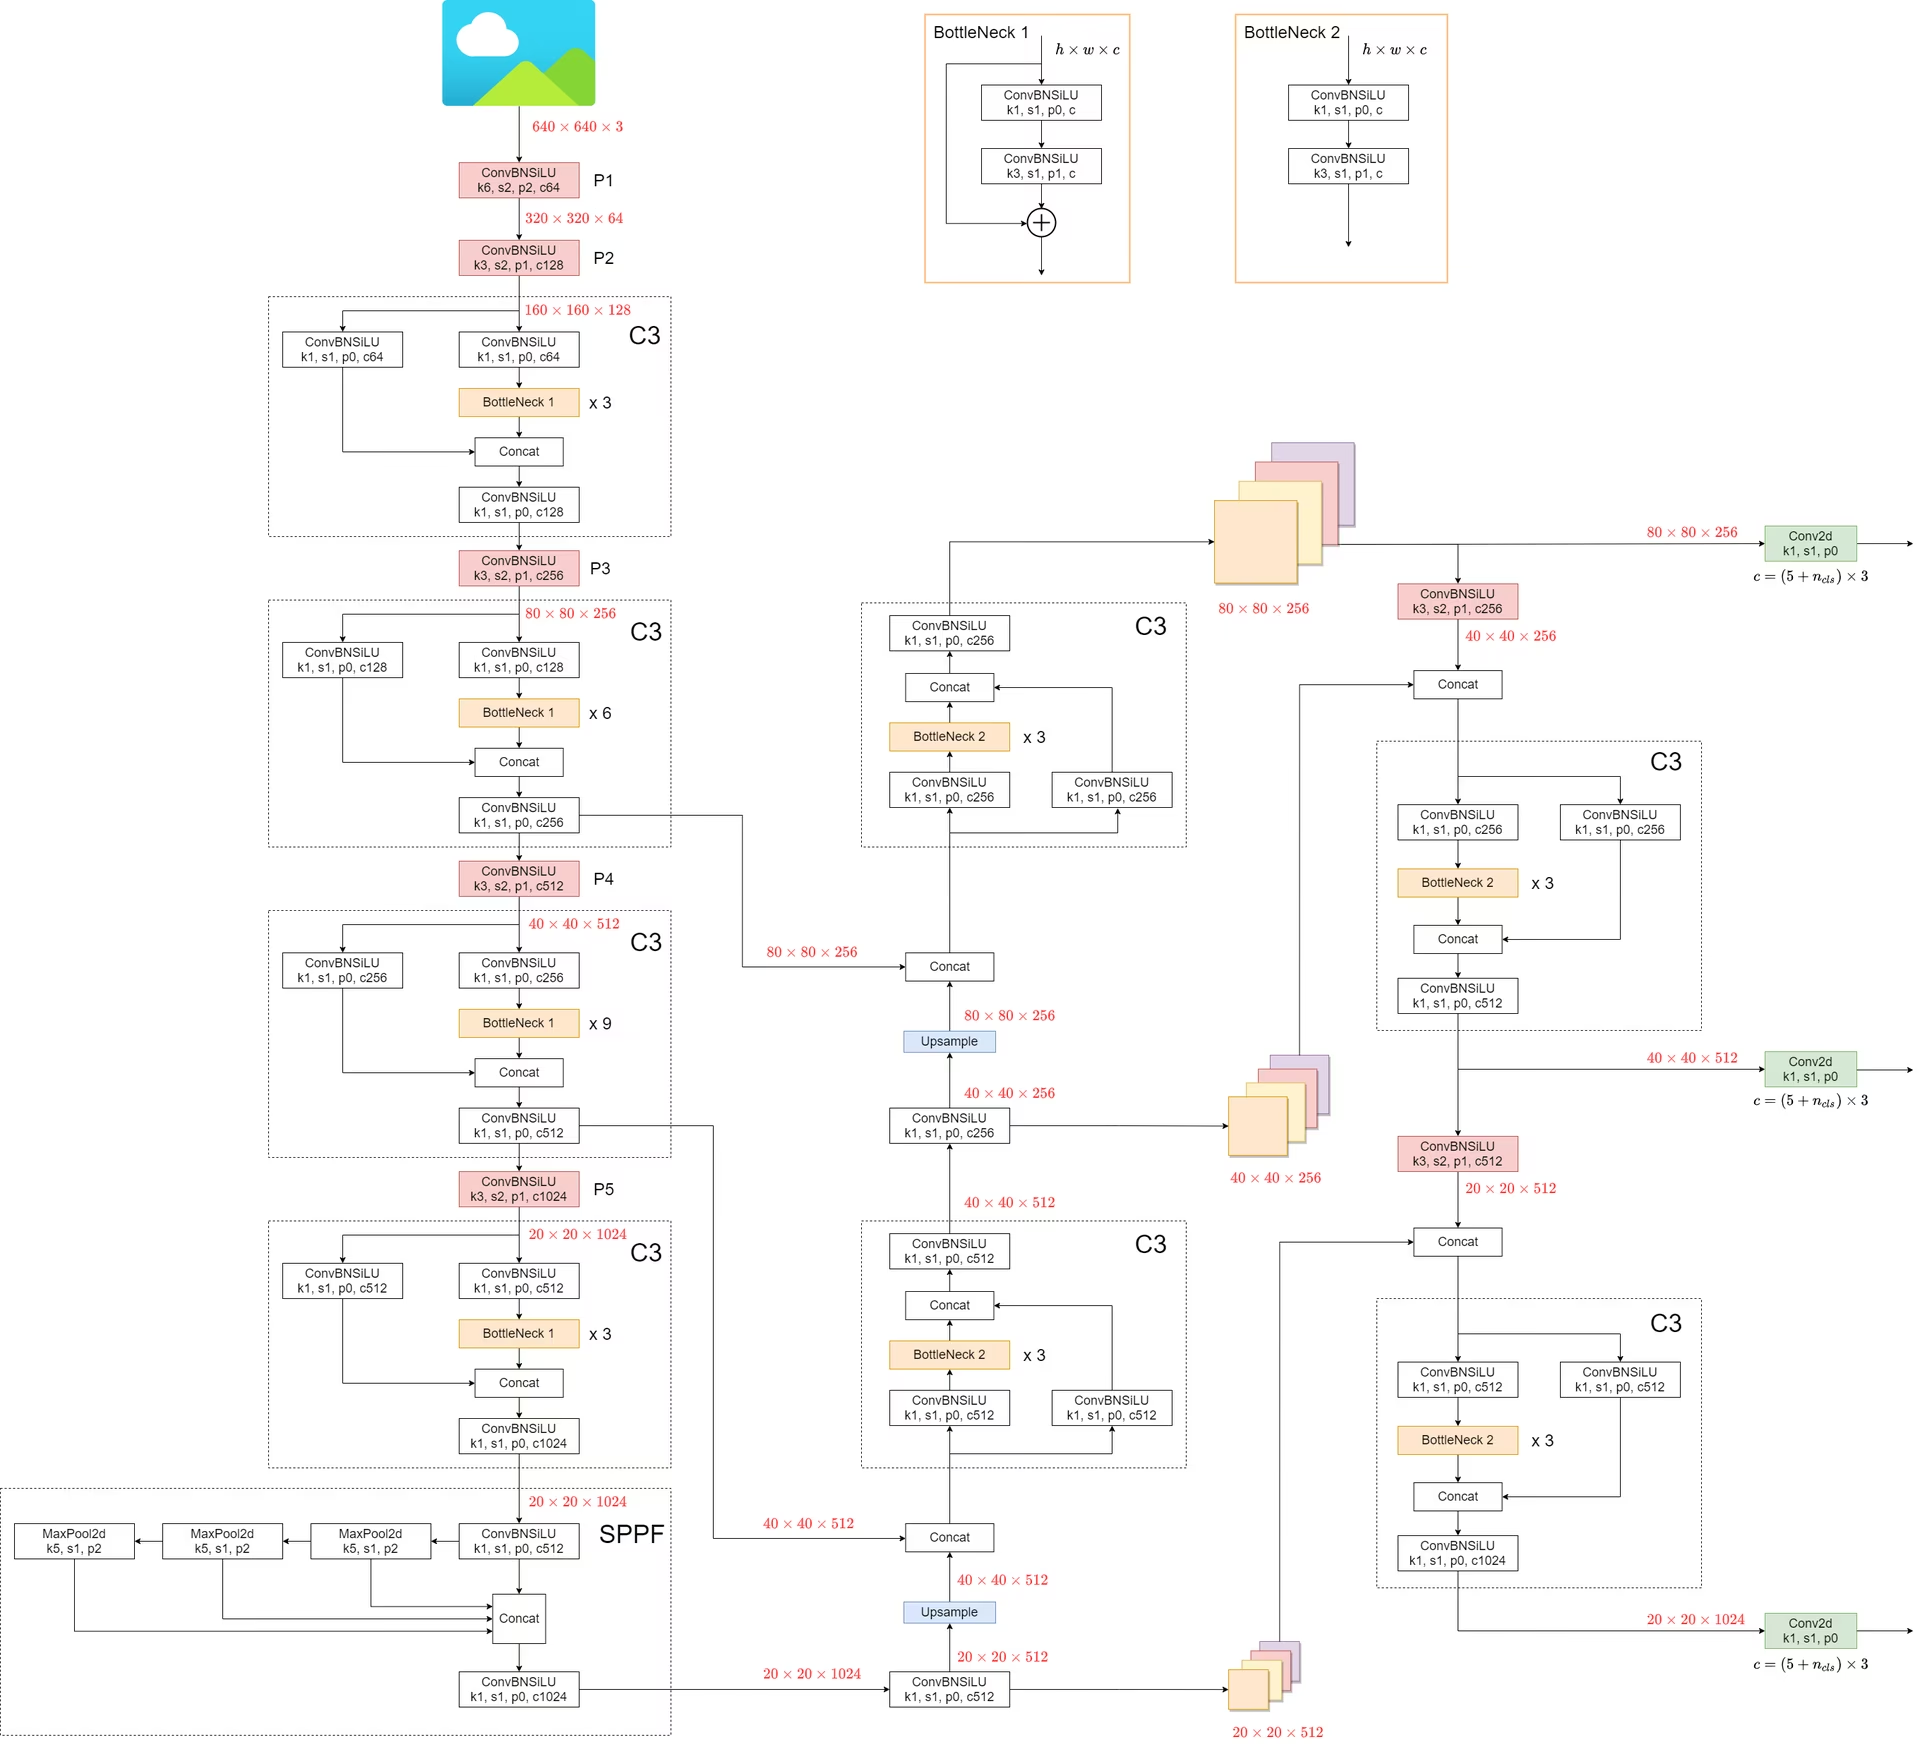
تتكون بنية YOLOv5 من ثلاثة أجزاء رئيسية:
- العمود الفقري: هو الجزء الأساسي من الشبكة. صُمّم العمود الفقري في YOLOv5 باستخدام بنية
CSPDarknet53، وهي تعديل لبنية Darknet المستخدمة في الإصدارات السابقة. - العنق: يربط هذا الجزء العمود الفقري بالرأس. ويستخدم YOLOv5 بنيتي
SPPF(تجميع هرمي مكاني - سريع) وPANet(شبكة تجميع المسارات). - الرأس: هذا الجزء مسؤول عن إنشاء المخرجات النهائية. يستخدم YOLOv5
YOLOv3 Headلهذا الغرض.
يوضح الشكل أدناه بنية النموذج. ويمكن الاطلاع على تفاصيل بنية النموذج في models/yolov5l.yaml.
يتضمن YOLOv5 بعض التحسينات البارزة مقارنةً بالإصدارات السابقة:
- استُبدلت بنية
Focusالموجودة في الإصدارات السابقة ببنية6x6 Conv2d. ويعزز هذا التغيير الكفاءة #4825. - استُبدلت بنية
SPPبـSPPF. ويزيد هذا التغيير سرعة المعالجة إلى أكثر من الضعف مع الحفاظ على المخرجات نفسها.
يمكن استخدام التعليمات البرمجية التالية لاختبار سرعة SPP وSPPF:
مثال على تحليل سرعة SPP مقابل SPPF (انقر للفتح)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
النتيجة:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. تقنيات زيادة البيانات#
يستخدم YOLOv5 تقنيات متنوعة لزيادة البيانات لتحسين قدرة النموذج على التعميم والحد من فرط التكيّف. وتشمل هذه التقنيات:
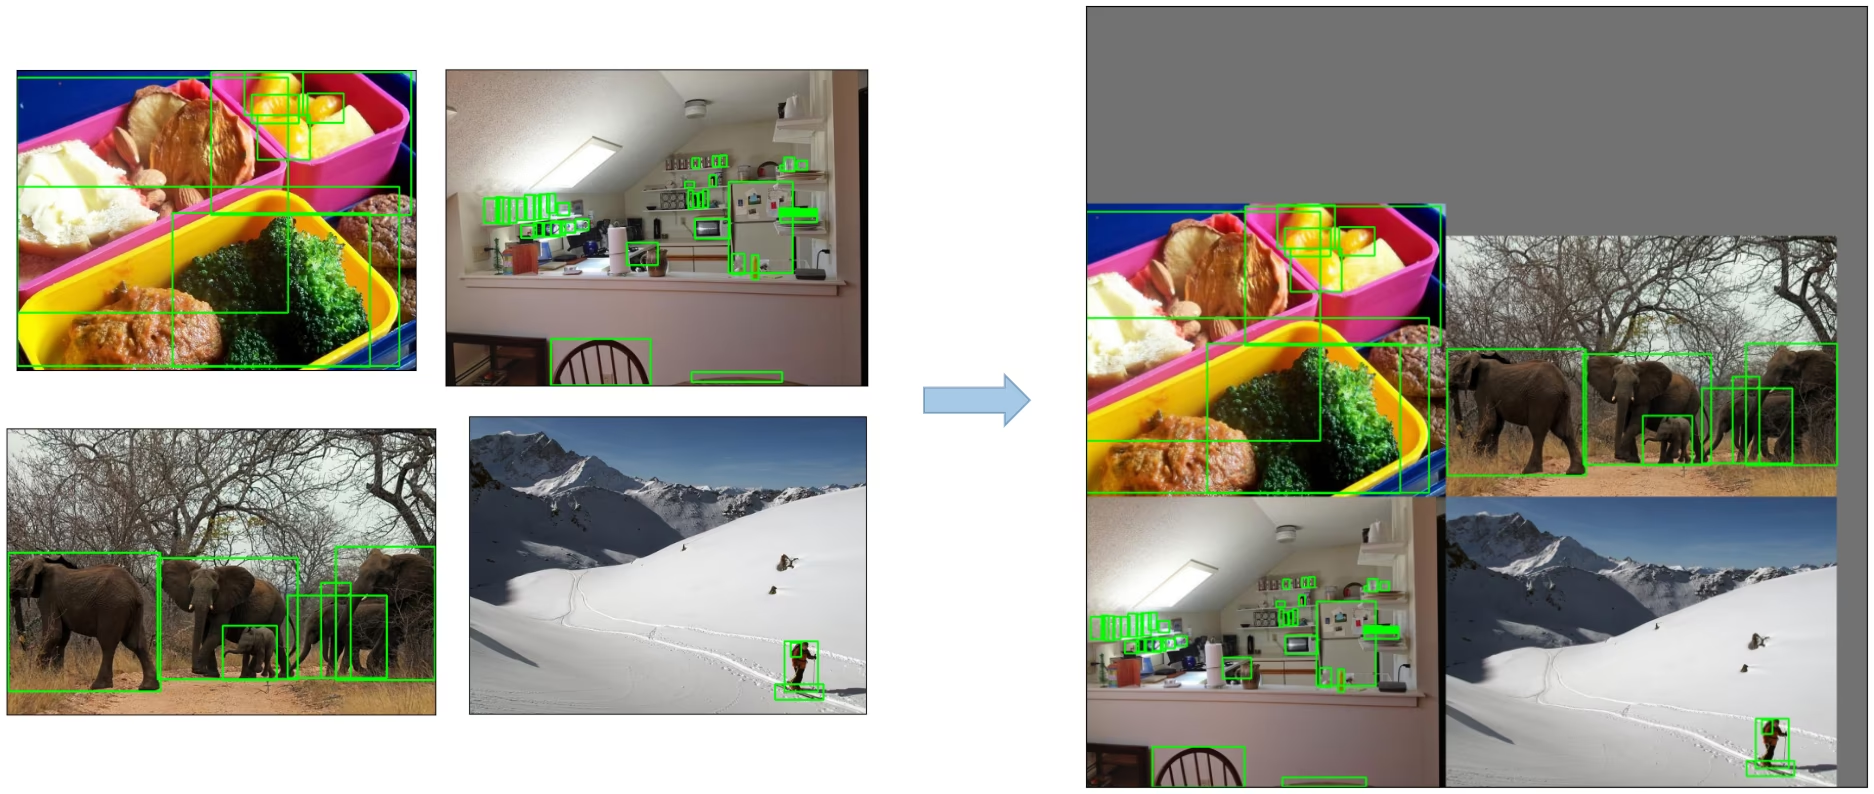
-
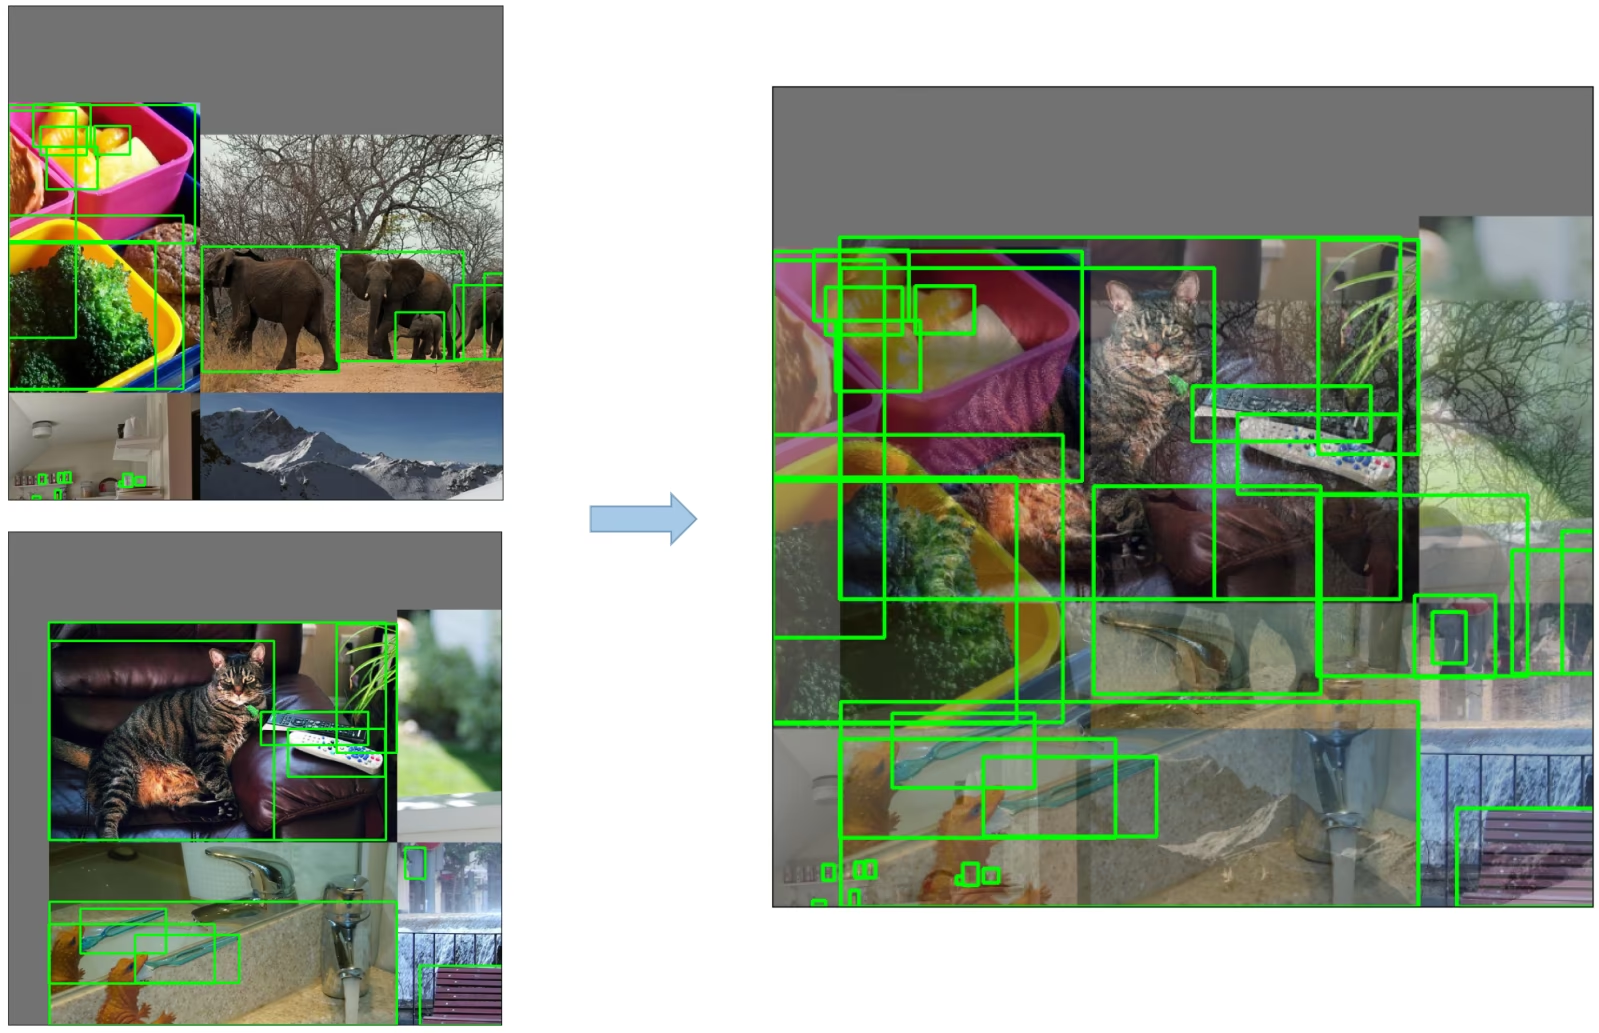
تعزيز الفسيفساء: تقنية لمعالجة الصور تجمع أربع صور تدريبية في صورة واحدة بطرق تشجّع نماذج كشف الأجسام على التعامل بشكل أفضل مع مختلف أحجام الأجسام وإزاحاتها.
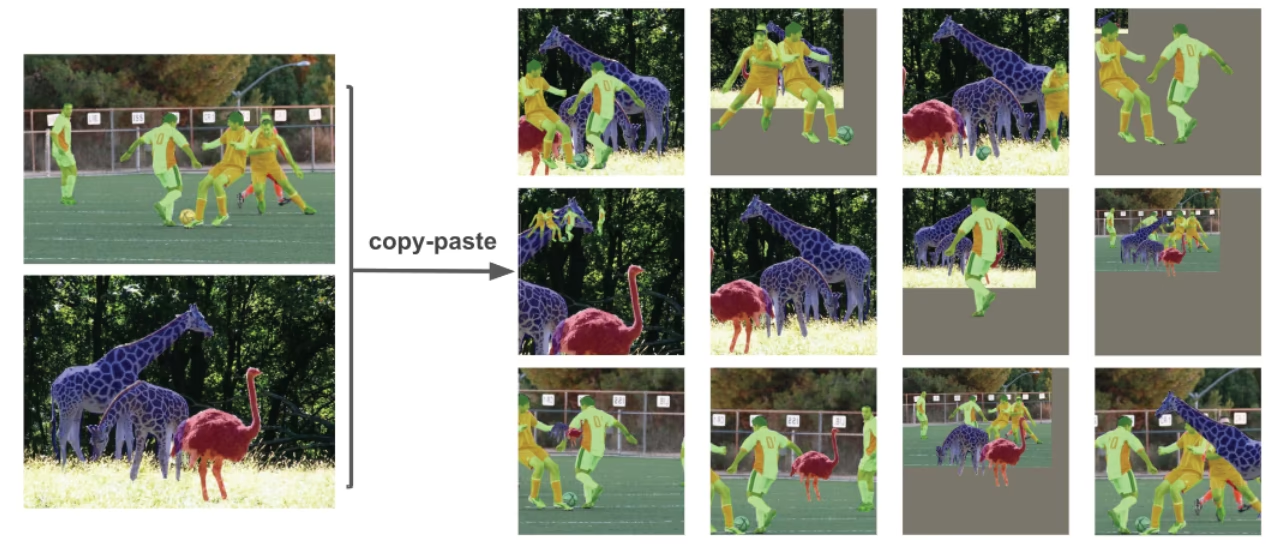
-
تعزيز النسخ واللصق: أسلوب لتعزيز البيانات ينسخ مثيلات الأجسام باستخدام أقنعة التجزئة الخاصة بها، ويلصقها على صور التدريب لإنشاء عينات تدريب جديدة.
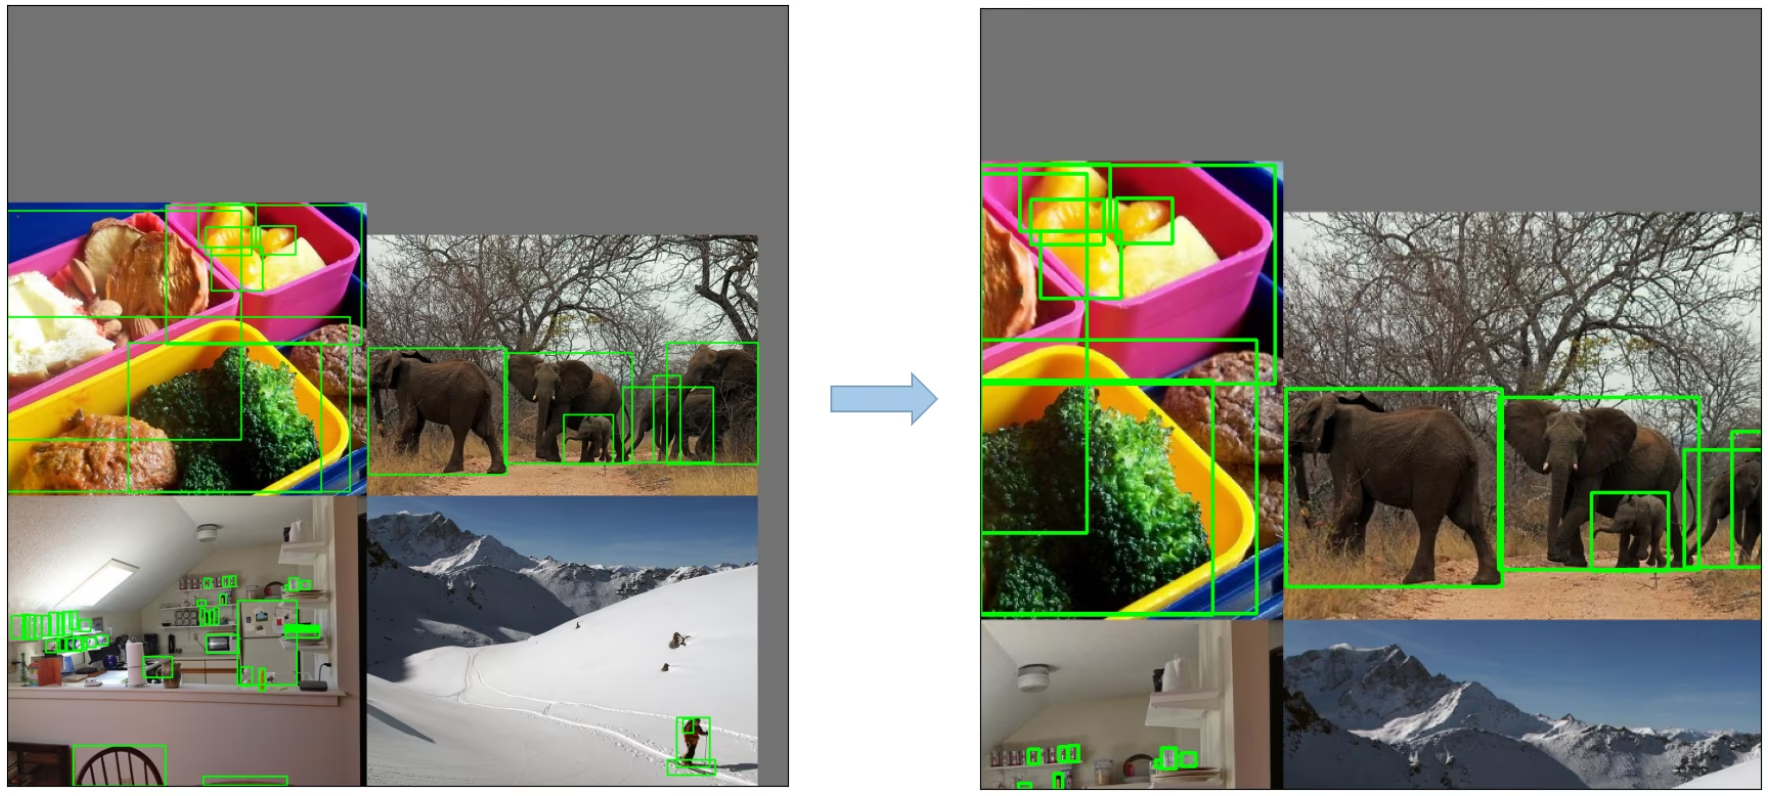
-
التحويلات الأفينية العشوائية: تشمل تدوير الصور وتحجيمها وإزاحتها وقصّها عشوائيًا.
-
زيادة البيانات باستخدام MixUp: طريقة تنشئ صورًا مركبة عبر حساب تركيبة خطية من صورتين والتسميات المرتبطة بهما.
-
Albumentations: مكتبة لزيادة الصور تدعم مجموعة متنوعة من تقنيات زيادة البيانات.
-
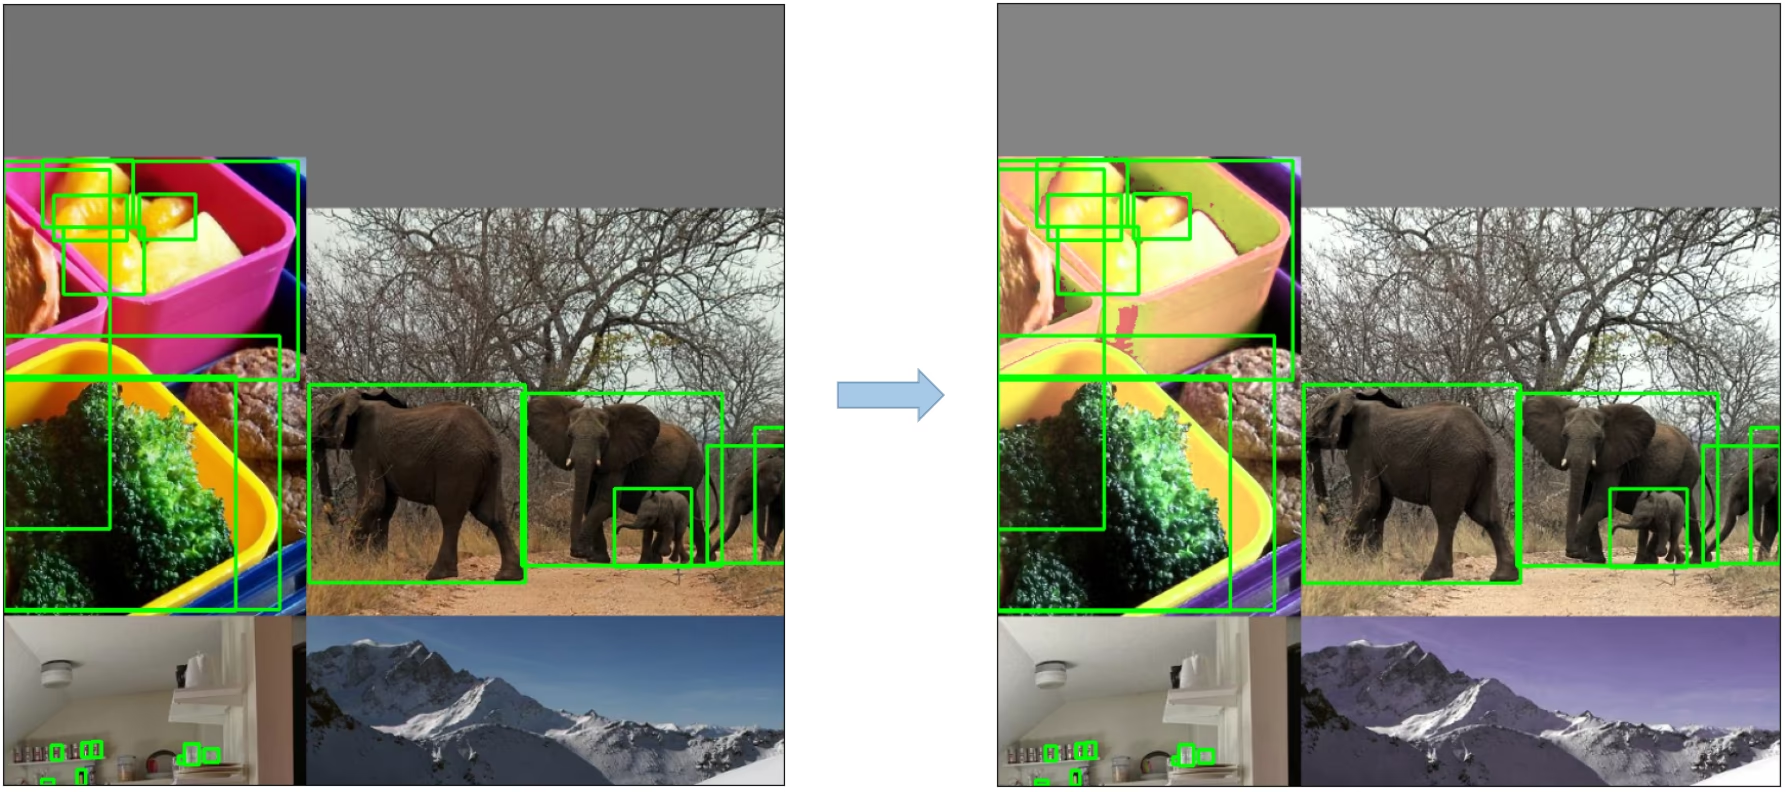
زيادة بيانات HSV: تغييرات عشوائية في تدرج الألوان والتشبع والقيمة للصور.
-
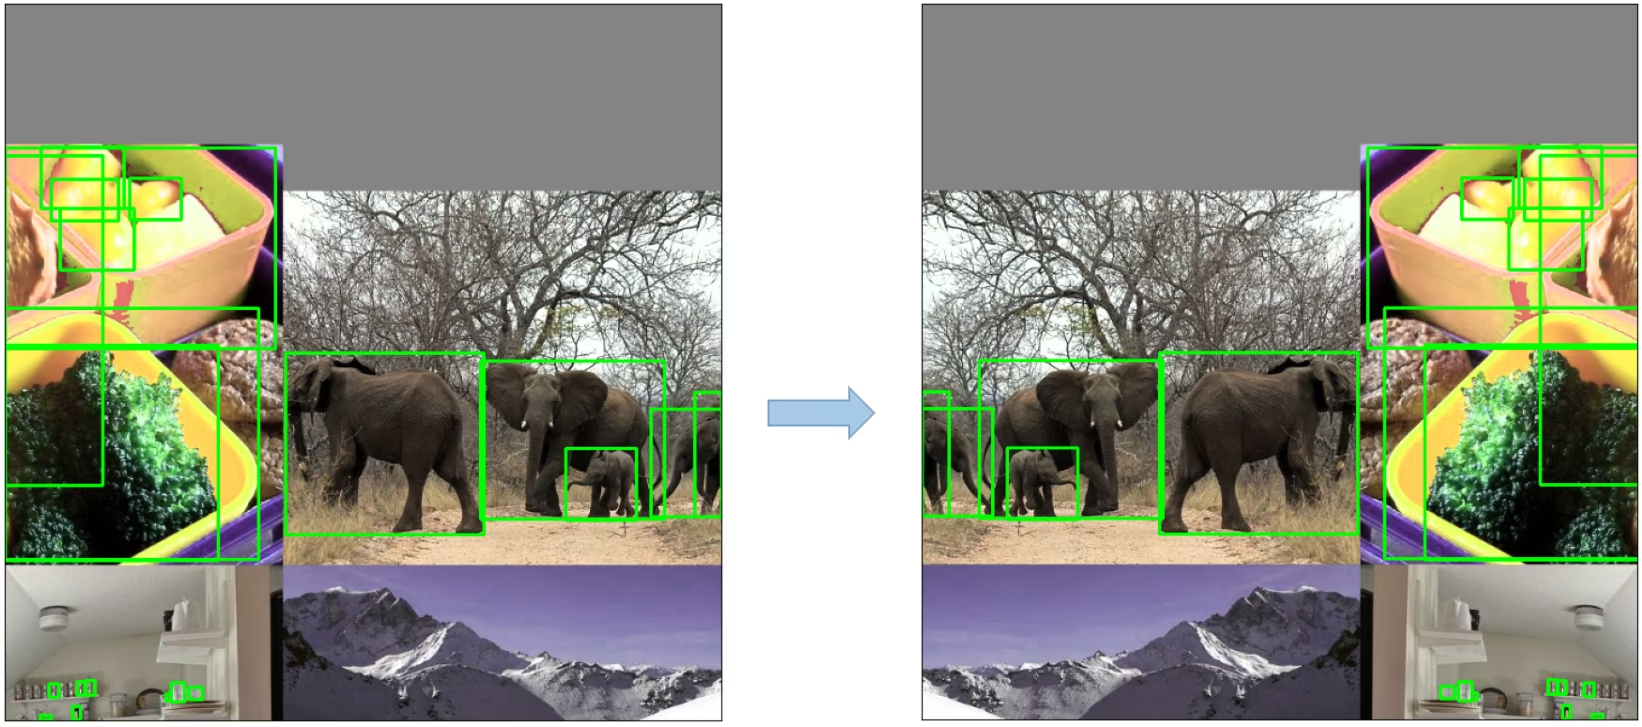
القلب الأفقي العشوائي: طريقة لزيادة البيانات تقلب الصور أفقيًا بصورة عشوائية.
3. استراتيجيات التدريب#
يطبّق YOLOv5 عدة استراتيجيات تدريب لتعزيز أداء النموذج، ومنها:
- التدريب متعدد المقاييس: تُعاد تحجيم الصور المدخلة عشوائيًا ضمن نطاق يتراوح بين 0.5 و1.5 ضعف حجمها الأصلي أثناء التدريب.
- AutoAnchor: تحسّن هذه الاستراتيجية مربعات الارتساء الأولية لتلائم الخصائص الإحصائية لمربعات الحقيقة الأرضية في بياناتك المخصصة.
- مُجدوِل معدل التعلّم للإحماء والجيب التمام: طريقة لضبط معدل التعلّم لتحسين أداء النموذج.
- المتوسط المتحرك الأسي (EMA): استراتيجية تستخدم متوسط المعلمات عبر الخطوات السابقة لتحقيق الاستقرار في عملية التدريب والحد من خطأ التعميم.
- التدريب بدقة مختلطة: أسلوب لتنفيذ العمليات بتنسيق الدقة النصفية، ما يقلل استهلاك الذاكرة ويزيد سرعة الحوسبة.
- تطور المعلمات الفائقة: استراتيجية لضبط المعلمات الفائقة تلقائيًا لتحقيق الأداء الأمثل. اطّلع على درس تطور المعلمات الفائقة.
4. ميزات إضافية#
4.1 حساب الخسائر#
تُحسب الخسارة في YOLOv5 بوصفها مزيجًا من ثلاثة مكونات منفصلة للخسارة:
- خسارة الفئات (خسارة BCE): خسارة الانتروبيا المتقاطعة الثنائية، وتقيس الخطأ في مهمة التصنيف.
- خسارة وجود الكائن (خسارة BCE): خسارة أخرى للانتروبيا المتقاطعة الثنائية، وتحسب الخطأ في اكتشاف وجود كائن في خلية شبكة معينة من عدمه.
- خسارة الموقع (خسارة CIoU): تقيس خسارة IoU الكاملة خطأ تحديد موقع الجسم داخل خلية الشبكة.
تُمثَّل دالة الخسارة الإجمالية كما يلي:
4.2 موازنة الخسائر#
تُمنح خسائر وجود الكائن في طبقات التنبؤ الثلاث (P3، P4، P5) أوزانًا مختلفة. وأوزان الموازنة هي [4.0, 1.0, 0.4] على التوالي. يضمن هذا النهج أن تسهم التنبؤات عند المقاييس المختلفة إسهامًا مناسبًا في الخسارة الإجمالية.
4.3 إزالة حساسية الشبكة#
تُجري بنية YOLOv5 تغييرات مهمة على استراتيجية التنبؤ بالمربعات مقارنةً بالإصدارات السابقة من YOLO. في YOLOv2 وYOLOv3، كان يجري التنبؤ بإحداثيات المربع مباشرةً باستخدام تفعيل الطبقة الأخيرة.

لكن في YOLOv5، حُدّثت صيغة التنبؤ بإحداثيات المربع للحد من حساسية الشبكة ومنع النموذج من التنبؤ بأبعاد غير محدودة للمربع.
فيما يلي الصيغ المنقحة لحساب مربع الإحاطة المتنبأ به:
قارن إزاحة نقطة المركز قبل القياس وبعده. يتغير نطاق إزاحة نقطة المركز من (0, 1) إلى (-0.5, 1.5). لذلك، يسهل وصول الإزاحة إلى 0 أو 1.

قارن نسبة قياس الارتفاع والعرض (بالنسبة إلى الارتساء) قبل التعديل وبعده. تتضمن معادلات مربعات YOLO/Darknet الأصلية عيبًا خطيرًا. فالارتفاع والعرض غير مقيّدين تمامًا، إذ إنهما ببساطة out=exp(in)، وهذا أمر خطير لأنه قد يؤدي إلى انفلات التدرجات، وعدم الاستقرار، وخسائر NaN، وفي النهاية إلى فقدان التدريب بالكامل.

4.4 إنشاء الأهداف#
تُعد عملية إنشاء الأهداف في YOLOv5 ضرورية لكفاءة التدريب ودقة النموذج. وتشمل إسناد مربعات الحقيقة الأرضية إلى خلايا الشبكة المناسبة في خريطة الإخراج ومطابقتها بمربعات الارتكاز المناسبة.
تتبع هذه العملية الخطوات التالية:
- احسب نسبة أبعاد مربع الحقيقة الأرضية إلى أبعاد كل قالب ارتكاز.

- إذا كانت النسبة المحسوبة ضمن العتبة، فطابق مربع الحقيقة الأرضية مع المرساة المقابلة.

- أسند المرساة المطابقة إلى الخلايا المناسبة، مع مراعاة أن مربع الحقيقة الأرضية قد يُسنَد إلى أكثر من مرساة بسبب تعديل نطاق إزاحة نقطة المركز من (0, 1) إلى (-0.5, 1.5)، ما يتيح إجراء مطابقات إضافية.

بهذه الطريقة، تضمن عملية إنشاء الأهداف إسناد كل كائن من كائنات الحقيقة الأرضية ومطابقته على نحو صحيح أثناء التدريب، ما يتيح لـ YOLOv5 تعلّم مهمة اكتشاف الكائنات بفاعلية أكبر.
الخلاصة#
يمثل YOLOv5 خطوة مهمة في تطور اكتشاف الكائنات في الزمن الحقيقي. وتوفر خياراته المعمارية واستراتيجيات التدريب والتحسينات الهندسية أداءً قويًا وكفاءة عالية مقارنةً بإصدارات YOLO السابقة.
تشمل التحسينات الأساسية في YOLOv5 تنقيحات معمارية مثل البنية 6x6 Conv2d وSPPF، ومجموعة واسعة من تقنيات تعزيز البيانات، واستراتيجيات التدريب مثل AutoAnchor وEMA، وتعديلات على حساب الخسارة وبناء الأهداف. وتحسّن هذه العناصر مجتمعة دقة كشف الأجسام وكفاءته مع الحفاظ على السرعة المعروفة بها نماذج YOLO.
الأسئلة الشائعة#
تستخرج بنية CSPDarknet53 الأساسية السمات، وتدمجها طبقتا SPPF وPANet عبر المقاييس، بينما تتنبأ طبقة الرأس، المصممة على غرار YOLOv3، بالمربعات ووجود الكائنات والفئات عند خطوات 8 و16 و32. وترد قائمة الطبقات كاملةً في
models/yolov5l.yaml.تربط SPPF ثلاث عمليات تجميع أقصى بحجم 5x5 على التوالي، بدلًا من تنفيذ عمليات تجميع 5x5 و9x9 و13x13 بالتوازي. وتكون المخرجات متطابقة رياضيًا، لكن التنفيذ أسرع بأكثر من الضعف، كما يوضح مقطع قياس الأداء أعلاه.
لم يكن إزاحة YOLO الأصلية تصل أبدًا إلى 0 أو 1 بالضبط، لذا كان من الصعب التنبؤ بالكائنات المتمركزة على حدود الشبكة. ويزيل توسيع نطاق دالة سيغمويد إلى (-0.5, 1.5) حساسية الشبكة، كما أن تربيع
2σللعرض والارتفاع يحدّ التنبؤات إلى 4 أضعاف حجم المرساة، ما يمنع تضخم التدرجات الناتج عن الدالة الأسية غير المحدودة.تُطابق أي مرساة تكون نسبتا عرضها وارتفاعها إلى المربع ضمن
anchor_t(4.0 افتراضيًا)، كما يتيح نطاق الإزاحة الموسع إسناد المربع أيضًا إلى خليتي الشبكة المجاورتين. لذلك، يمكن لكائن واحد إنشاء عدة أهداف إيجابية، ما يسرّع التقارب.
التعليقات
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.